ProductScope — Web Scraping وتحليل بيانات المنتجات باستخدام Python
تفاصيل العمل
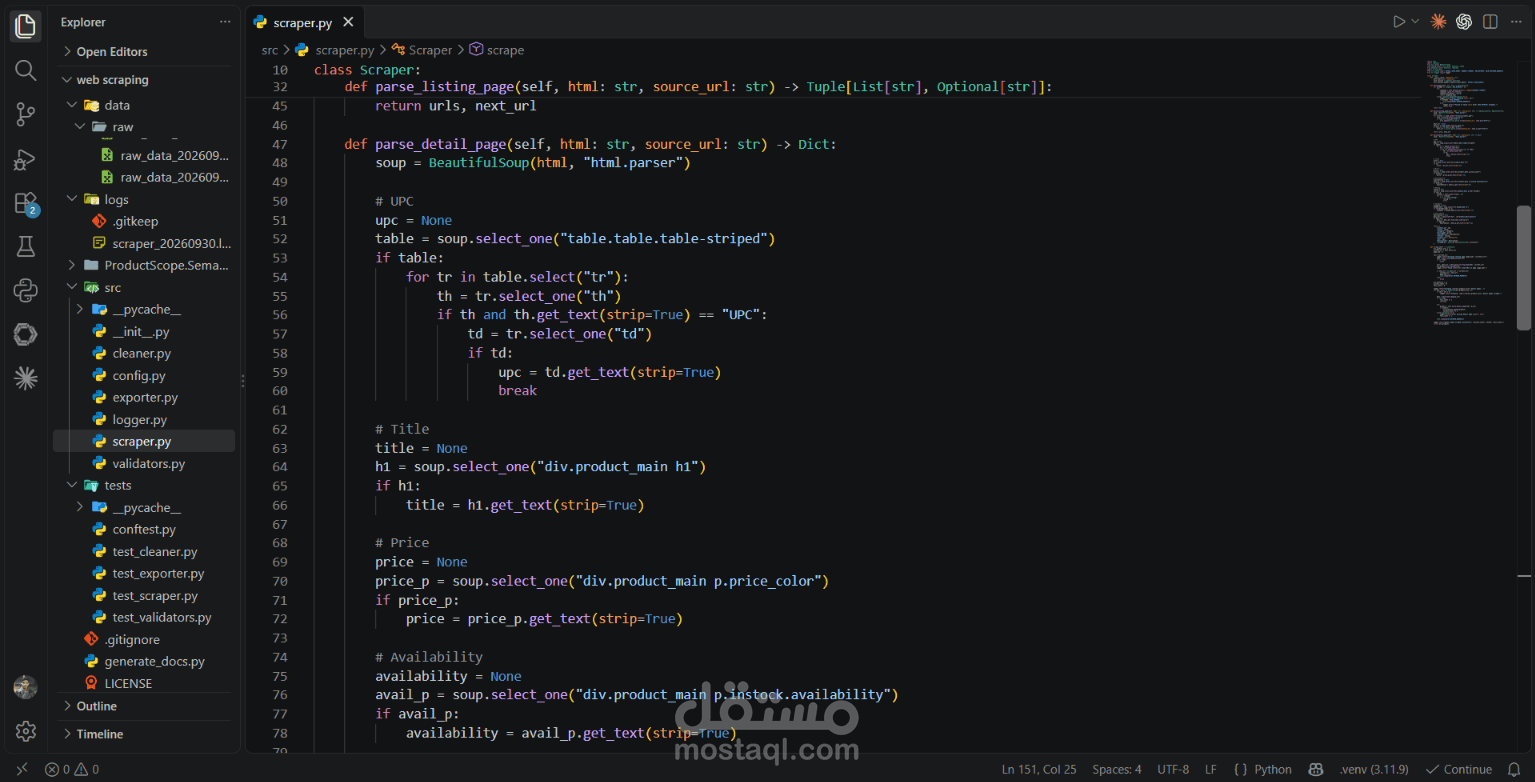
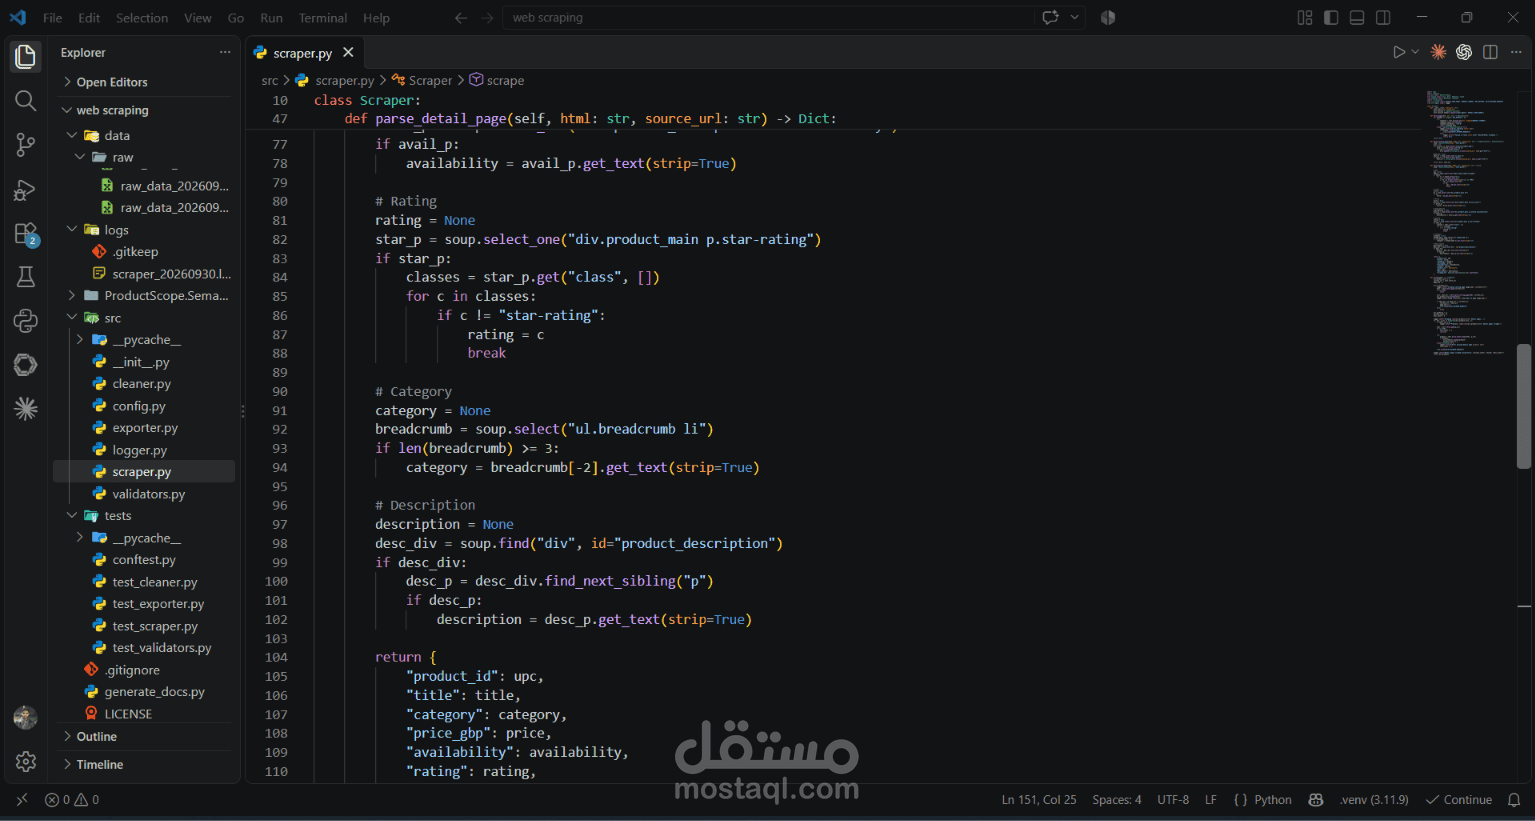
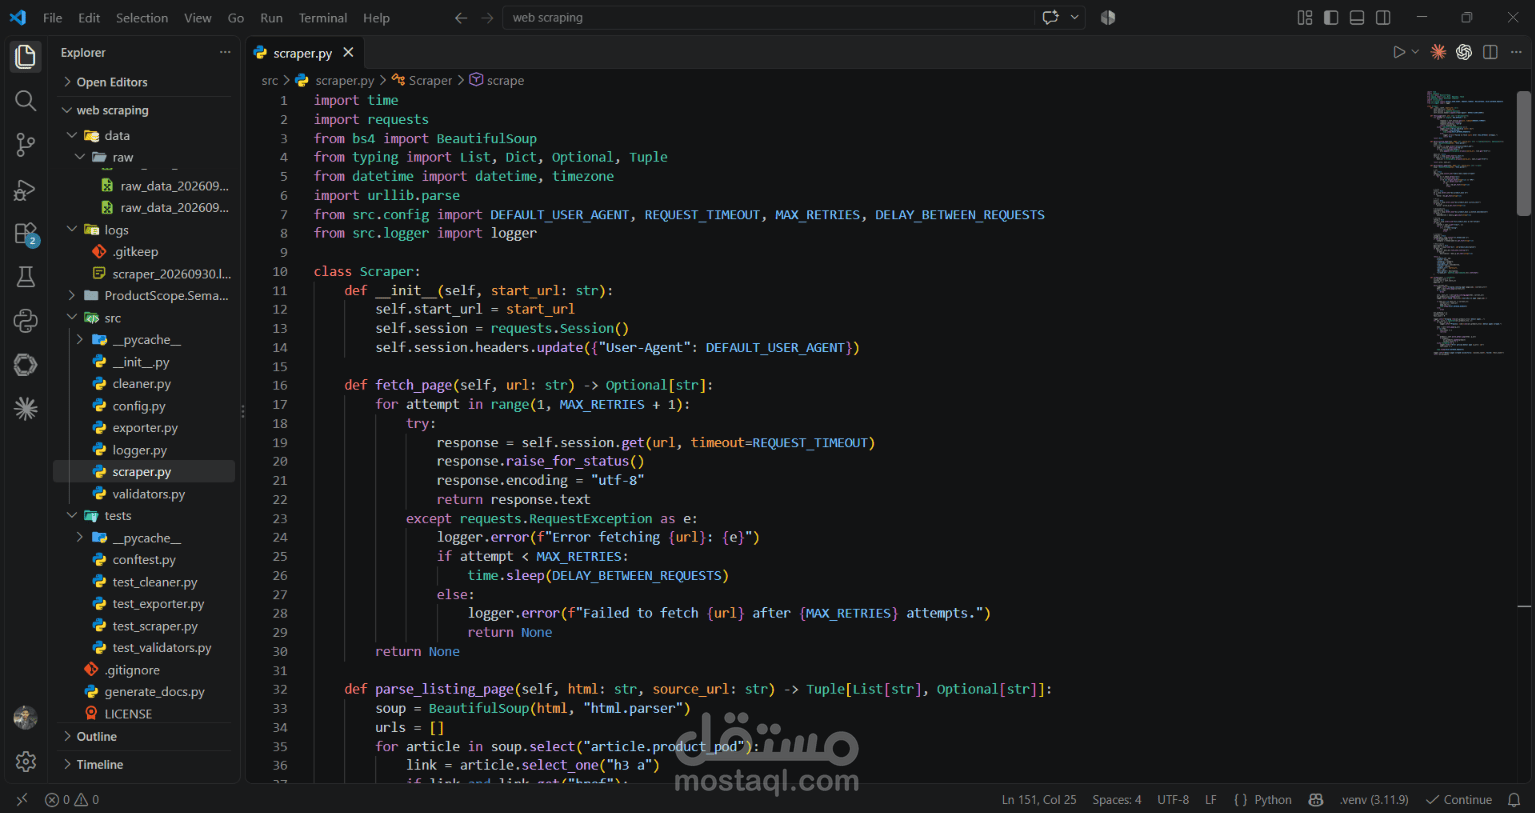
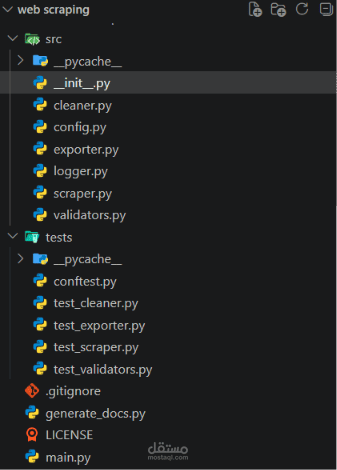
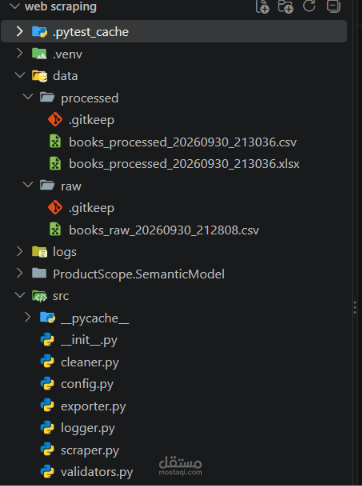
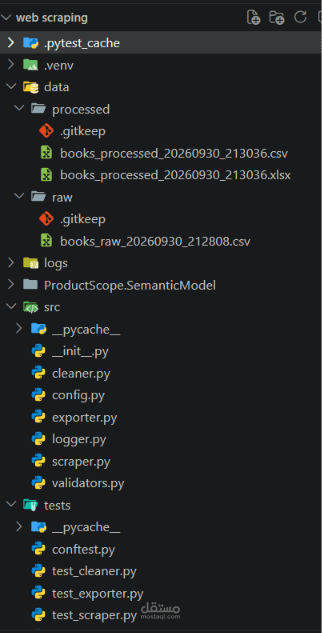
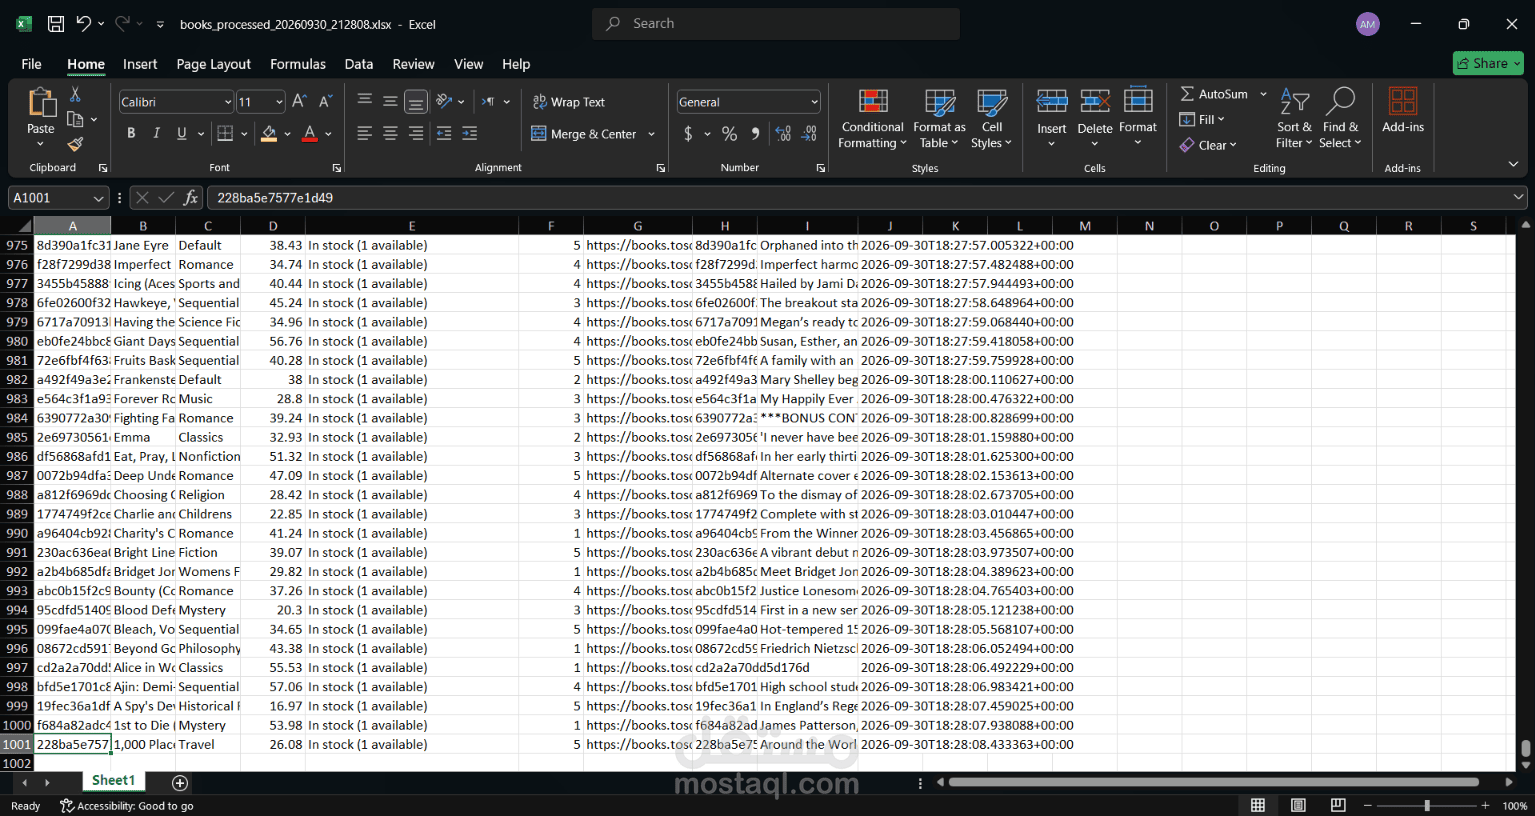
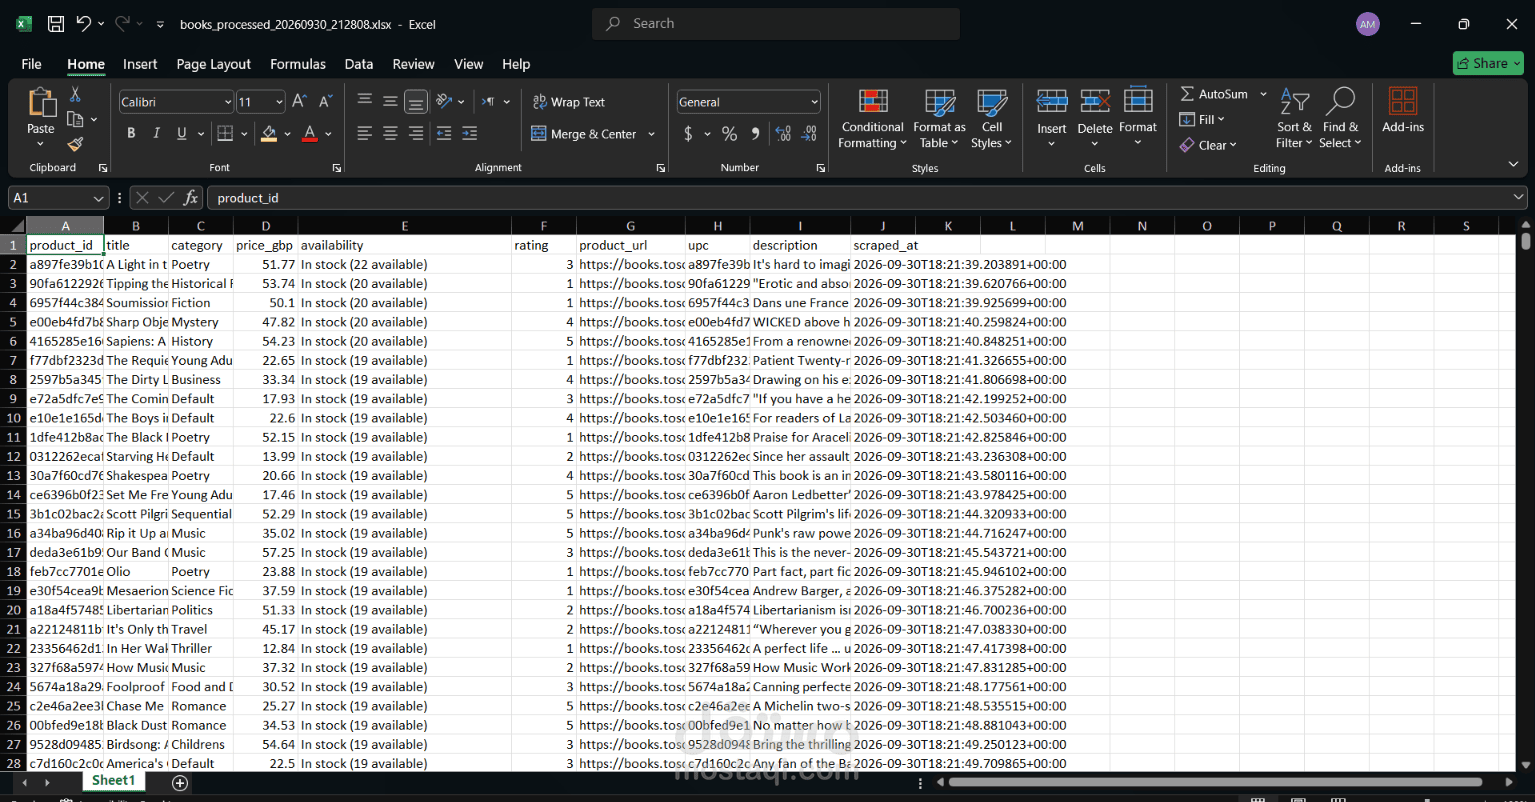
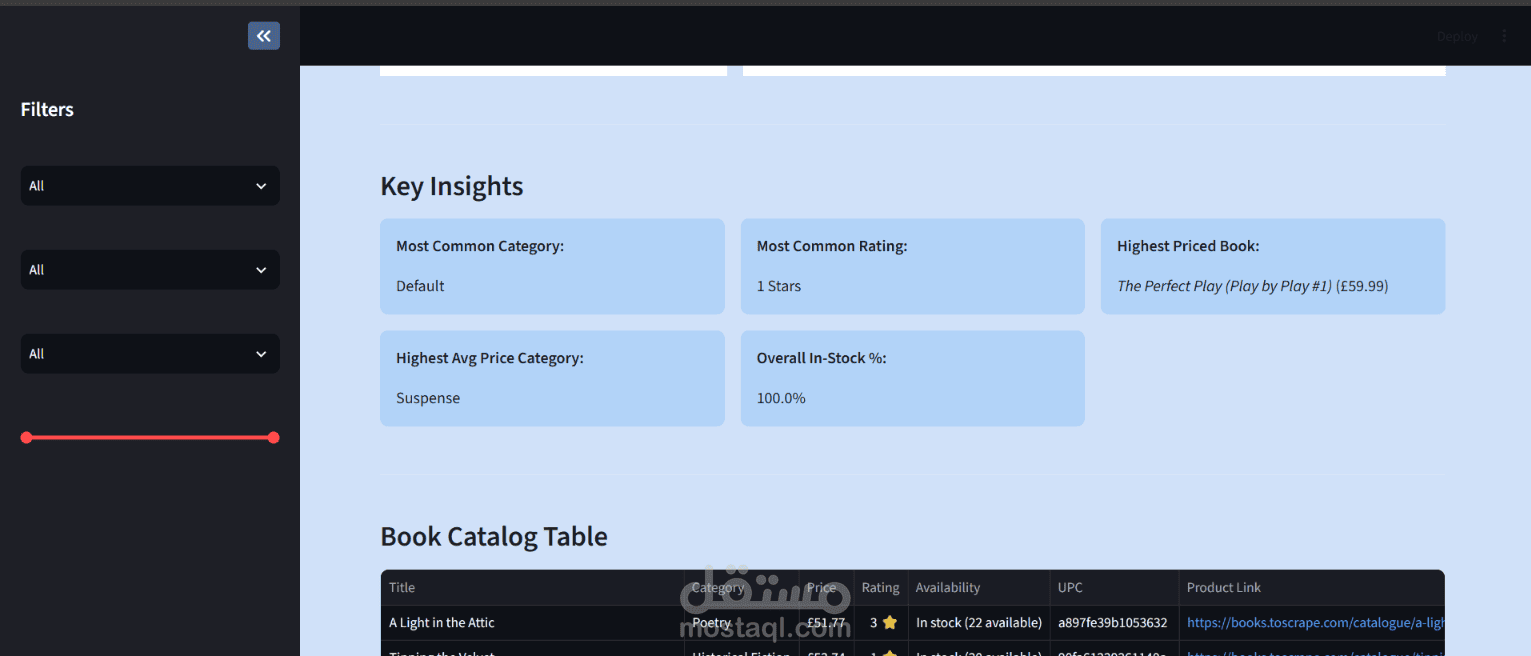
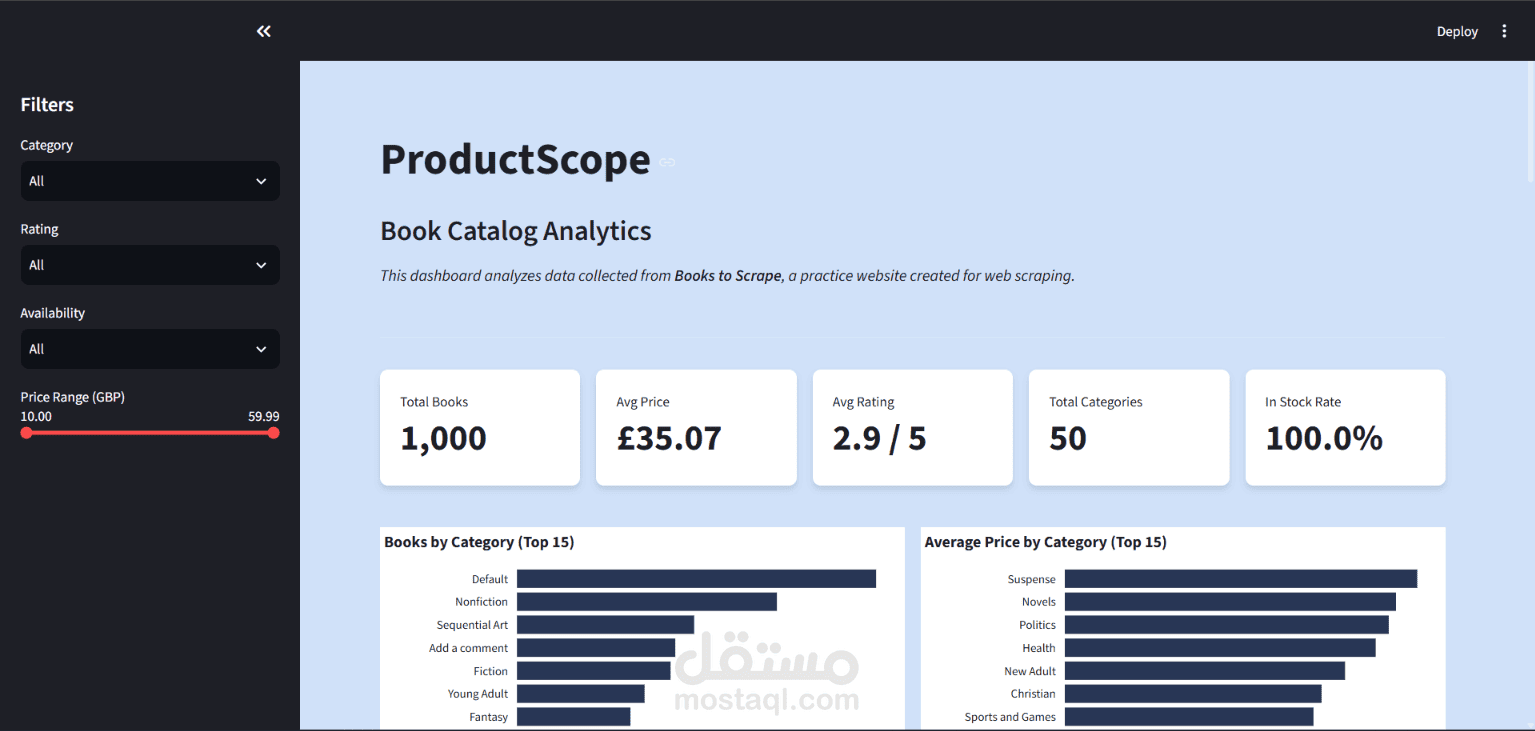
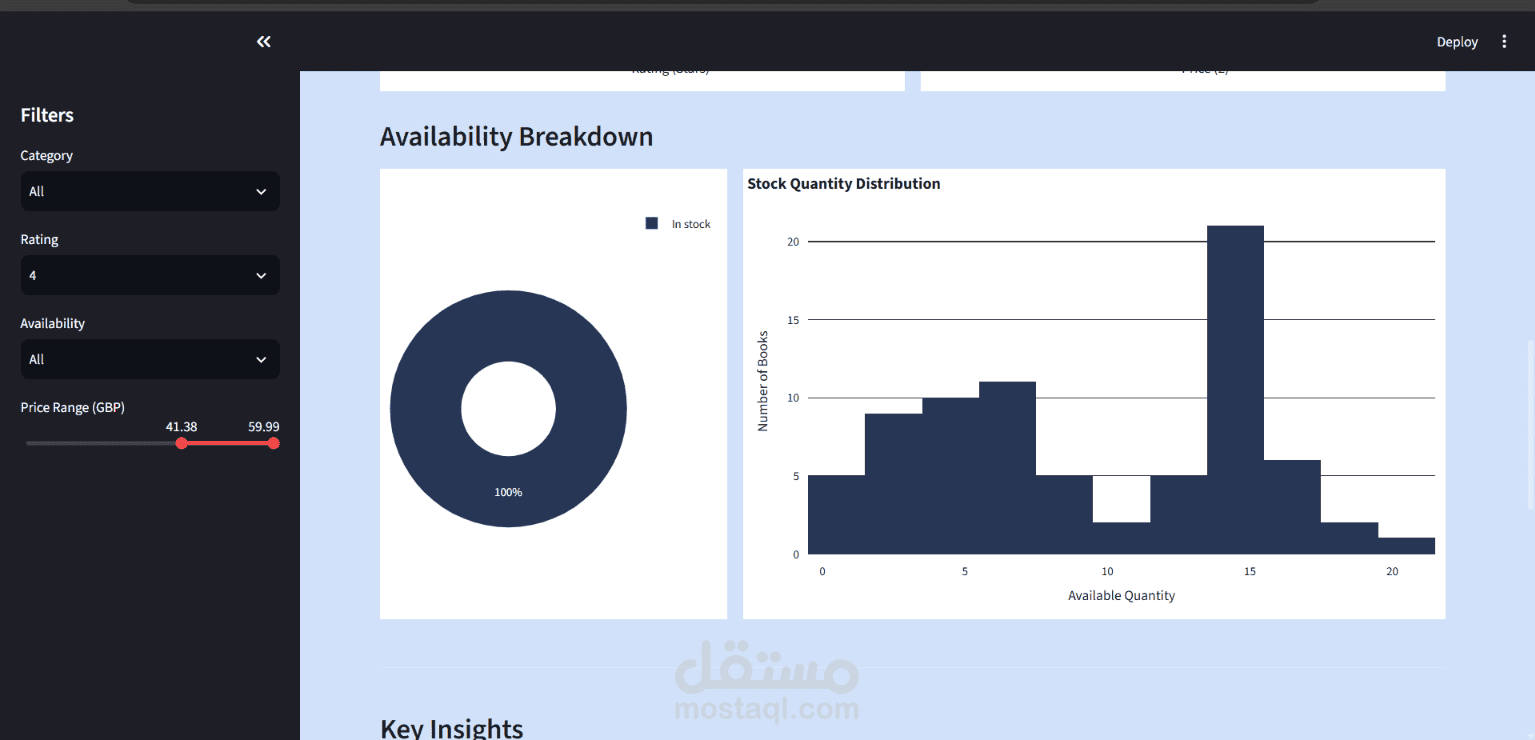
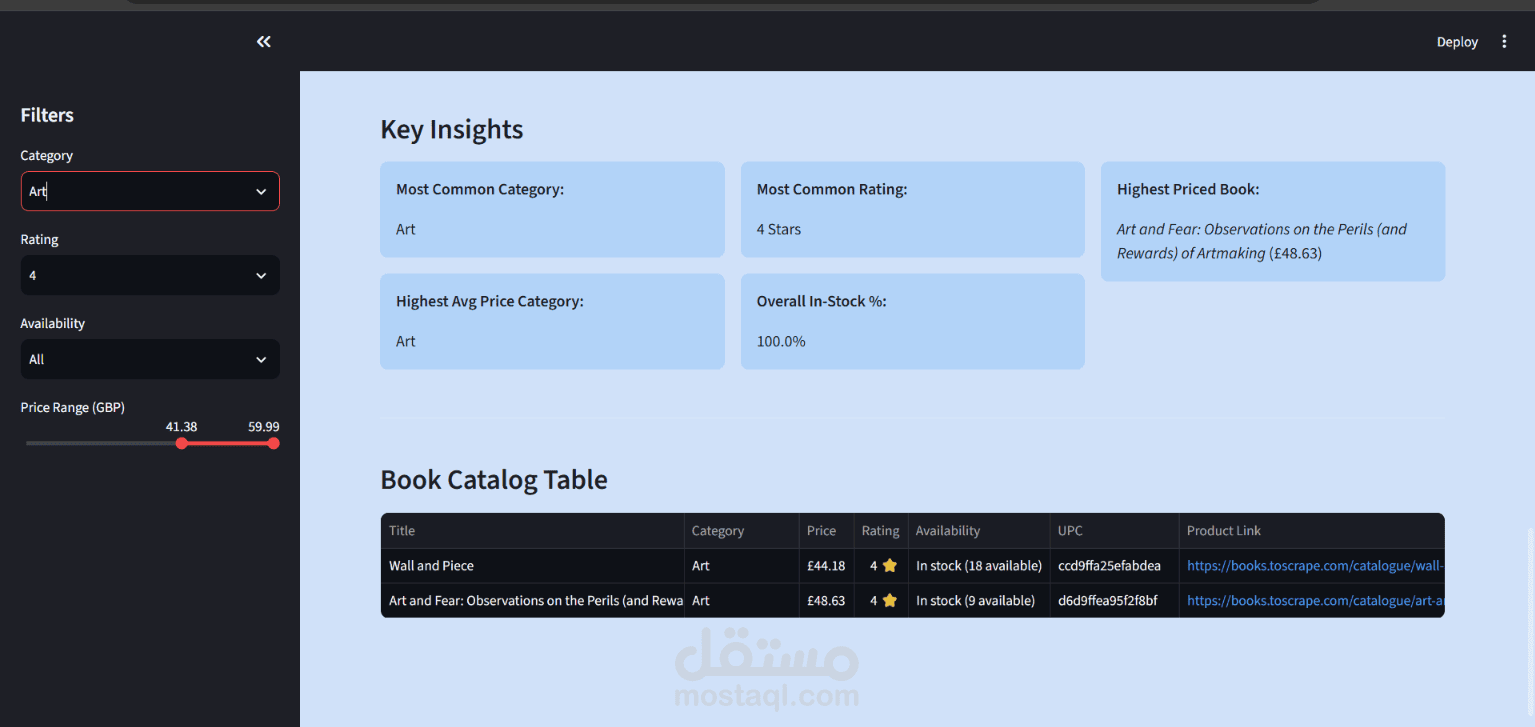
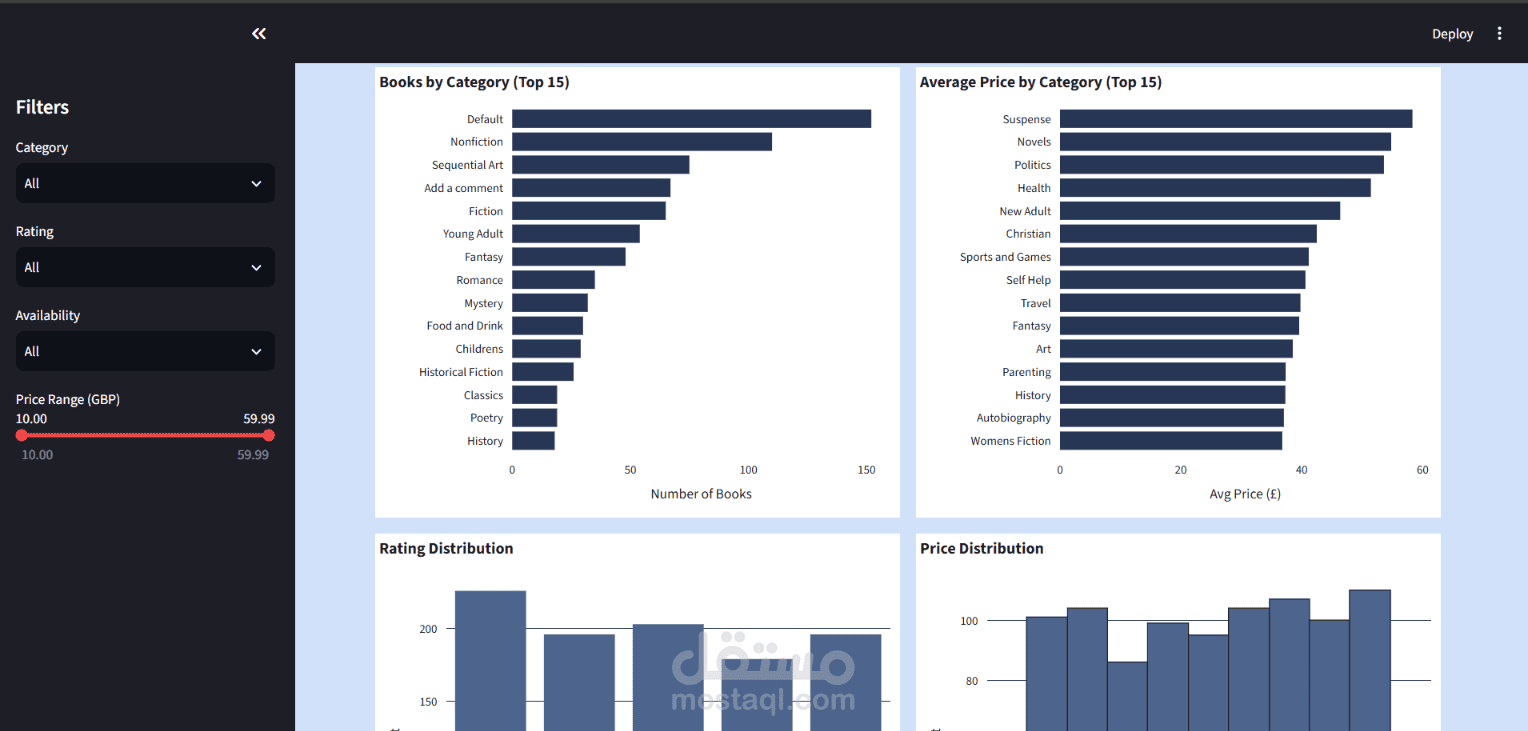
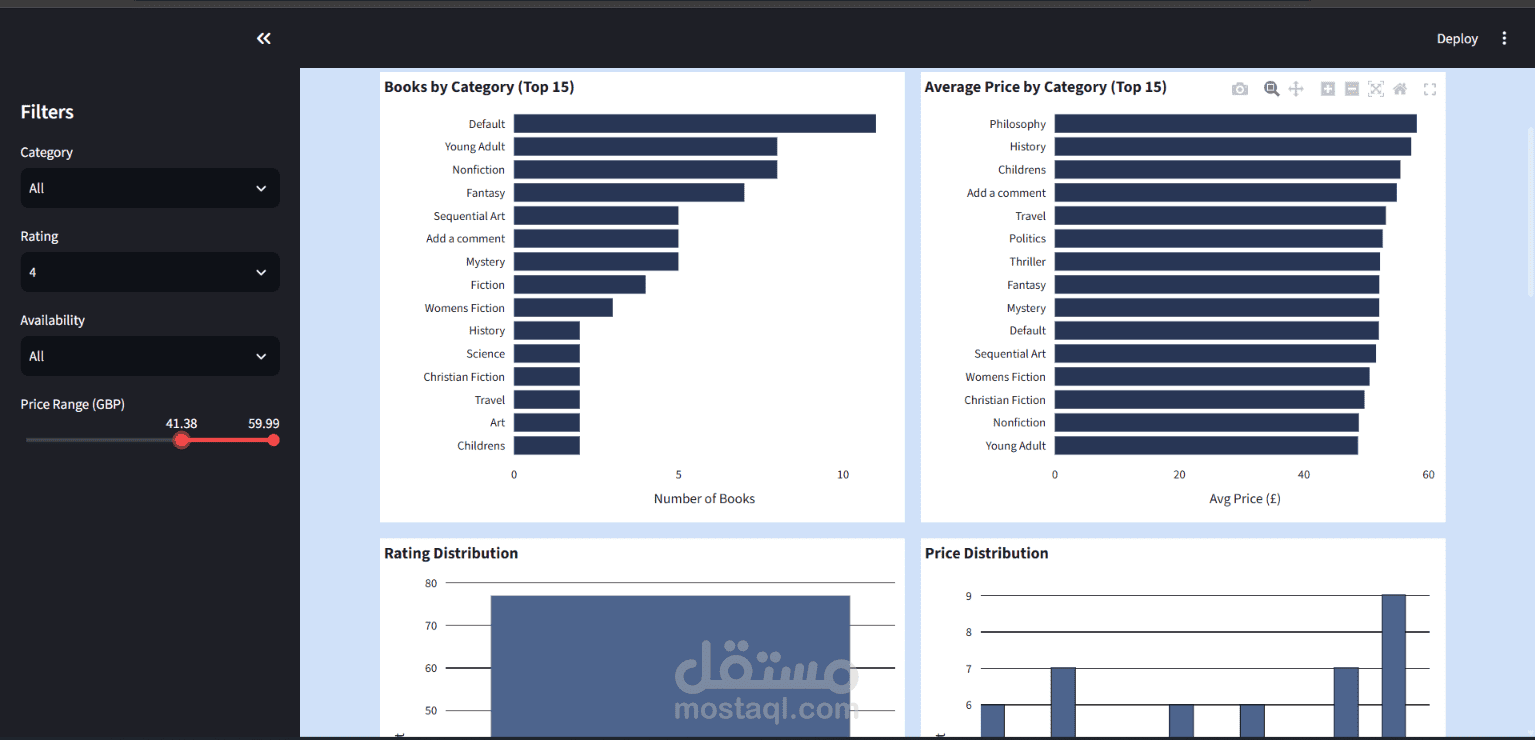
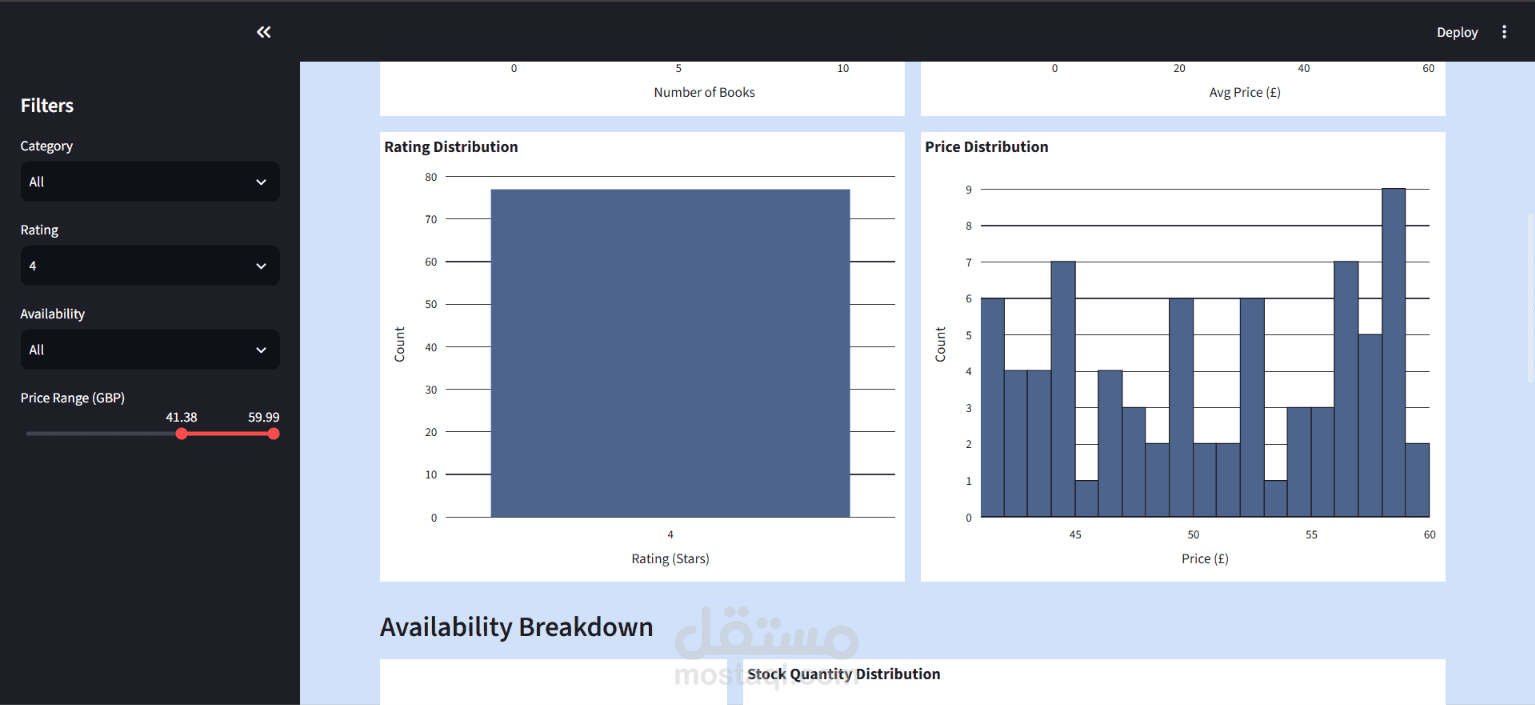
قمت بتطوير مشروع متكامل باستخدام Python لاستخراج ومعالجة وتحليل بيانات الكتب من موقع Books to Scrape، وتحويل البيانات الخام إلى Dataset منظمة وقابلة للتحليل، بالإضافة إلى إنشاء Dashboard تفاعلية لعرض النتائج.
أبرز ما تم تنفيذه:
• استخراج بيانات 1,000 كتاب من 50 صفحة من الموقع.
• استخراج التفاصيل من صفحات المنتجات، مع نجاح 1,000 من أصل 1,000 عملية استخراج.
• جمع بيانات تشمل:
* اسم الكتاب
* التصنيف
* السعر
* التقييم
* حالة التوفر
* UPC
* الوصف
* رابط المنتج
* وقت استخراج البيانات
• تنفيذ Data Cleaning وData Validation للتأكد من جودة البيانات.
• التعامل مع Missing Values وDuplicate Records والتحقق من صحة الحقول.
• حفظ البيانات بصيغ CSV وExcel.
• إنشاء Raw Dataset وProcessed Dataset للحفاظ على مراحل الـ Data Pipeline.
• إضافة Logging لمتابعة عمليات الـ Scraping ومعرفة حالة التنفيذ.
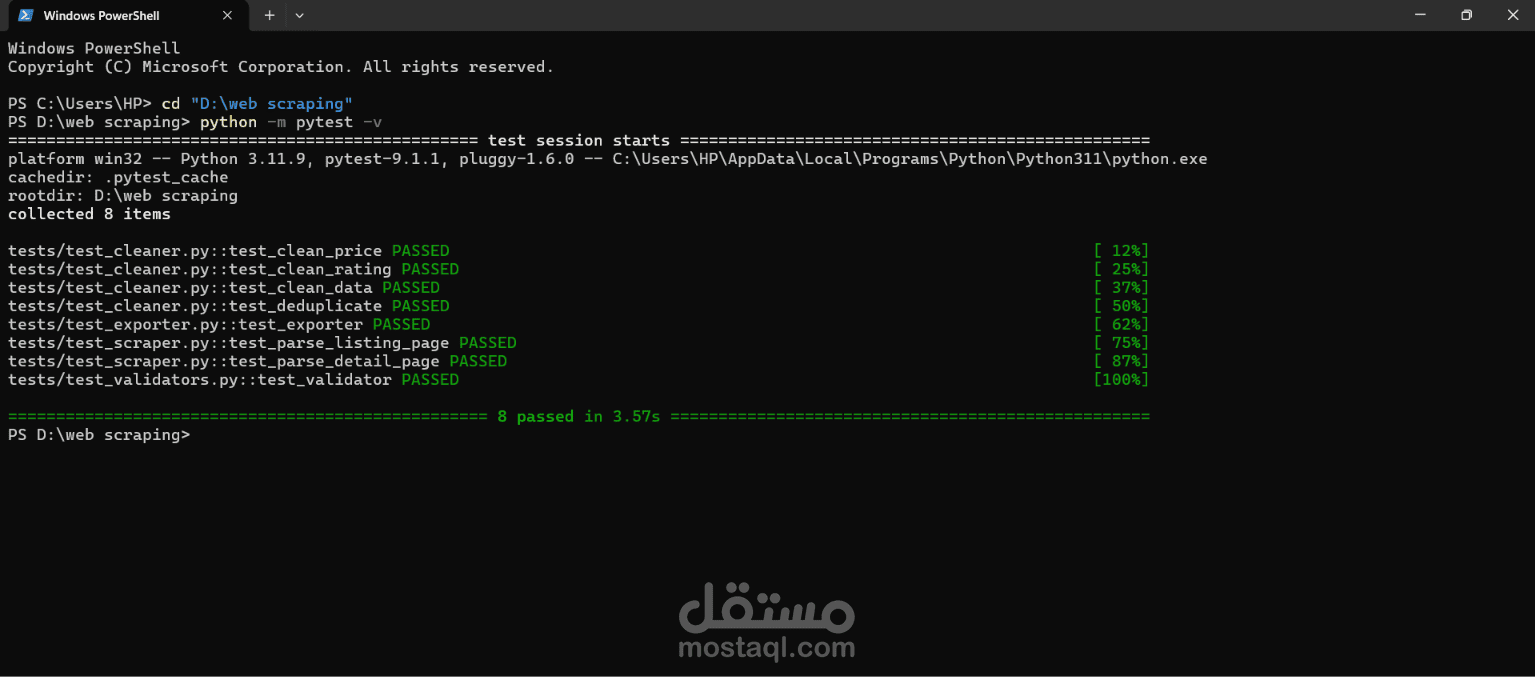
• بناء Automated Tests باستخدام pytest، ونجاح جميع الاختبارات: 8/8.
• تطوير Dashboard تفاعلية باستخدام Streamlit وPlotly لعرض:
* إجمالي عدد الكتب
* متوسط الأسعار
* متوسط التقييمات
* عدد التصنيفات
* معدل التوفر
* توزيع الأسعار والتقييمات
* تحليل الأسعار حسب التصنيف
* جدول تفاعلي للبيانات مع روابط المنتجات
* Filters للتفاعل مع البيانات
التقنيات المستخدمة:
Python — Requests — BeautifulSoup — Pandas — OpenPyXL — pytest — Streamlit — Plotly — CSV — Excel — Logging
المشروع تم تصميمه بطريقة Modular Architecture بحيث تكون مراحل الـ Scraping وCleaning وValidation وExport والـ Dashboard منفصلة وقابلة للتطوير.
النتيجة النهائية هي Data Pipeline متكاملة تبدأ من استخراج البيانات من الويب، مرورًا بالمعالجة والتحقق من الجودة، وانتهاءً بعرض البيانات وتحليلها من خلال Dashboard تفاعلية.