أداة Python لتقسيم ودمج ملفات PDF واستخراج الجداول إلى Excel
تفاصيل العمل
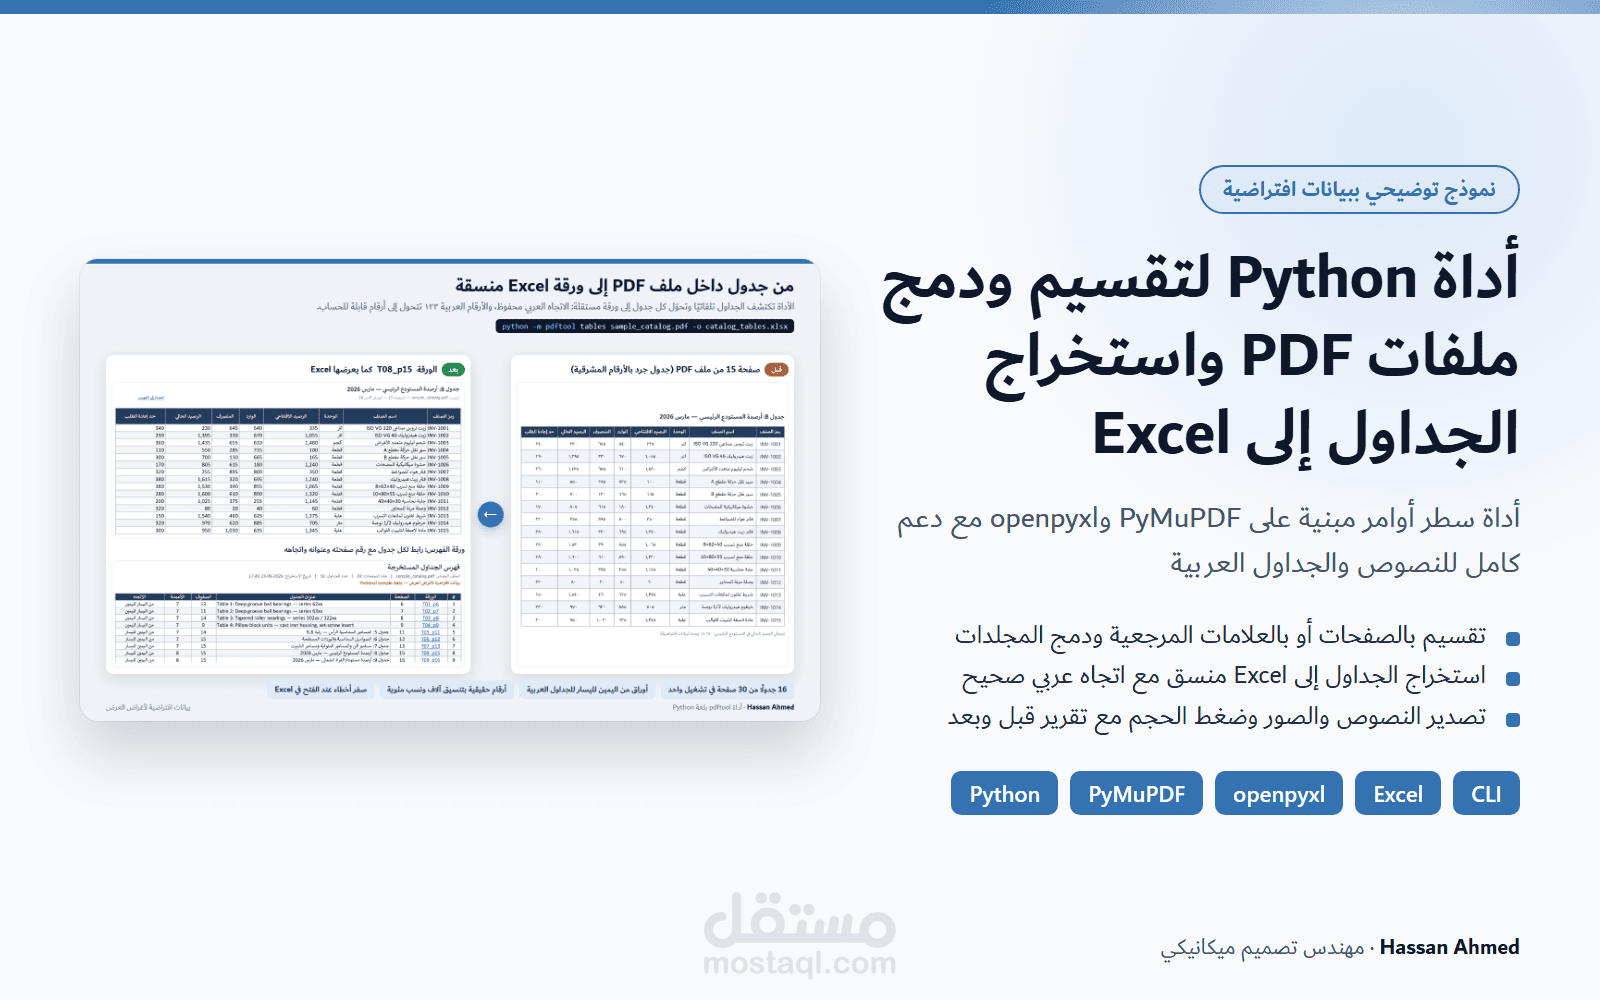
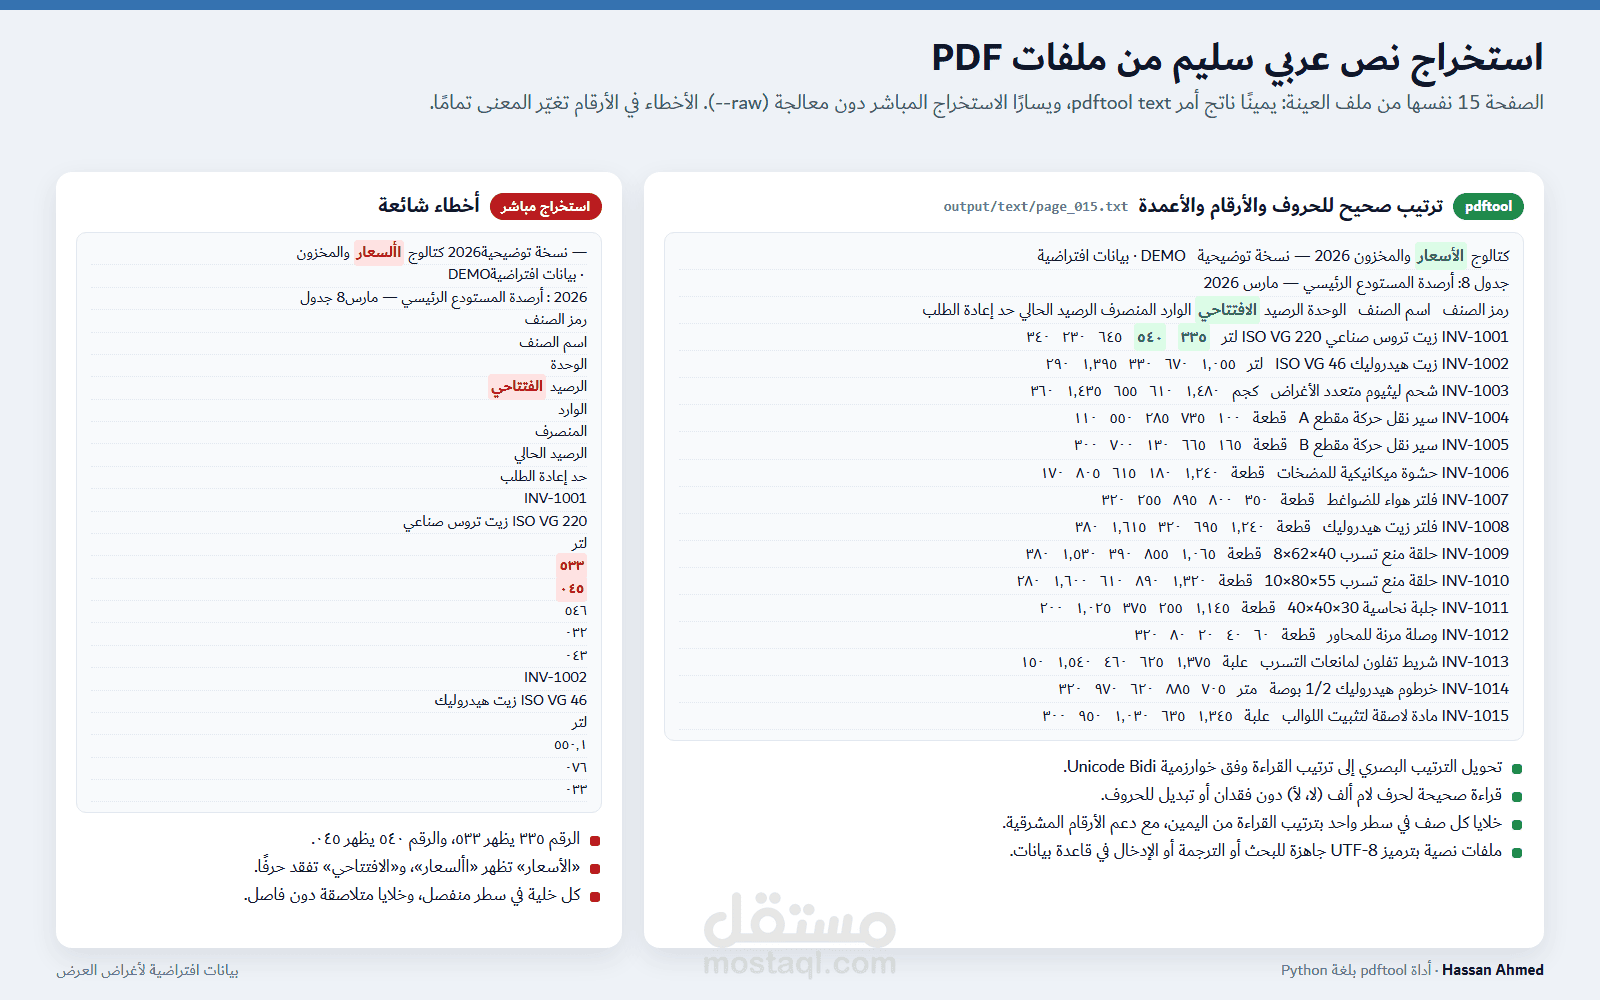
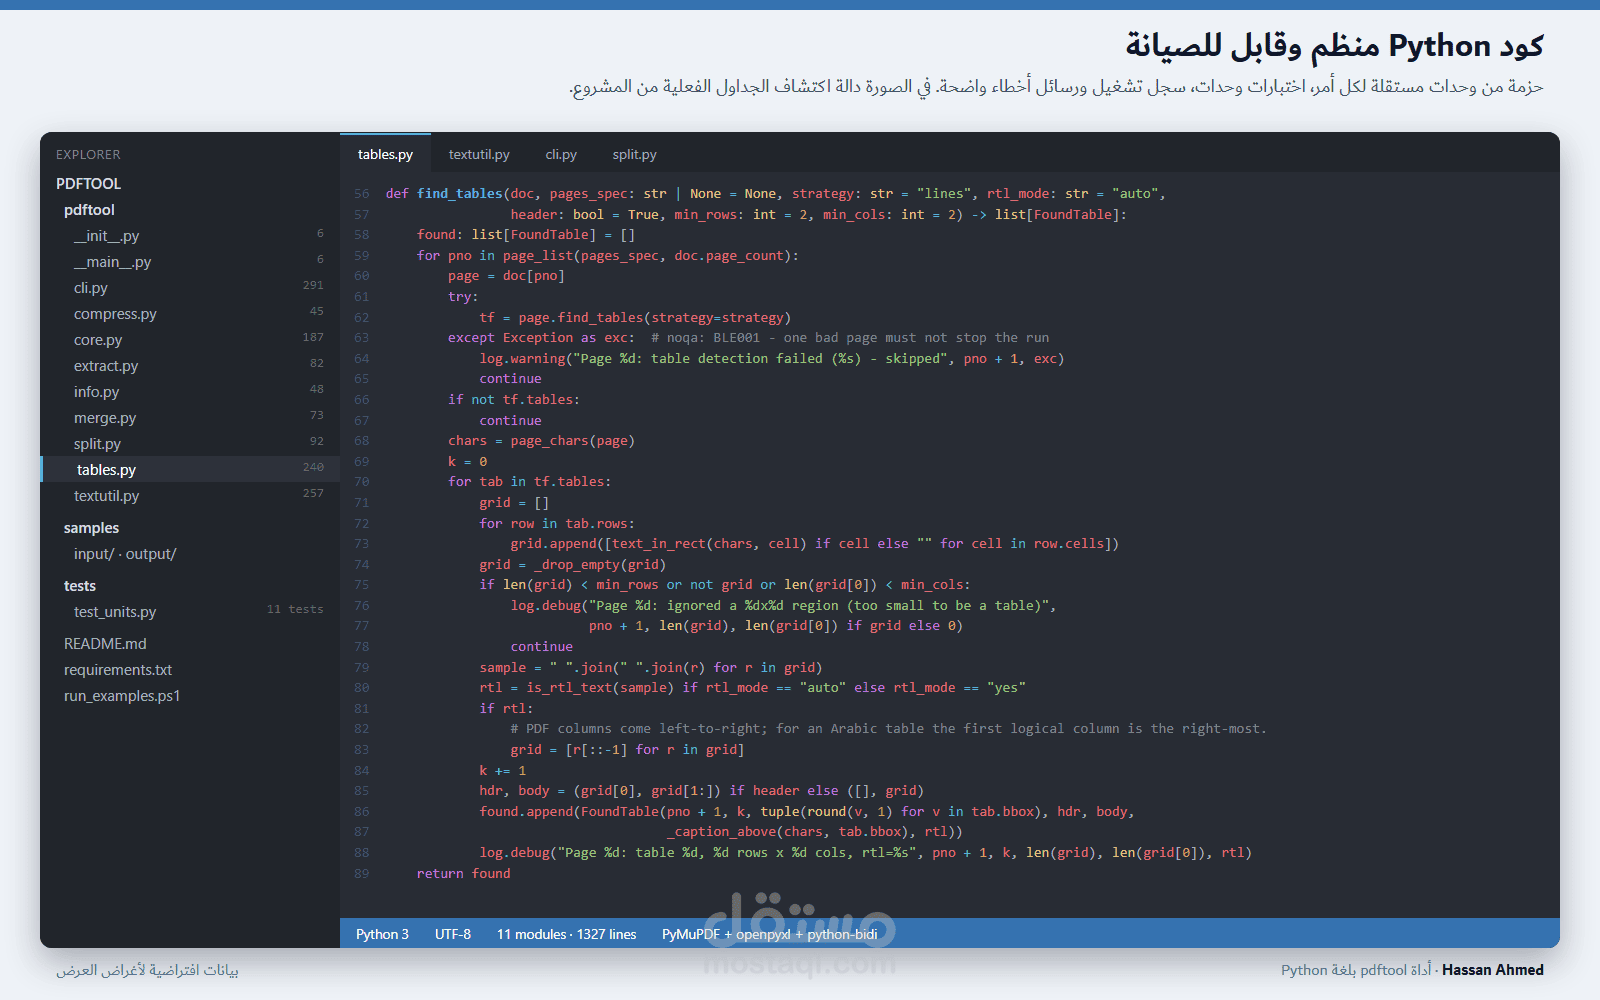
أداة سطر أوامر مكتوبة بلغة Python لمعالجة ملفات PDF دفعة واحدة، مبنية على مكتبتي PyMuPDF وopenpyxl، ومصممة لتتعامل بدقة مع النصوص والجداول العربية.
ما الذي تقدمه الأداة:
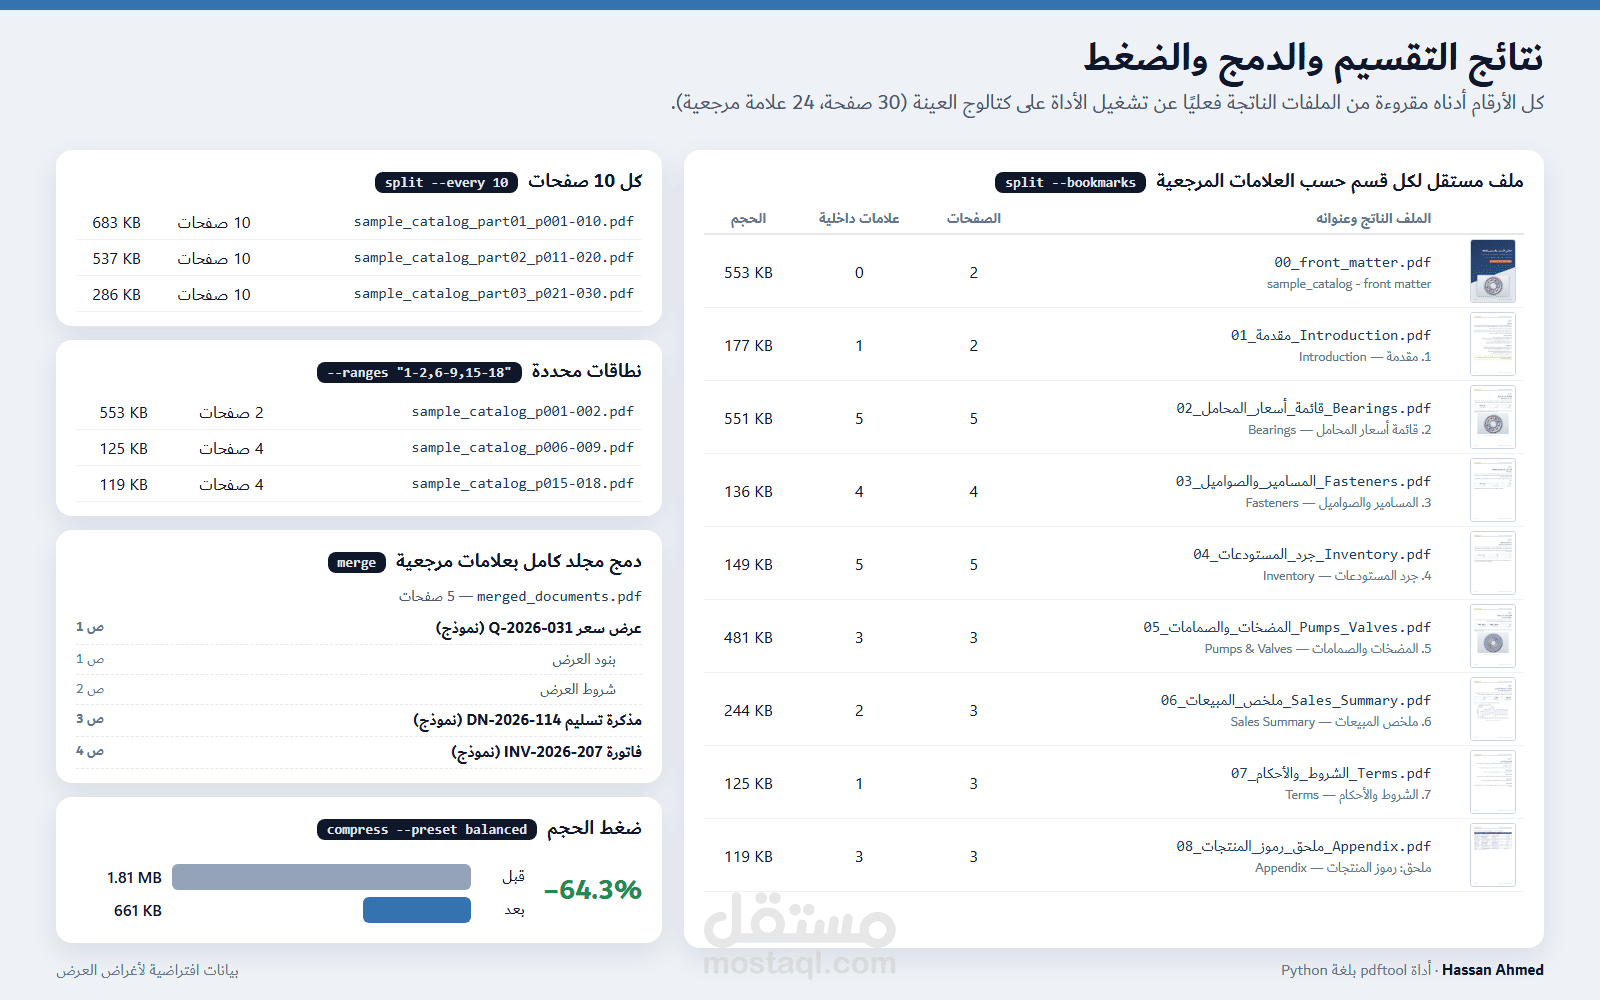
• تقسيم الملف كل عدد من الصفحات، أو حسب نطاقات محددة، أو إلى ملف لكل قسم وفق العلامات المرجعية.
• دمج مجلد كامل في ملف واحد مع علامة مرجعية لكل ملف.
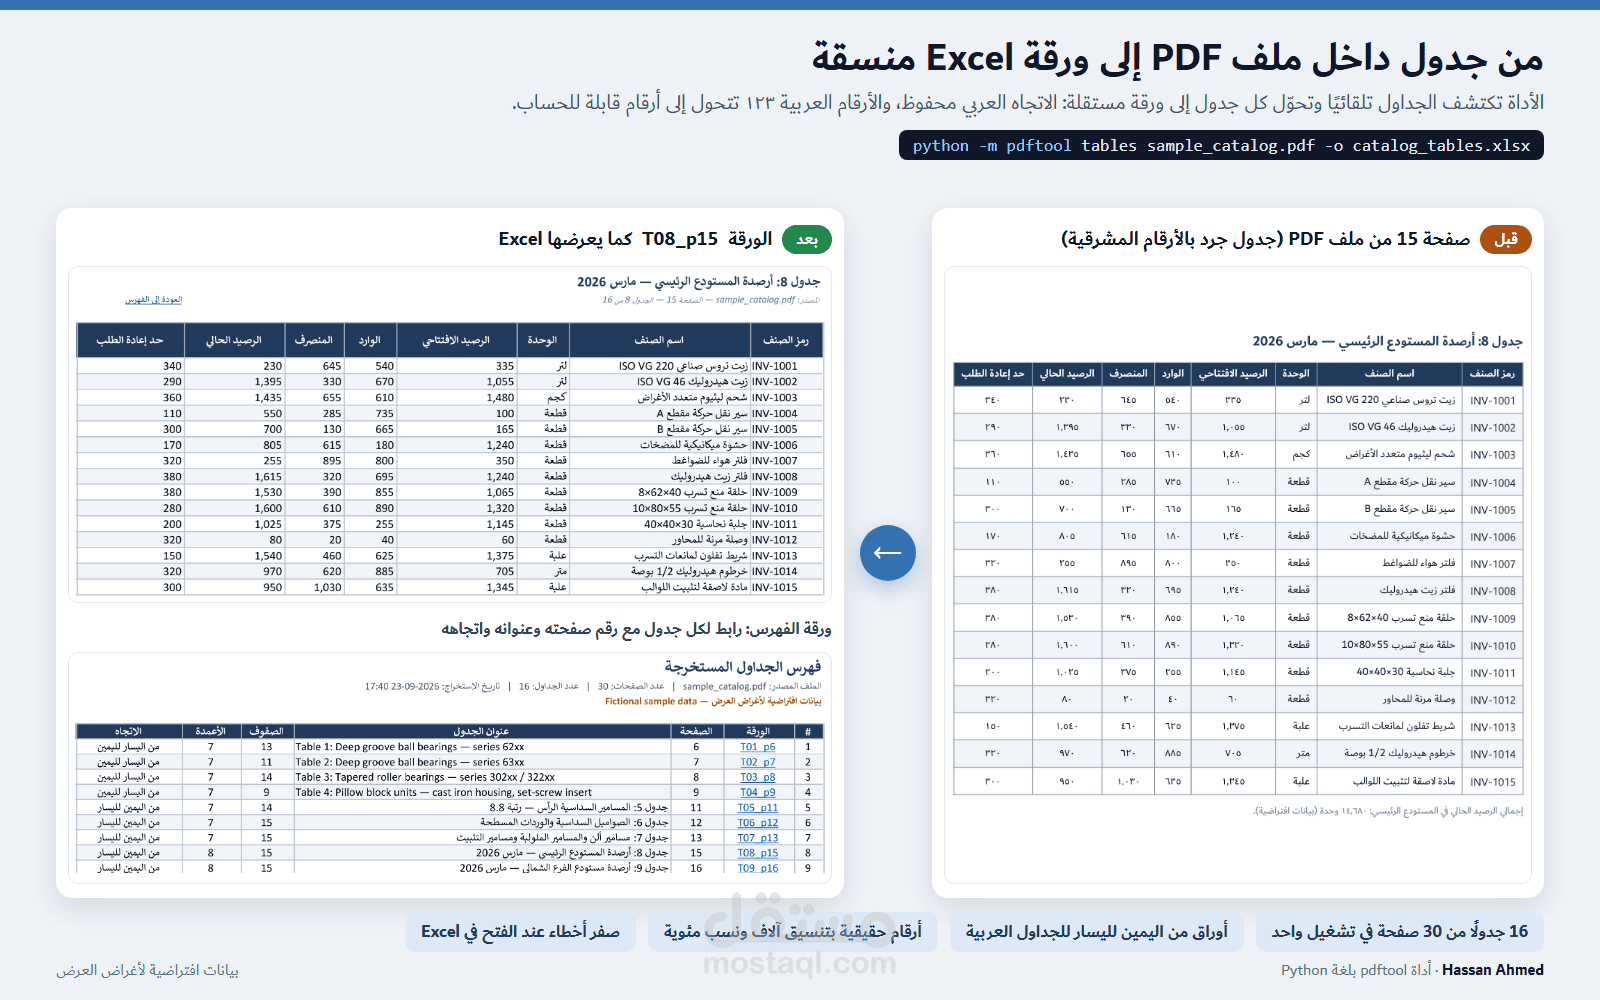
• اكتشاف الجداول وتصديرها إلى Excel: ورقة فهرس بروابط، وورقة منسقة لكل جدول مع رقم صفحته في الملف الأصلي، واتجاه من اليمين لليسار للجداول العربية، وتحويل الأرقام العربية المشرقية إلى أرقام قابلة للحساب.
• استخراج نص كل صفحة إلى ملفات UTF-8 بترتيب صحيح للحروف والأرقام العربية، وتصدير الصور المضمنة.
• ضغط حجم الملف مع تقرير قبل وبعد.
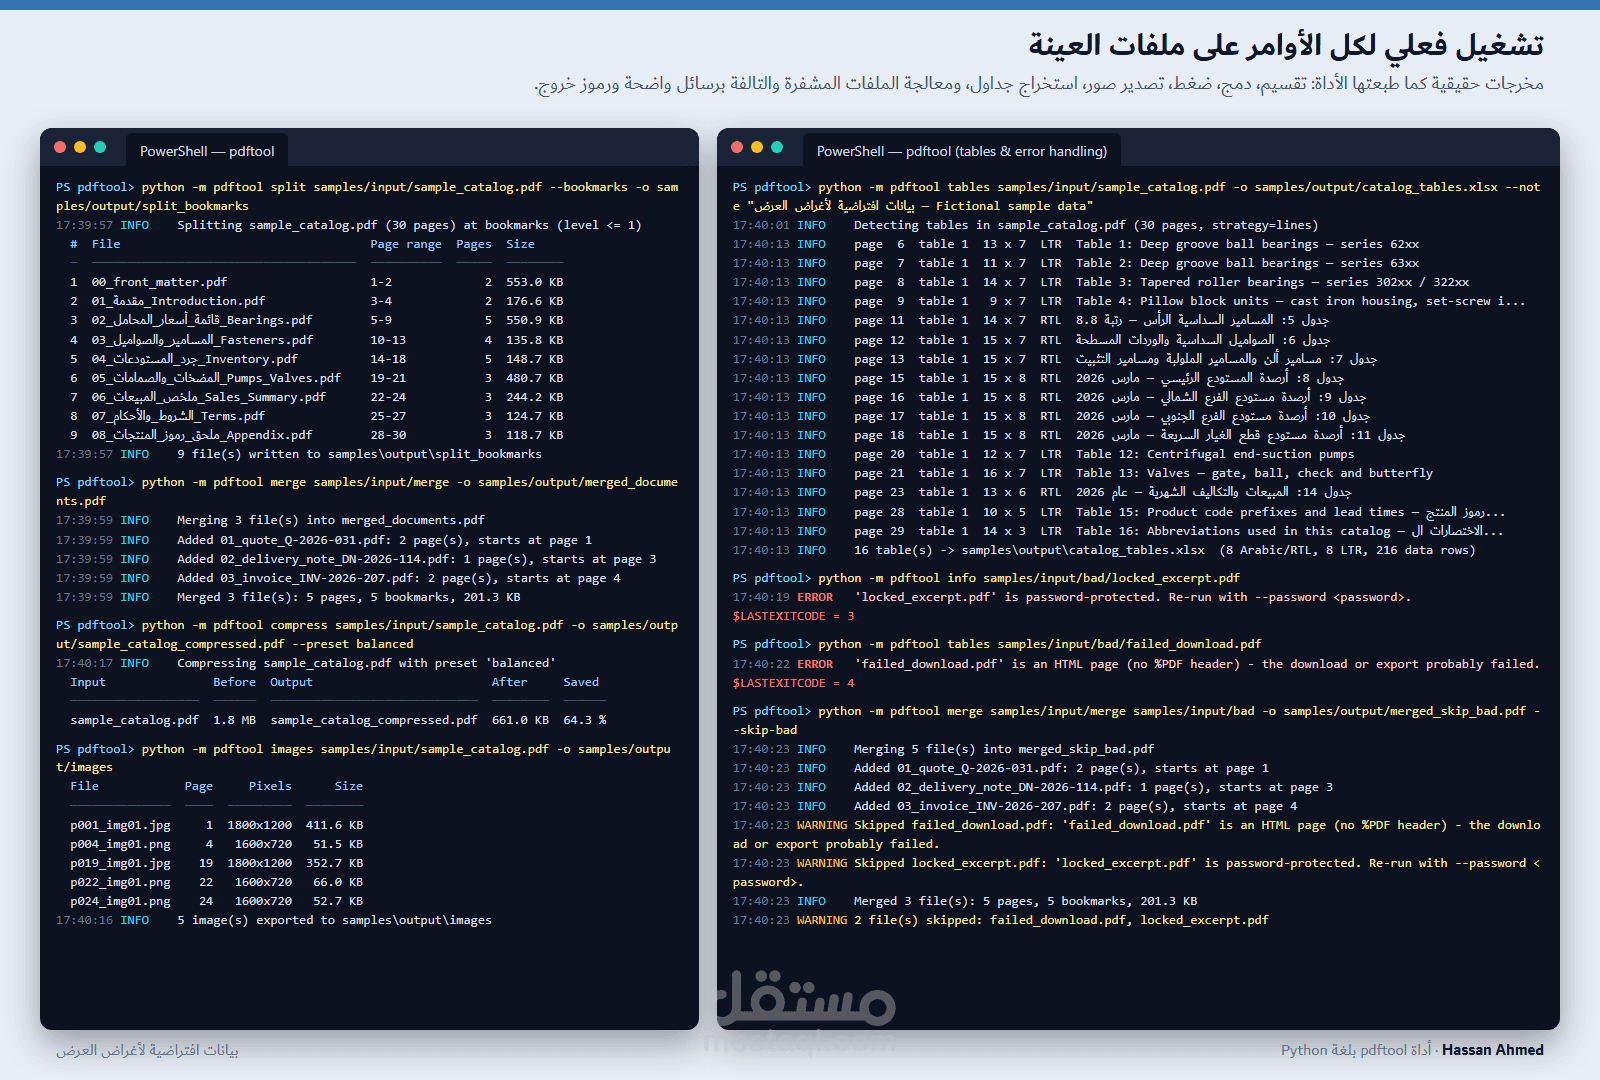
• رسائل أخطاء واضحة ورموز خروج للملفات المشفرة والتالفة، وسجل تشغيل مفصل.
كيف نُفذ العمل:
شغّلت جميع الأوامر فعليًا على كتالوج تجريبي من 30 صفحة يضم 16 جدولًا بالعربية والإنجليزية، فنتج مصنف Excel من 17 ورقة يُفتح دون أي قيمة خطأ، وانخفض حجم الملف بنسبة 64%. المشروع مرفق كاملًا مع دليل استخدام بالعربية والإنجليزية واختبارات وملفات العينة ومخرجاتها.
يمكنك أن تطلب بناءً على هذا العمل:
• تحويل جداول ملفات PDF لديك، كقوائم الأسعار والكشوف، إلى Excel.
• أداة مخصصة لتقسيم مئات الملفات أو دمجها أو إعادة تسميتها آليًا.
• استخراج نصوص عربية سليمة من ملفات PDF لأغراض البحث أو الترجمة.
نموذج توضيحي ببيانات افتراضية.