Smart PDF Data Cleaner
تفاصيل العمل
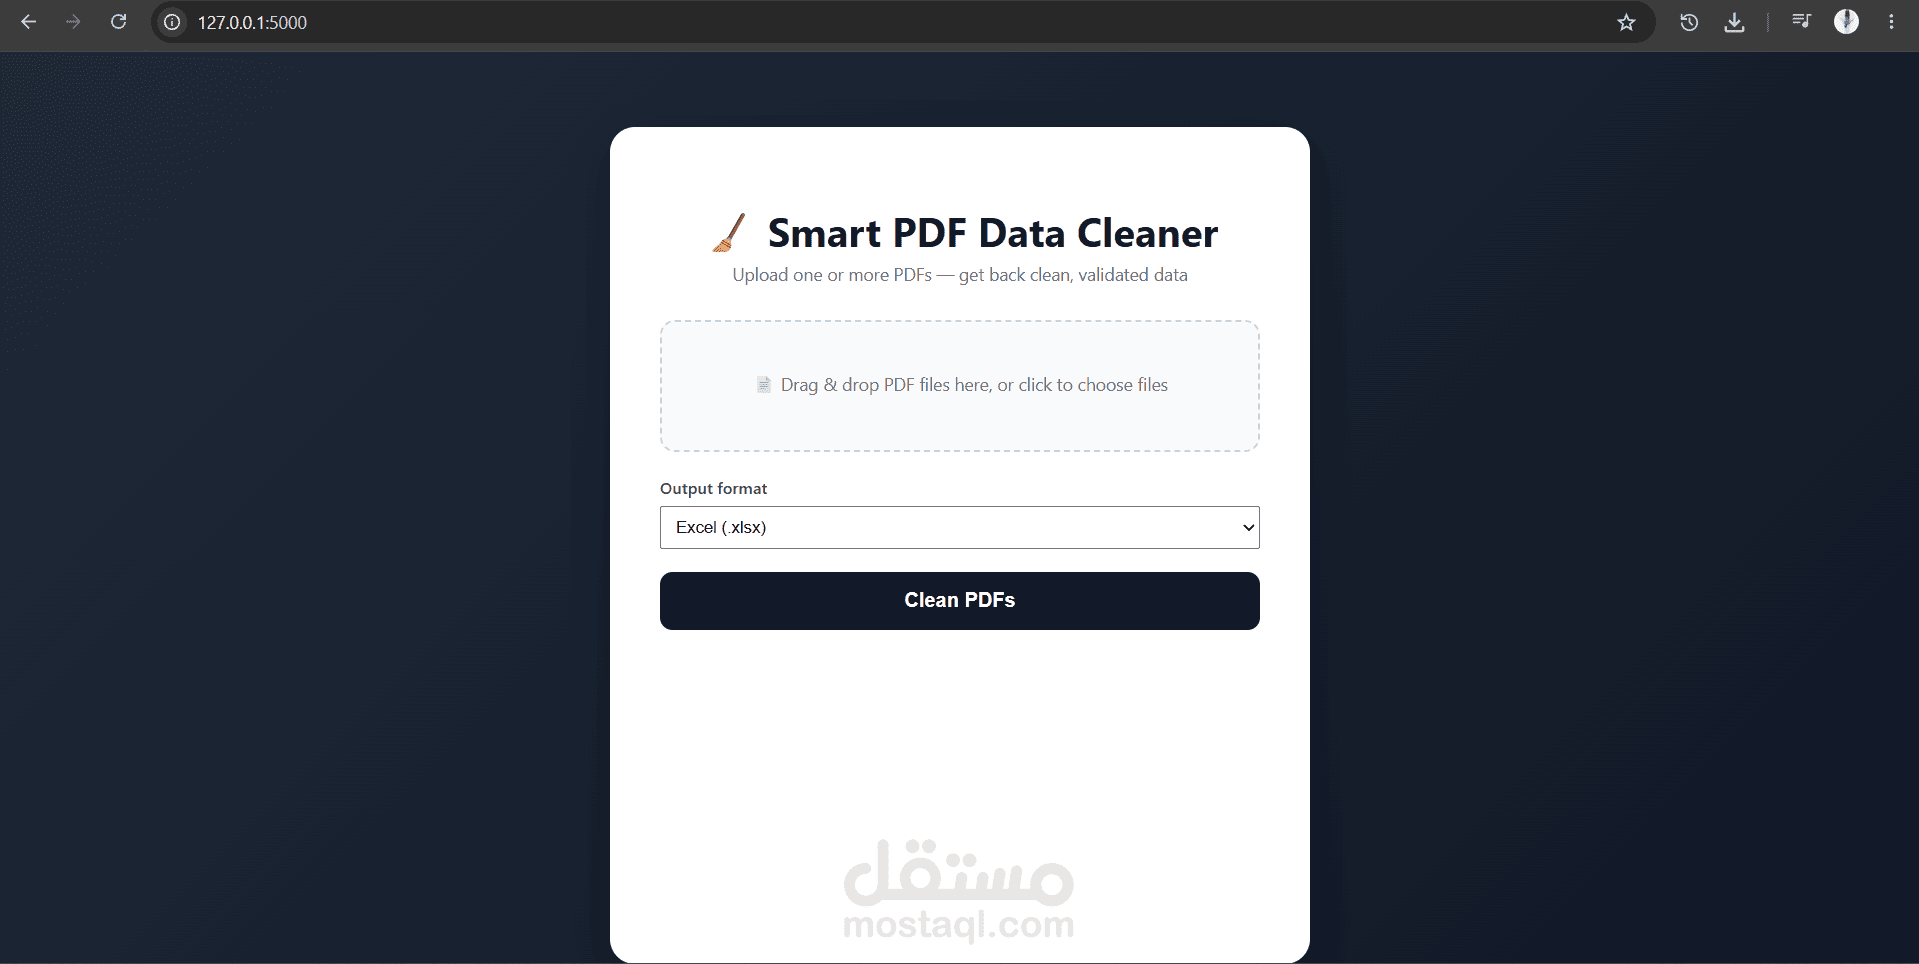
أداة برمجية لمعالجة وتنظيف البيانات الموجودة داخل ملفات PDF وتحويل الجداول غير المنظمة إلى بيانات منظمة وقابلة للاستخدام.
تم تطوير الأداة باستخدام Python وFlask، وتقوم باستخراج الجداول من ملفات PDF وتنظيف البيانات تلقائيًا، مع التحقق من صحة القيم وفصل البيانات التي تحتاج إلى مراجعة.
يشمل المشروع:
* استخراج الجداول والبيانات من ملفات PDF.
* دعم عدة جداول داخل نفس الملف.
* دمج الجداول الممتدة على عدة صفحات.
* تنظيف الأرقام والقيم التي تحتوي على رموز العملات.
* التحقق من صحة البريد الإلكتروني والتواريخ.
* اكتشاف الصفوف المكررة.
* اكتشاف القيم الشاذة (Outliers).
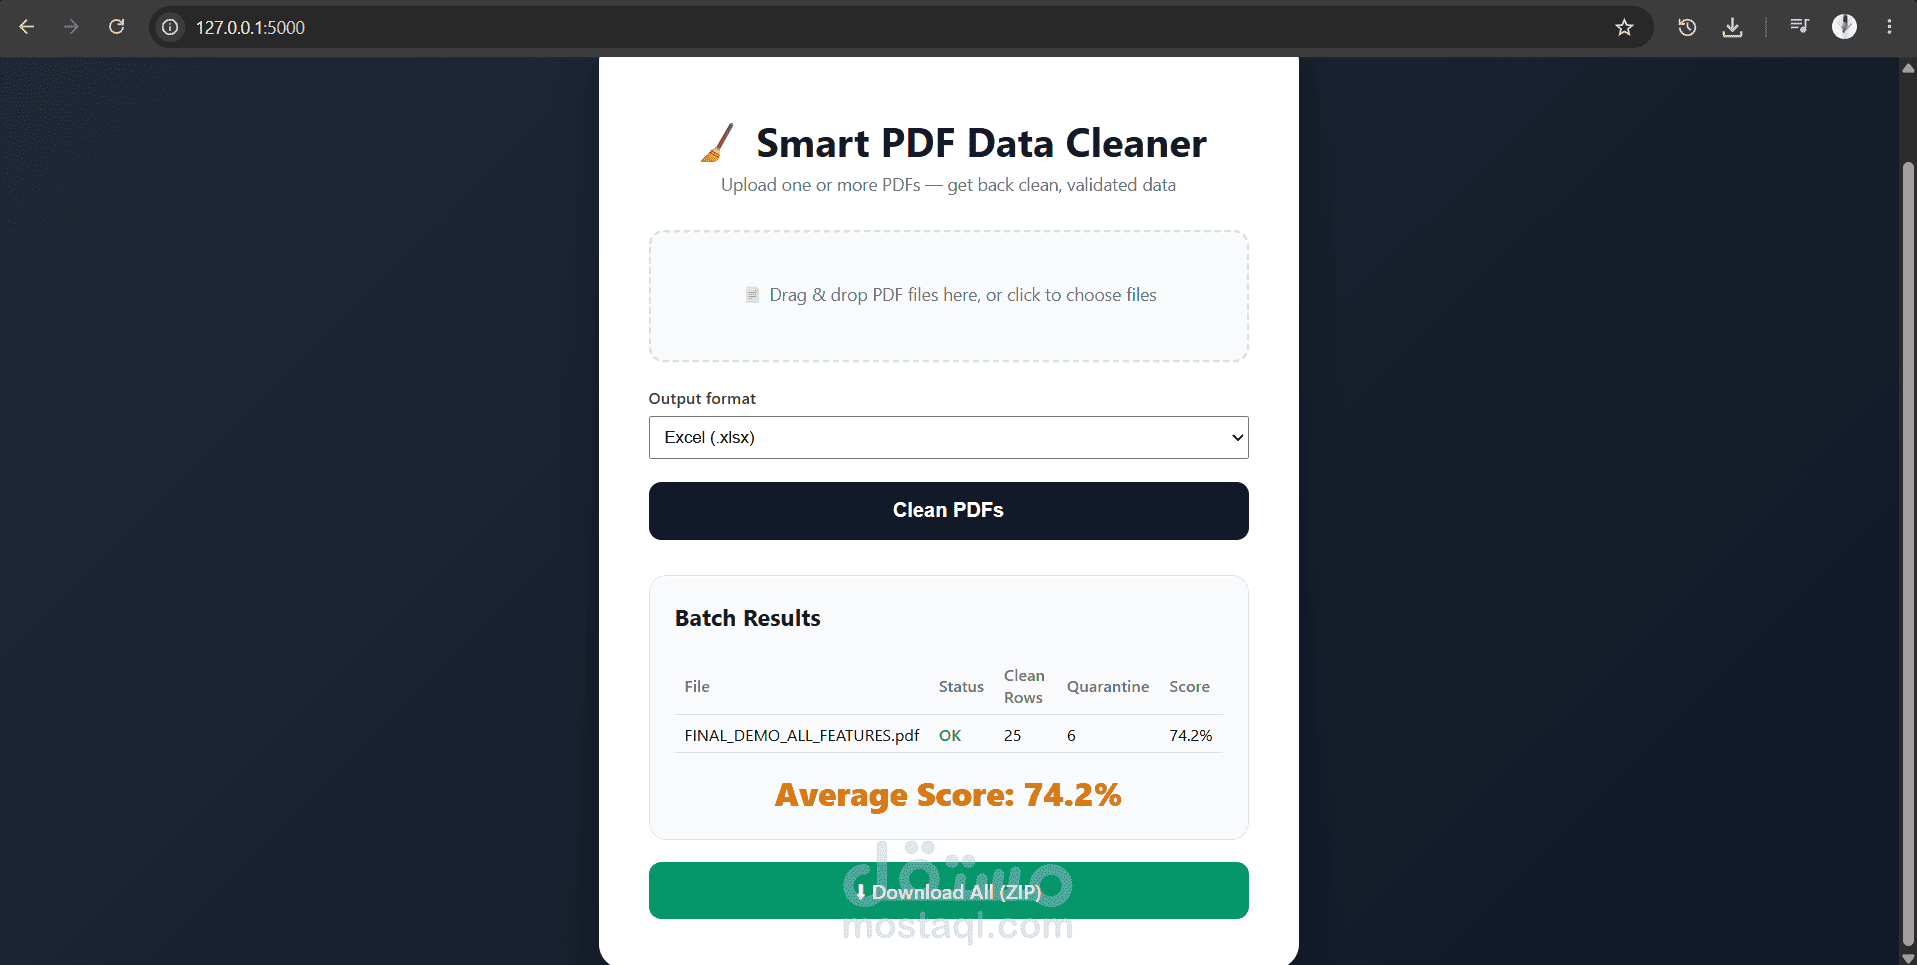
* فصل البيانات إلى Clean Data وQuarantine Data.
* حساب Quality Score لجودة البيانات.
* معالجة عدة ملفات PDF دفعة واحدة (Batch Processing).
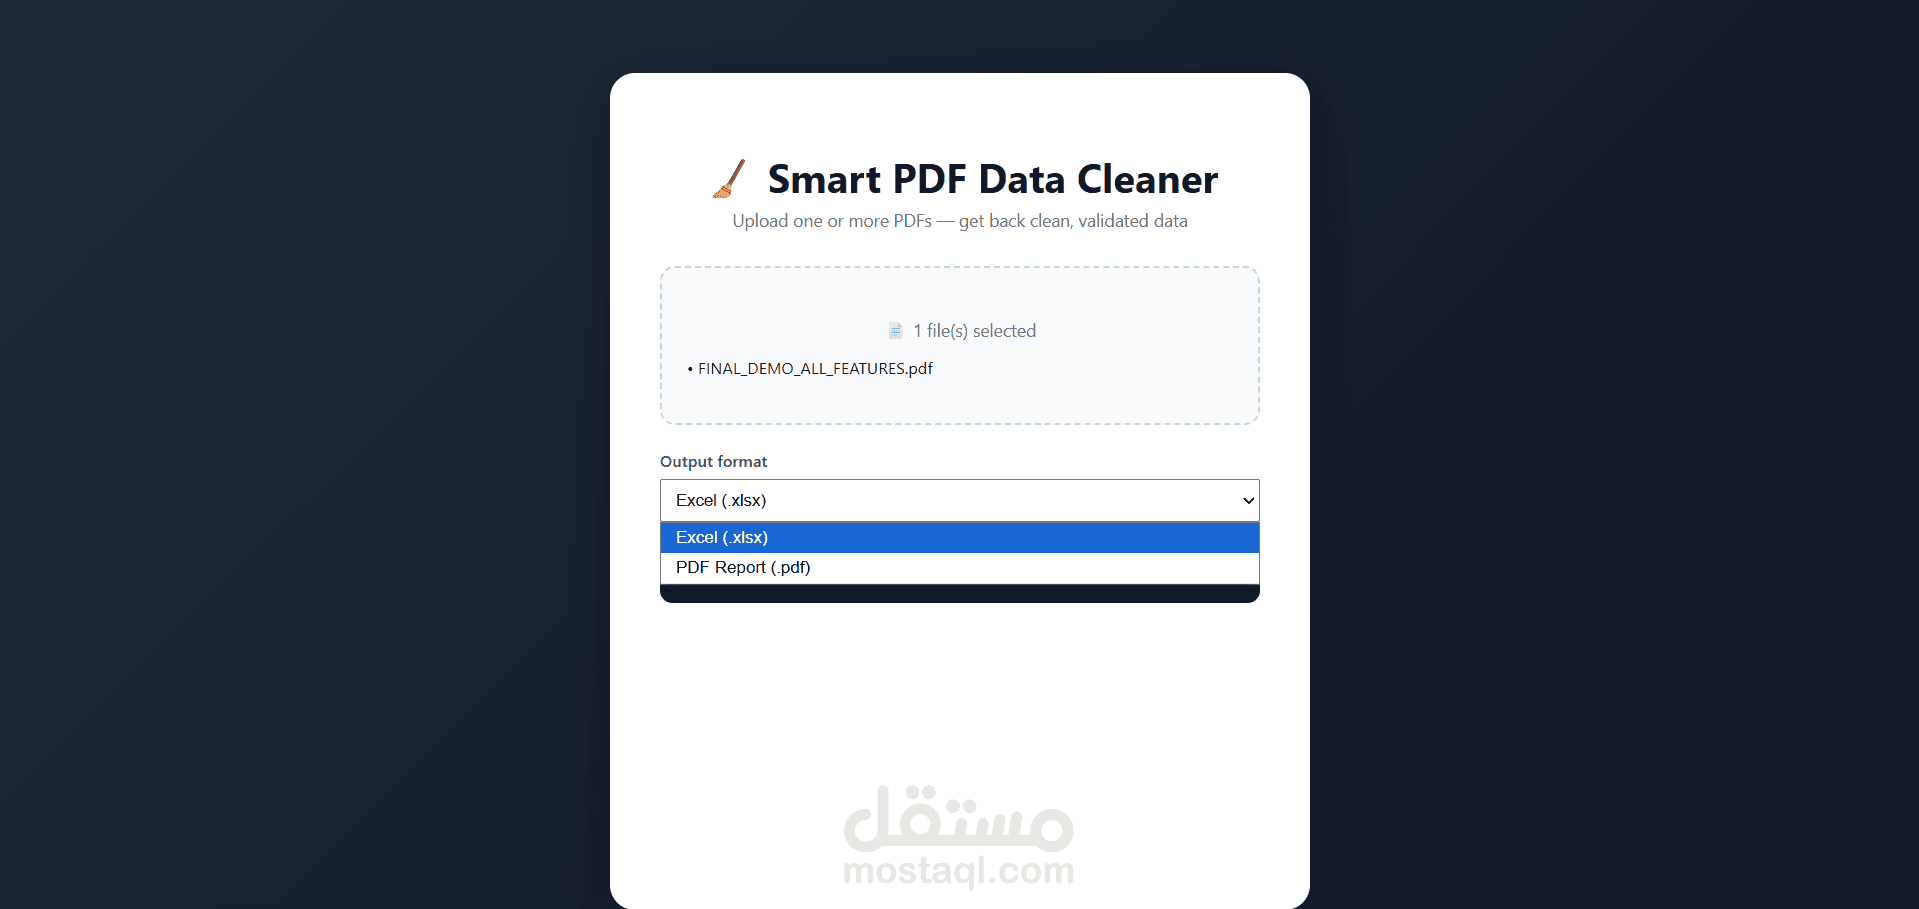
* تصدير النتائج بصيغة Excel أو تقرير PDF.
* تحميل نتائج معالجة عدة ملفات ضمن ملف ZIP.
* معالجة الأخطاء والملفات التالفة أو غير المدعومة بدون توقف النظام.
* واجهة استخدام حديثة تدعم Drag & Drop.
تم اختبار الأداة باستخدام سيناريوهات مختلفة تشمل الجداول المتعددة، الجداول الممتدة على عدة صفحات، والملفات التي لا تحتوي على جداول، مع التأكد من عمل النظام ومعالجة الأخطاء بشكل صحيح.