Emotion Classification
تفاصيل العمل
عنوان المشروع:
تصنيف المشاعر في النصوص باستخدام التعلّم العميق ونماذج Transformers (Emotion Classification)
وصف المشروع:
في هذا المشروع بنيت وقارنت عدة نماذج لتصنيف النصوص الإنجليزية حسب المشاعر التي تعبّر عنها، إلى 6 فئات: الحزن، والفرح، والحب، والغضب، والخوف، والمفاجأة. استخدمت مجموعة بيانات Emotion التي تضم 20,000 نص مقسّمة إلى تدريب وتحقق واختبار. هذا النوع من النماذج مفيد في تحليل آراء العملاء، ومراقبة وسائل التواصل الاجتماعي، وأنظمة خدمة العملاء.
مراحل العمل:
تحليل البيانات: دراسة توزيع الفئات (مع وجود عدم توازن واضح بينها) وأطوال النصوص.
تجهيز النصوص: بناء Tokenizer ومعجم كلمات خاص (7,401 كلمة)، واستخدام Tokenizer الخاص بـ DistilBERT للمقارنة.
نموذج من الصفر: بناء شبكة BiLSTM باستخدام PyTorch، حققت دقة 86.9% على بيانات الاختبار، مع وقت تدريب أقل من 15 ثانية.
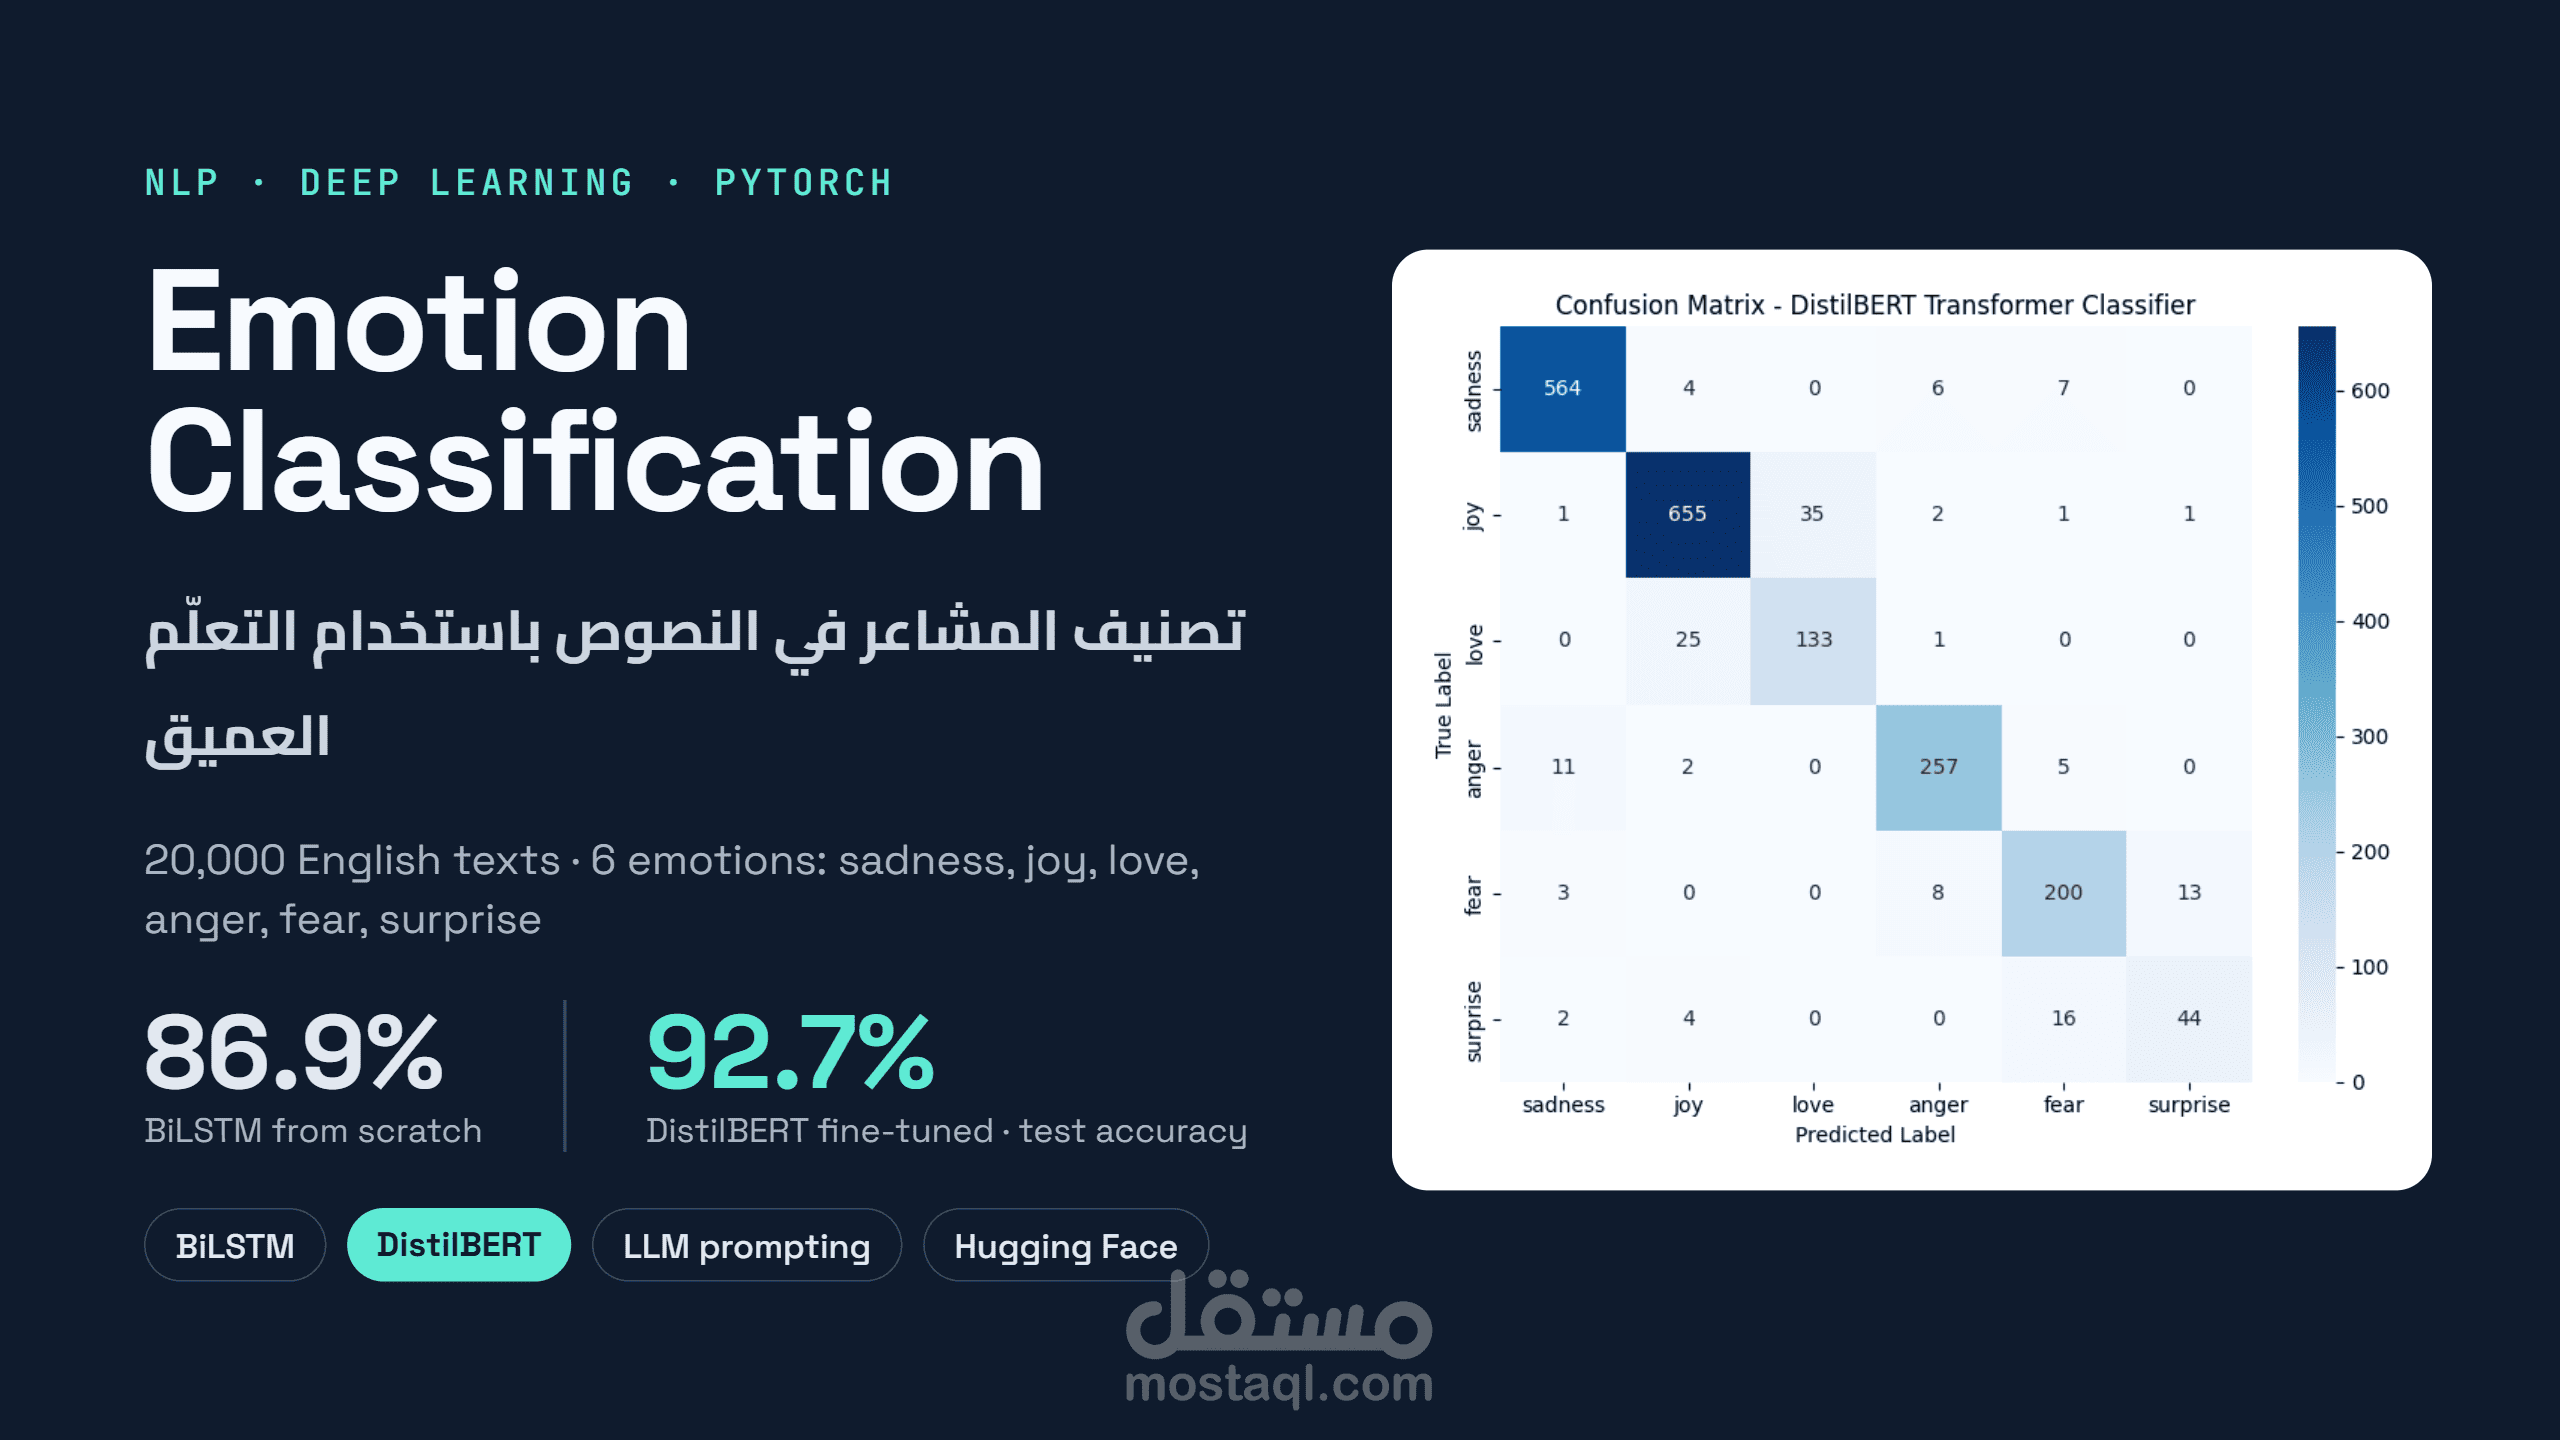
ضبط نموذج Transformer (Fine-tuning): تدريب نموذج DistilBERT على مهمة التصنيف، حقق دقة 92.7% وMacro F1 بقيمة 0.88.
اختبار كفاءة البيانات: إعادة تدريب DistilBERT على عيّنة متوازنة من 498 نصًا فقط لقياس تأثير حجم البيانات على الأداء (دقة 69.5%).
النماذج اللغوية الكبيرة (LLMs): تجربة التصنيف بالتوجيه المباشر (Zero-shot وFew-shot) باستخدام نموذج Qwen2.5-1.5B-Instruct.
التقييم والمقارنة: تقارير Classification Report ومصفوفات الالتباس (Confusion Matrix)، ومقارنة النماذج من حيث الدقة وسرعة التدريب والاستدلال.
الأدوات المستخدمة:
Python – PyTorch – Hugging Face Transformers – Scikit-learn – Pandas – Matplotlib – Seaborn
النتيجة:
مقارنة عملية توضّح متى يكون النموذج الخفيف كافيًا، ومتى يستحق نموذج Transformer تكلفته الإضافية. يمكن تطبيق نفس المنهجية على تقييمات العملاء أو التعليقات أو أي نصوص باللغة العربية أو الإنجليزية