RFM Analysis
تفاصيل العمل
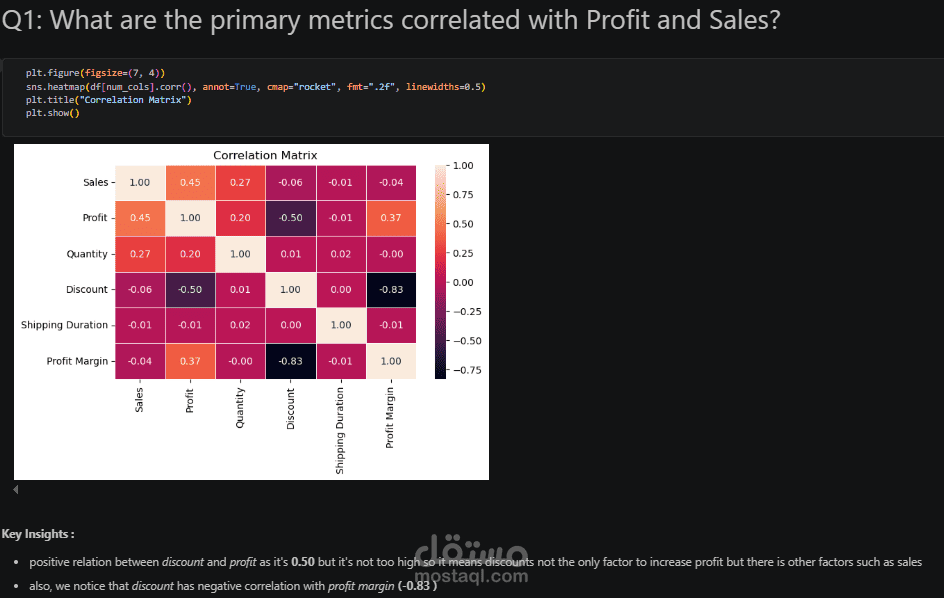
مشروع تحليلي يستهدف تقسيم شرائح العملاء ودراسة سلوكهم الشرائي لمنشأة تجارية (Superstore Dataset) باستخدام لغة Python، وذلك للمساعدة في اتخاذ قرارات تسويقية مبنية على البيانات وزيادة نسبة احتفاظ الشركة بالعملاء (Customer Retention).
الخطوات والتنفيذ العملي:
Data Cleaning & Preparation):
التعامل مع القيم المفقودة (Null Values) وتكرار البيانات (Duplicates).
استبعاد الطلبات المرجعة (Returned Orders) لضمان دقة الحسابات المالية.
تهيئة الحقول الزمنية وحساب القيم المباشرة لكل عميل.
حساب مؤشرات RFM الرئيسية:
Recency (R): قياس مدى حداثة آخر عملية شراء للعميل.
Frequency (F): حساب إجمالي تكرار عمليات الشراء.
Monetary (M): حساب إجمالي إنفاق العميل.
Quantile Scoring & Segmentation:
استخدام دالة pd.qcut لتوزيع درجات العملاء بشكل متوازن.
تطبيق قواعد ومنطق الأعمال (Business Logic) لتصنيف العملاء إلى شرائح دقيقة مثل: العملاء المميزين (Champions)، العملاء المهددين بالمغادرة (At-Risk)، والعملاء المفقودين (Lost Customers).
Data Visualization & Insights:
إنشاء خرائط حرارية (Heatmaps) لتحليل التفاعل بين حداثة الشراء وتكراره (R-F Analysis).
تصميم مخططات شريطية (Bar Charts) لتوضيح توزيع الشرائح مختلفة.
استخدام المخططات النقطية (Scatter Plots) لفهم سلوكيات الإنفاق بصورة أعمق.
الأدوات والتقنيات المستخدمة:
اللغة: Python
المكتبات: Pandas, NumPy, Matplotlib, Seaborn
المخرجات القابلة للتطبيق (Business Value):
تزويد فريق التسويق برؤى تحليلية دقيقة تُمكنهم من توجيه الحملات الإعلانية المخصصة لكل شريحة، مما يرفع من كفاءة الميزانية التسويقية ويزيد من القيمة الإجمالية للعميل (Customer Lifetime Value).