Mushroom Classification: Edible or Poisonous? | Machine Learning with Python
تفاصيل العمل
🍄 صالح للأكل ولا سام؟
موديل Machine Learning بيجاوب
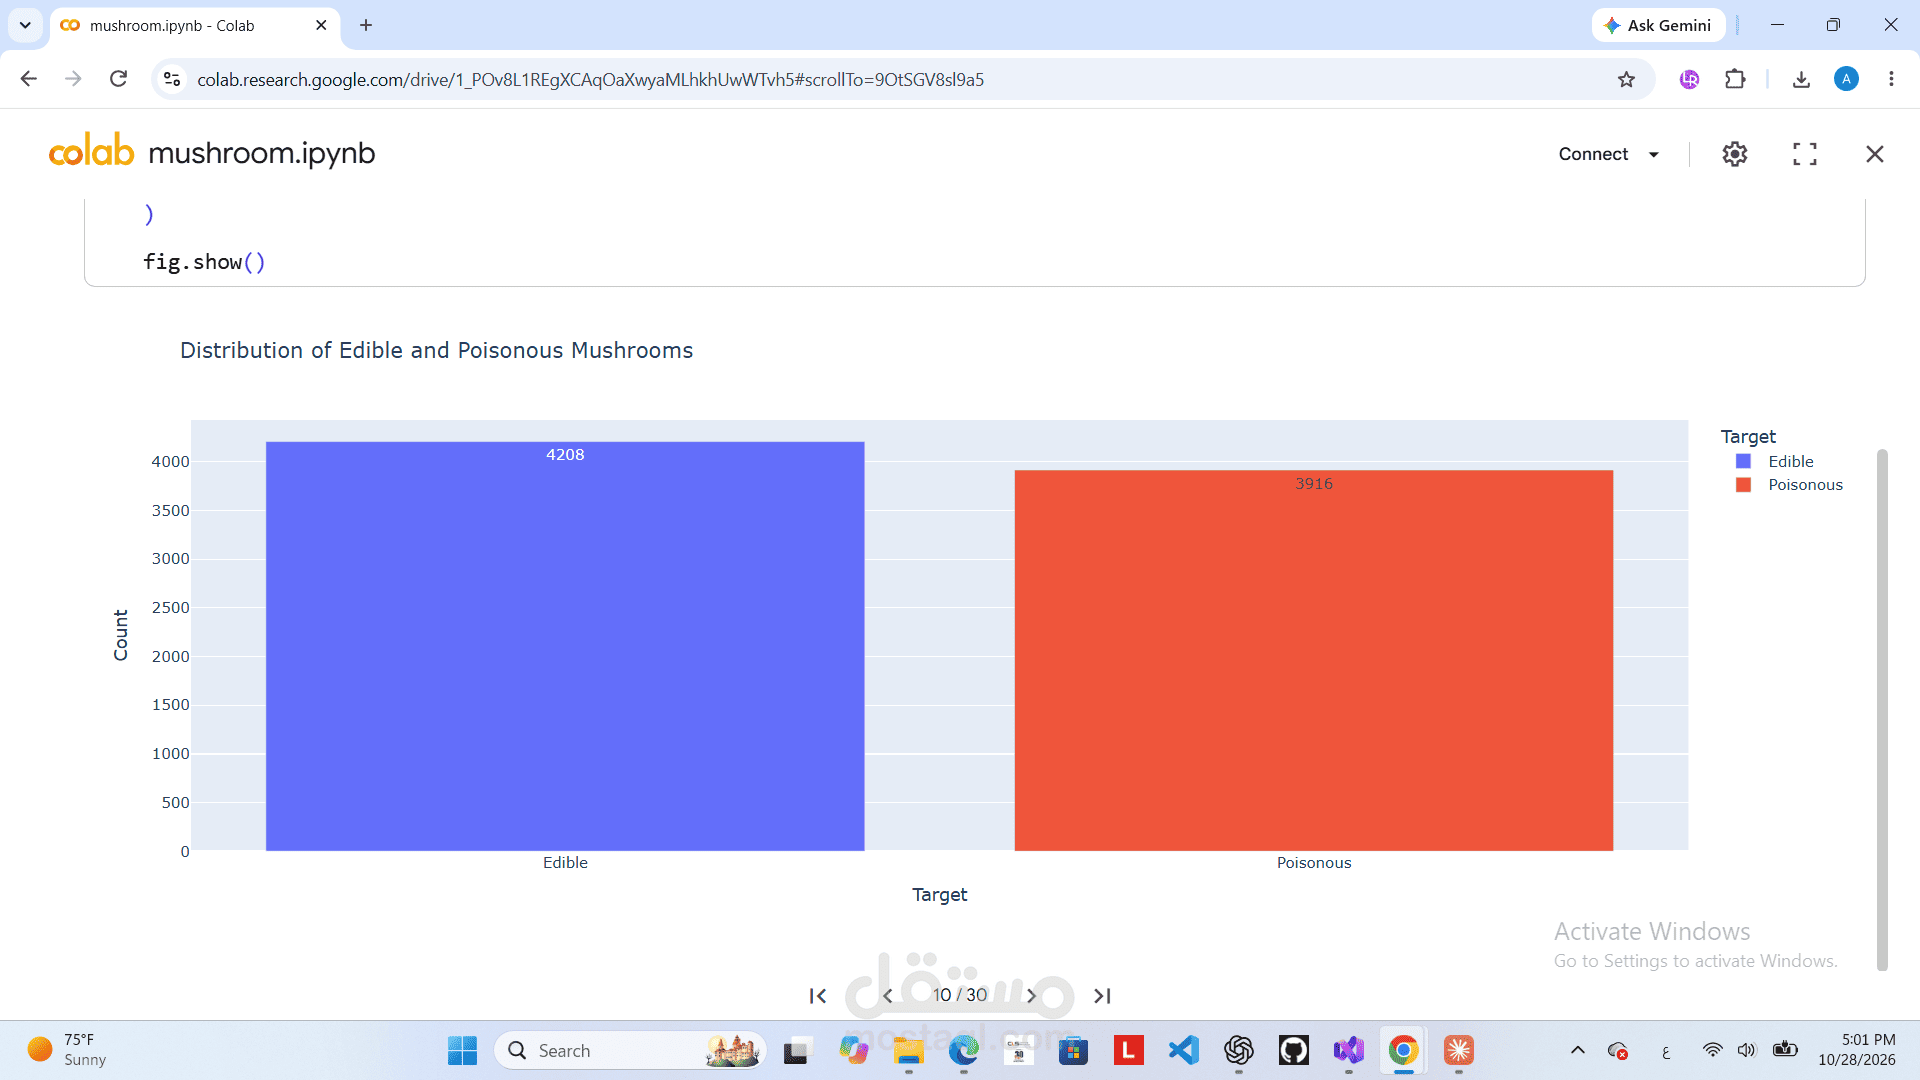
غلطة واحدة في تصنيف فطر سام على إنه صالح ممكن تكون خطيرة. عشان كده بنيت مشروع تصنيف كامل على بيانات 8,124 عينة فطر (4,208 صالح للأكل و3,916 سام)، وركزت فيه على إن الموديل يكتشف الفطر السام بدقة، مش على الدقة العامة بس.
اللي عملته في المشروع:
🔍 فحص وتنظيف البيانات (Data Inspection & Cleaning)
فحصت البيانات بـ Pandas وتأكدت إن مفيش صفوف مكررة
اكتشفت عمود stalk-root فيه 2,480 قيمة مفقودة (حوالي 30% من الداتا) وعالجتها بـ SimpleImputer بالقيمة الأكثر تكرارًا
حوّلت كل الأعمدة الفئوية لصيغة رقمية بـ OneHotEncoder عشان الموديلات تفهمها
📊 تحليل ورسومات تفاعلية (Data Visualization بـ Plotly)
حللت توزيع الفئتين (صالح / سام)
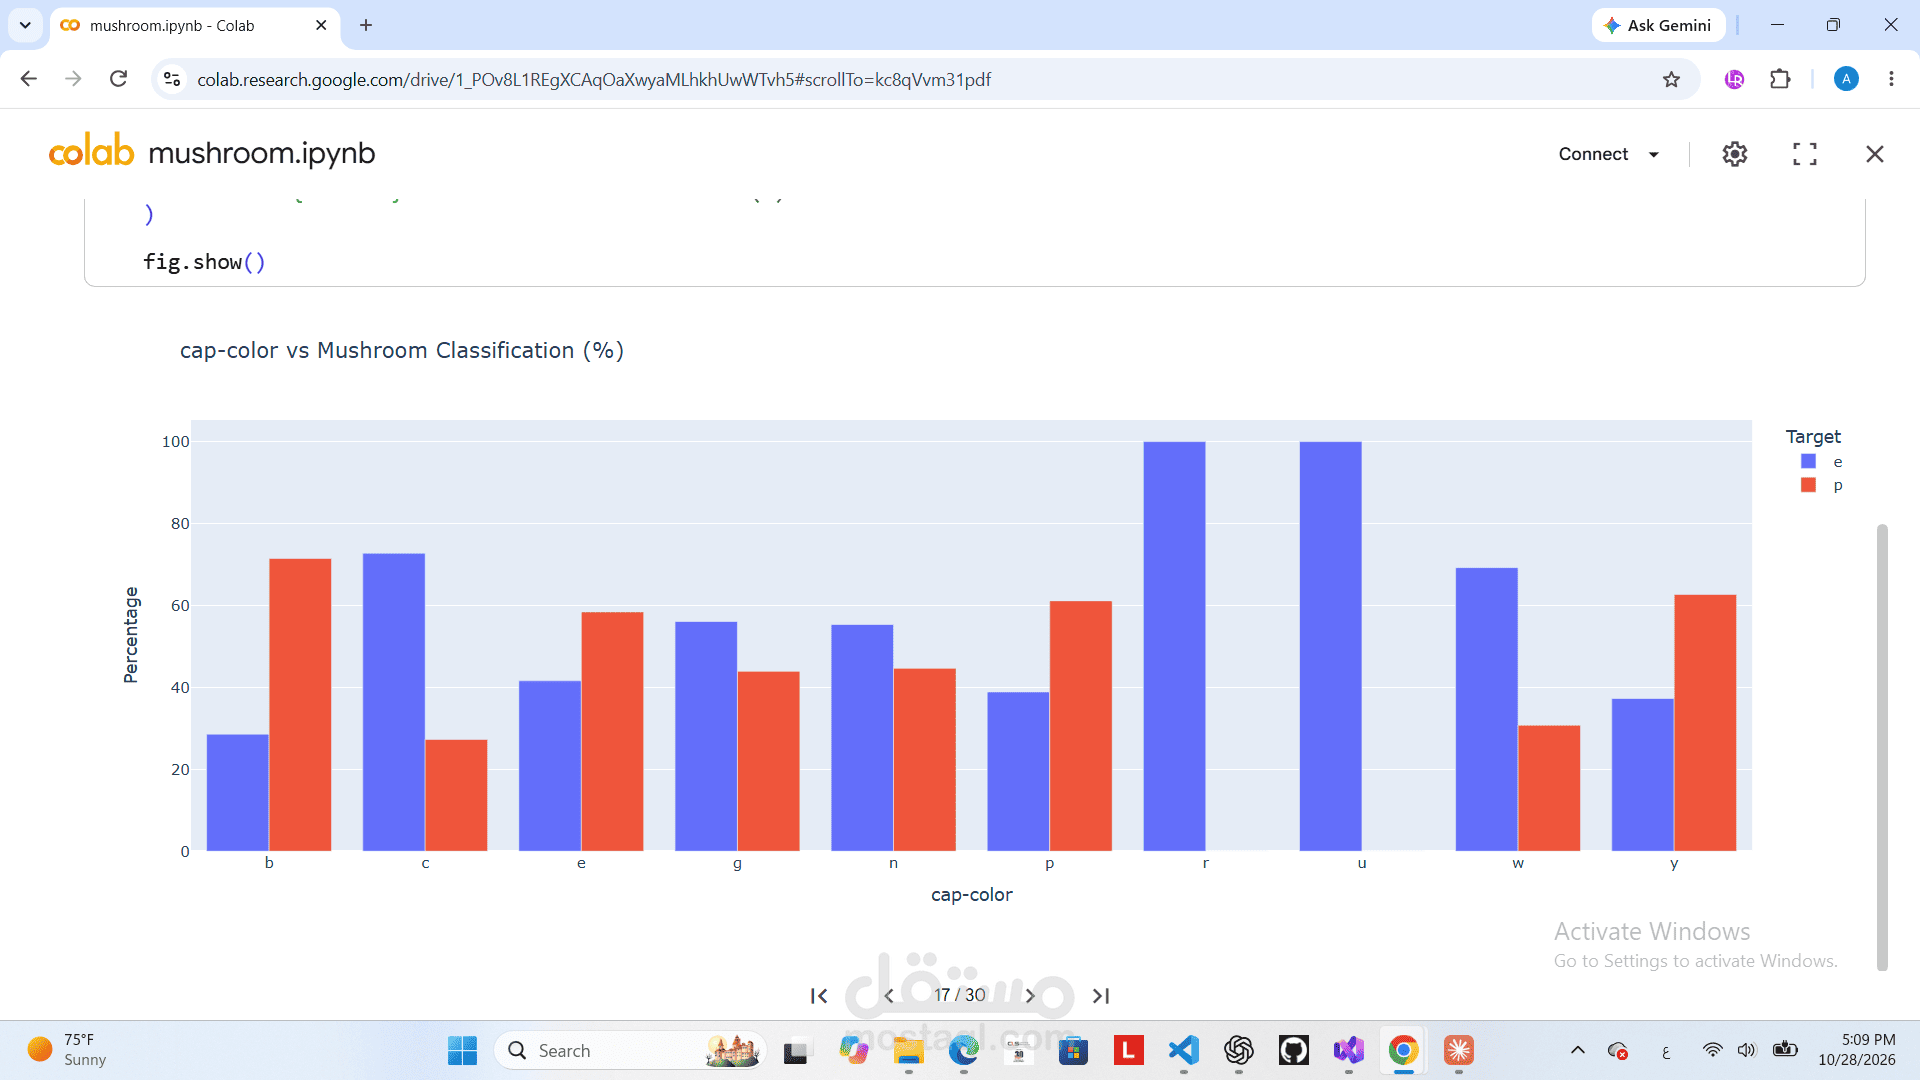
استكشفت توزيع الخصائص الفئوية والعلاقة بين خصائص الفطر وتصنيفه
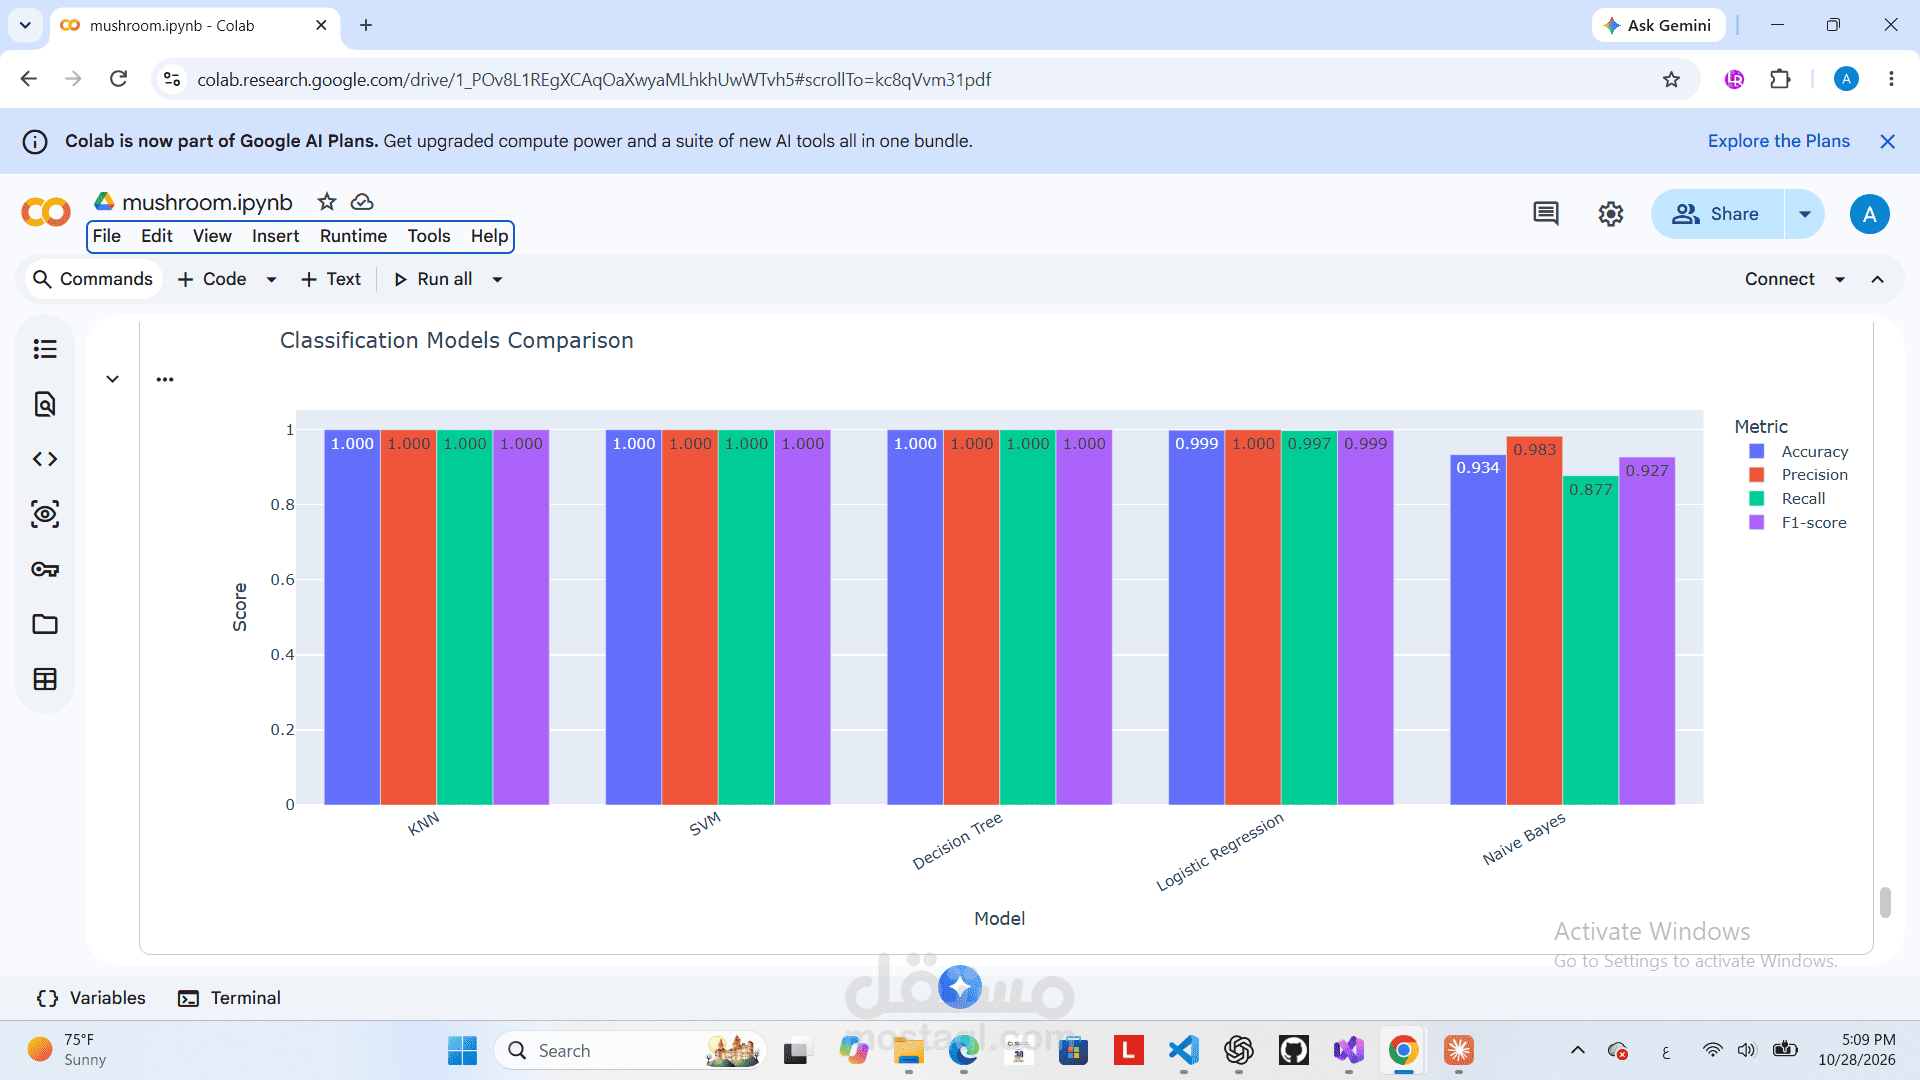
🤖 تدريب ومقارنة 7 موديلات تصنيف (Scikit-learn)
Logistic Regression
K-Nearest Neighbors (KNN)
Decision Tree
Support Vector Machine (SVM)
Bernoulli Naive Bayes
Gradient Boosting
📈 تقييم الأداء (Model Evaluation)
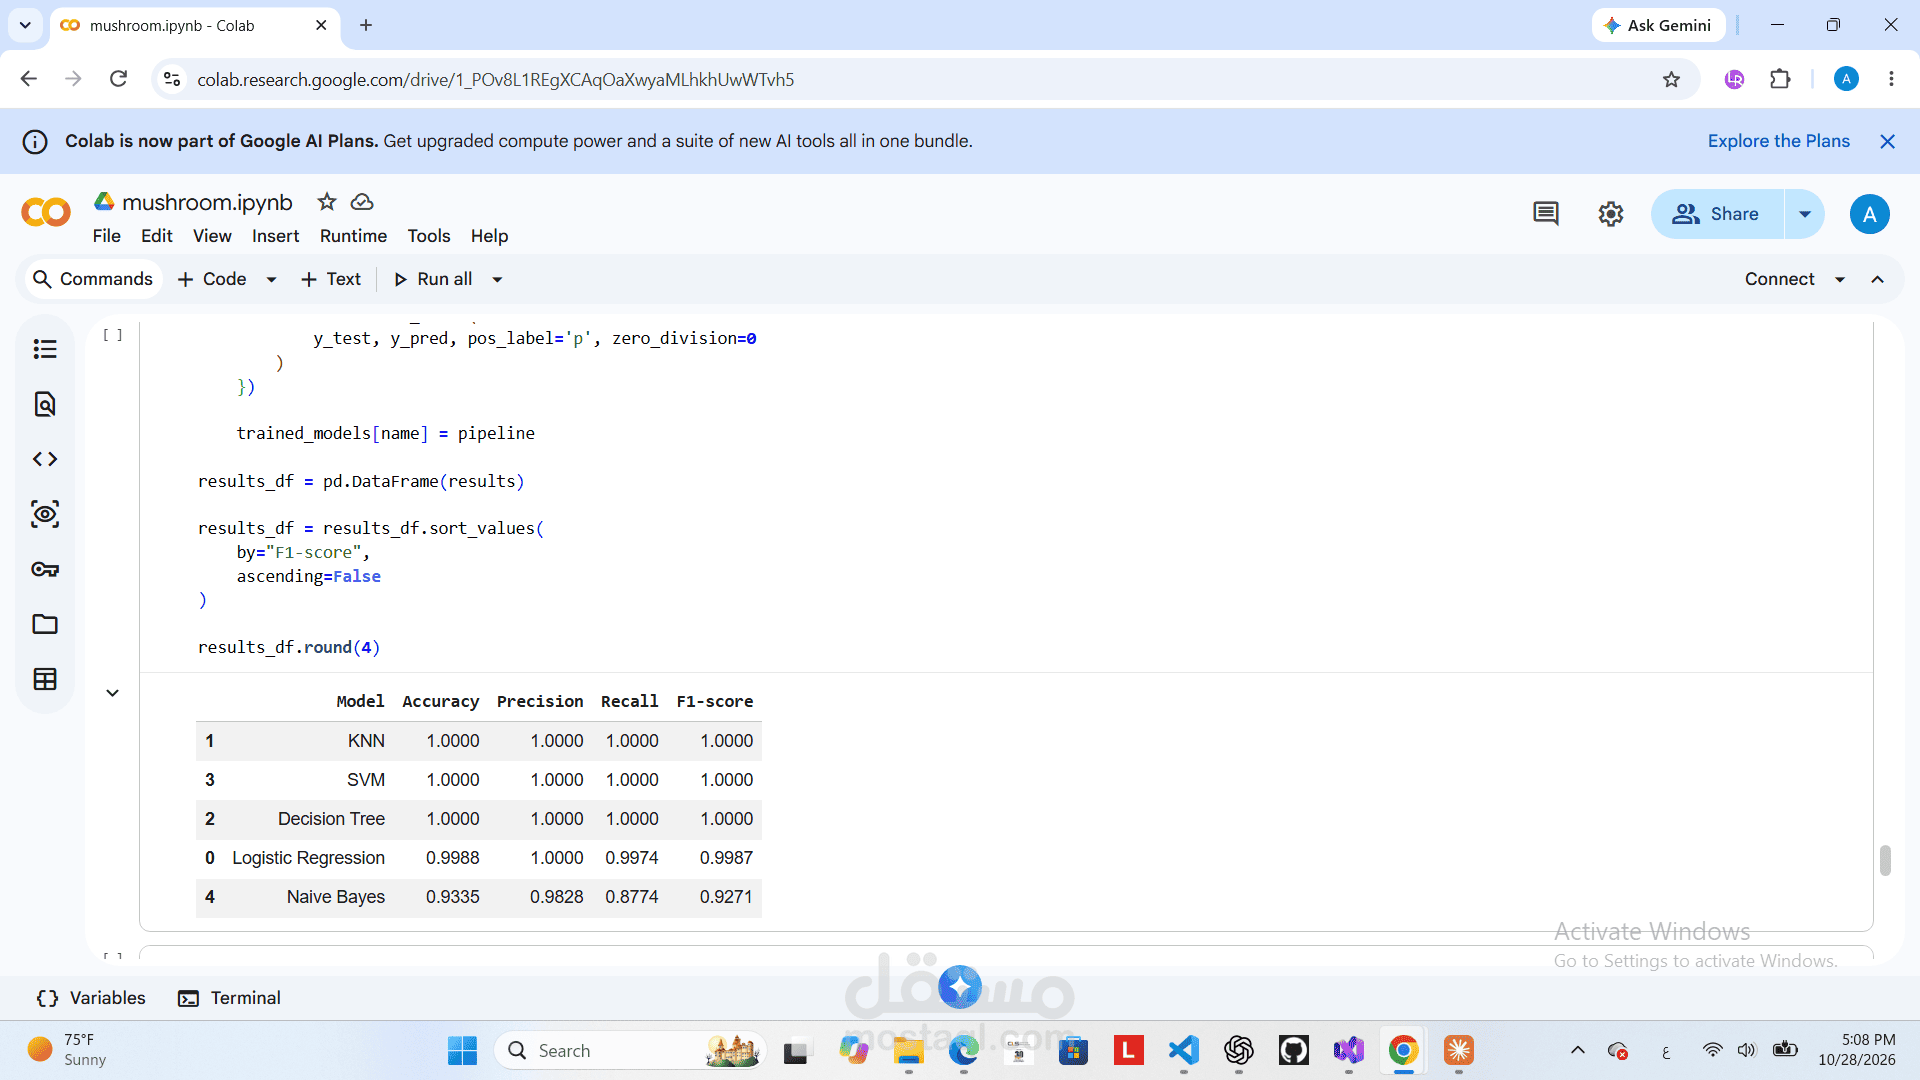
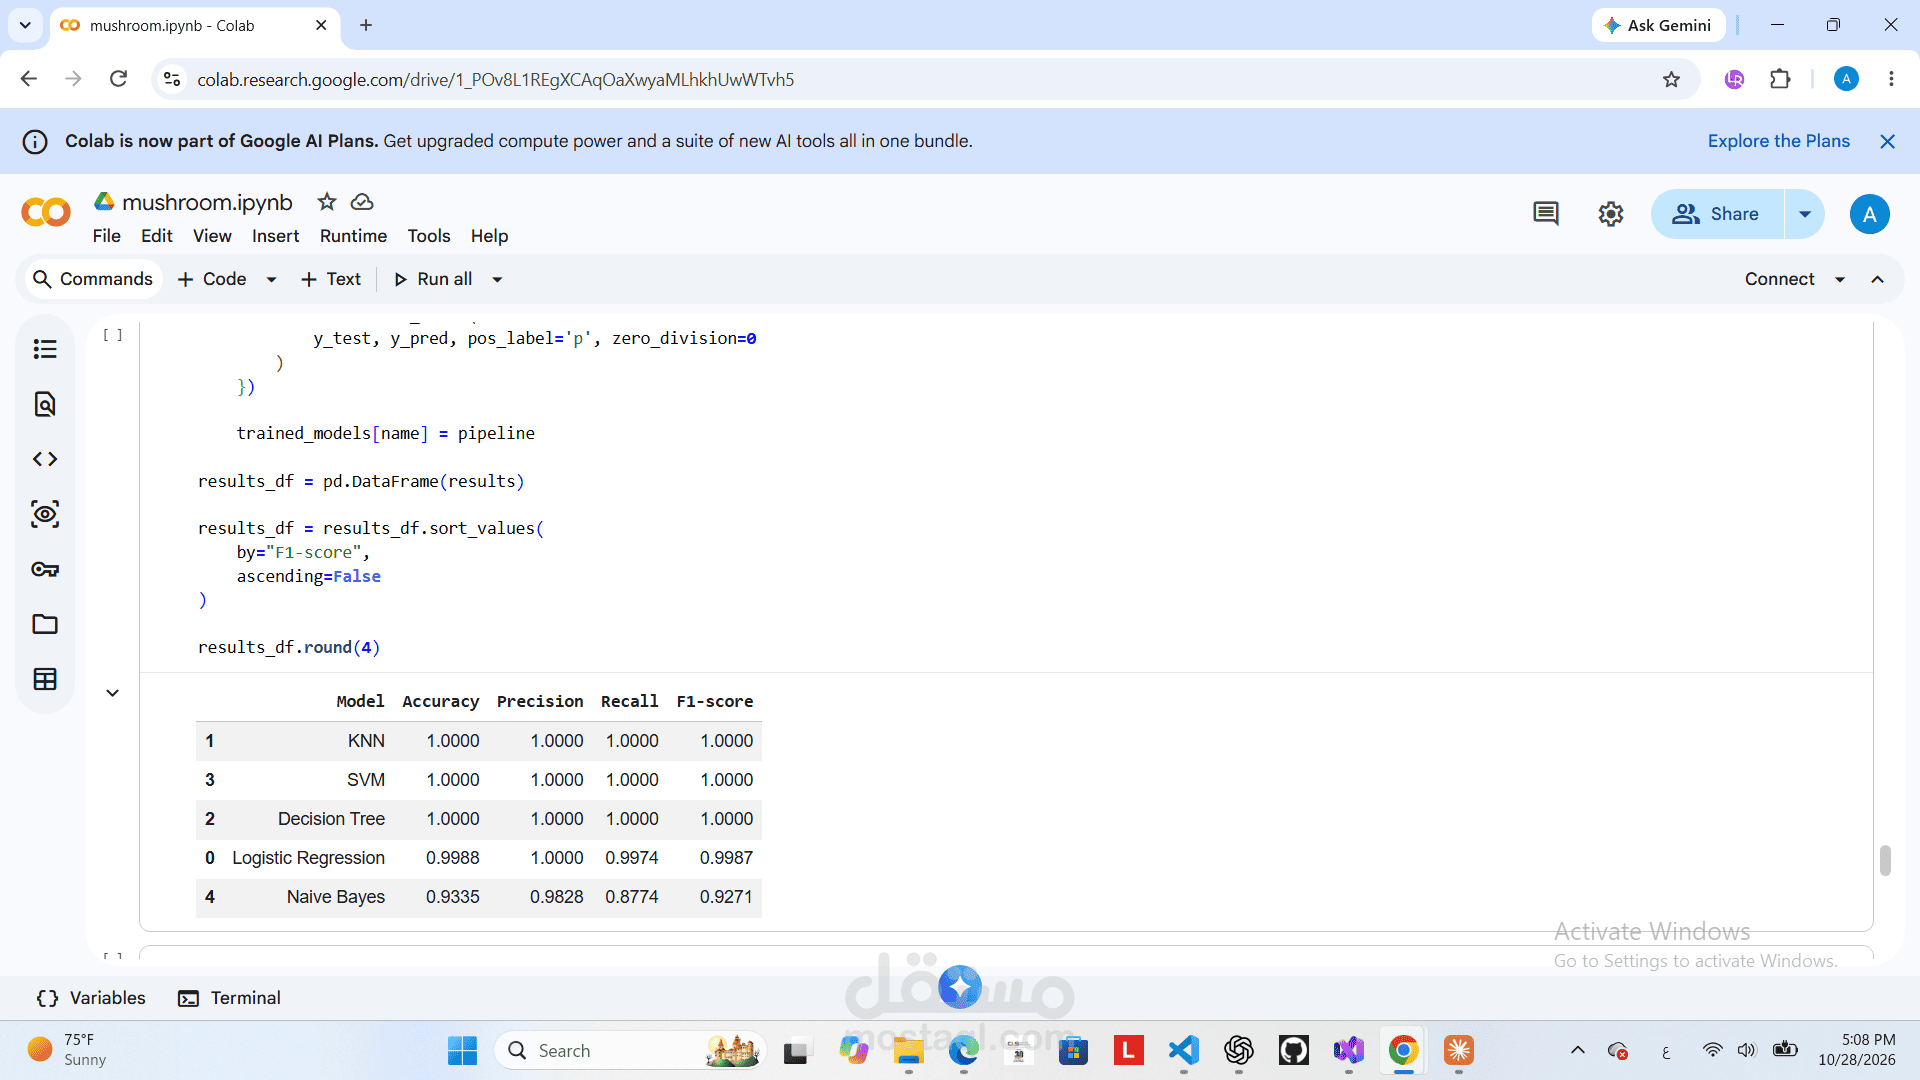
قيّمت كل موديل بـ Accuracy و Precision و Recall و F1-score
ركزت على الفئة السامة (pos_label='p') لأن الخطأ فيها هو الأخطر في الواقع
🛠️ الأدوات: Python • Pandas • Scikit-learn • Plotly