Cardiovascular Disease Data Analysis and Prediction Using Python
تفاصيل العمل
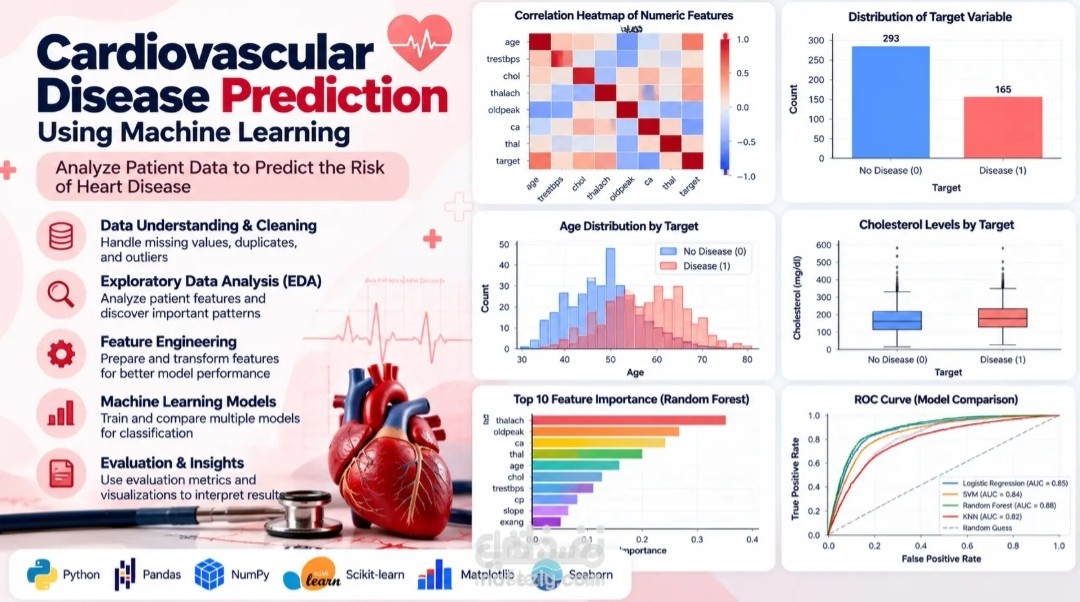
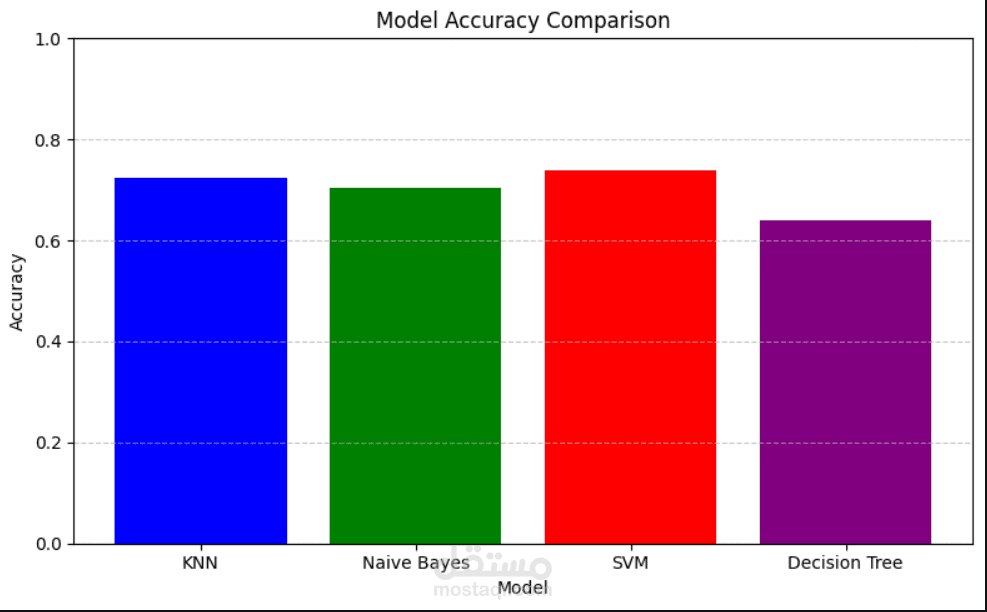
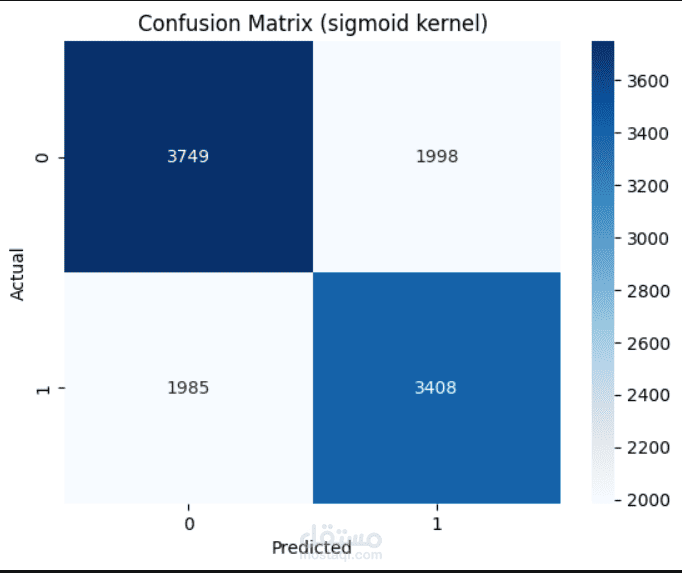
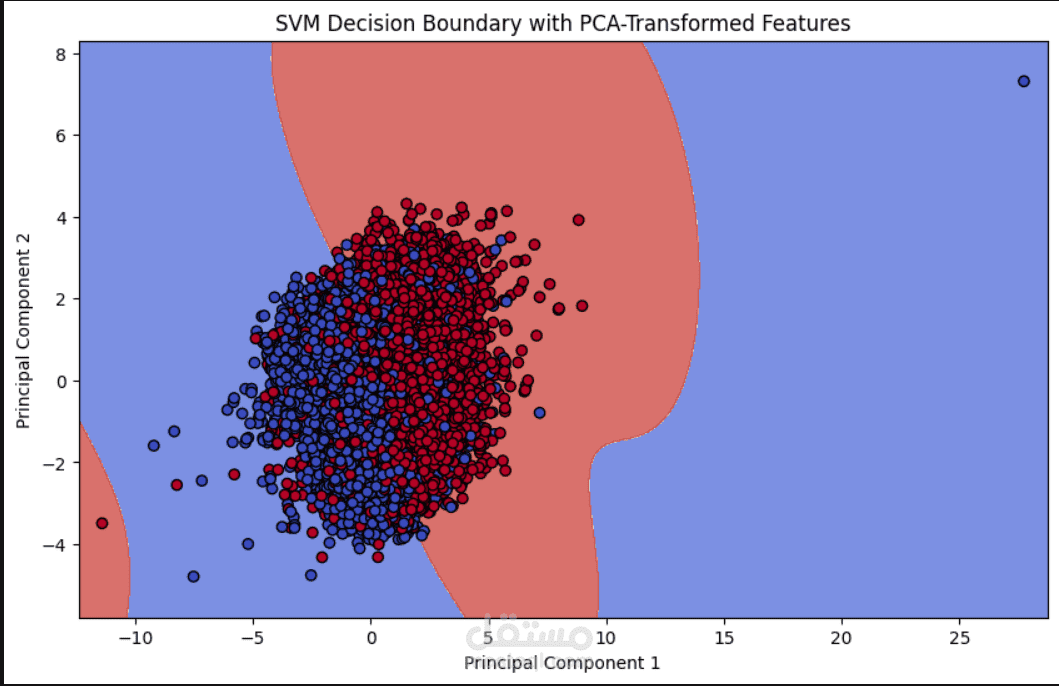
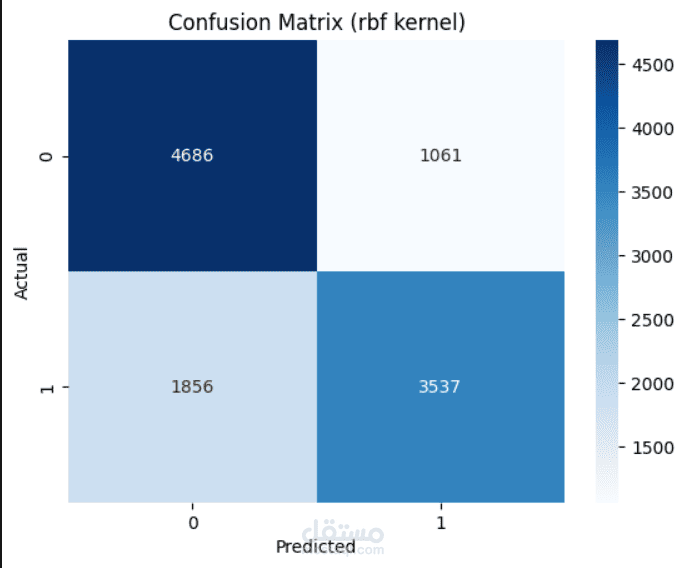
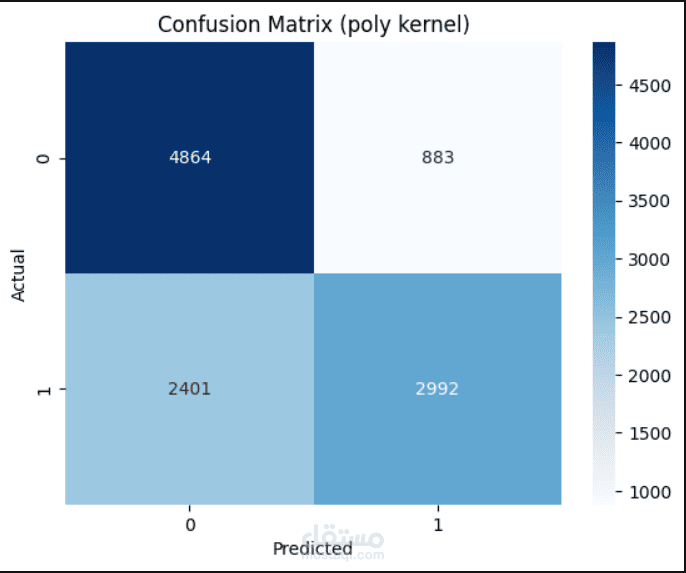
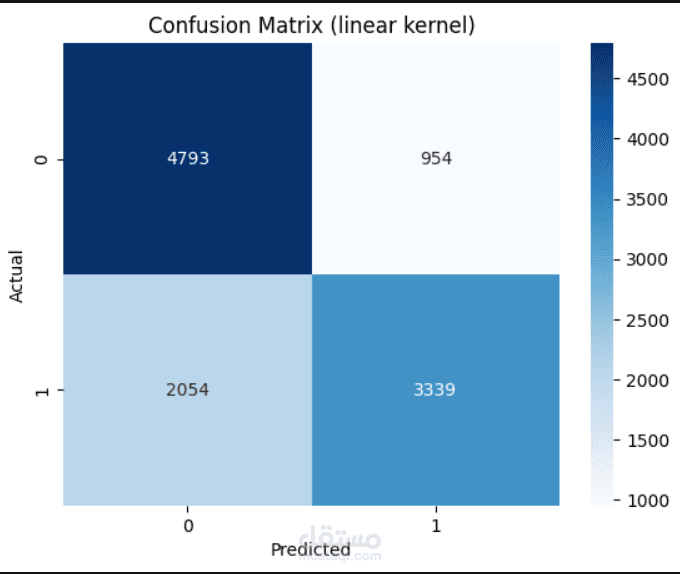
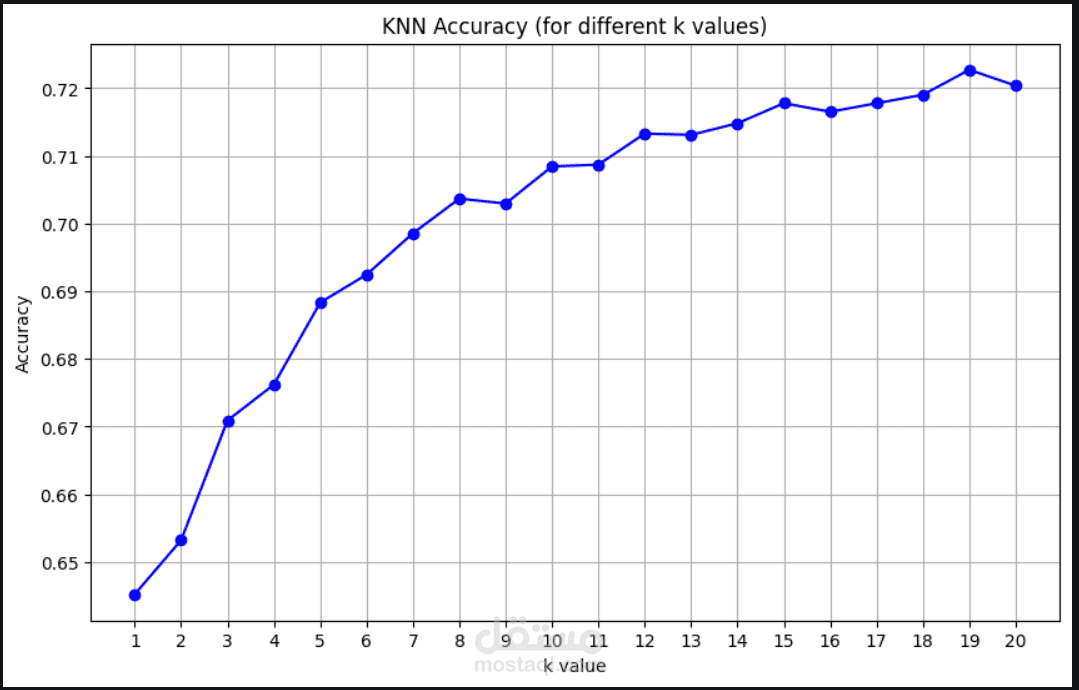
نفذت مشروعًا لتحليل بيانات مرتبطة بأمراض القلب والأوعية الدموية باستخدام Python، بهدف استكشاف الأنماط والعلاقات بين الخصائص الصحية المختلفة، وبناء نماذج Machine Learning لتصنيف الحالات وفقًا للمتغير المستهدف في البيانات.
مراحل العمل:
Data Cleaning & Preprocessing: فحص البيانات، إزالة عمود المعرّف، وتحويل العمر من الأيام إلى السنوات، مع استكشاف القيم المتطرفة.
Exploratory Data Analysis (EDA): تحليل توزيع المتغيرات والفئات المختلفة، واستكشاف بعض العلاقات بين الخصائص.
Data Visualization: استخدام الرسوم البيانية لتوضيح توزيعات البيانات والأنماط التي تظهر أثناء التحليل.
Feature Scaling: تطبيق StandardScaler لتجهيز البيانات للموديلات التي تتأثر بمقاييس الخصائص.
Classification Models: تجربة K-Nearest Neighbors (KNN)، وGaussian Naive Bayes، وSupport Vector Machine (SVM)، وDecision Tree.
Hyperparameter Tuning : استخدام GridSearchCV لتحسين إعدادات Decision Tree، وRandomizedSearchCV لاستكشاف إعدادات SVM.
Model Evaluation: مقارنة أداء النماذج باستخدام Accuracy، وPrecision، وRecall، وF1-score، بالإضافة إلى Confusion Matrix وClassification Report في الأجزاء التي تم تطبيقها.
الأدوات المستخدمة: Python، Pandas، NumPy، Matplotlib، Seaborn، Scikit-learn، وSciPy.
يركز المشروع على تطبيق خطوات تحليل البيانات وبناء نماذج التصنيف وتقييم أدائها بطريقة منظمة.
هذا المشروع تعليمي، ولا يُستخدم لتشخيص الأمراض أو اتخاذ قرارات طبية.