Car Price Analysis and Prediction Using Python
تفاصيل العمل
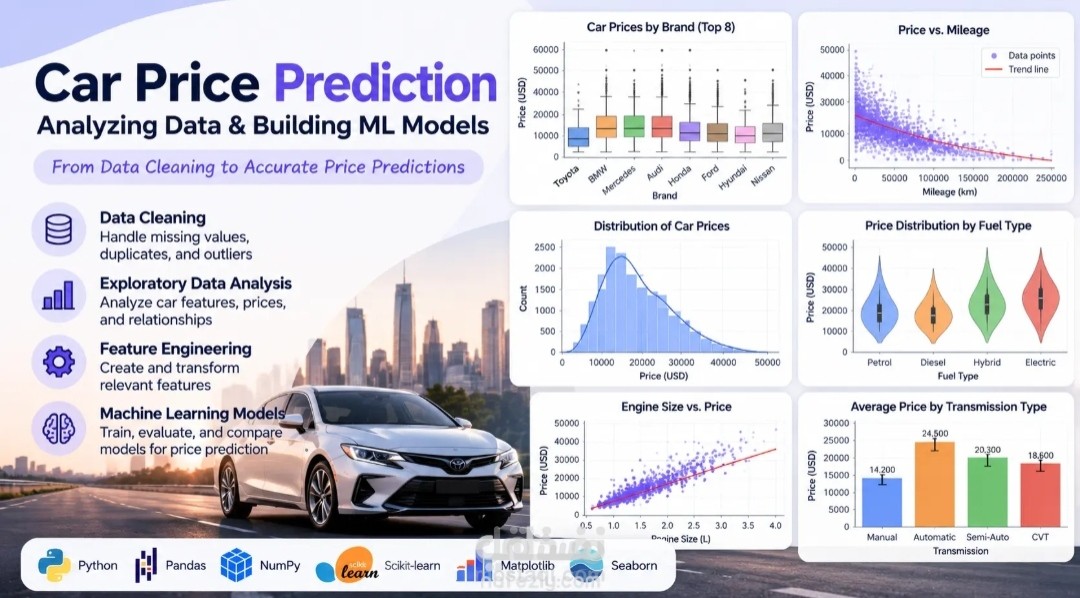
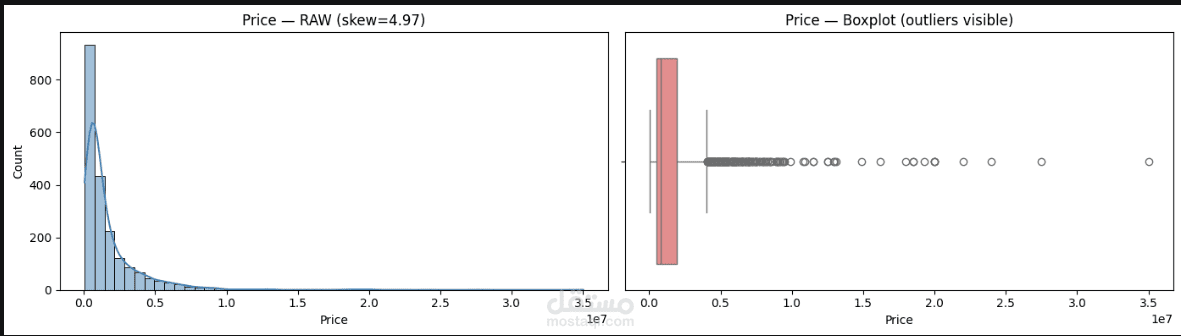
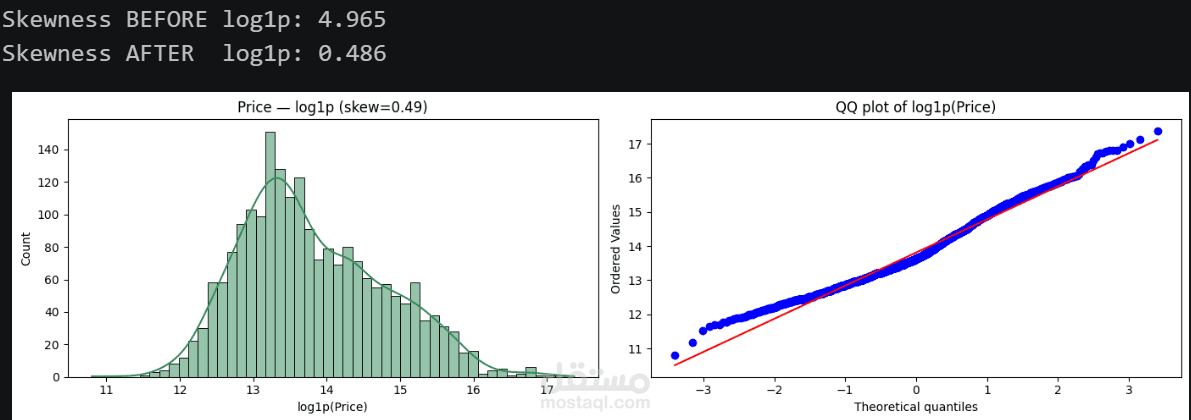
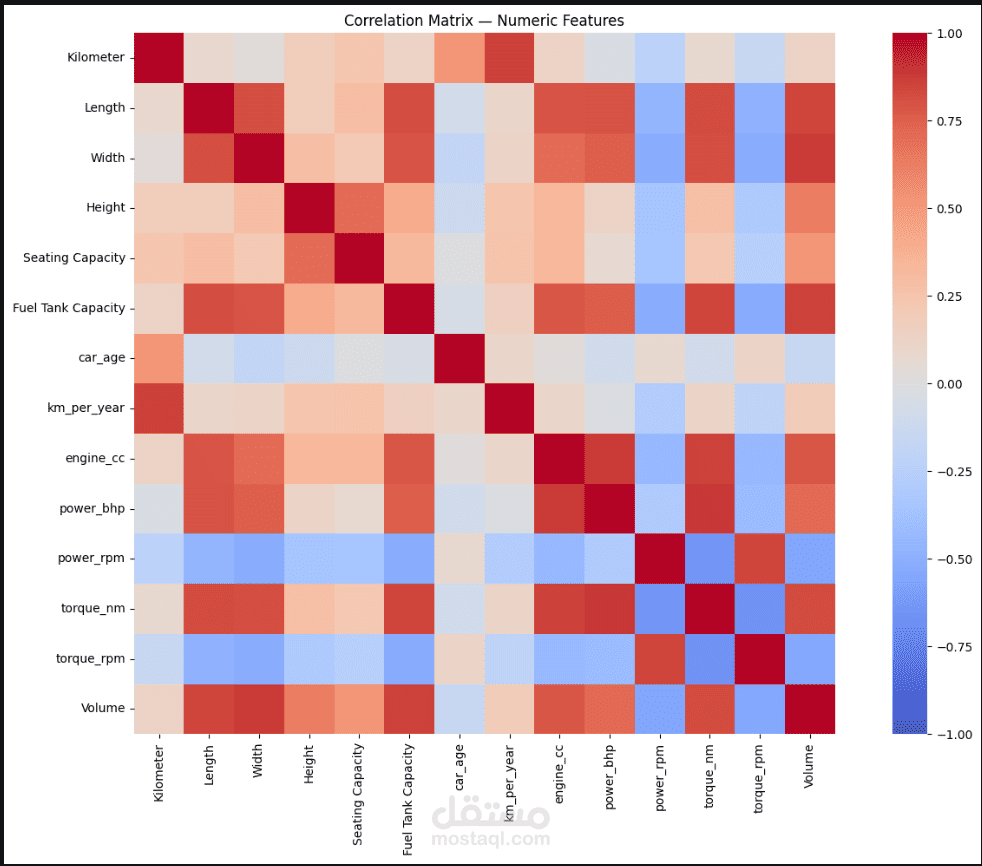
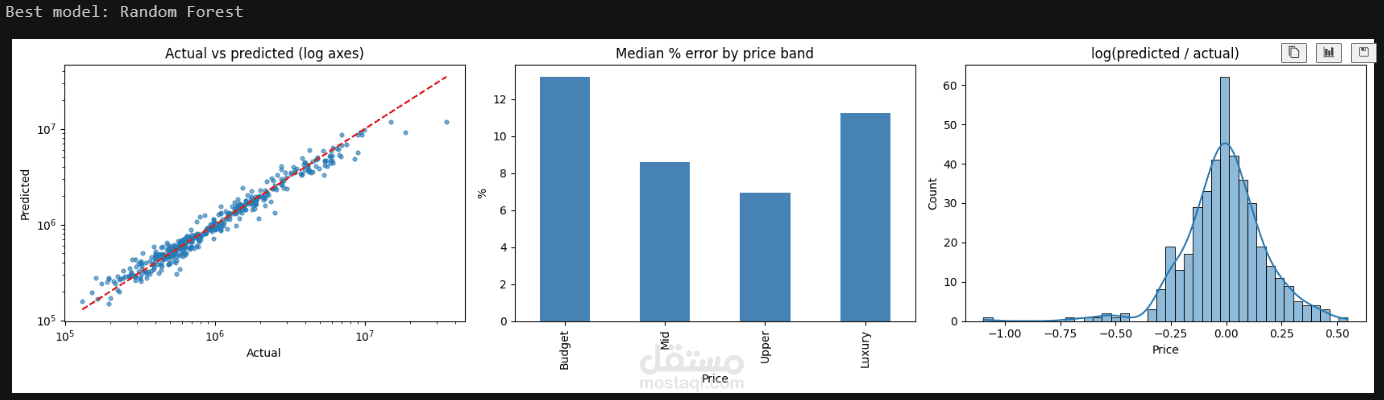
قمت بتنفيذ مشروع لتحليل بيانات السيارات وبناء نماذج Machine Learning للتنبؤ بأسعارها باستخدام Python، بهدف فهم العوامل المرتبطة بأسعار السيارات وتقييم أداء النماذج المختلفة.
مراحل العمل:
Data Cleaning: فحص البيانات وتنظيفها ومعالجة القيم غير المناسبة وتجهيزها للتحليل.
Exploratory Data Analysis (EDA): استكشاف خصائص السيارات وأسعارها وتحليل توزيع البيانات والعلاقات بين المتغيرات.
Feature Engineering: تجهيز الخصائص وإنشاء متغيرات مشتقة مثل قوة المحرك واستهلاك السيارة السنوي بالكيلومترات، وفقًا للبيانات المتاحة.
Data Preprocessing: بناء Pipelines لمعالجة المتغيرات الرقمية والفئوية، والتعامل مع القيم المفقودة وترميز البيانات.
Feature Selection:دراسة العلاقات بين الخصائص واختيار المتغيرات المناسبة للنمذجة.
Machine Learning:بناء نموذج Linear Regression ومقارنته بنماذج أكثر قدرة على التعامل مع العلاقات غير الخطية، مثل Random Forest وHistGradientBoosting.
Model Evaluation: تقييم النماذج باستخدام مقاييس مثل MAE وRMSE وR²، مع تحليل أخطاء التنبؤ.
Model Saving: حفظ أفضل Pipeline لاستخدامها لاحقًا في التنبؤ بأسعار سيارات جديدة.
الأدوات المستخدمة: Python، Pandas، NumPy، Matplotlib، Seaborn، Scikit-learn، وJoblib.
يركز المشروع على تحويل بيانات السيارات الخام إلى معلومات قابلة للتحليل، وبناء Workflow منظم لمعالجة البيانات وتدريب النماذج وتقييم أدائها.