MedScope
تفاصيل العمل
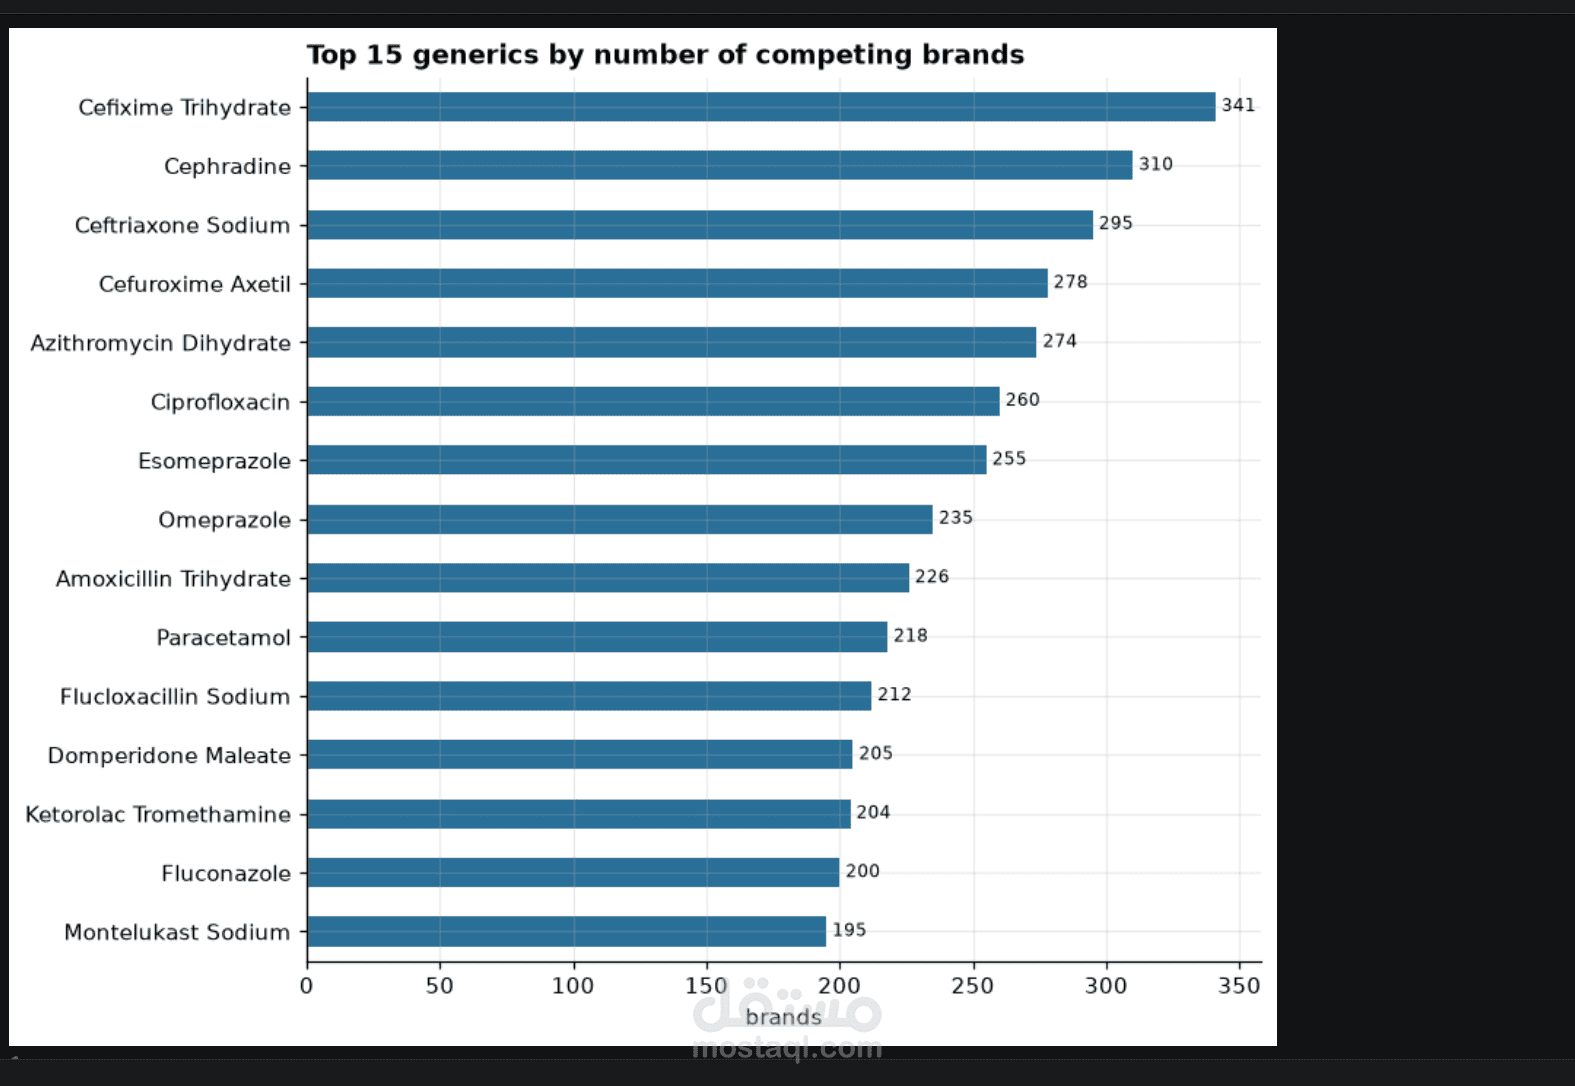
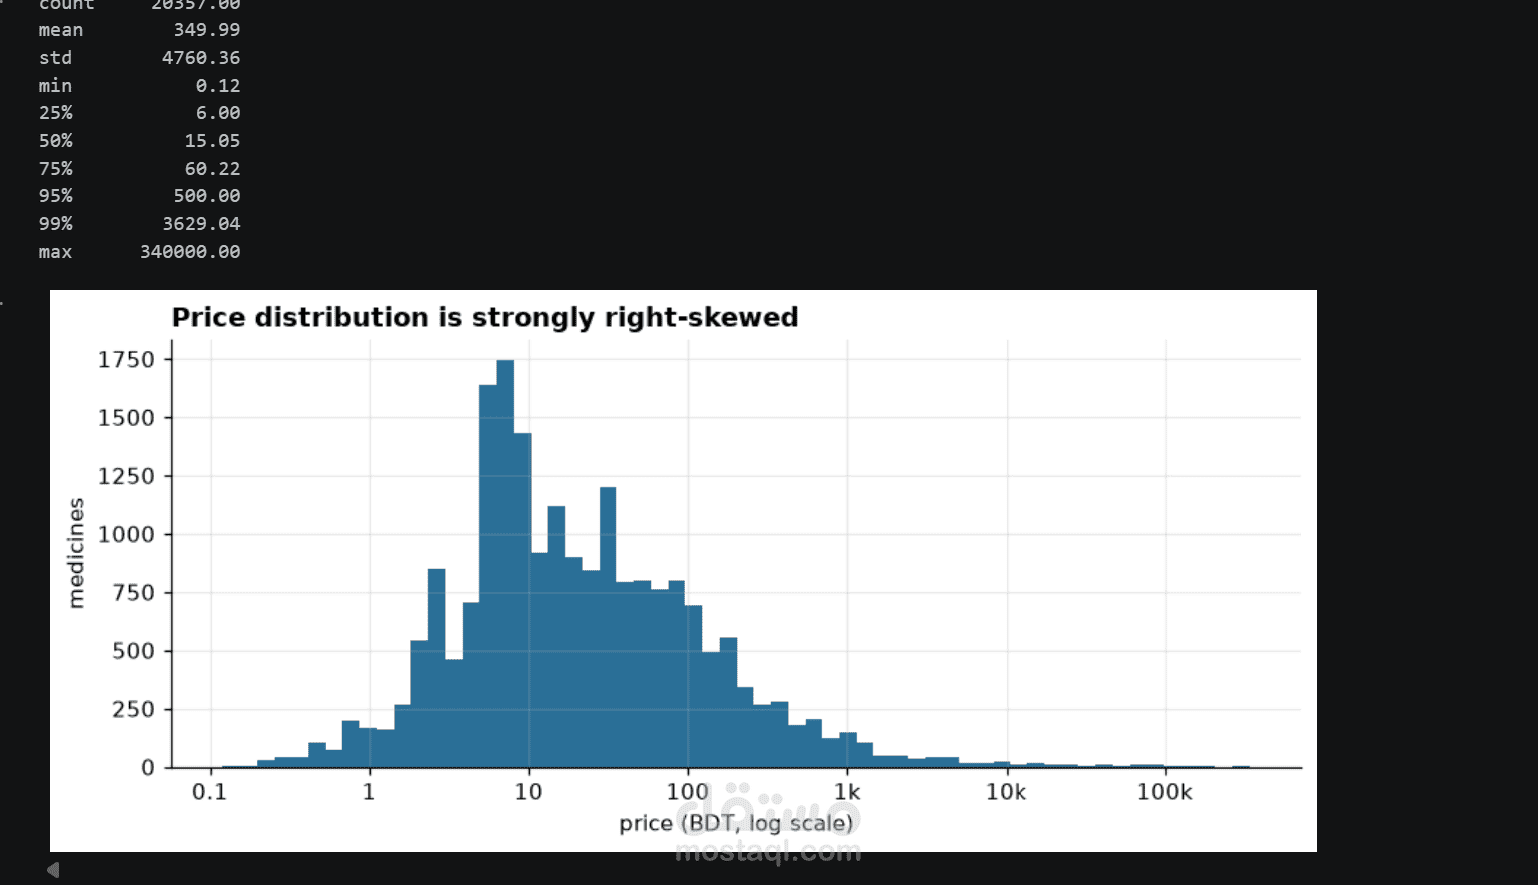
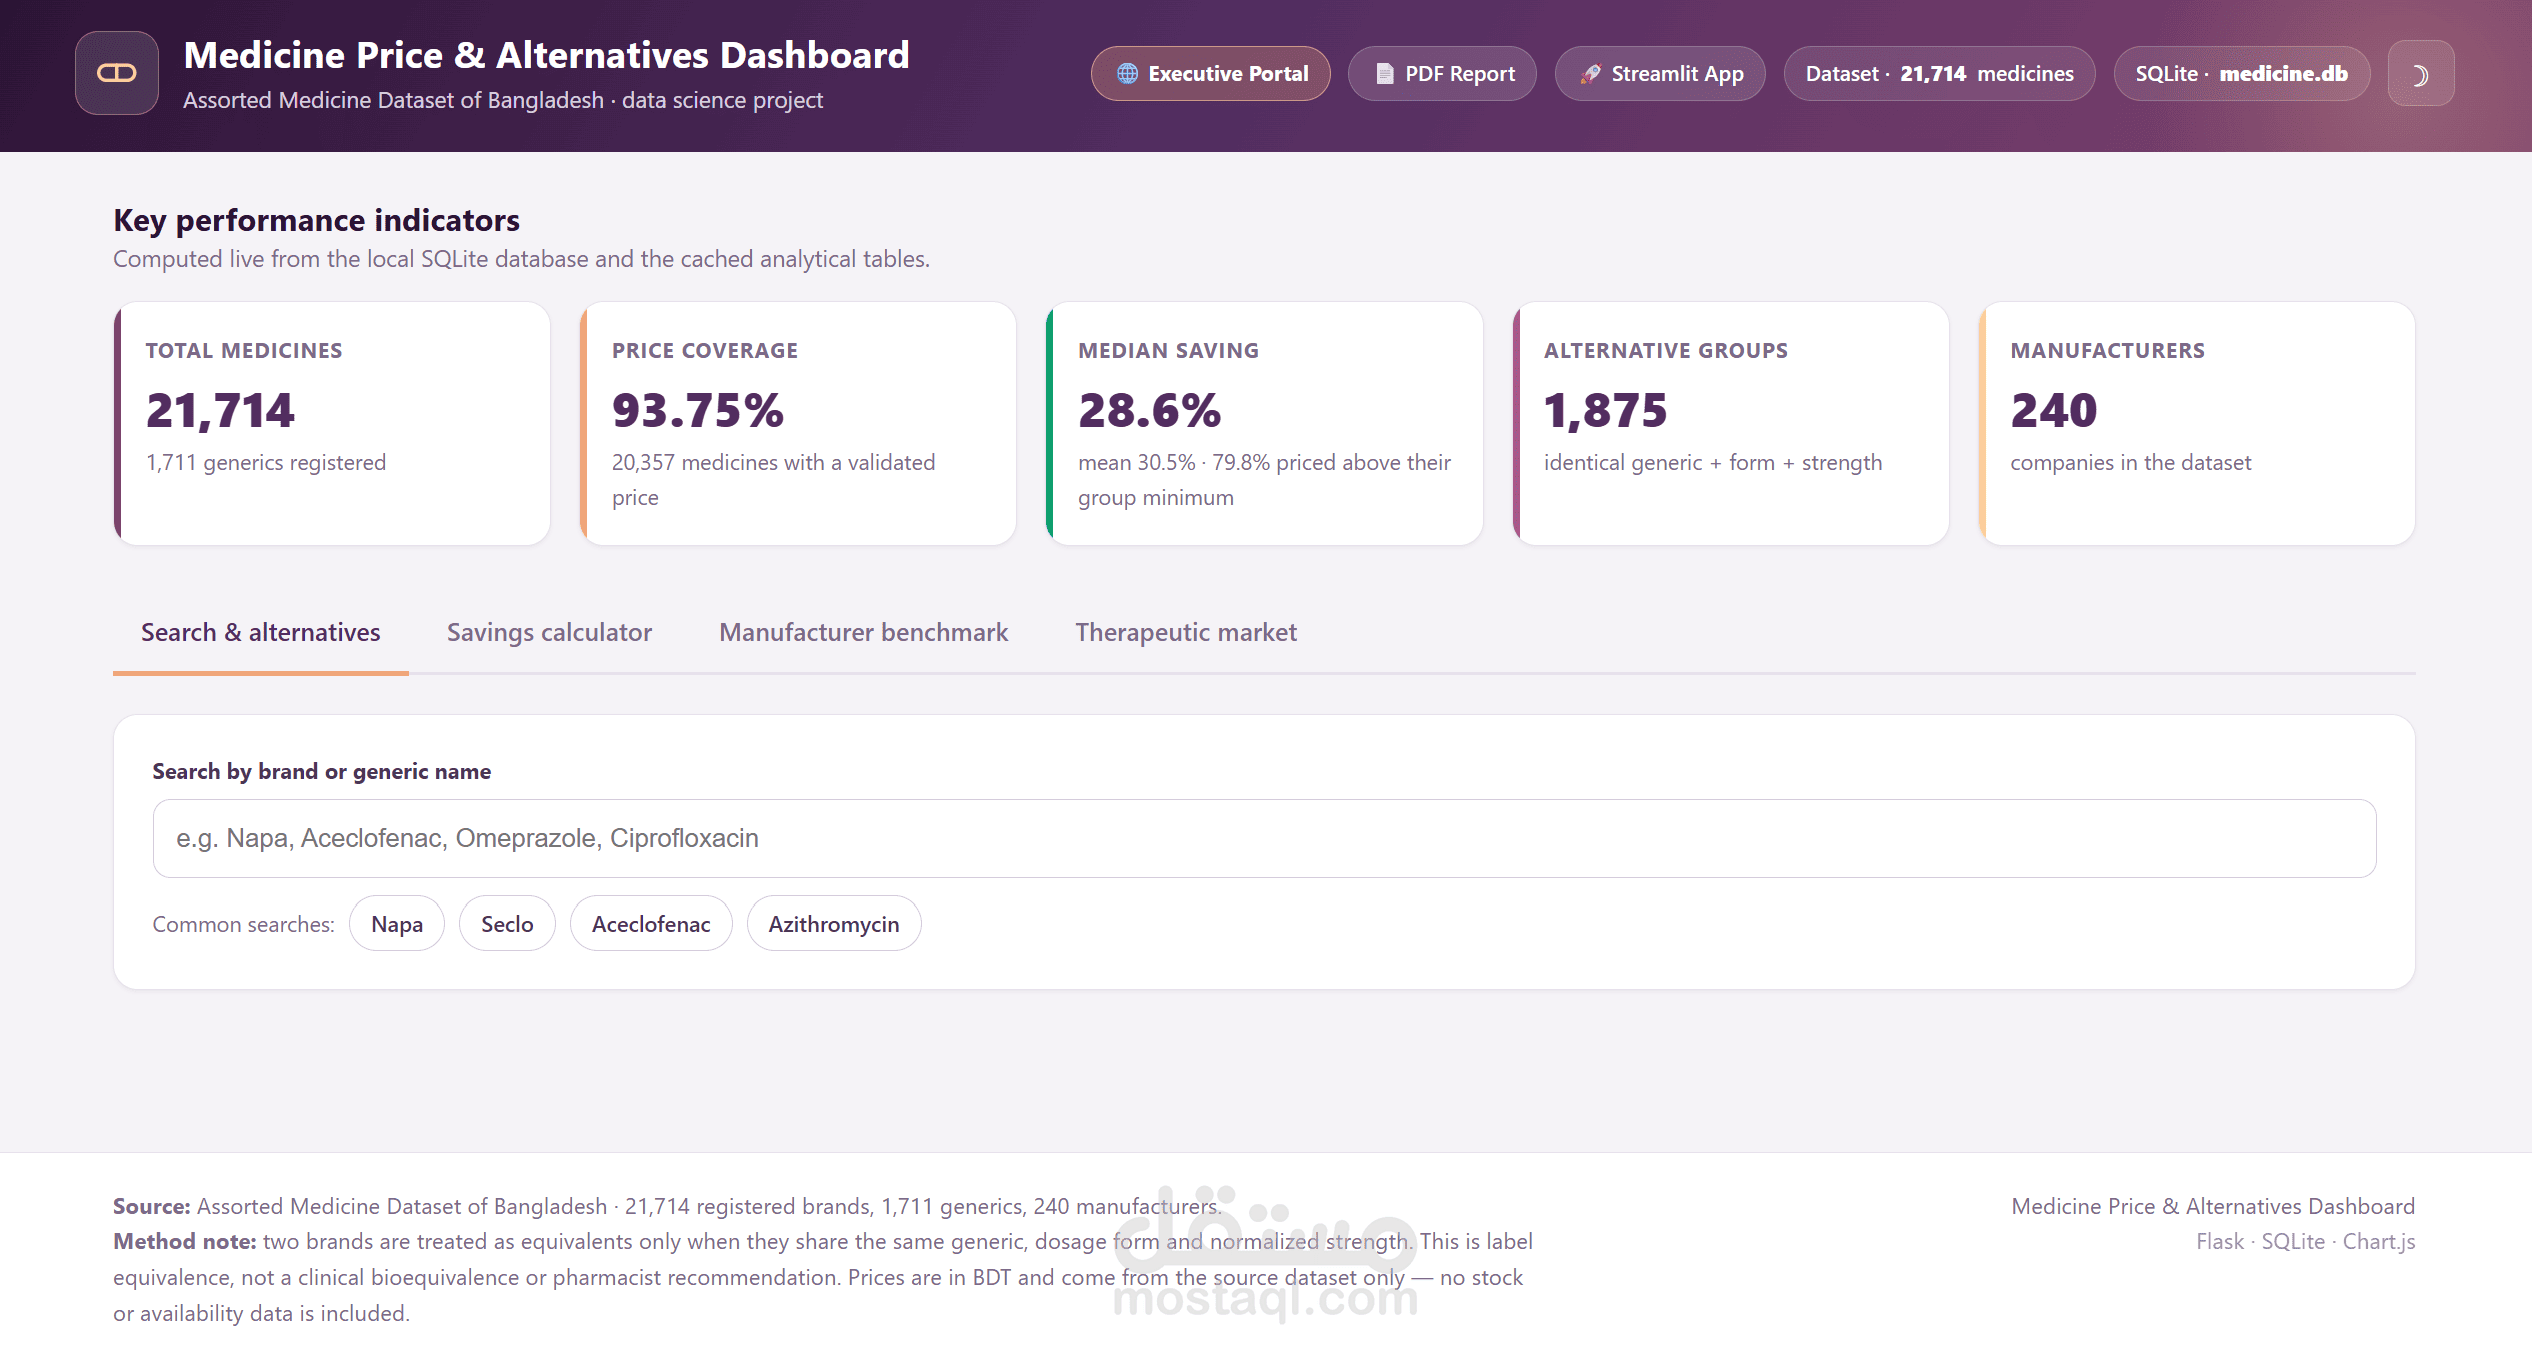
تحليل بيانات الأدوية في بنغلاديش – مشروع علم البيانات (Data Science)
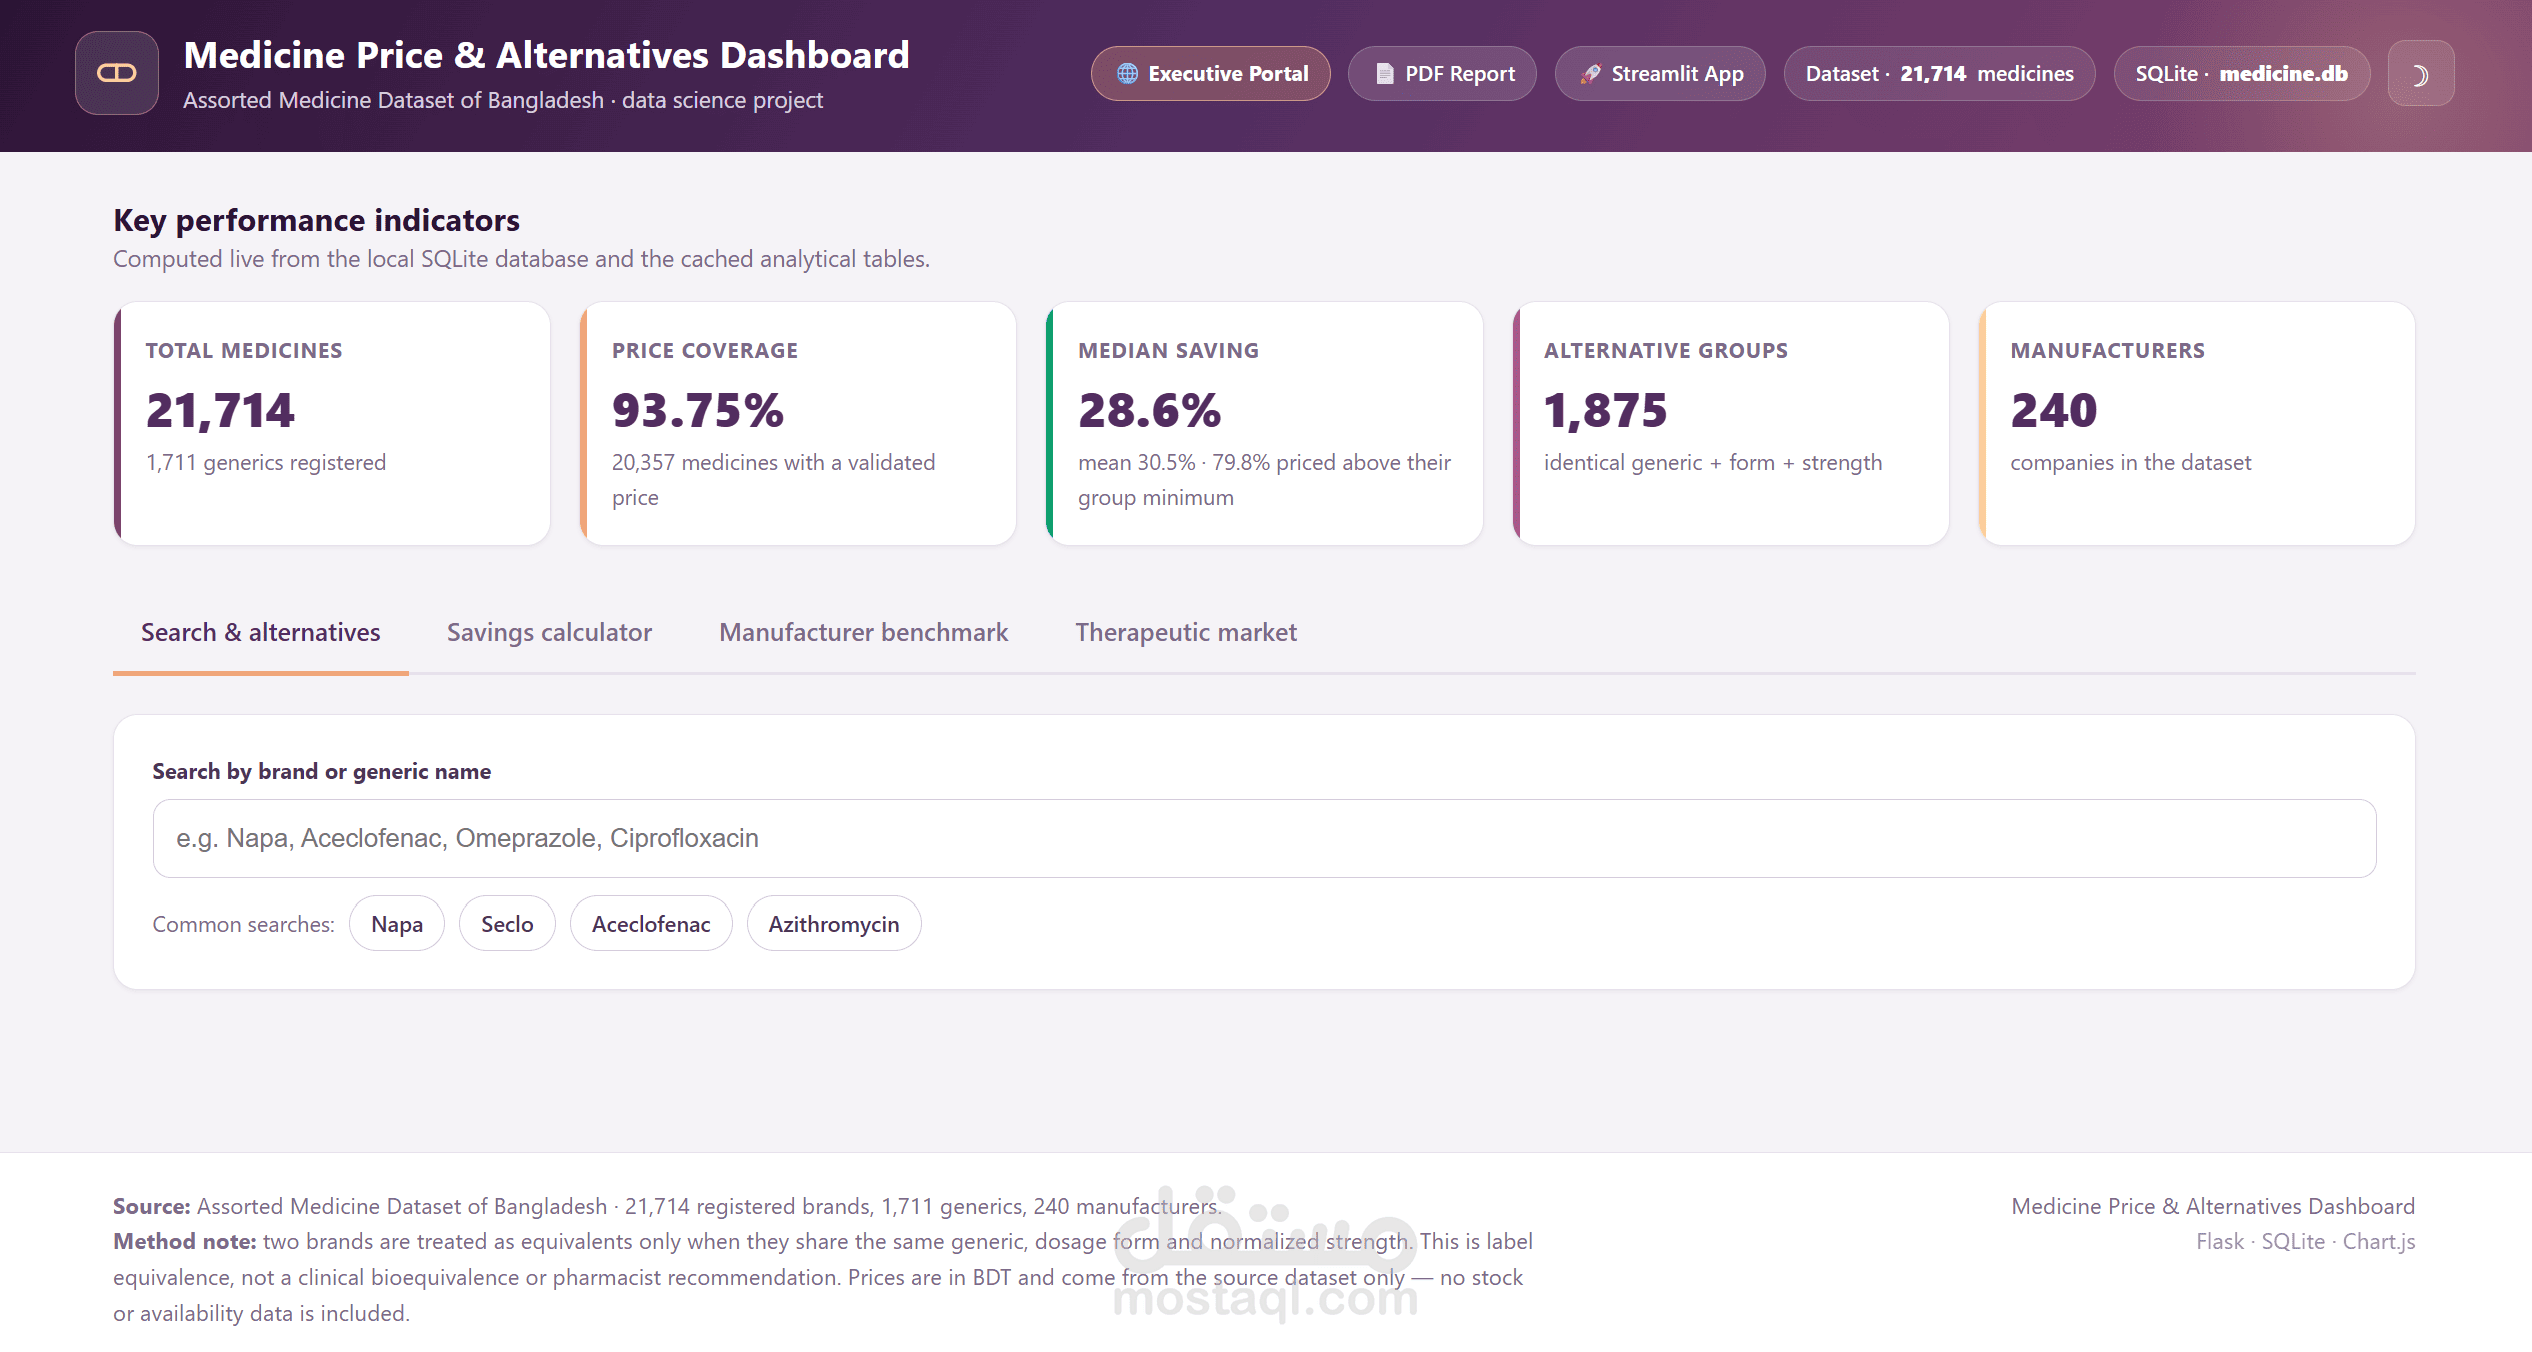
يهدف هذا المشروع إلى معالجة وتنظيف وتحليل مجموعة بيانات الأدوية المتنوعة في بنغلاديش (Assorted Medicine Dataset of Bangladesh)، من خلال بناء مسار عمل احترافي وقابل لإعادة التنفيذ (Reproducible Data Pipeline)، لتحويل البيانات الخام إلى بيانات دقيقة ومنظمة وجاهزة للاستخدام في قواعد بيانات SQL، وإجراء التحليل الاستكشافي للبيانات (EDA)، وتحليل الأدوية البديلة، وحساب التوفير المحتمل للمرضى، وإنشاء لوحات معلومات تفاعلية (Interactive Dashboards).
أهم النتائج والإنجازات
1. استخراج أسعار الأدوية وتنظيف البيانات
- استخراج السعر لكل وحدة دوائية لـ 20,357 دواءً، بنسبة تغطية بلغت 93.75%.
- استخراج أسعار العبوات وأحجامها لـ 13,527 دواءً.
- التعامل مع صيغ الأسعار المتعددة والغامضة بحذر، وتعيين القيم غير المؤكدة إلى `NULL` لضمان دقة البيانات وموثوقية النتائج.
2. تحديد مجموعات الأدوية البديلة
- تكوين 1,875 مجموعة من الأدوية المتكافئة، بالاعتماد حصريًا على تطابق اسم المادة الفعالة (`generic_name`)، والشكل الصيدلاني (`dosage_form`)، والتركيز بعد توحيده (`normalized strength`).
3. تحليل فرص التوفير للمرضى
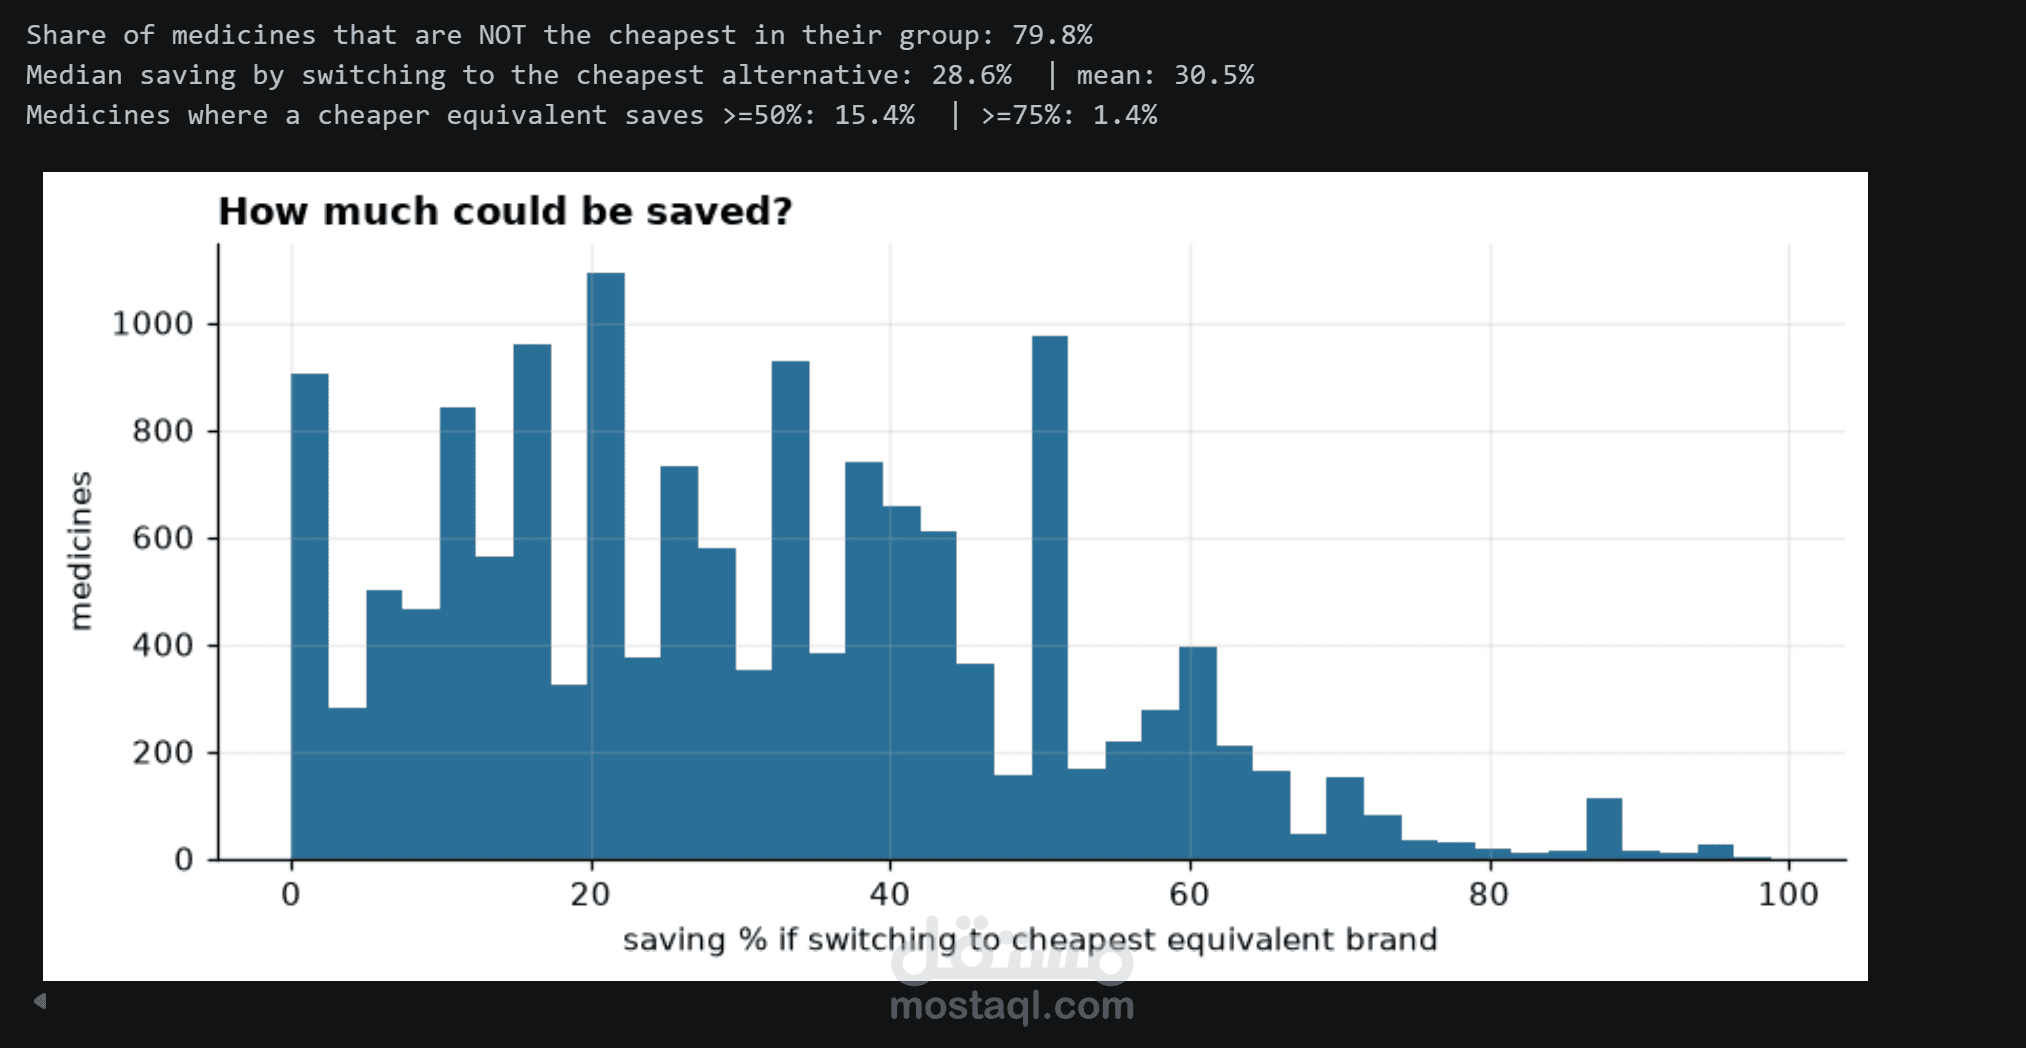
- أظهرت النتائج أن 79.8% من الأدوية ليست الأقل سعرًا ضمن مجموعاتها من البدائل المتكافئة.
- بلغ متوسط التوفير المحتمل عند اختيار العلامة التجارية الأقل سعرًا 30.5%، بينما بلغ التوفير الوسيط 28.6%.
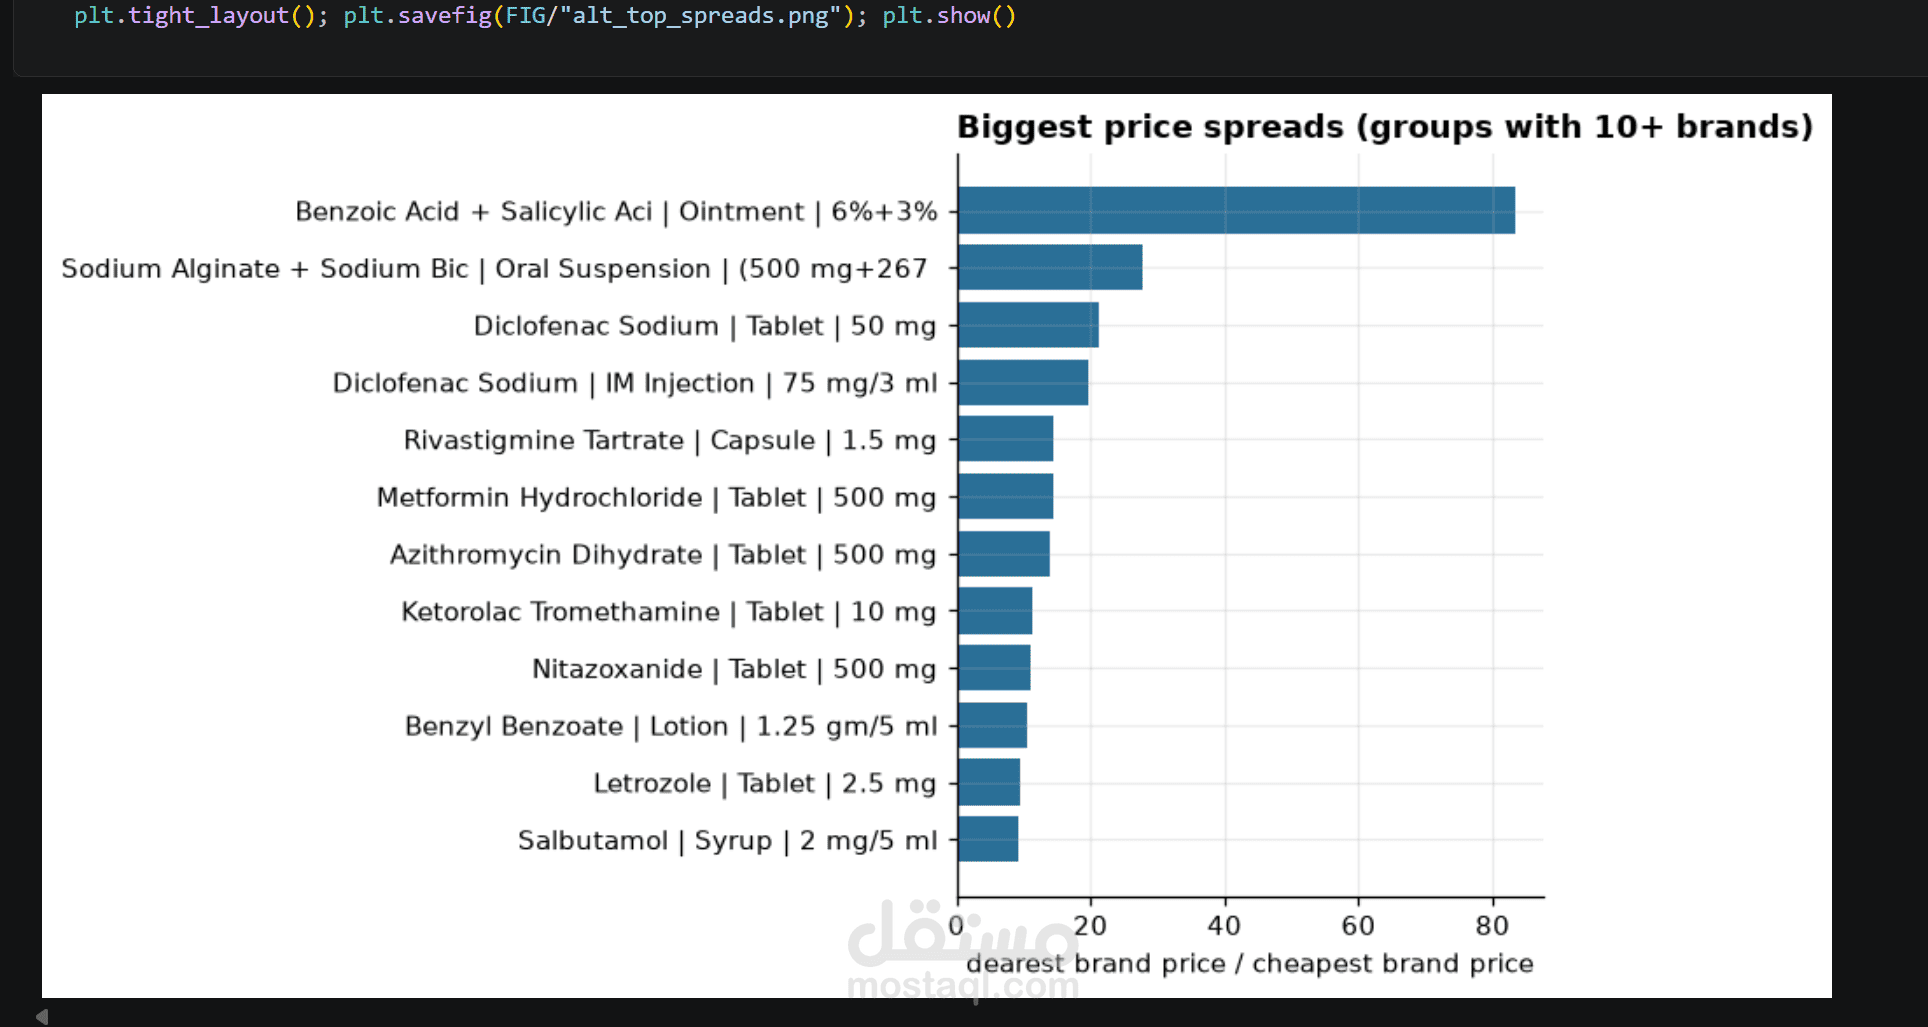
- في 23.4% من مجموعات الأدوية، بلغ سعر العلامة التجارية الأعلى سعرًا ضعف سعر العلامة الأقل سعرًا أو أكثر.
- تتيح أكثر من 15.4% من الأدوية فرصًا لتوفير يبلغ 50% أو أكثر.
4. تحليل تركز السوق
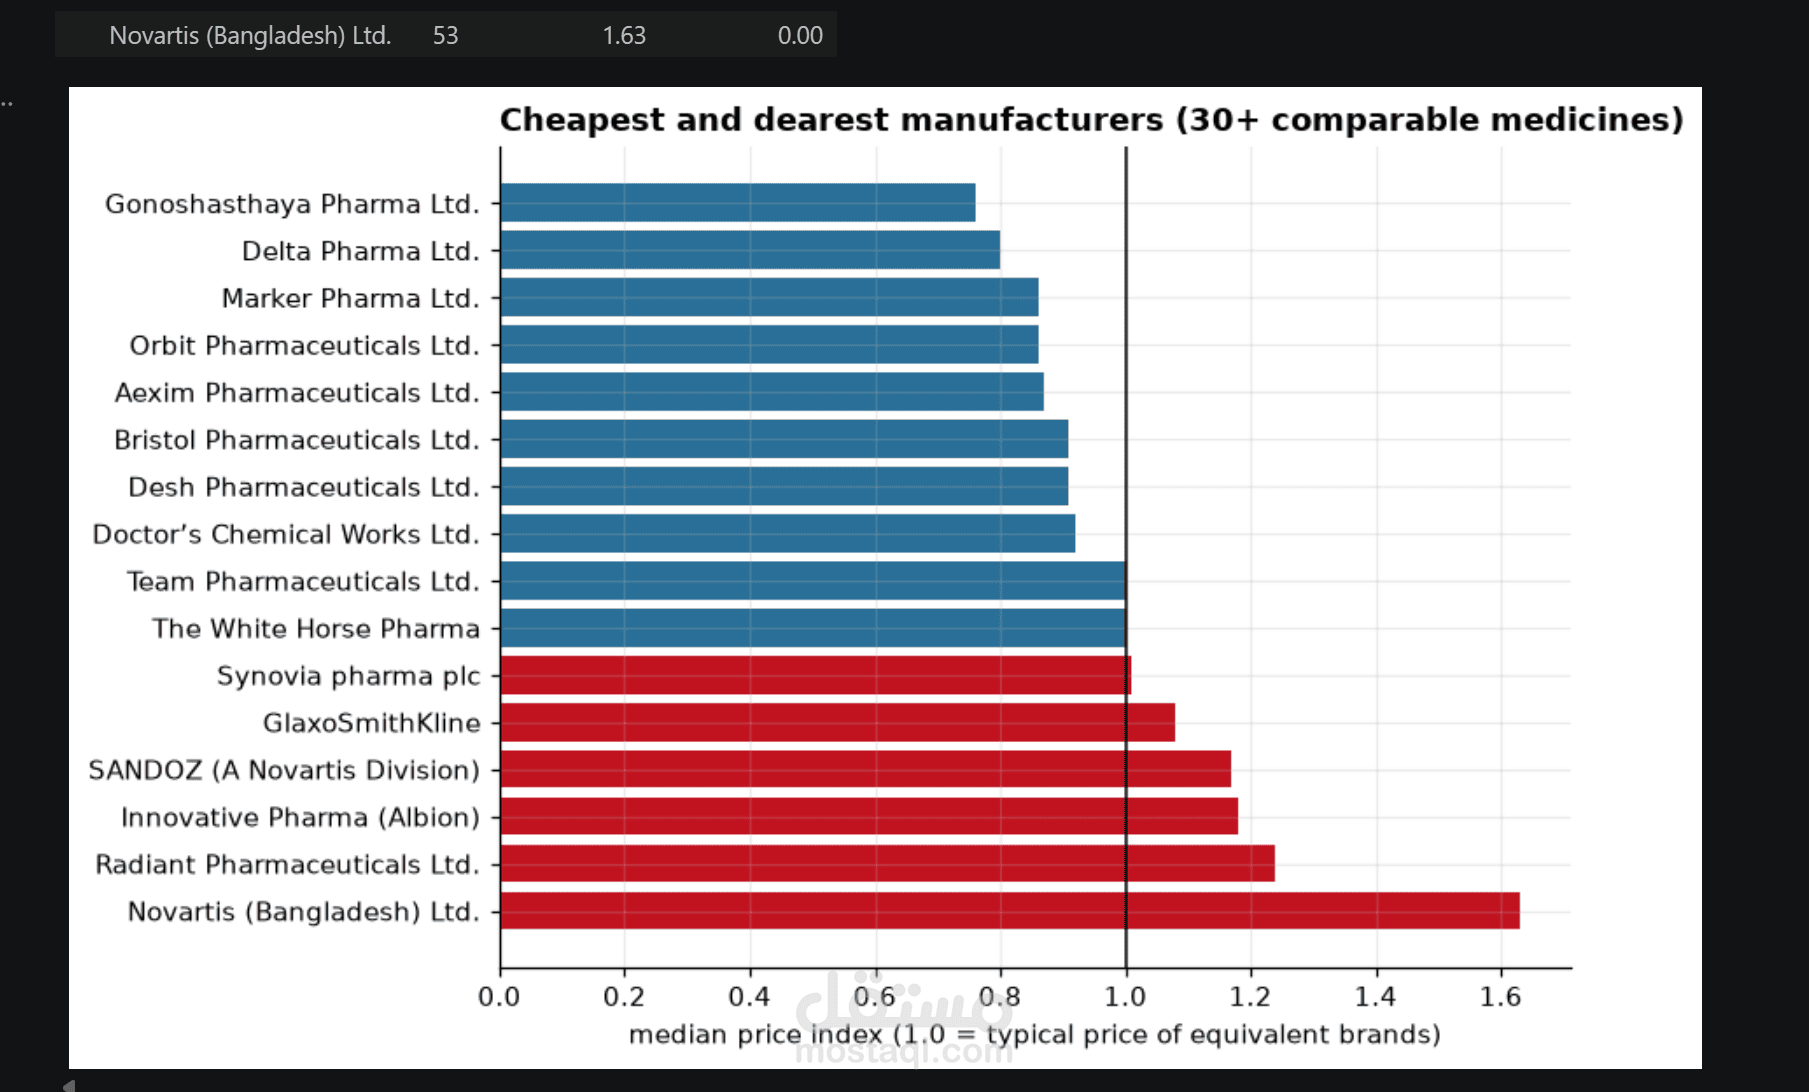
- تستحوذ أكبر 10 شركات مصنّعة على نحو ثلث العلامات التجارية المتداولة في السوق، مما يوفر مؤشرًا على مستوى تركز السوق وتوزيع العلامات التجارية بين الشركات المصنّعة.
الهدف من المشروع
تقديم بيانات دوائية نظيفة وموثوقة تدعم التحليل الاستكشافي، والمقارنة بين أسعار الأدوية المتكافئة، وتحديد فرص التوفير المحتملة للمرضى، وفهم أنماط التسعير وتوزيع العلامات التجارية، مع تجهيز البيانات للاستخدام في قواعد البيانات ولوحات المعلومات التفاعلية.