استخراج بيانات Web Scrapping
تفاصيل العمل
Automated E-Commerce Scraping & Data Processing Pipeline
نظرة عامة (Overview)
مشروع زحف ويب ومعالجة بيانات متقدم (Web Scraping & Data Pipeline) مبني باستخدام إطار عمل Scrapy. يقوم المشروع باستخراج تفاصيل المنتجات (الكتب) عبر صفحات متعددة، وتتبع الروابط التفصيلية للمنتجات، ثم تنظيف وتحويل الحقول النصية والمالية مباشرة أثناء عملية السحب باستخدام ItemLoader ومعالجات مخصصة (Processors) قبل التصدير لهيكل بيانات منظم (JSON).
المميزات التقنية الرئيسية (Key Features)
الاستخراج متعدد المستويات (Multi-level Crawling & Request Handling):
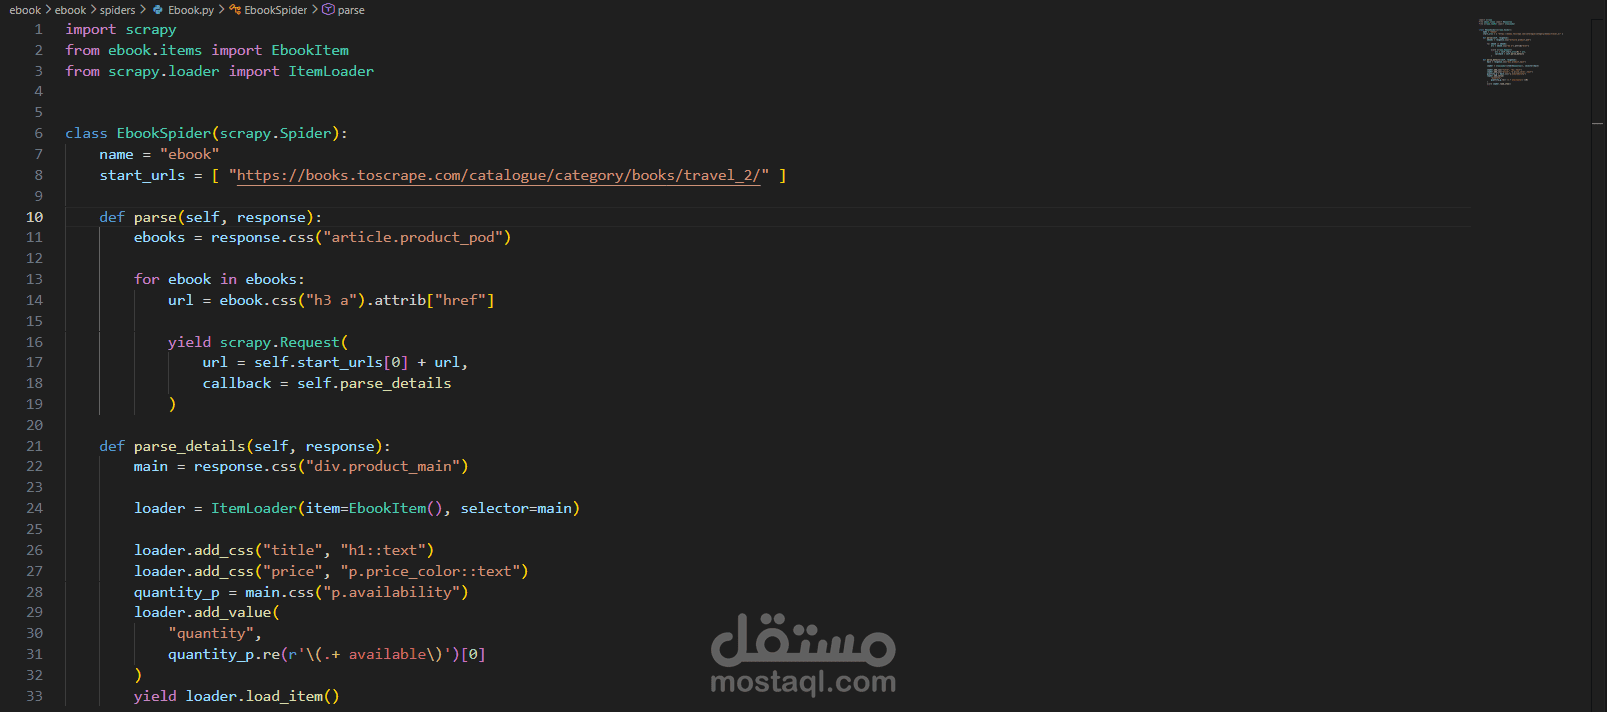
سحب قائمة المنتجات من صفحة الفهرس وتوليد طلبات فرعية (scrapy.Request) ديناميكياً لتتبع روابط صفحات التفاصيل لكل منتج عبر parse_details callback.
التنظيف الآلي أثناء الاستخراج (On-the-fly Data Cleaning):استخدام ItemLoader لفصل منطق السحب عن المعالجة، مما يجعل الكود نظيفاً وقابلاً للتطوير (Clean & Modular Architecture).
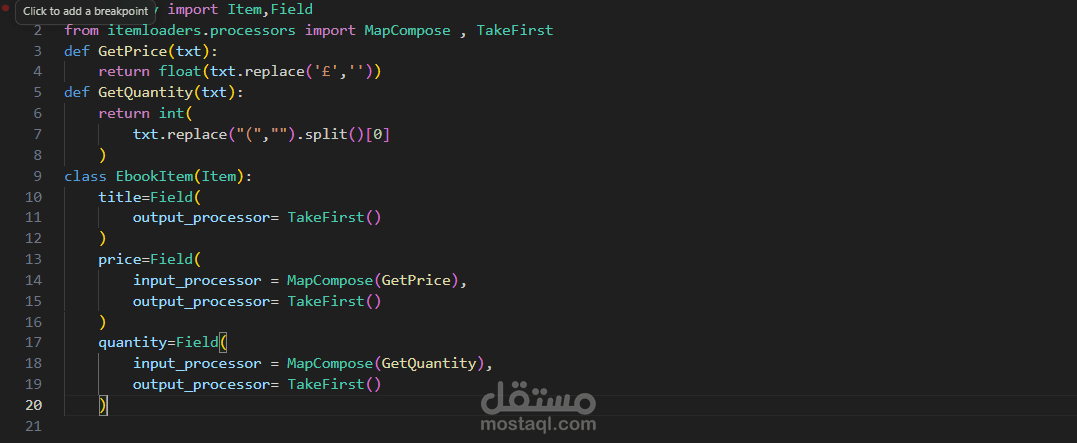
بناء Input Processors مخصصة باستخدام MapCompose:تنظيف رمز العملة (£) وتحويل السعر مباشرة من نص إلى قيمة عشرية رياضية (float).
استخراج عدد النسخ المتوفرة (quantity) باستخدام التعبيرات النمطية (Regular Expressions) وإزالة الأقواس والكلمات الزائدة والتحويل إلى رقم صحيح (int).
استخدام Output Processors مثل TakeFirst لضمان الحصول على قيم مفردة ونظيفة بدلاً من القوائم (Lists).
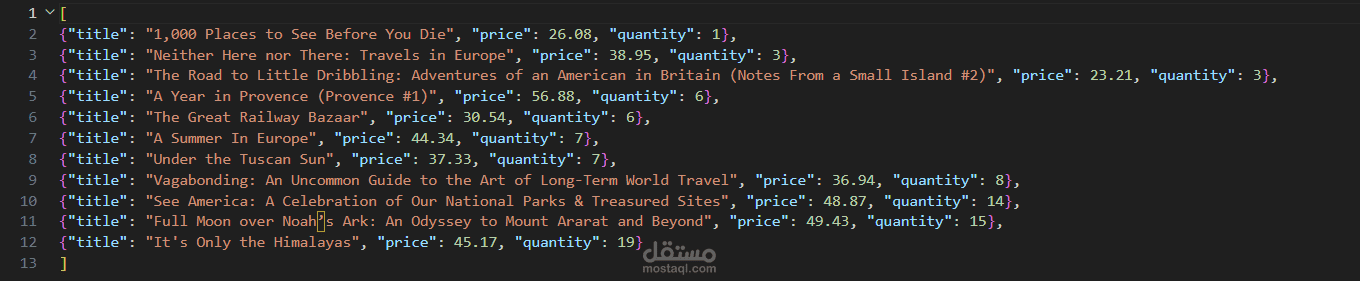
هيكلة وتصدير البيانات (Structured Data Export):تصدير المخرجات النهائية إلى تنسيق JSON جاهز للتحميل والربط مع قواعد البيانات أو أدوات الـ BI والتحليل الإحصائي.
الأدوات والتقنيات المستخدمة (Tech Stack)
Python
Scrapy (Spider, ItemLoader, Requests, Selectors)
itemloaders.processors (MapCompose, TakeFirst)
CSS Selectors & Regex (معالجة النصوص وتحديد العناصر)
JSON (تخزين وهيكلة المخرجات)