CV Scanning
تفاصيل العمل
# نظام الفرز الذكي للسير الذاتية وإدارة طلبات التوظيف
**ICON AI Automations | AI-Powered CV Screening & Recruitment Management**
## نبذة عن المشروع
نظام ذكي لأتمتة عملية استقبال السير الذاتية وتحليلها وتقييم المتقدمين للوظائف باستخدام الذكاء الاصطناعي، مع ربط جميع البيانات بقاعدة بيانات مركزية لضمان دقة المعلومات، ومنع التكرار، وتسهيل متابعة المرشحين واتخاذ قرارات التوظيف.
تم تطوير النظام باستخدام **n8n وTally وGoogle Gemini AI وSupabase**، بهدف تقليل الوقت المستغرق في الفرز اليدوي للسير الذاتية وتحويل عملية التوظيف إلى عملية منظمة وقابلة للتوسع.
## أولاً: استقبال طلبات التوظيف
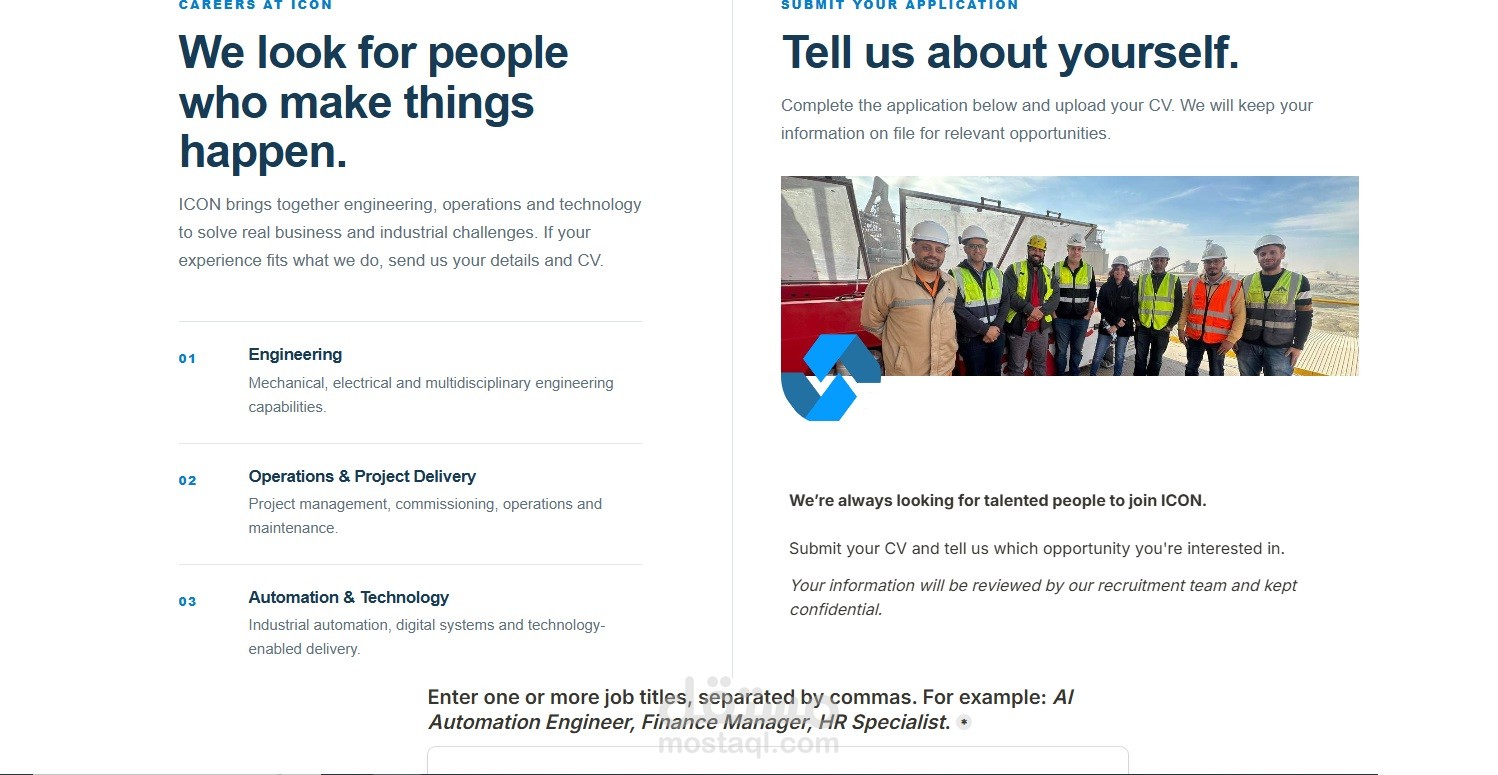
تبدأ العملية من خلال نموذج إلكتروني تم إنشاؤه باستخدام **Tally**، يتيح للمتقدمين:
- إدخال الاسم الكامل.
- تسجيل البريد الإلكتروني.
- رفع السيرة الذاتية (CV).
- تحديد الوظيفة المتقدم إليها.
بمجرد إرسال النموذج، يتم تشغيل Workflow تلقائيًا داخل n8n لمعالجة الطلب، دون الحاجة إلى إدخال البيانات يدويًا.
## ثانيًا: تحليل السير الذاتية بالذكاء الاصطناعي
يستخدم النظام نموذج **Google Gemini AI** لتحليل السيرة الذاتية ومقارنتها بمتطلبات الوظيفة.
ويشمل التقييم:
1. **المؤهلات العلمية:** مدى توافق المؤهل الدراسي مع متطلبات الوظيفة.
2. **المهارات:** تحليل المهارات الفنية والمهنية المطلوبة.
3. **الخبرة العملية:** تقييم سنوات الخبرة وطبيعة الوظائف السابقة.
4. **مدى الملاءمة الوظيفية:** تحديد درجة توافق المرشح مع الوظيفة.
5. **المتطلبات المفضلة:** قياس مدى توافر المؤهلات والمهارات الإضافية.
بعد التحليل، ينتج النظام تقريرًا منظمًا بصيغة JSON يحتوي على:
- درجات التقييم في المعايير المختلفة.
- درجة التوافق الإجمالية (Match Score).
- توصية بشأن مدى ملاءمة المرشح.
- ملخص مهني للسيرة الذاتية.
- نقاط القوة.
- نقاط الضعف.
- المتطلبات غير المتوافرة لدى المرشح.
يساعد هذا التقييم مسؤول التوظيف على تحديد المرشحين الأنسب بصورة أسرع، مع الاحتفاظ بالقرار النهائي للمراجعة البشرية.
## ثالثًا: إدارة البيانات باستخدام Supabase
تم ربط النظام بقاعدة بيانات **Supabase المبنية على PostgreSQL**، لتخزين المعلومات بطريقة منظمة ومترابطة.
وتتكون قاعدة البيانات من خمسة جداول رئيسية:
**1. Candidates – المرشحون**
تخزين البيانات الأساسية للمتقدمين، مثل الاسم والبريد الإلكتروني وبيانات التواصل.
**2. Vacancies – الوظائف الشاغرة**
تخزين الوظائف ومتطلباتها، بما يسمح بمقارنة كل سيرة ذاتية بالوظيفة المناسبة.
**3. Applications – طلبات التوظيف**
ربط كل مرشح بالوظيفة التي تقدم إليها، مع الاحتفاظ بحالة الطلب ومراحل معالجته.
**4. Screening Results – نتائج الفرز**
تخزين نتائج تحليل الذكاء الاصطناعي، بما يشمل الدرجات والتوصيات ونقاط القوة والضعف.
**5. Interviews – المقابلات**
تخزين بيانات المقابلات وربطها بطلبات التوظيف، لدعم متابعة المرشحين خلال المراحل التالية.
يسمح هذا التصميم بوجود مرشح واحد يتقدم إلى وظائف مختلفة، مع الاحتفاظ بنتيجة تقييم مستقلة لكل طلب.
## رابعًا: منع التكرار وحماية سلامة البيانات
من أهم مميزات النظام أنه لا يكتفي بتخزين البيانات، بل يتضمن عدة مستويات للتحكم في التكرار ومنع إنشاء سجلات غير ضرورية.
### 1. منع تكرار طلب التوظيف
تم إنشاء قيد فريد (Unique Constraint) على الحقلين:
`candidate_id + vacancy_id`
وبذلك لا يمكن إنشاء أكثر من طلب توظيف واحد لنفس المرشح على نفس الوظيفة.
لكن يمكن للمرشح نفسه التقدم إلى وظائف مختلفة دون مشكلة.
### 2. التحقق من وجود الطلب قبل إنشائه
يستخدم Workflow خطوة **Application Exists?** للتحقق مما إذا كان طلب التوظيف مسجلًا بالفعل.
- إذا لم يكن موجودًا، يتم إنشاء طلب جديد.
- إذا كان موجودًا، يتم استخدام السجل الحالي بدلًا من إنشاء سجل مكرر.
### 3. منع تكرار نتائج الفرز
تم إنشاء قيد فريد على:
`screening_results.application_id`
وهذا يضمن وجود سجل نتائج فرز واحد لكل طلب توظيف.
### 4. التحقق من نتائج التحليل السابقة
قبل تخزين نتائج جديدة، يستخدم النظام خطوة **Check Existing Screening** ثم **Screening Exists?**.
إذا كانت هناك نتيجة سابقة، يمكن تحديث السجل الموجود بدلًا من إضافة سجل مكرر.
### 5. استخدام Upsert Logic
يعتمد النظام على منطق **Insert or Update**، أي إنشاء السجل إذا لم يكن موجودًا، أو تحديثه إذا كان موجودًا.
يساعد ذلك على تجنب تضخم قاعدة البيانات بالسجلات المكررة عند إعادة تشغيل Workflow أو إعادة معالجة طلب سابق.
### 6. حماية إضافية على مستوى قاعدة البيانات
لا يعتمد منع التكرار على شروط n8n فقط، بل توجد قيود فريدة داخل PostgreSQL نفسها.
وبالتالي، حتى إذا حاول Workflow إنشاء سجل مكرر، تستطيع قاعدة البيانات رفض العملية المخالفة للقيد.
**النتيجة:** نظام أكثر موثوقية، يقلل التكرار ويحافظ على العلاقات بين المرشحين والوظائف ونتائج التقييم.
## خامسًا: قائمة المقابلات الذكية
تم إنشاء Database يجمع هذه المعلومات المرتبطة من عدة جداول في عرض موحد، يتضمن:
- بيانات المرشح.
- الوظيفة المتقدم إليها.
- حالة طلب التوظيف.
- نتائج الفرز بالذكاء الاصطناعي.
- درجة التوافق والتوصية.
- بيانات المقابلة المرتبطة، عند توافرها.
بدلًا من البحث في جداول متعددة، يستطيع مسؤول التوظيف الاعتماد على مصدر بيانات موحد لمراجعة المرشحين ومتابعة المقابلات.
## سادسًا: القيمة العملية للنظام
يوفر النظام عدة فوائد لإدارة الموارد البشرية:
- **توفير الوقت:** تقليل الحاجة إلى مراجعة كل سيرة ذاتية يدويًا من البداية.
- **توحيد معايير التقييم:** تحليل المرشحين وفق معايير محددة مرتبطة بالوظيفة.
- **سهولة المقارنة:** عرض درجات التوافق ونقاط القوة والضعف.
- **تقليل التكرار:** تجنب إنشاء طلبات ونتائج تقييم مكررة.
- **تنظيم المعلومات:** الاحتفاظ ببيانات المرشحين والوظائف في قاعدة بيانات مركزية.
- **قابلية التوسع:** إمكانية تطوير النظام مستقبلًا لربطه بالمقابلات والإشعارات ولوحات التحكم.
- **دعم القرار البشري:** تقديم توصيات تساعد مسؤول التوظيف دون استبدال حكمه المهني.
## الخلاصة
هذا المشروع ليس مجرد نموذج لرفع السير الذاتية، بل **نظام متكامل للفرز الأولي الذكي وإدارة بيانات التوظيف**.
يجمع بين الذكاء الاصطناعي، وأتمتة العمليات، وقواعد البيانات العلائقية، وآليات منع التكرار، لتقديم عملية توظيف أسرع وأكثر تنظيمًا وقابلية للتطوير.
**الهدف ليس استبدال مسؤول التوظيف، بل تمكينه من التركيز على تقييم الأشخاص واتخاذ القرارات، بدلًا من استهلاك وقته في الأعمال الإدارية المتكررة.**