Linkedin Scrapper
تفاصيل العمل
# LinkedIn Jobs Radar
**نظام ذكي لأتمتة البحث عن الوظائف ومطابقتها مع اهتمامات المشتركين**
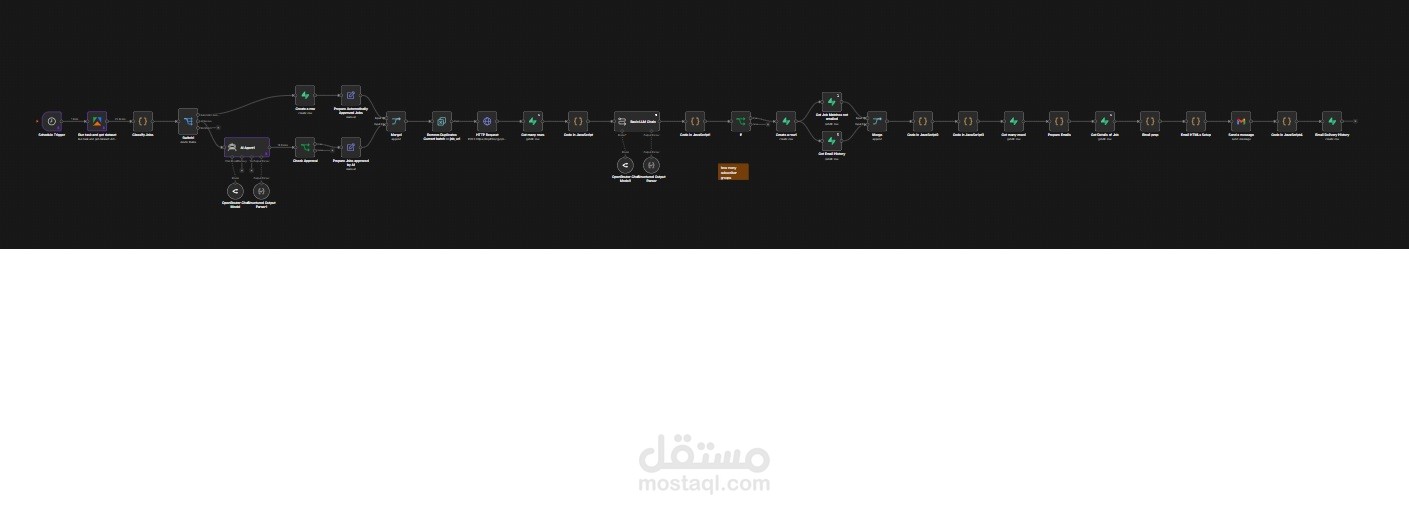
مشروع **LinkedIn Jobs Radar** هو نظام أتمتة ذكي تم تطويره باستخدام **n8n وSupabase والذكاء الاصطناعي**، بهدف جمع الوظائف الجديدة من LinkedIn، وتحليلها، ومطابقتها تلقائيًا مع اهتمامات الباحثين عن عمل، ثم إرسال الفرص المناسبة لكل مشترك عبر البريد الإلكتروني.
الفكرة مش مجرد تجميع وظائف وإرسالها، لكن بناء نظام متكامل يضمن إن كل مشترك يستقبل الوظائف المناسبة لاهتماماته، مع تقليل التكرار في البيانات والإشعارات.
## أولًا: كيف يعمل النظام؟
**1. تسجيل المشتركين**
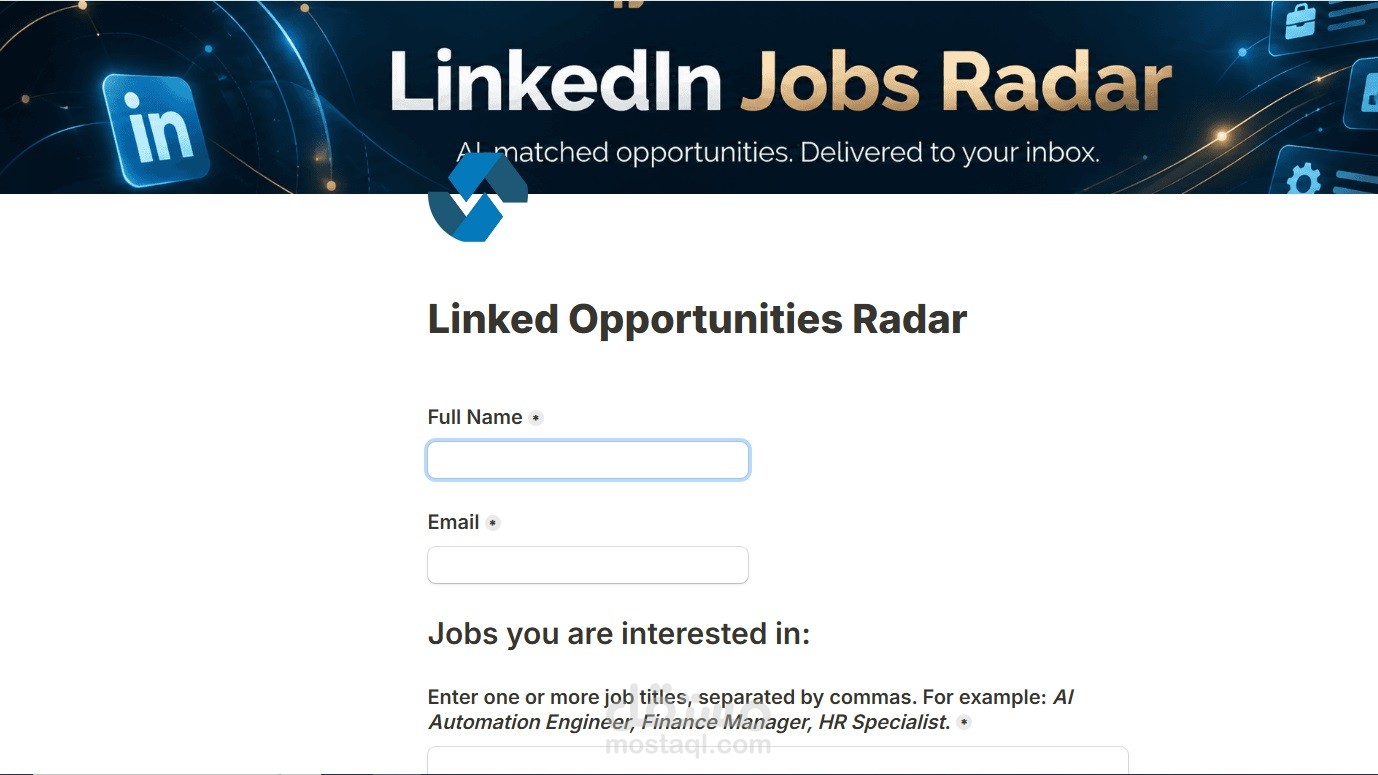
يبدأ النظام من خلال نموذج Tally، حيث يسجل المستخدم اسمه وبريده الإلكتروني والوظائف التي يهتم بها.
يتم إرسال البيانات تلقائيًا إلى n8n، ثم تخزينها في قاعدة بيانات Supabase داخل جدول `subscribers`.
**2. جمع الوظائف تلقائيًا**
يعمل النظام بشكل مجدول باستخدام Apify لجمع الوظائف المنشورة على LinkedIn، ثم إرسالها إلى n8n لمعالجتها.
**3. تصنيف الوظائف باستخدام الذكاء الاصطناعي**
يتم تحليل الوظائف على مرحلتين:
- الوظائف ذات درجة الثقة المرتفعة تمر عبر مسار الموافقة التلقائية.
- الوظائف الأخرى يتم إرسالها إلى AI Agent لتحليل الوصف الوظيفي وتحديد القسم المناسب ودرجة الثقة وقرار الموافقة.
**4. تخزين الوظائف في Supabase**
بعد اعتماد الوظائف، يتم توحيد بياناتها وتخزينها في جدول `jobs`، مع الاحتفاظ بمعرّف الوظيفة الأصلي ورابطها والمسمى الوظيفي والشركة والقسم ودرجة الثقة.
**5. المطابقة الذكية مع المشتركين**
يسترجع النظام بيانات المشتركين واهتماماتهم من Supabase، ثم يستخدم Basic LLM Chain لتقييم مدى ملاءمة كل وظيفة لكل مشترك.
يتم حفظ نتائج المطابقة في جدول `job_matches`، متضمنة معرّف المشترك ومعرّف الوظيفة ودرجة المطابقة.
**6. إرسال الإشعارات بالبريد الإلكتروني**
يتم تجميع الوظائف المناسبة لكل مشترك في رسالة بريد إلكتروني واحدة، بدلًا من إرسال رسالة منفصلة لكل وظيفة.
بعد الإرسال، يتم تحديث سجل الإشعارات في Supabase مع حالة الإرسال ومعرّف الرسالة الذي يرجعه Gmail.
## ثانيًا: كيف نتجنب تكرار البيانات والإشعارات؟
من أهم جوانب المشروع إننا بنعالج مشكلة التكرار على أكثر من مستوى، بدل الاعتماد على خطوة واحدة فقط.
### المستوى الأول: منع التكرار داخل دفعة الوظائف
نستخدم عقدة **Remove Duplicates** في n8n لفحص الوظائف التي تم جمعها خلال التشغيل الحالي، وإزالة السجلات المتكررة بناءً على الحقل المحدد للمقارنة.
وبالتالي، لو ظهرت نفس الوظيفة أكثر من مرة في نتائج البحث، يمكن استبعاد النسخ المتكررة قبل التخزين.
### المستوى الثاني: منع تكرار الوظائف بين مرات التشغيل
نستخدم Supabase مع آلية **Upsert** عبر HTTP Request.
بدلًا من إضافة نفس الوظيفة كسجل جديد في كل تشغيل، يستطيع النظام تحديث السجل الموجود عند اكتشاف تعارض في المفتاح الفريد.
كما توجد قيود فريدة داخل قاعدة البيانات على روابط الوظائف، بالإضافة إلى فهرس فريد لمعرّف الوظيفة الخارجي مع مصدرها.
وده مهم لأن نفس الوظيفة ممكن تظهر في نتائج LinkedIn اليوم وبكرة، حتى لو تم ضبط البحث على آخر 24 ساعة.
### المستوى الثالث: منع تكرار المطابقة
داخل جدول `job_matches` يوجد قيد فريد على:
`subscriber_id + job_id`
وده يمنع تخزين نفس العلاقة بين المشترك والوظيفة أكثر من مرة.
لكن في نفس الوقت يسمح بمطابقة نفس الوظيفة مع مشتركين مختلفين.
### المستوى الرابع: منع تكرار إرسال نفس الوظيفة
نستخدم جدول `email_delivery_history` لتسجيل عمليات إرسال الوظائف للمشتركين.
قبل تجهيز الرسائل، يسترجع النظام:
- الوظائف المطابقة للمشتركين من `job_matches`.
- سجلات الإرسال السابقة التي حالتها `sent` من `email_delivery_history`.
ثم تتم مقارنة البيانات لاستبعاد أي وظيفة سبق إرسالها لنفس المشترك.
كمان يوجد قيد فريد على `subscriber_id + job_id` داخل سجل الإرسال، لإضافة طبقة حماية على مستوى قاعدة البيانات.
وبالتالي، حتى لو ظهرت الوظيفة مرة أخرى في عملية جمع جديدة، يمكن للنظام التعرف على أنها أُرسلت بالفعل لهذا المشترك وعدم إدراجها في رسالة جديدة.
**ملاحظة تقنية:** هذه الآليات توفر حماية قوية ضد التكرار، لكن ضمان عدم إرسال أي إشعار مكرر في جميع الظروف يحتاج أيضًا إلى إدارة حالات `pending` ومعالجة التشغيل المتزامن وإعادة المحاولة، لأن تسجيل نجاح الإرسال يحدث بعد استجابة Gmail.
## ثالثًا: لماذا استخدمنا Supabase؟
Supabase مش مجرد مكان لتخزين البيانات في المشروع، لكنه عنصر أساسي في تنظيم النظام وربط مراحله المختلفة.
اعتمدنا على أربع جداول رئيسية:
| الجدول | وظيفته |
|---|---|
| `subscribers` | حفظ المشتركين واهتماماتهم |
| `jobs` | حفظ الوظائف ونتائج تصنيفها |
| `job_matches` | ربط الوظائف بالمشتركين المناسبين |
| `email_delivery_history` | تتبع الإشعارات ومنع إعادة إرسال الوظائف |
استخدام قاعدة بيانات PostgreSQL من خلال Supabase يوفر عدة مزايا:
- تنظيم البيانات في جداول مترابطة بدل تخزينها بشكل عشوائي.
- استخدام مفاتيح أساسية وفريدة لحماية سلامة البيانات.
- الاحتفاظ بتاريخ المطابقات والإشعارات عبر مرات التشغيل.
- سهولة استرجاع البيانات من n8n.
- إمكانية تطوير النظام مستقبلًا لإضافة منصات توظيف أخرى ولوحات متابعة وتقارير.
## رابعًا: ما الذي يجعل النظام فعالًا؟
النظام يجمع بين ثلاث تقنيات، لكل واحدة دور واضح:
**n8n:** يدير تسلسل العمليات، وجدولة التنفيذ، ونقل البيانات، والتكامل بين الخدمات.
**الذكاء الاصطناعي:** يحلل الوظائف ويقيّم مدى مناسبتها للمشتركين، بدل الاعتماد فقط على التطابق الحرفي للكلمات.
**Supabase:** يحتفظ بالبيانات والعلاقات وسجل العمليات، ويطبق قيودًا تمنع تكرار السجلات.
النتيجة هي نظام يقلل التدخل اليدوي في البحث والتصنيف والمطابقة وتجهيز الإشعارات، ويساعد على إرسال فرص أكثر ارتباطًا باهتمامات كل مشترك.
## الخلاصة
**LinkedIn Jobs Radar مش مجرد أداة بتجمع وظائف من LinkedIn.**
هو نظام أتمتة متكامل يبدأ من تسجيل المشترك، ويمر بجمع الوظائف وتحليلها بالذكاء الاصطناعي، ثم مطابقتها مع الاهتمامات الشخصية وإرسالها بالبريد الإلكتروني.
وأحد أهم جوانبه الهندسية هو استخدام **عدة طبقات لمنع التكرار**: داخل دفعة البيانات، وعند التخزين في Supabase، وعند إنشاء المطابقات، وقبل إرسال الإشعارات.
وده بيخلي النظام أكثر تنظيمًا وكفاءة وقابلية للتوسع، مع إمكانية تطويره لاحقًا ليصبح منصة متكاملة للتوصية بالوظائف من مصادر متعددة.