تنظيف داتا uper
تفاصيل العمل
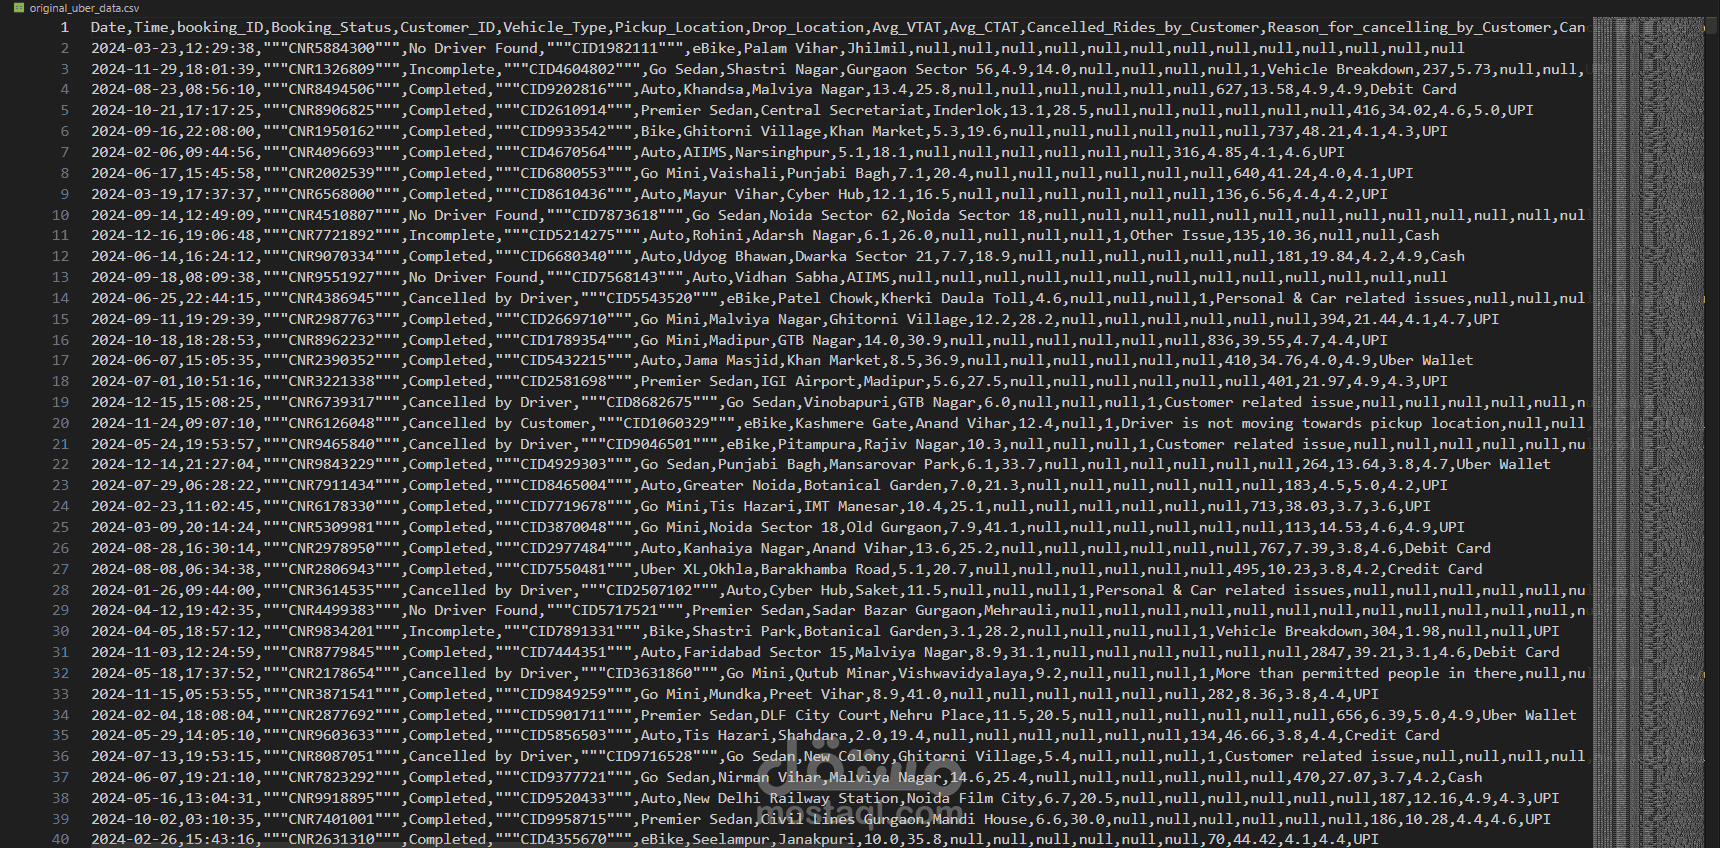
مشروع عملي لمعالجة وتجهيز بيانات رحلات أوبر (Uber Data) باستخدام Python ومكتبة Pandas. الهدف من المشروع هو تحويل البيانات الأولية (Raw Data) المليئة بالقيم المفقودة والتكرارات إلى داتا نظيفة وجاهزة للتحليل الإحصائي وبناء التقارير دون تشويه المؤشرات المالية الأساسية.
خطوات العمل (Pipeline Workflow)
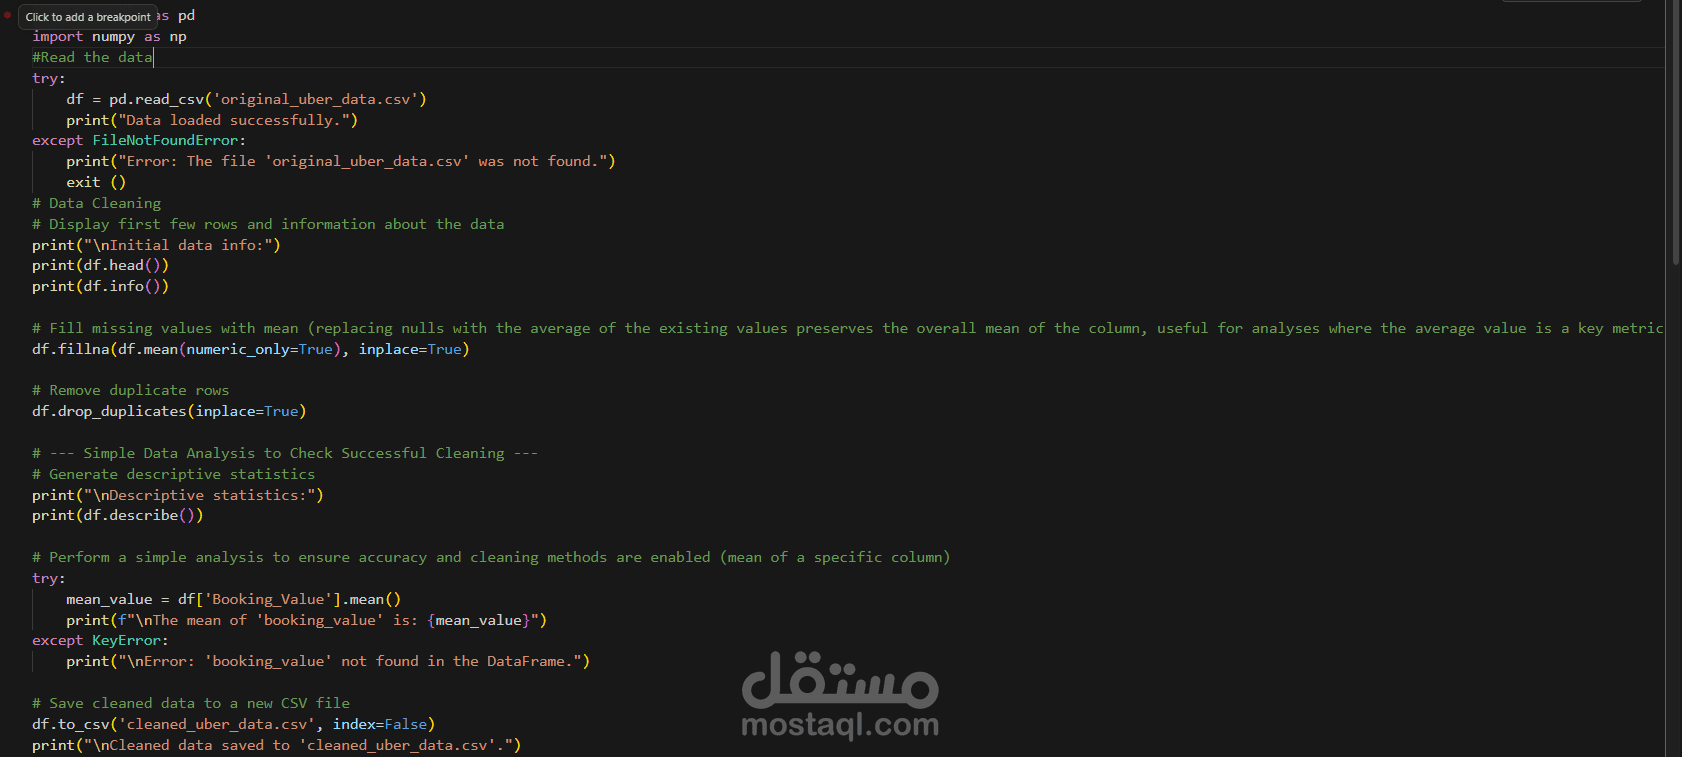
تحميل البيانات والتحقق (Data Ingestion & Validation):
قراءة ملف البيانات الأولي مع تطبيق Exception Handling لاكتشاف ومعالجة أخطاء مسارات الملفات (FileNotFoundError) تلقائياً قبل بدء التنفيذ.
استكشاف أولي للبنية عبر فحص أنواع البيانات وتوزيع الأعمدة (head, info).
معالجة القيم المفقودة (Handling Missing Data):
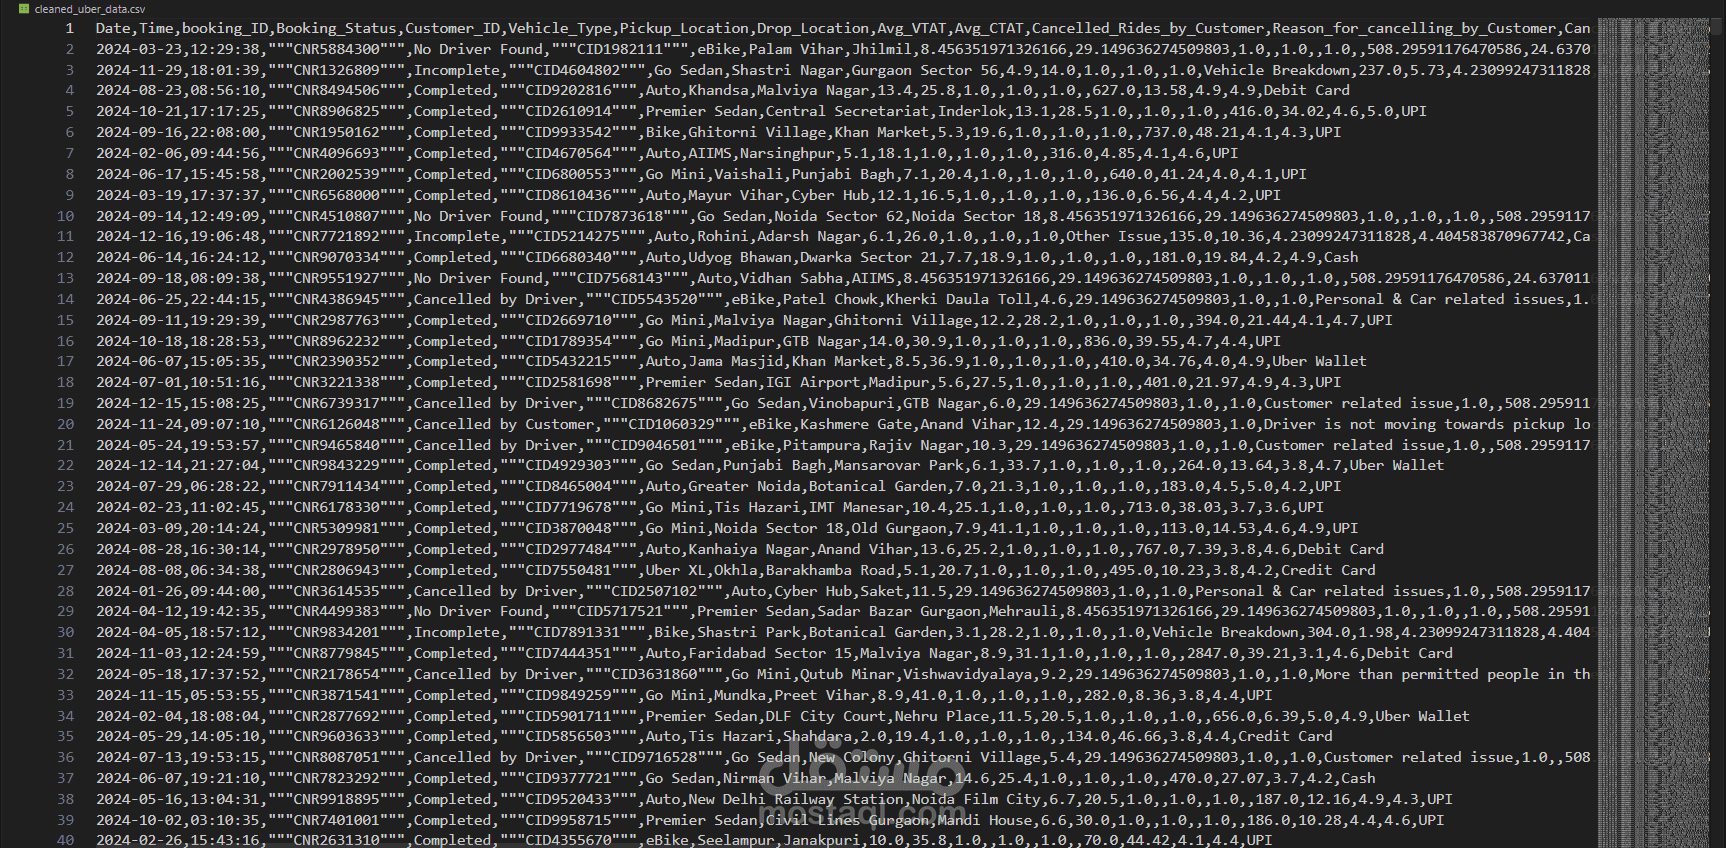
تعويض القيم الرقمية الفارغة (Nulls) باستخدام المتوسط الحسابي (Mean Imputation) للأعمدة العددية فقط (numeric_only=True)؛ للحفاظ على توازن التوزيع الإحصائي العام للبيانات.
إزالة التكرارات (Deduplication):
التخلص من السجلات والصفوف المكررة بالكامل (drop_duplicates) لضمان عدم تضخيم أحجام العينات أو التأثير سلباً على العمليات الحسابية.
التحقق من جودة التنظيف (Post-Cleaning Verification):
استخراج الإحصاءات الوصفية الأساسية (describe) للتحقق من سلامة الأرقام بعد المعالجة.
عمل فحص دقيق (Sanity Check) على المؤشرات التشغيلية والمالية مثل عمود Booking_Value للتأكد من منطقية المتوسط الحسابي وجاهزية البيانات للـ BI Tools أو نماذج الـ ML.
تصدير المخرجات (Data Export):
حفظ النسخة النظيفة في ملف مهيأ ومستقل cleaned_uber_data.csv بدون فهرس إضافي (index=False) لتسهيل الربط مع أدوات التحليل الأخرى.
الأدوات المستخدمة (Tech Stack)
Python
Pandas: معالجة وهيكلة البيانات وتطبيق استراتيجيات التنظيف.
NumPy: العمليات الرياضية والإحصائية.