Mini Search Engine | Python & Information Retrieval
تفاصيل العمل
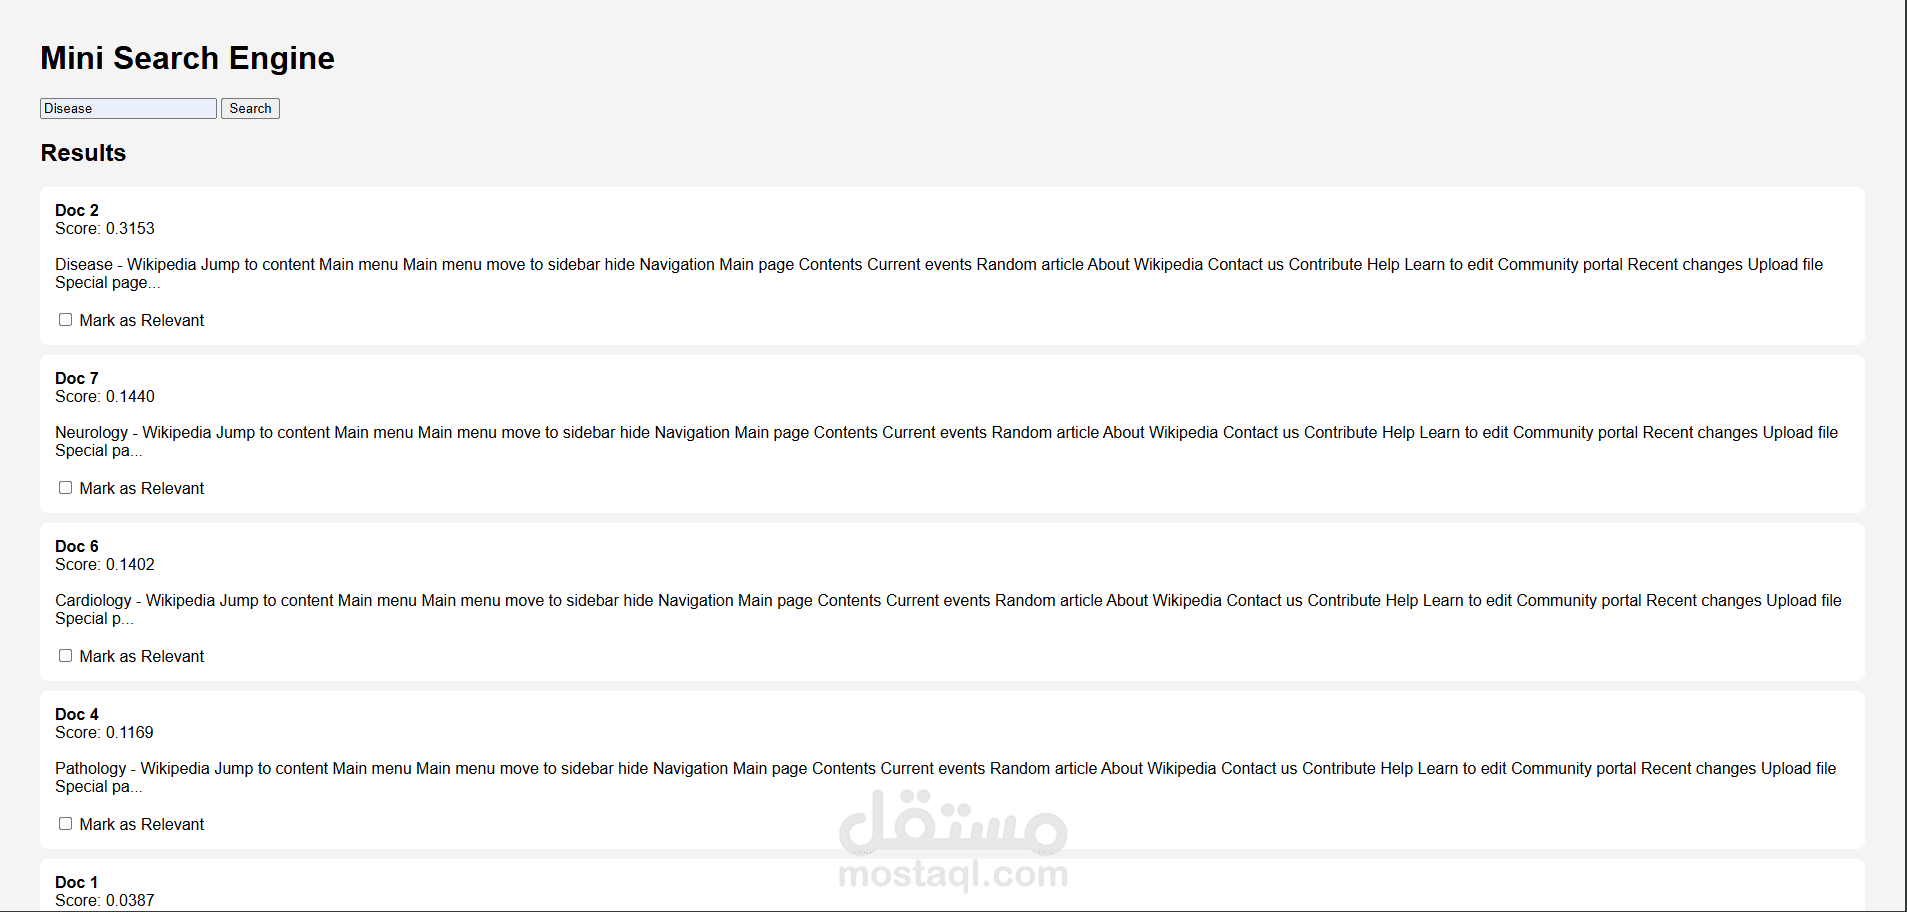
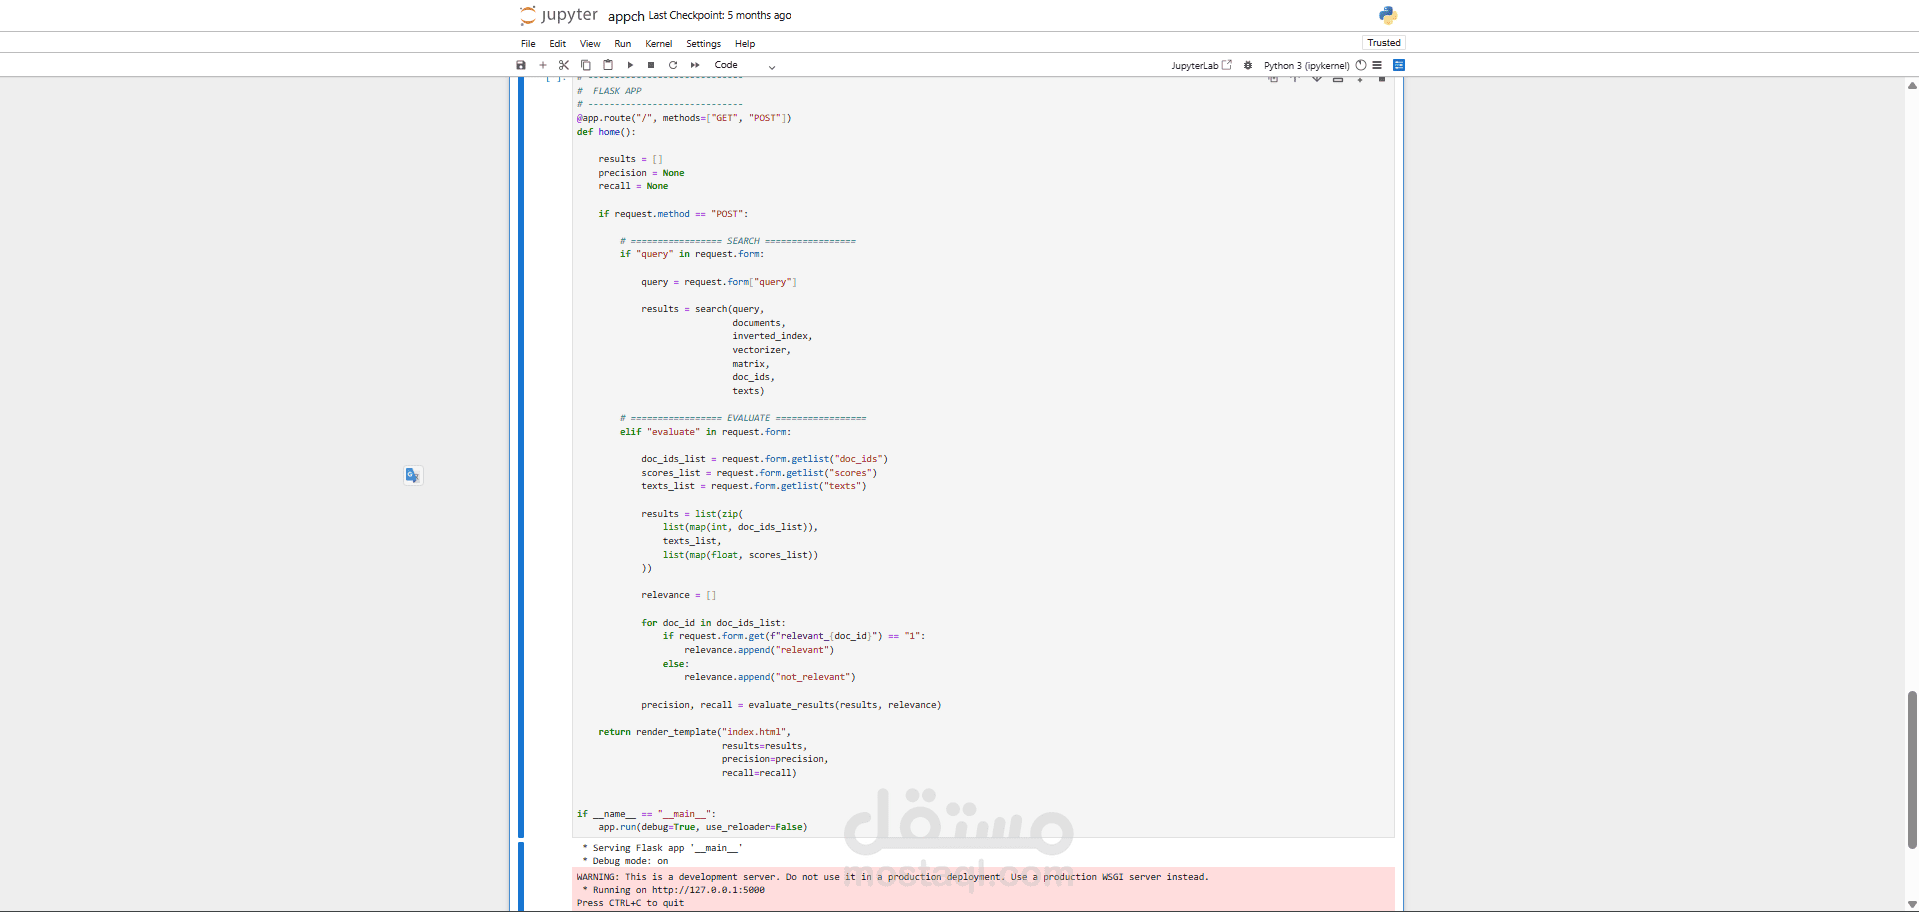
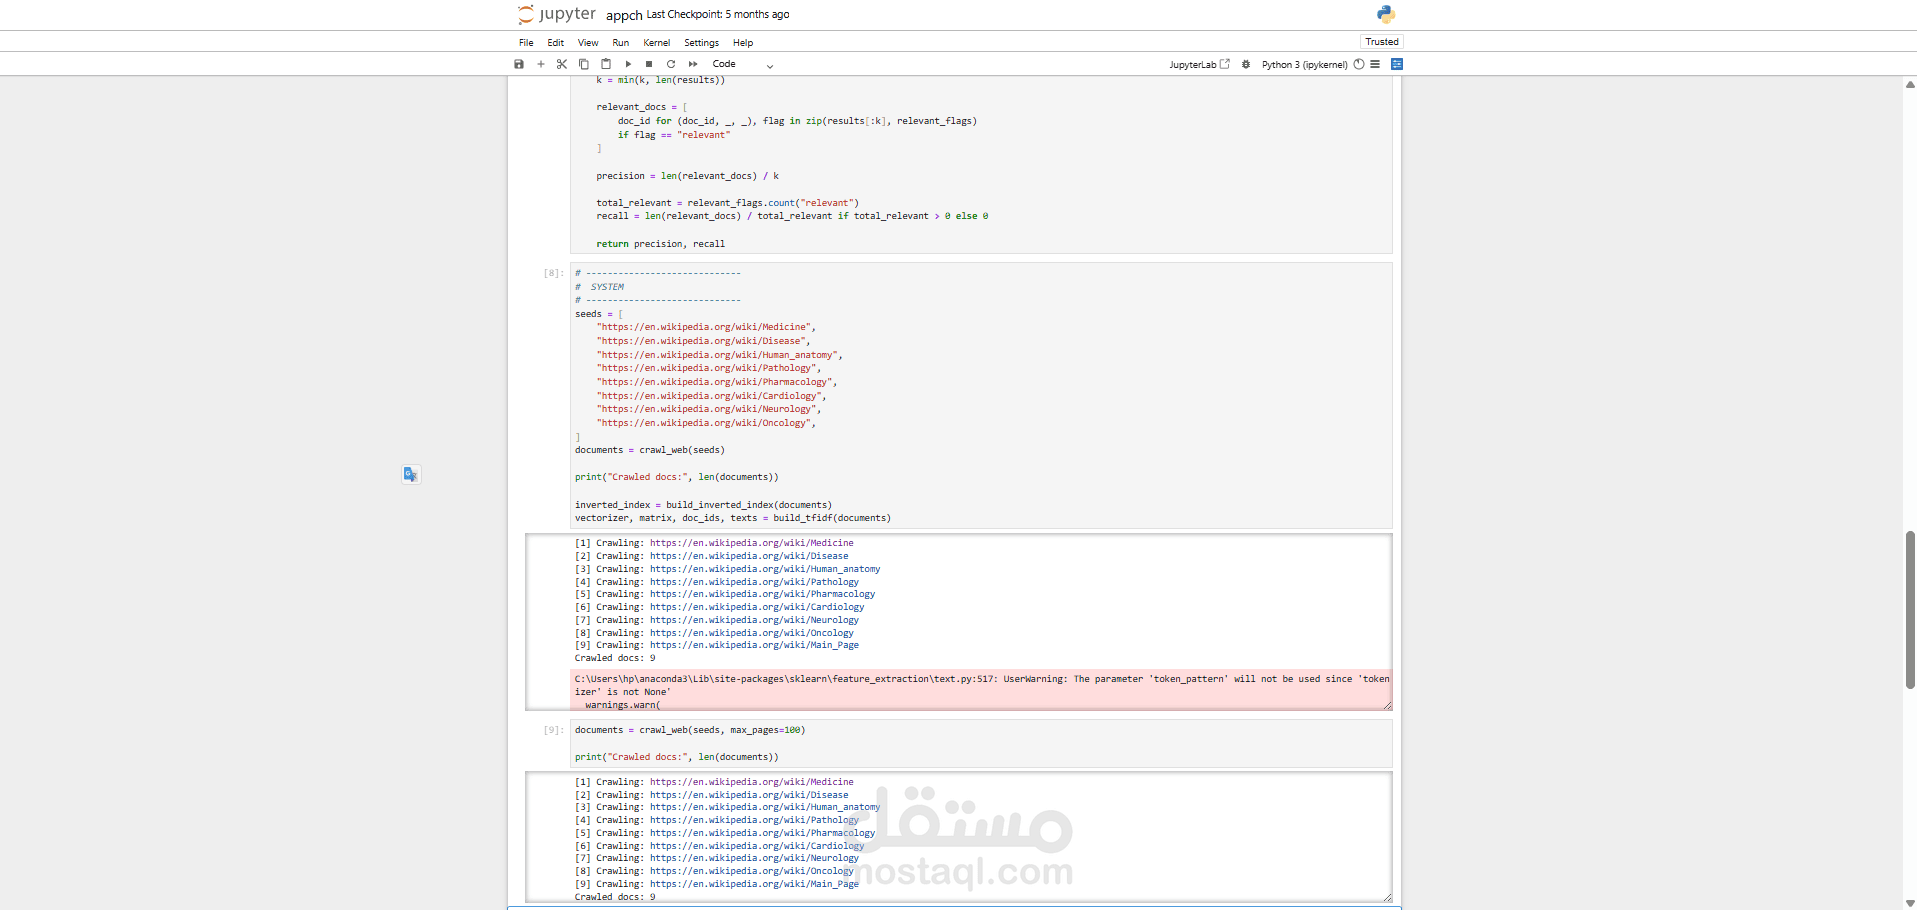
بناء محرك بحث مصغر من الصفر لاسترجاع المعلومات وتصنيف المستندات النصية بحسب درجة علاقتها بكلمات البحث.
أبرز خطوات وإنجازات المشروع:
معالجة النصوص وتزحف الويب: تطبيق Web Crawling ومعالجة النصوص باستخدام مكتبة NLTK (مثل التقطيع Stemming واستبعاد Stopwords).
الفهرسة والاسترجاع: بناء الفهرس المعكوس (Inverted Index) واستخدام خوارزمية TF-IDF ورتب التشابه الزاوي (Cosine Similarity) لترتيب المستندات الأكثر ملاءمة.
التطوير والواجهة: تقييم النظام عبر حساب Precision/Recall ونشر النظام كـ تطبيق ويب تفاعلي باستخدام إطار العمل Flask.