IMDb Top Movies Web Scraping and Data Analysis
تفاصيل العمل
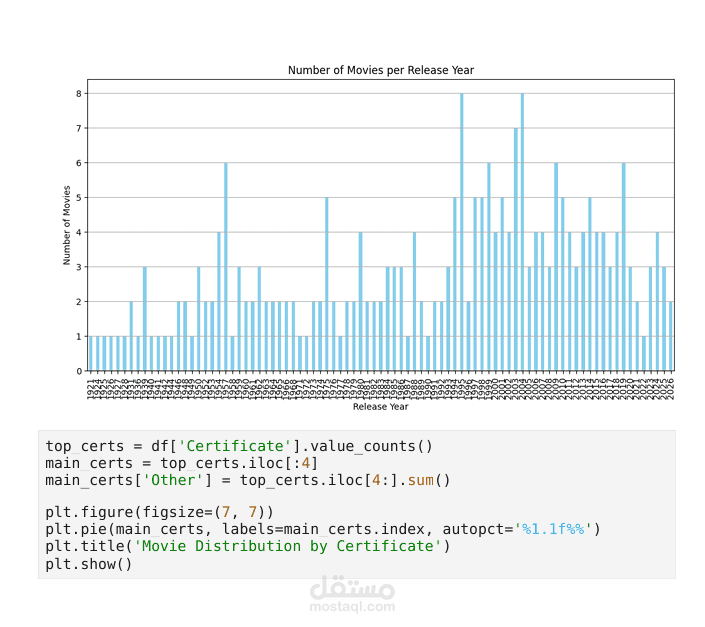
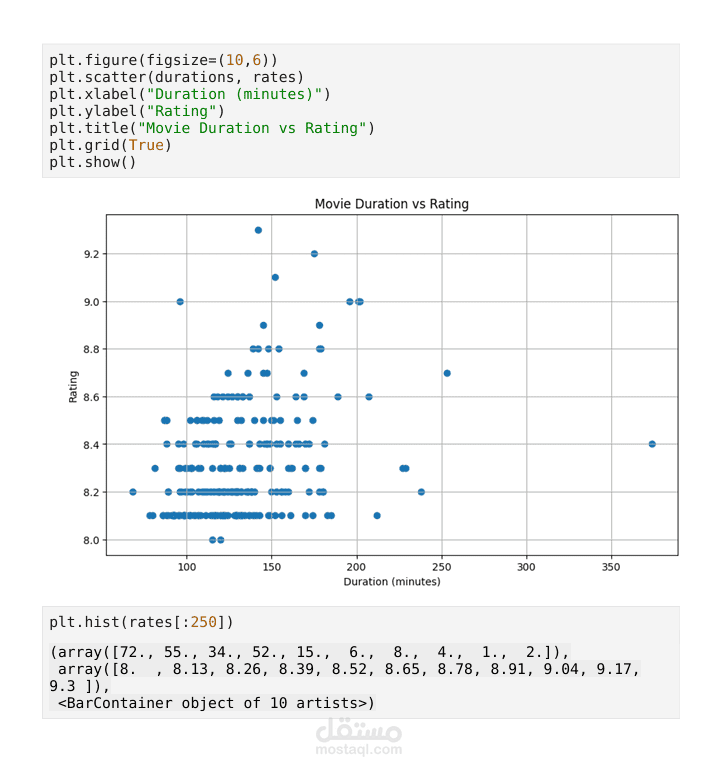
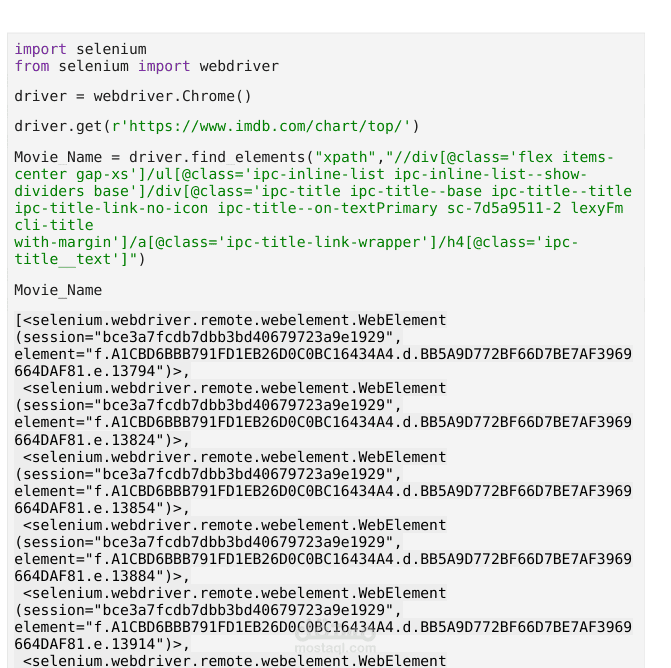
Developed a web scraping project using Python and Selenium to extract data from IMDb’s Top 250 Movies chart. Collected movie titles, release years, runtimes, age certificates, and IMDb ratings, then organized the data into a structured Pandas DataFrame. Performed data cleaning and preprocessing by handling missing values, removing duplicates, and converting data types. Created visualizations using Matplotlib to analyze movie ratings, runtime distributions, release-year trends, and age certificate distributions.