Uber_Pickup_Cluster
تفاصيل العمل
**Uber Pickup Clustering | تحليل وتحديد مناطق الطلب المرتفع**
تطوير نظام Machine Learning لتحليل بيانات رحلات Uber في نيويورك، واكتشاف مناطق الطلب المرتفع (Hotspots) باستخدام تقنيات Unsupervised Learning.
**أبرز نقاط القوة والتميز:**
- **حجم البيانات:** 180,000 سجل و4 أعمدة أساسية.
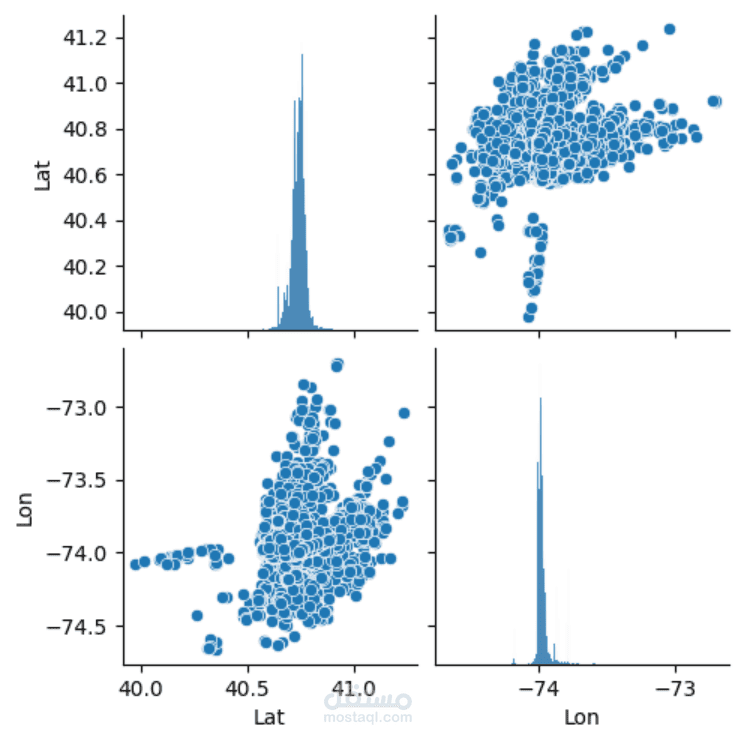
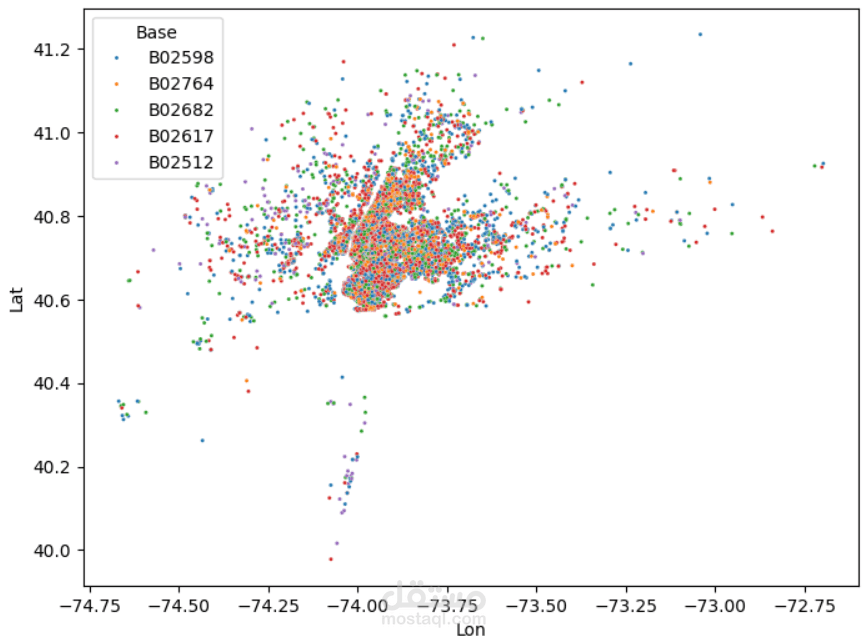
- إجراء EDA وتحليل التوزيع الجغرافي والزمني لطلبات الرحلات.
- تطبيق Feature Engineering لاستخراج الساعة واليوم والشهر من بيانات الوقت.
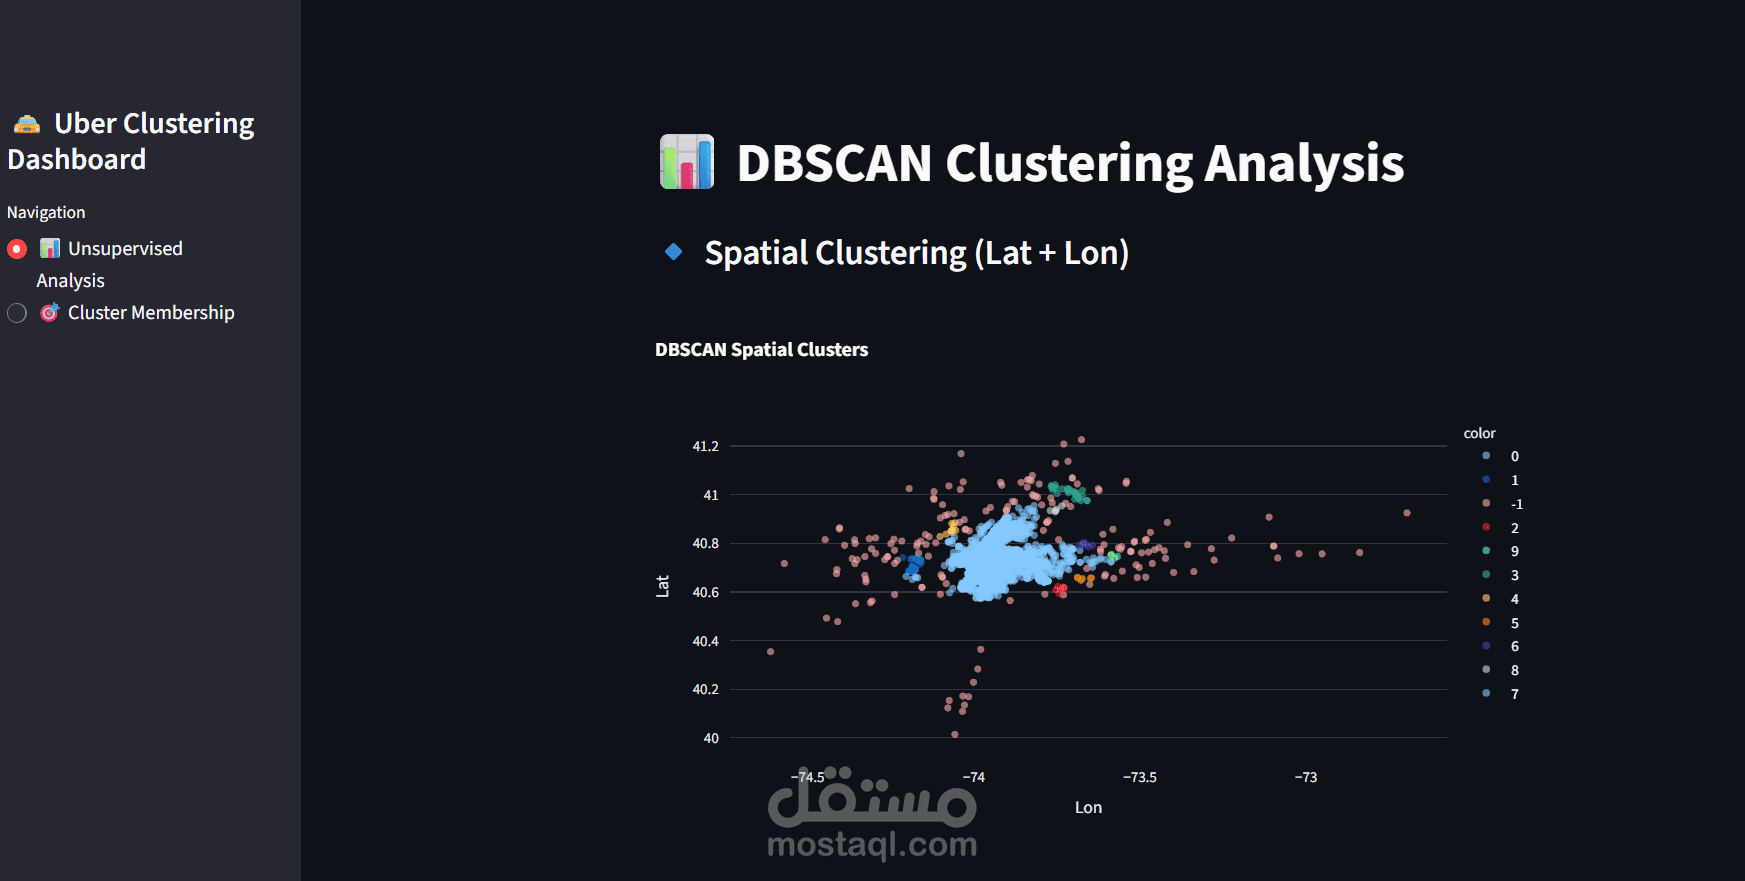
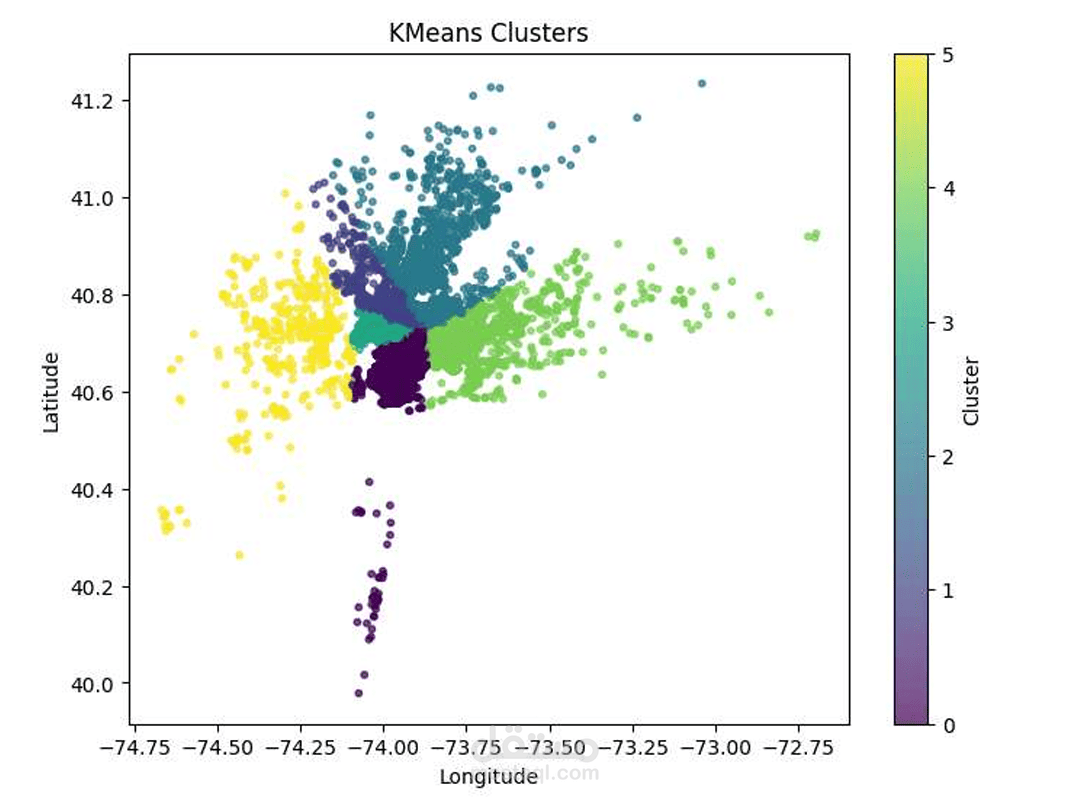
- بناء ومقارنة خوارزميتي K-Means وDBSCAN لاكتشاف التجمعات الجغرافية.
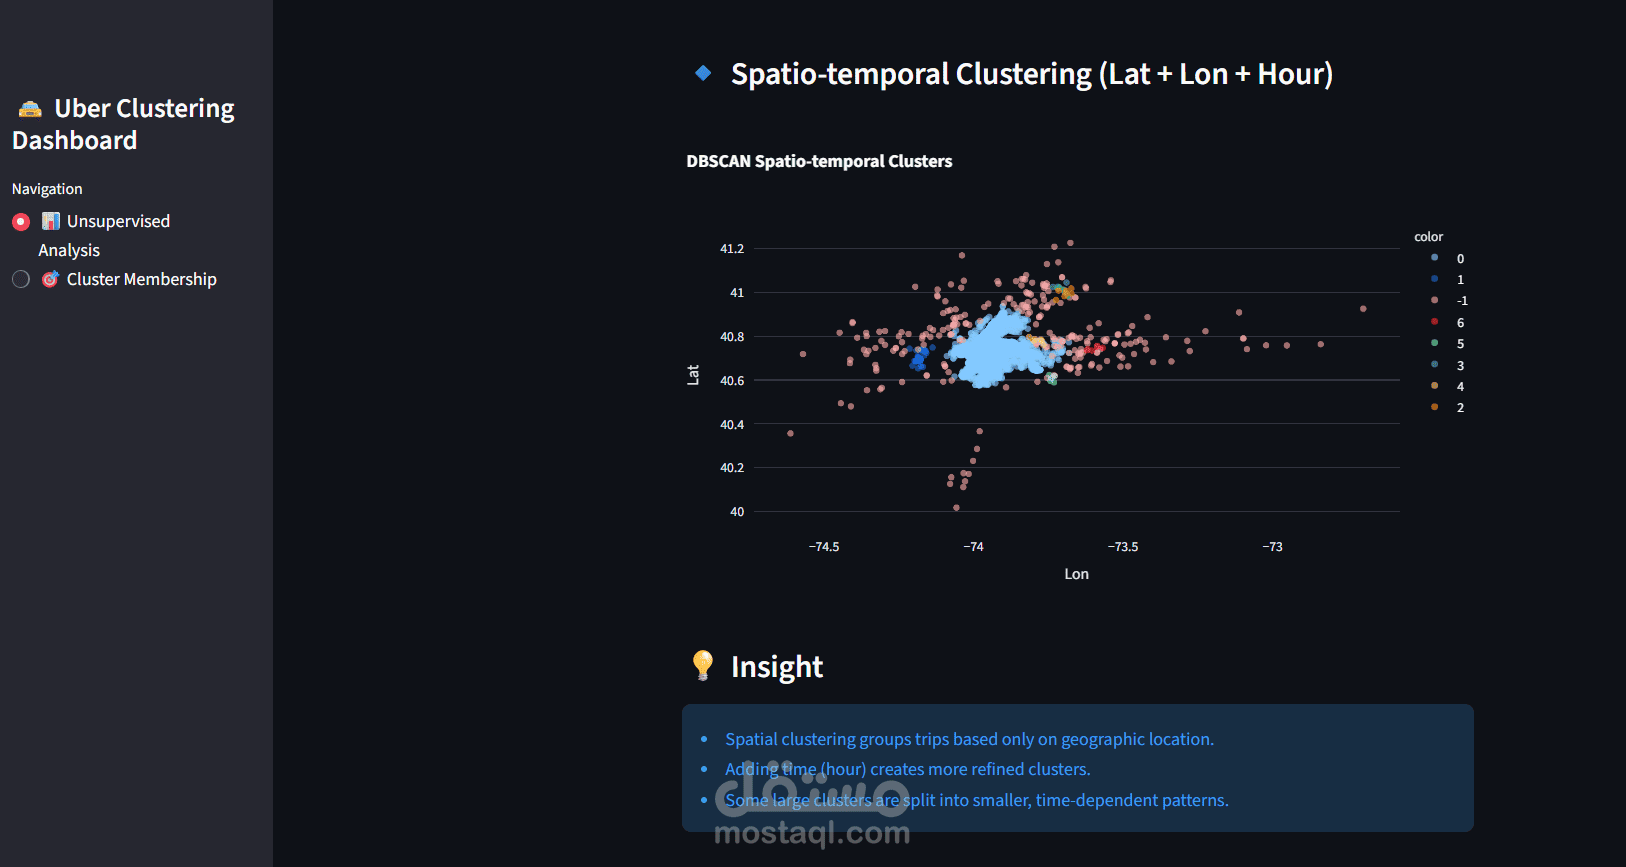
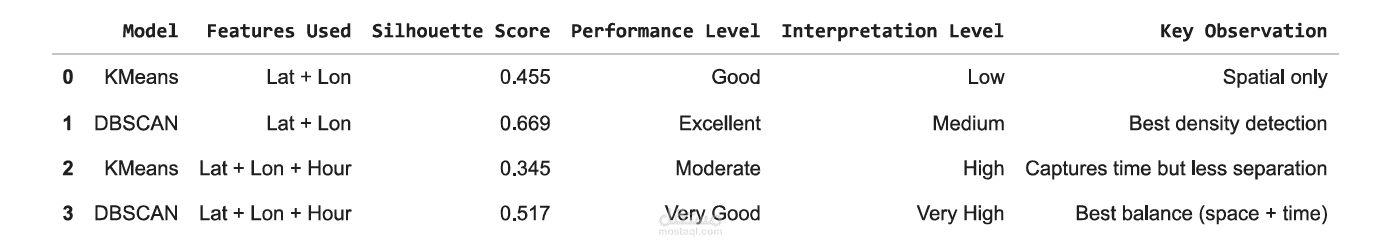
- تنفيذ تجربتين للمقارنة بين Spatial Clustering وSpatio-Temporal Clustering.
- تحسين إعدادات التجميع باستخدام Elbow Method وSilhouette Score.
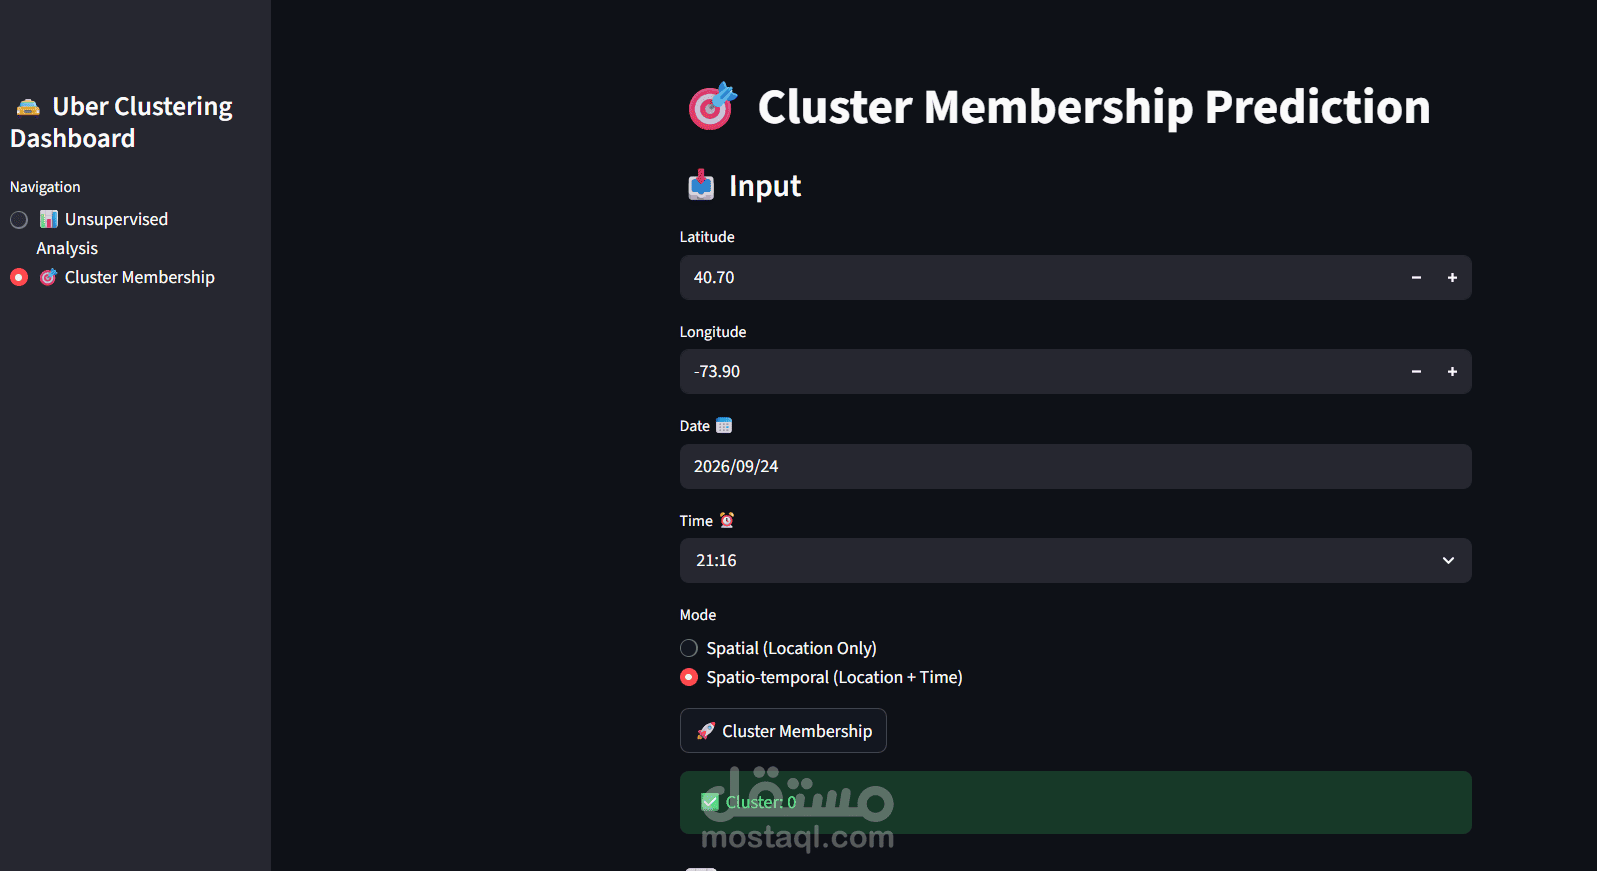
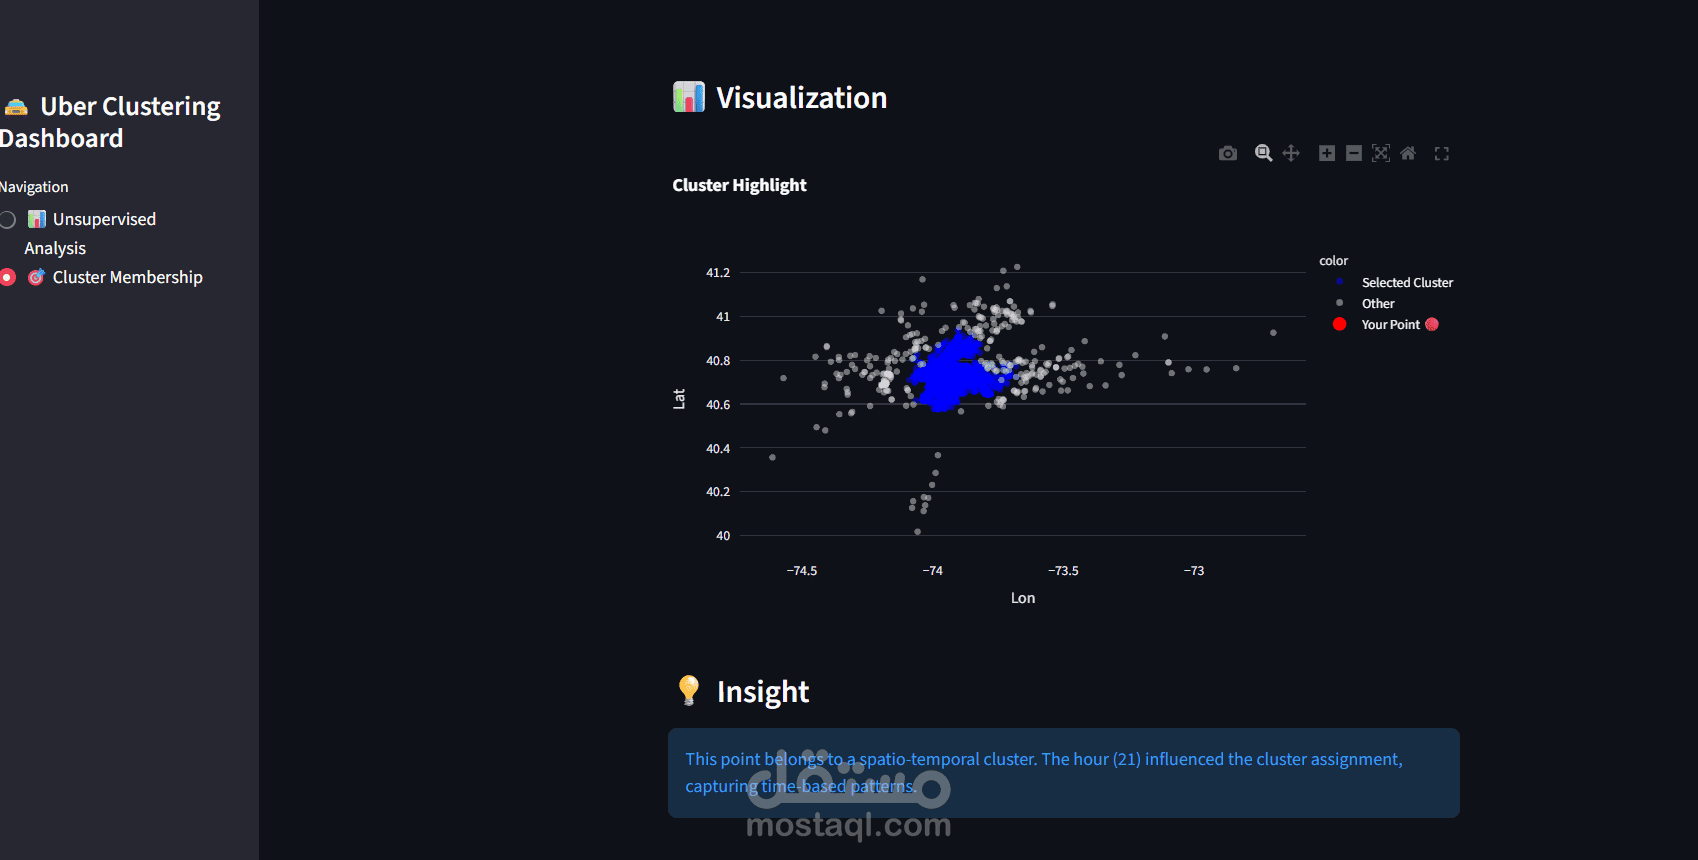
- تدريب نموذج KNN لتوقع انتماء نقاط جديدة للتجمعات المكتشفة.
**النتائج المحققة:**
- **Silhouette Score: 0.669** باستخدام DBSCAN في التحليل المكاني.
- تحديد **6 مجموعات** باستخدام K-Means بعد التحسين.
- **KNN Test Accuracy: 99.92%** في إعادة توقع تسميات التجميع المكاني الناتجة عن DBSCAN.
**التقنيات المستخدمة:**
Python | Pandas | NumPy | Scikit-learn | K-Means | DBSCAN | KNN | Matplotlib | Seaborn | Plotly
يوضح المشروع قدرتي على تحليل البيانات المكانية والزمانية، واكتشاف الأنماط الخفية وتحويل نتائج التجميع إلى نماذج قابلة لإعادة الاستخدام.