Fake Reviews Detection Using NLP & Machine Learning
تفاصيل العمل
نوع العمل:
تطوير نموذج Machine Learning باستخدام Natural Language Processing (NLP) للكشف عن المراجعات المزيفة وتصنيف النصوص إلى مراجعات حقيقية ومزيفة.
مميزات المشروع:
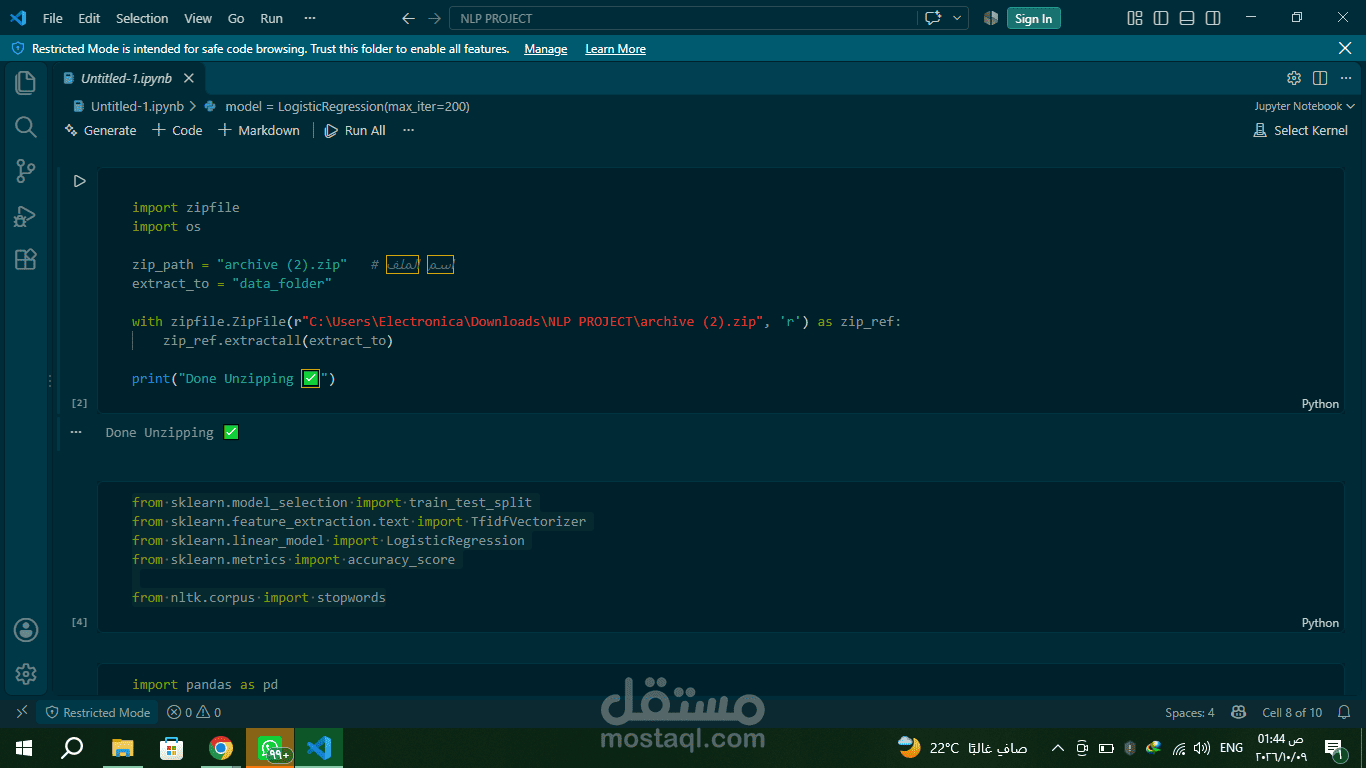
معالجة النصوص وتجهيزها للتحليل.
استخدام TF-IDF لتحويل المراجعات النصية إلى خصائص رقمية.
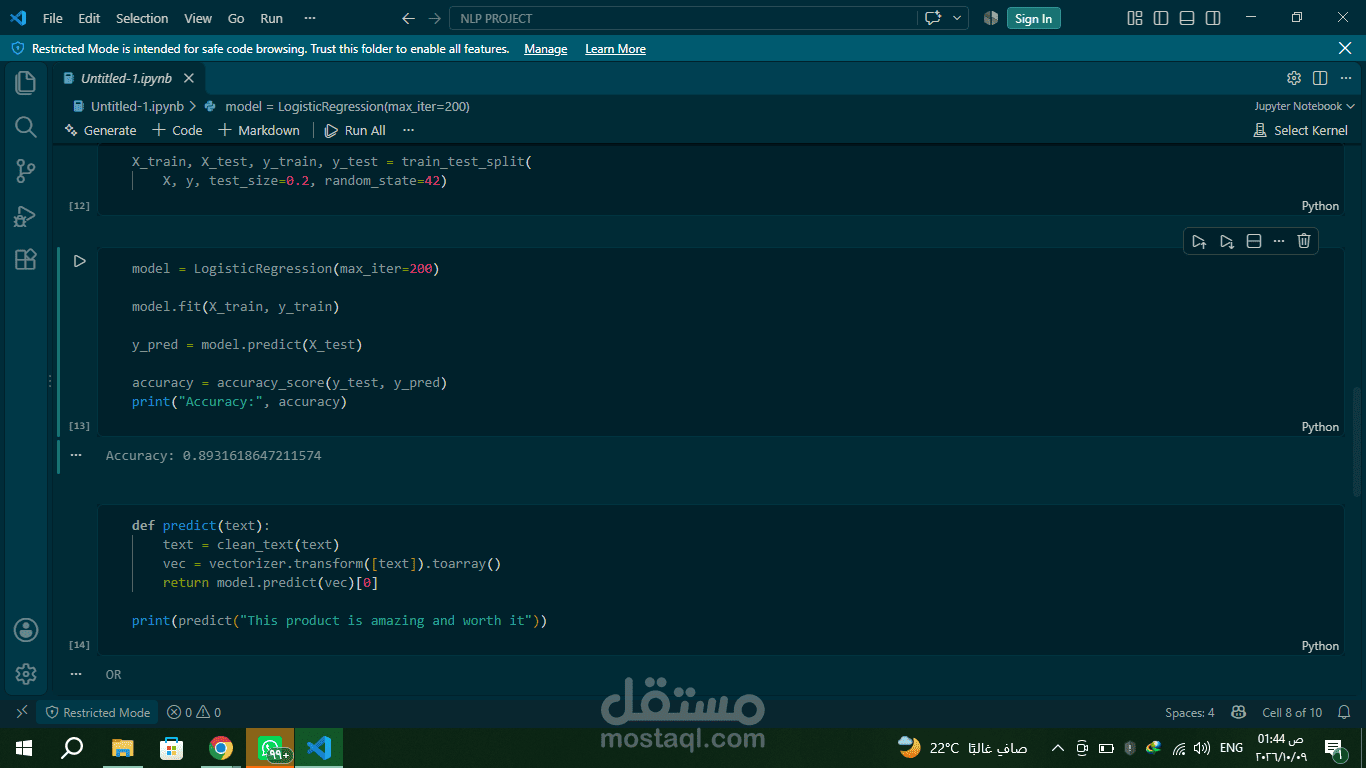
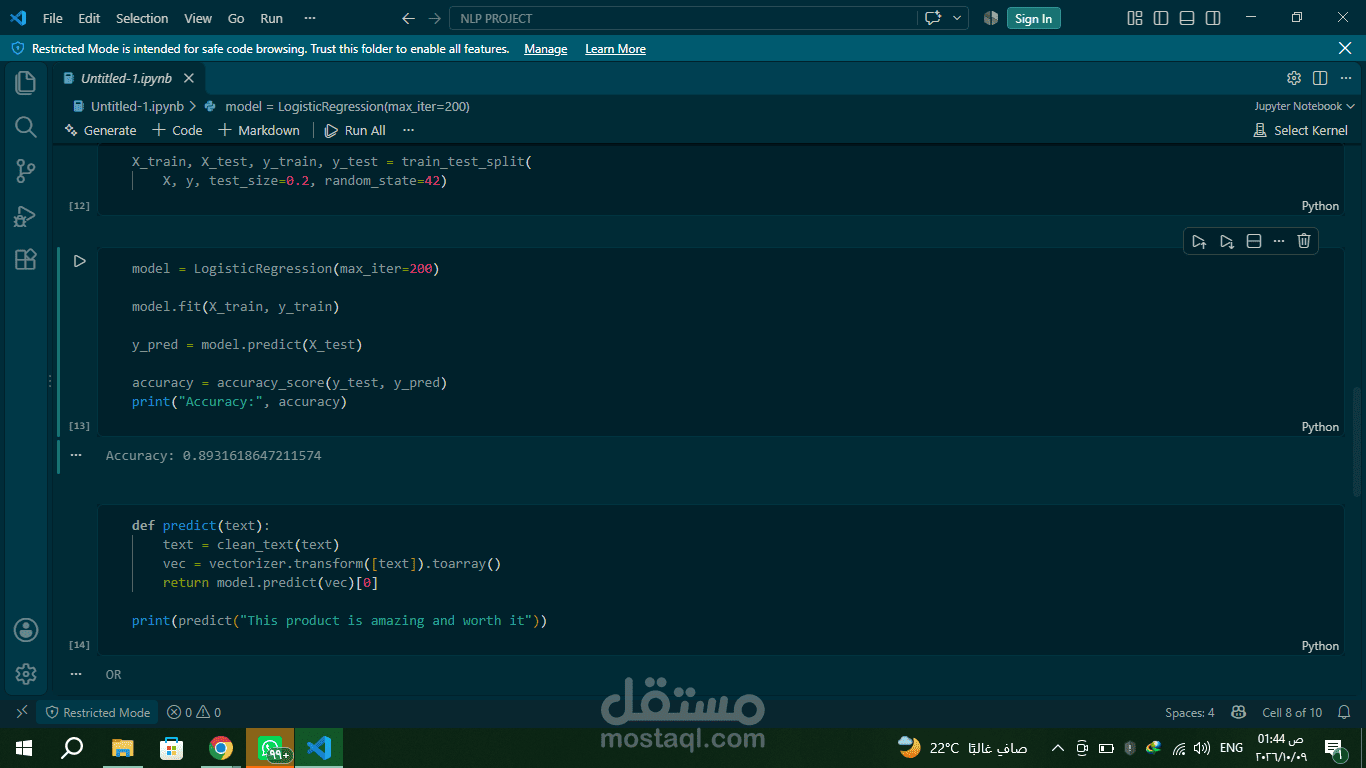
تدريب نموذج Logistic Regression لتصنيف المراجعات.
تقسيم البيانات إلى Training Set وTesting Set.
تقييم أداء النموذج باستخدام Accuracy Score.
الأدوات والتقنيات المستخدمة:
Python, Scikit-learn, NLTK, TF-IDF, Logistic Regression.
النتائج:
حقق النموذج Accuracy بلغت حوالي 89.32% على بيانات الاختبار المستخدمة. تم التدريب والتقييم باستخدام Dataset من المراجعات المُصطنعة (Synthetic Reviews).