Football Player Valuation Pipeline: From Raw Data to Predictive Models
تفاصيل العمل
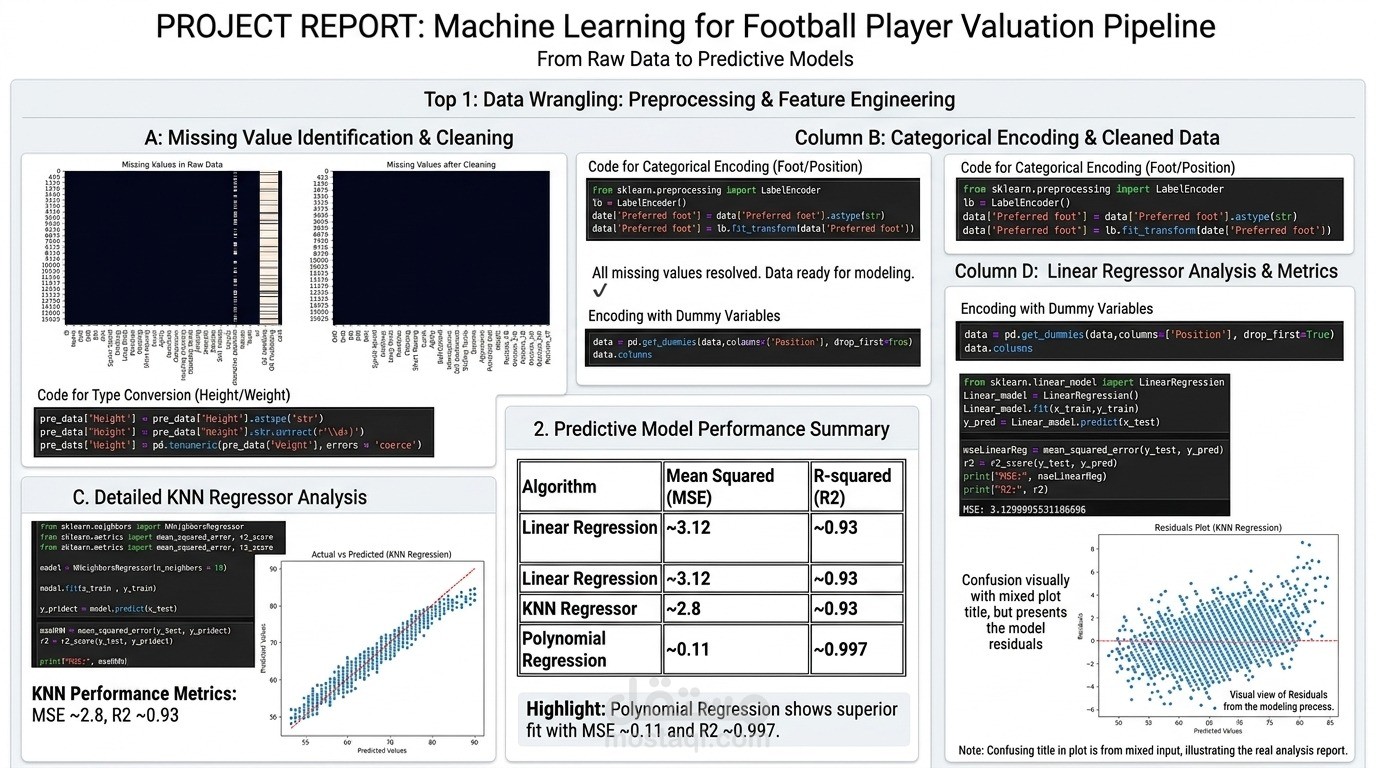
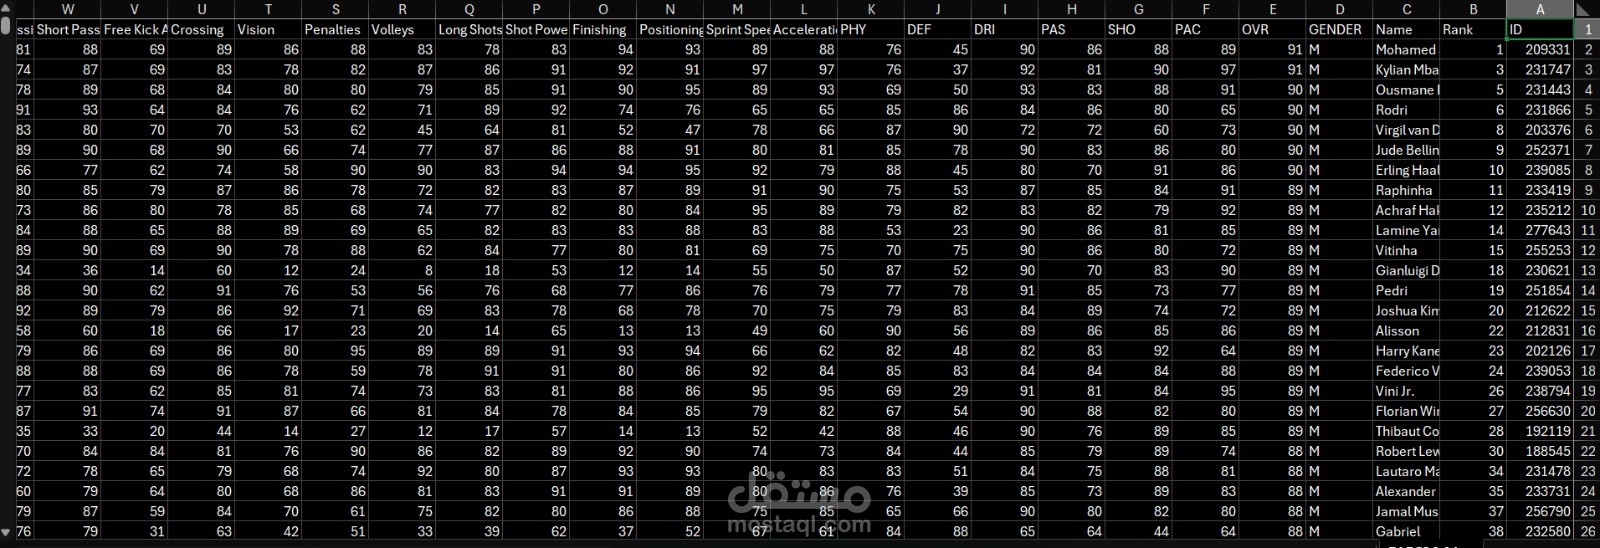
مشروع متكامل في مجال تعلم الآلة (Machine Learning) وتحليل البيانات (Data Analysis) يهدف إلى بناء خط معالجة واستكشاف للبيانات (End-to-End Pipeline) للتنبؤ بتقييمات وأسعار لاعبي كرة القدم بناءً على خصائصهم الفيزيائية والفنية والتكتيكية.
يتضمن المشروع كافة مراحل بناء النماذج الذكية من تنظيف البيانات واستخراج الخصائص، وحتى مقارنة أداء الخوارزميات المختلفة لاختيار النموذج الأفضل.
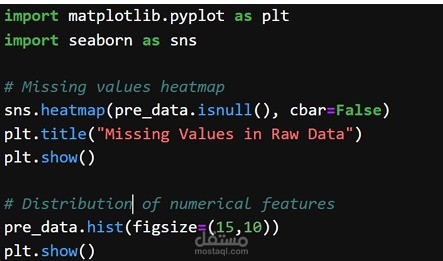
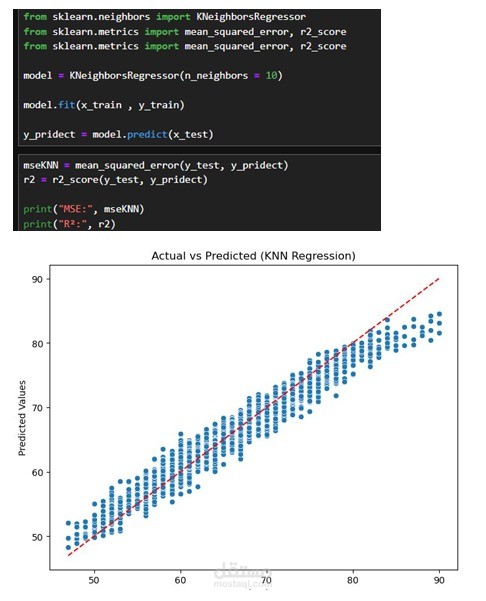
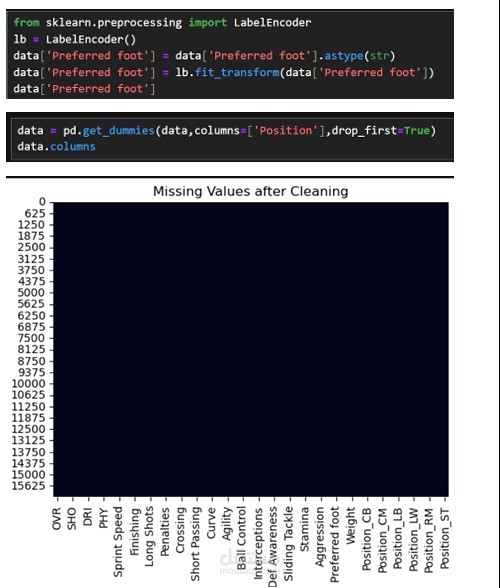
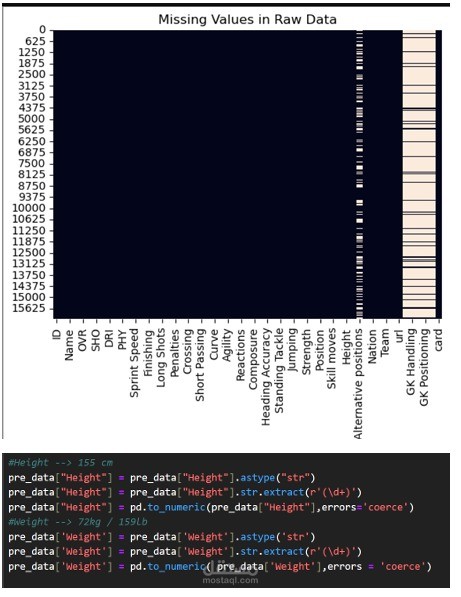
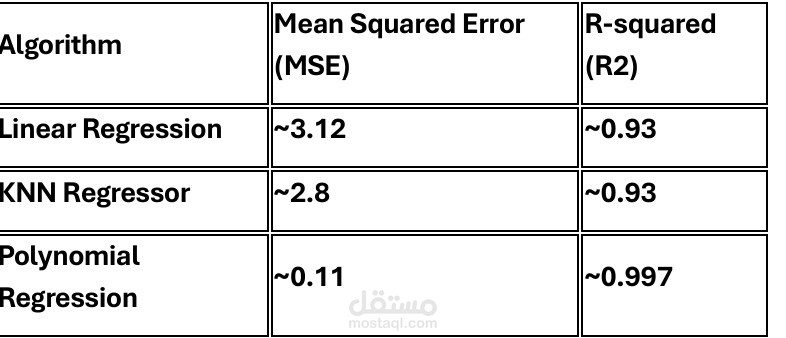
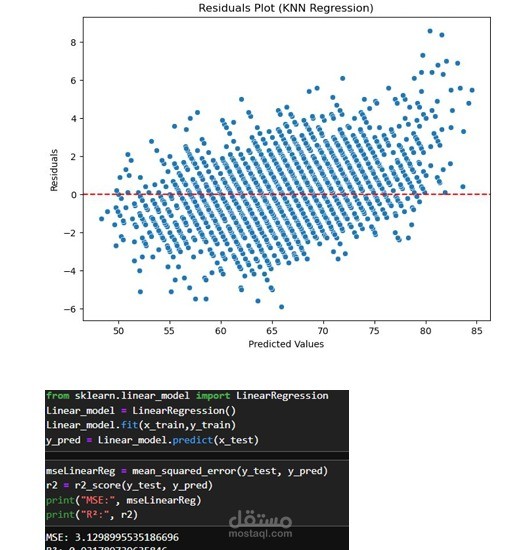
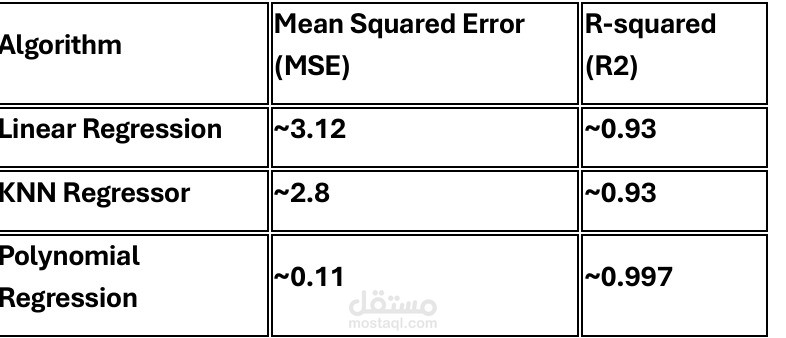
أبرز خطوات ومراحل العمل:معالجة وتنظيف البيانات (Data Cleaning & Feature Engineering): التعرف على البيانات المفقودة (Missing Values) ومعالجتها بالكامل لضمان جودة البيانات. استخراج القيم الرقمية وتصحيح أنواع البيانات مثل الطول والوزن باستعمال التعبيرات النمطية (Regex). ترميز المتغيرات الفئوية (Categorical Encoding) باستخدام LabelEncoder للقدم المفضلة وDummy Variables لمراكز اللاعبين. التحليل والاستكشاف البصري للبيانات (EDA): إنشاء الخرائط الحرارية (Heatmaps) باستخدام مكتبة Seaborn لمتابعة وجود البيانات المفقودة قبل وبعد التنظيف. استخدام المخططات البيانية (Histograms) ورسوم البواقي (Residuals Plots) لتحليل توزيع الخصائص ونسب الخطأ. بناء وتقييم النماذج التنبؤية (Predictive Modeling): Linear Regression (الانحدار الخطي): حقق متوسط مربع الخطأ (MSE) بقيمة ~3.12 ومُعامل التحديد (R²) بقيمة ~0.93. KNN Regressor (انحدار الجار أقرب): حقق (MSE) بقيمة ~2.8 ومُعامل التحديد (R²) بقيمة ~0.93. Polynomial Regression (الانحدار متعدد الحدود): حقق النتيجة الأفضل والأعلى دقة بـ (MSE) قدره ~0.11 ومُعامل تحديد (R²) قدره ~0.997. النتيجة النهائية:أظهر نموذج Polynomial Regression الأداء الأعلى والتفوق في المطابقة والتنبؤ بدقة وصلت إلى 99.7% (R² = 0.997)، مما يجعله الخيار الأمثل للتنبؤ بأسعار وتقييمات اللاعبين بناءً على إحصائياتهم الميدانية.
التقنيات والمكتبات المستخدمة:لغة البرمجة: Python. معالجة وتحليل البيانات: Pandas, NumPy, Scikit-learn (LabelEncoder, get_dummies). التمثيل البصري: Matplotlib, Seaborn. النماذج المستخدمة: Linear Regression, KNN Regressor, Polynomial Regression.