Scrapping tool python
تفاصيل العمل
يمثل هذا الكود تطبيق ويب لاستخراج البيانات (Web Scraping) بُني باستخدام لغة Python.
ينقسم عمل الكود إلى شقين رئيسيين يعكسان واجهتي المستخدم المتوفرتين:
أولاً: واجهة سطح المكتب (Desktop Edition)
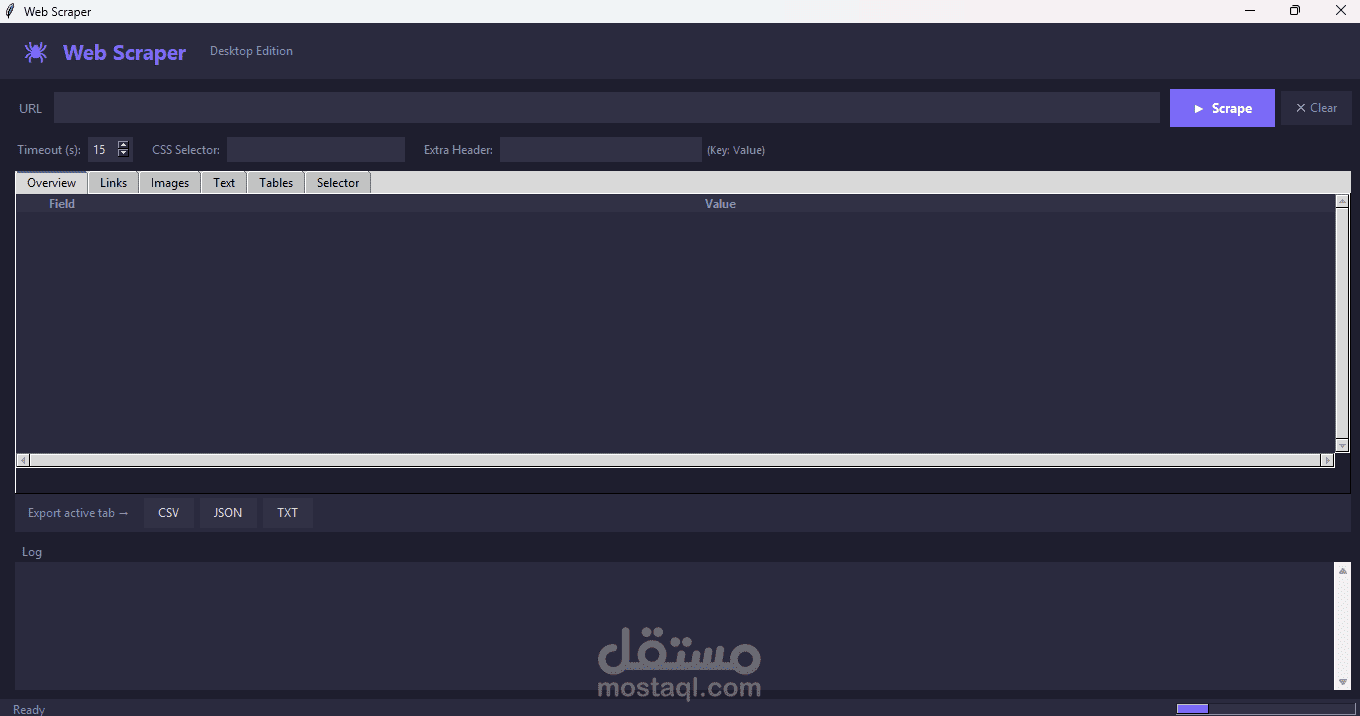
تم بناء واجهة مستخدم رسومية (GUI) قابلة للعمل كتطبيق سطح مكتب مستقل (Standalone) لأجهزة الويندوز، وتم تحزيمها باستخدام أداة PyInstaller.
تتميز الواجهة بتصميم داكن (Dark Theme) لتوفير تجربة مستخدم مريحة للعين، وتم بناؤها باستخدام مكتبة CustomTkinter لتوفير عناصر تحكم حديثة.
تتيح الواجهة إدخال رابط الموقع (URL)، وتحديد وقت الانتظار (Timeout)، وإدخال محددات CSS (CSS Selectors) لتوجيه عملية الاستخراج بدقة، مع إمكانية إضافة ترويسات مخصصة للطلب (Extra Headers).
يحتوي التطبيق على لوحة تحكم متعددة التبويبات (Overview, Links, Images, Text, Tables, Selector) لعرض البيانات المستخرجة بشكل منظم.
يوفر التطبيق خيارات لتصدير البيانات المستخرجة إلى ملفات بصيغ متعددة (CSV, JSON, TXT).
ثانياً: واجهة الويب (Web Interface)
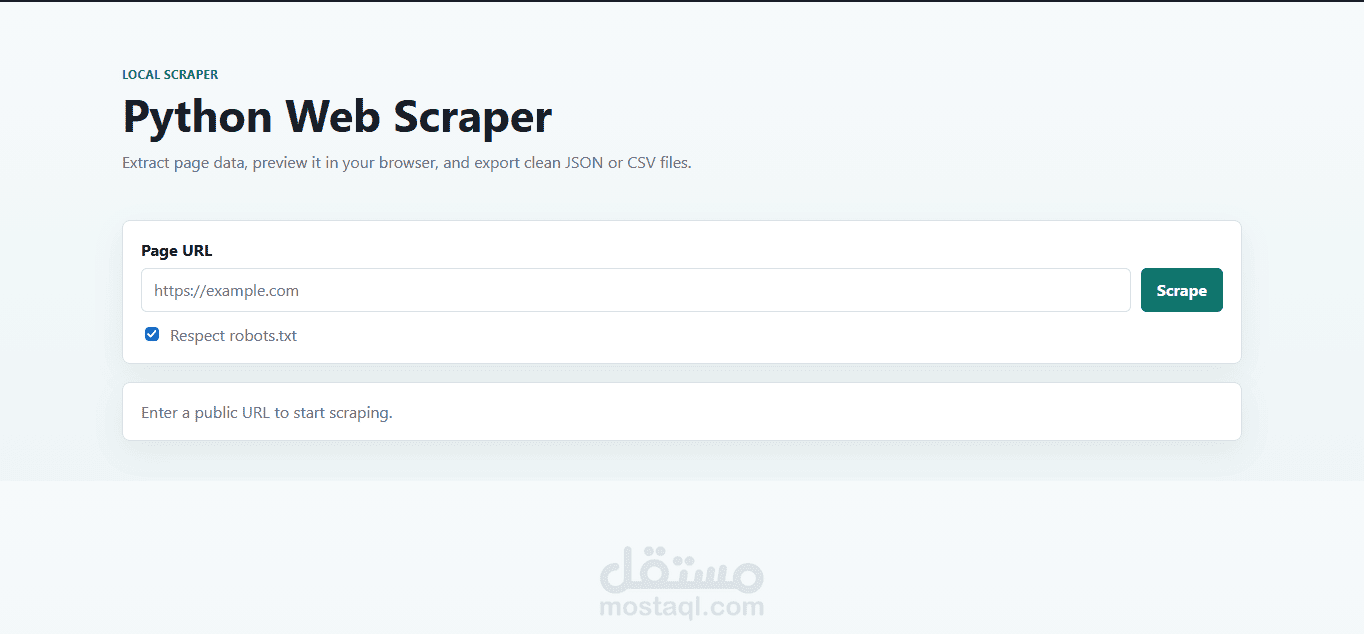
تم تطوير واجهة ويب نظيفة وبسيطة لاستخدام الأداة عبر المتصفح.
تتكون الواجهة من حقل لإدخال رابط الصفحة المراد استخراج البيانات منها (Page URL)، وزر "Scrape" لبدء العملية.
تحتوي الواجهة على خيار لتفعيل أو تعطيل الالتزام بملف robots.txt الخاص بالموقع المستهدف.
يُظهر قسم خاص أسفل حقل الإدخال رسائل توجيهية للمستخدم، مثل "Enter a public URL to start scraping".
ثالثاً: المنطق البرمجي (الخلفية - Backend)
يعتمد التطبيق على مكتبة BeautifulSoup القوية في بايثون لتحليل هيكل HTML للصفحات المستهدفة واستخراج البيانات المطلوبة بناءً على المدخلات.
يتم دمج هذه الأداة مع الواجهات الرسومية (سواء سطح المكتب أو الويب) لتوفير تجربة مستخدم متكاملة.