Breast Cancer Diagnosis - Classifier Comparison
تفاصيل العمل
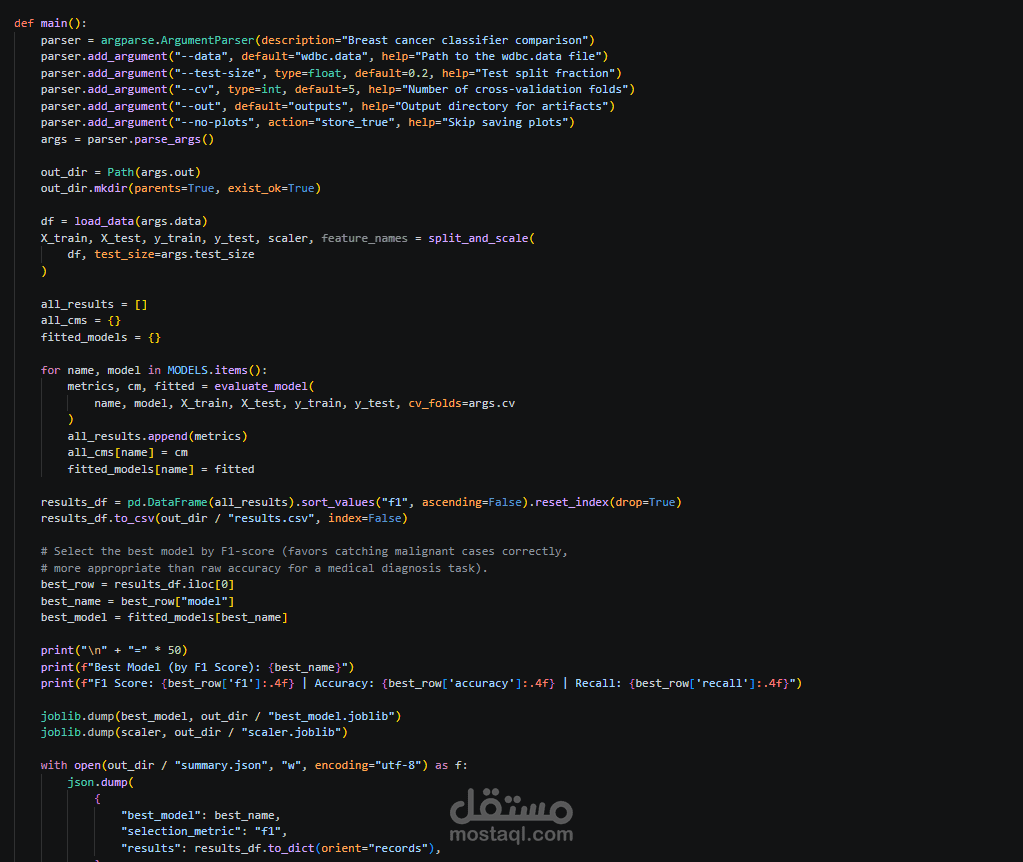
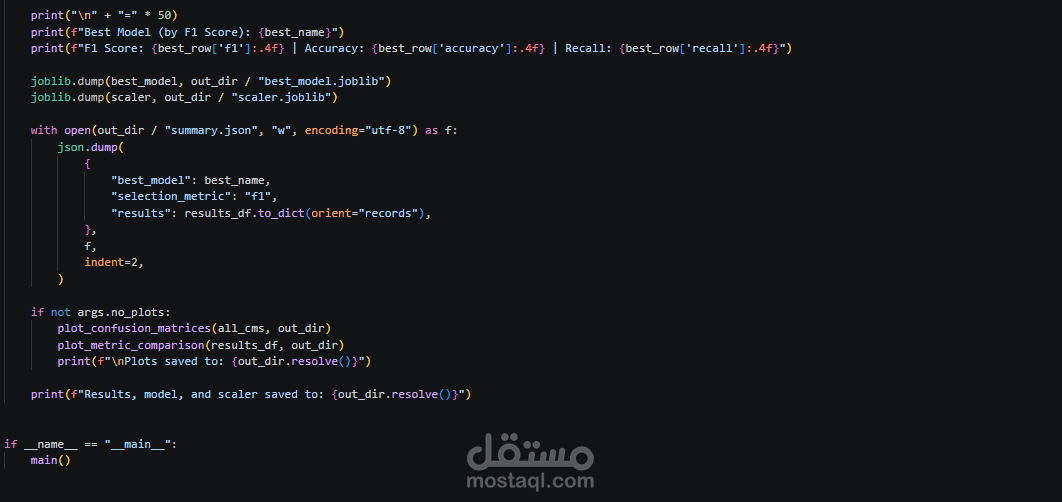
مشروع تعلم آلة باستخدام Python لتطوير ومقارنة عدة نماذج لتصنيف حالات سرطان الثدي بالاعتماد على Wisconsin Diagnostic Breast Cancer (WDBC) Dataset.
تم بناء نظام تصنيف قادر على التمييز بين الحالات الحميدة (Benign) والخبيثة (Malignant)، مع مقارنة أداء عدة خوارزميات واختيار أفضل نموذج بناءً على F1-Score، باعتباره معيارًا أكثر ملاءمة لمهام التصنيف الطبي من الاعتماد على Accuracy فقط.
ما تم تنفيذه:
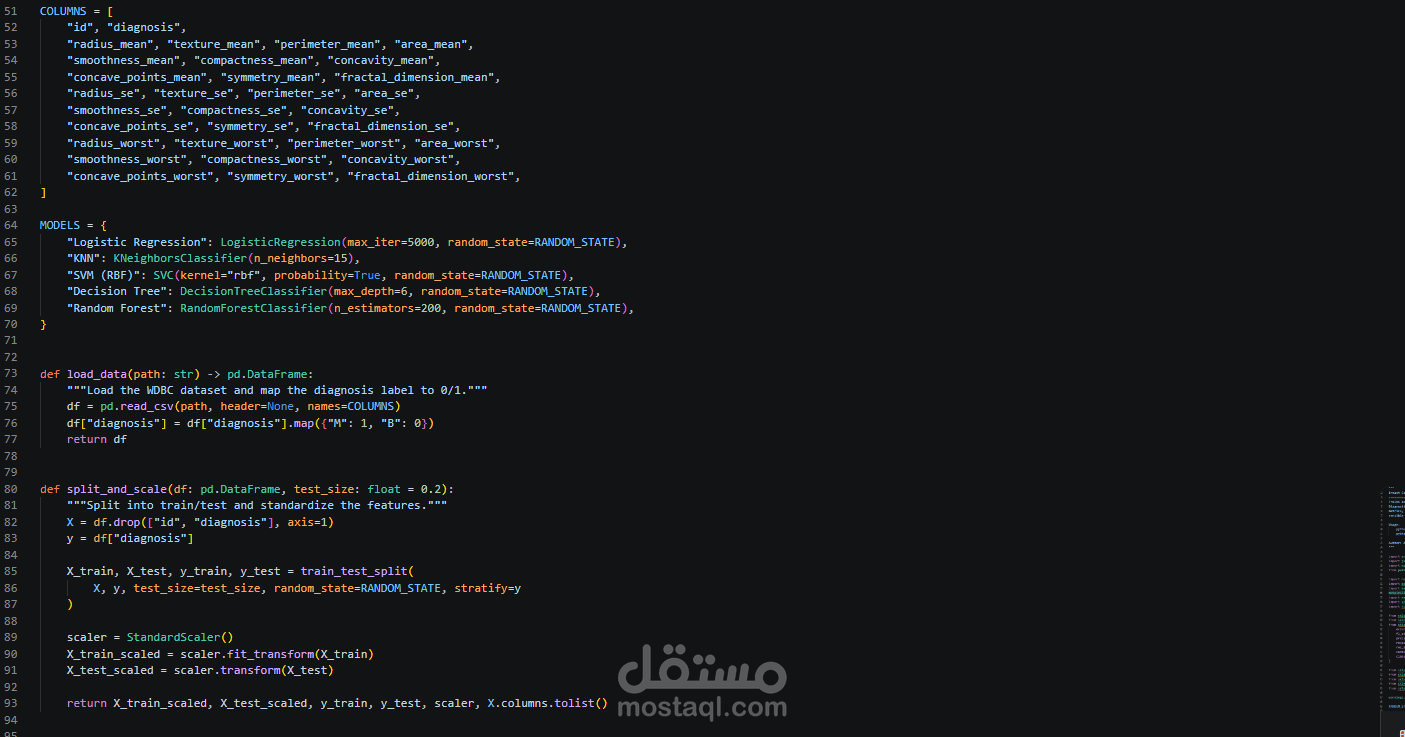
• تحميل وتجهيز بيانات WDBC وتحويل التصنيفات إلى قيم رقمية.
• فصل البيانات إلى Training وTesting Sets مع استخدام Stratified Split للحفاظ على توزيع الفئات.
• تطبيق Standardization باستخدام StandardScaler.
• تدريب ومقارنة 5 نماذج مختلفة:
- Logistic Regression
- K-Nearest Neighbors (KNN)
- Support Vector Machine (SVM)
- Decision Tree
- Random Forest
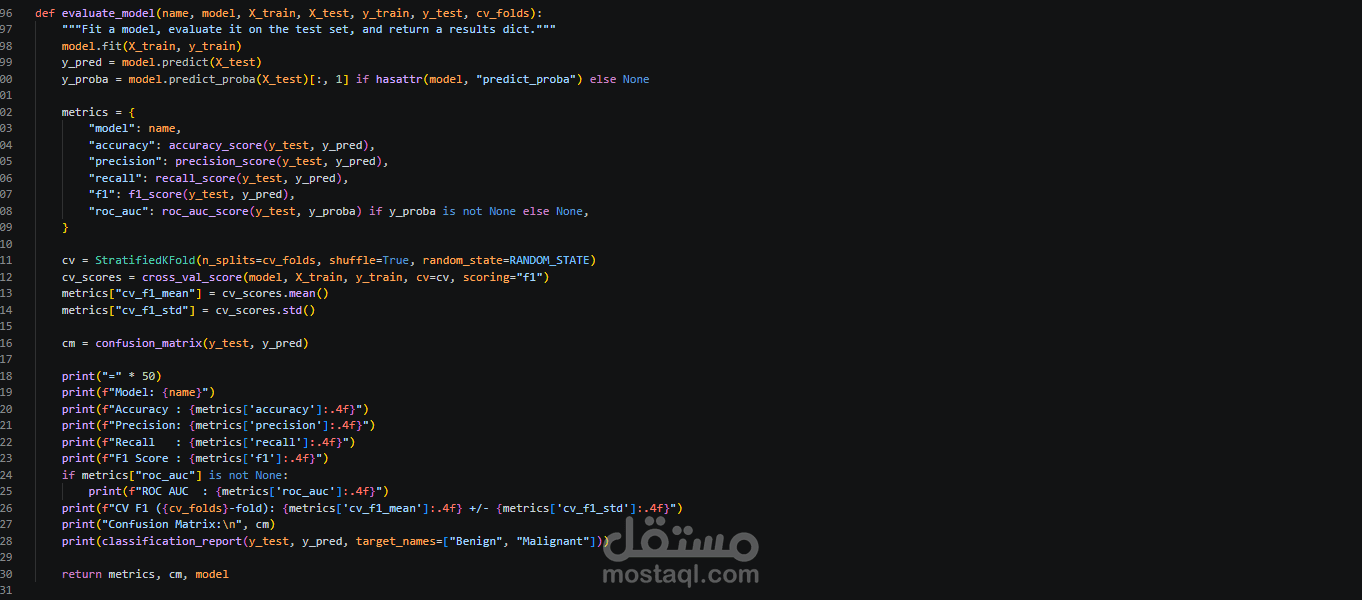
• تقييم النماذج باستخدام Accuracy وPrecision وRecall وF1-Score وROC-AUC.
• تطبيق Stratified K-Fold Cross-Validation لتقييم استقرار أداء النماذج.
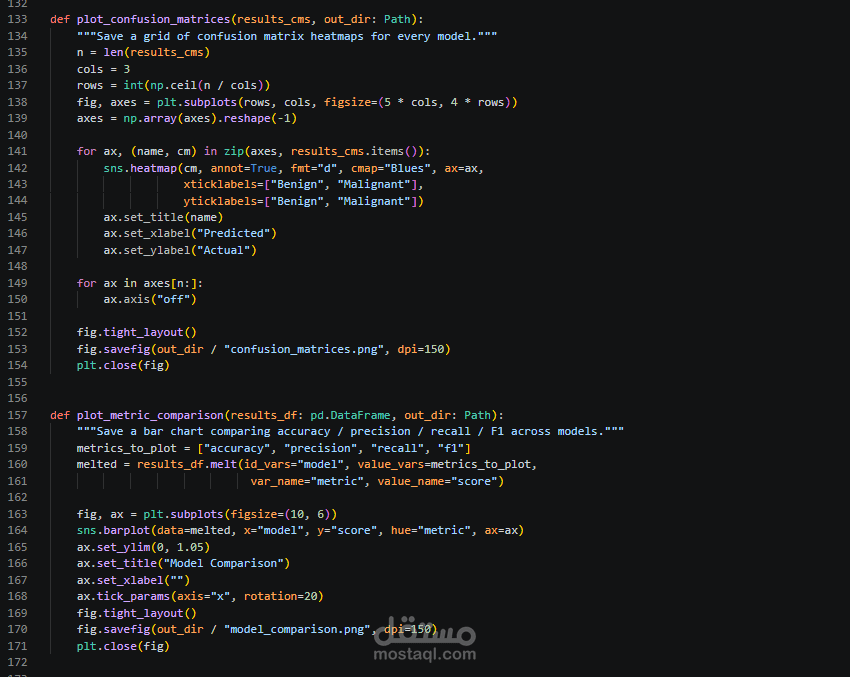
• إنشاء Confusion Matrix لكل نموذج لتحليل الحالات المصنفة بشكل صحيح وخاطئ.
• مقارنة أداء النماذج من خلال الرسوم البيانية.
• اختيار أفضل نموذج تلقائيًا بناءً على أعلى F1-Score.
• حفظ أفضل نموذج والـScaler لاستخدامهما لاحقًا في التنبؤ على بيانات جديدة.
• حفظ نتائج المقارنة والملخص النهائي بصيغ CSV وJSON.
الأدوات والتقنيات:
Python • Pandas • NumPy • Scikit-learn • Matplotlib • Seaborn • Joblib
الهدف من المشروع هو تطبيق دورة عمل متكاملة في Machine Learning تبدأ من تجهيز البيانات، مرورًا ببناء ومقارنة نماذج التصنيف وتقييمها باستخدام أكثر من Metric، وصولًا إلى اختيار وحفظ النموذج الأفضل بطريقة قابلة لإعادة الاستخدام.