التنبؤ بتكاليف التأمين الطبي
تفاصيل العمل
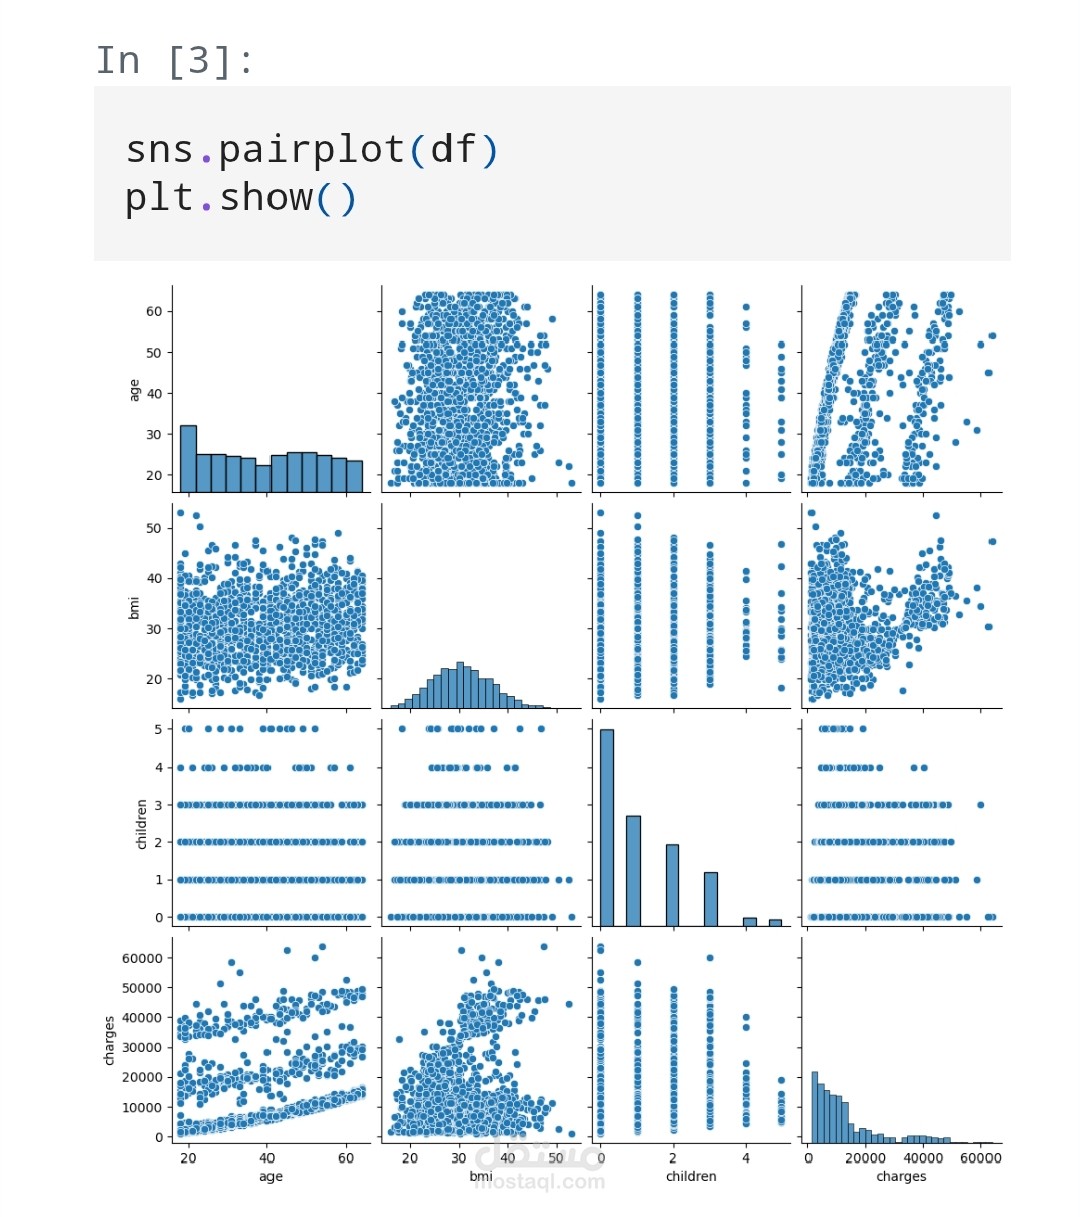
أنجزت مؤخراً مشروع انحدار (Regression) باستخدام Python وscikit-learn للتنبؤ بتكاليف التأمين الطبي للأفراد بناءً على بياناتهم الشخصية.
البيانات: 1,338 سجلاً تتضمن العمر والجنس ومؤشر كتلة الجسم (BMI) وعدد الأطفال وحالة التدخين والمنطقة.
ما قمت به:
🔹 استكشاف البيانات باستخدام pandas وseaborn وmatplotlib. تبيّن أن توزيع التكاليف منحرف جداً نحو اليمين، مع مجموعة واضحة من التكاليف المرتفعة.
🔹 تحويل المتغيرات الفئوية إلى أرقام باستخدام LabelEncoder.
🔹 تحليل خريطة الارتباط (Heatmap) لمعرفة أهم العوامل. التدخين كان الأقوى ارتباطاً بالتكاليف (r ≈ 0.79)، ثم العمر (0.30) ثم BMI (0.20).
🔹 تقسيم البيانات 70% تدريب و30% اختبار.
🔹 بناء نموذج أساسي بـ Linear Regression: R² = 0.73، وMAE ≈ 4,045، وRMSE ≈ 5,946.
🔹 تحسين النتيجة بـ Random Forest Regressor: R² = 0.82.
أهم اكتشاف: أظهرت أهمية المتغيرات أن التدخين يفسّر نحو 63% من قدرة النموذج على التنبؤ، يليه BMI (21%) ثم العمر (12%)، بينما كان تأثير الجنس والمنطقة ضعيفاً جداً.
ماذا تعلمت:
✔️ بناء نموذج بسيط أولاً يوضح بدقة كم يضيف النموذج الأعقد فعلاً.
✔️ أظهرت رسوم الأخطاء أن النموذج الخطي يضعف مع الحالات ذات التكلفة العالية لأن العلاقة فيها غير خطية، وهنا تحسّن الأداء مع Random Forest.