تحليل بيانات
تفاصيل العمل
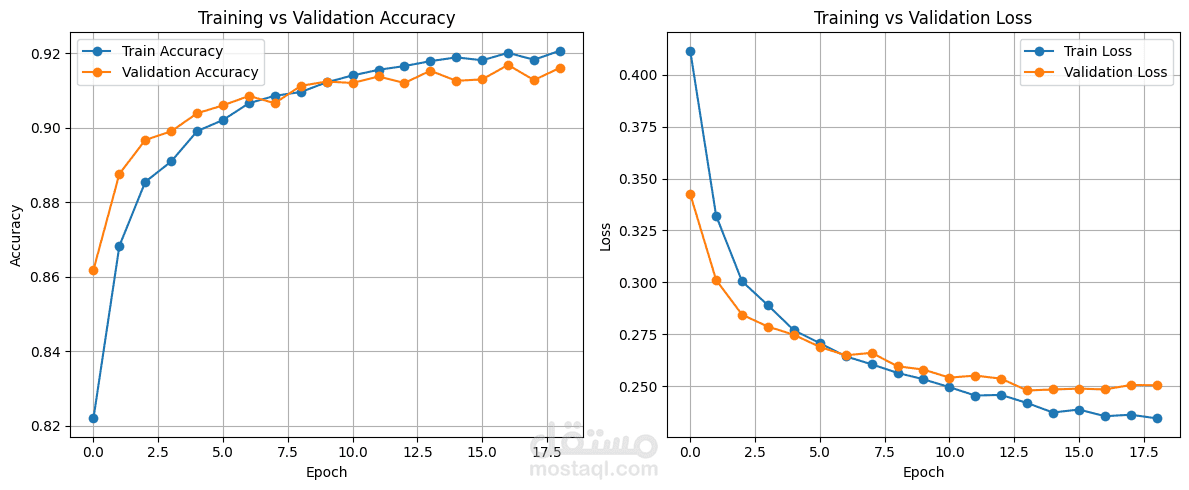
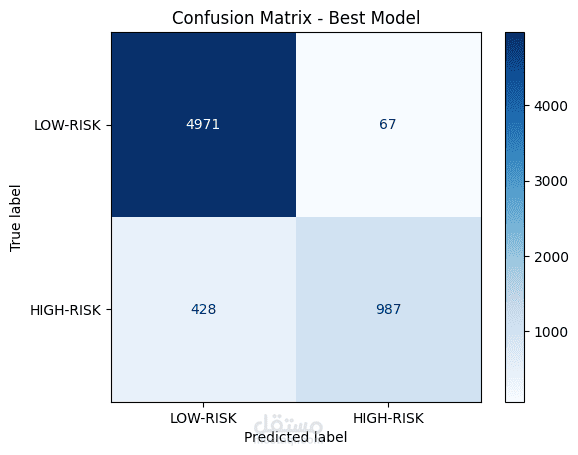
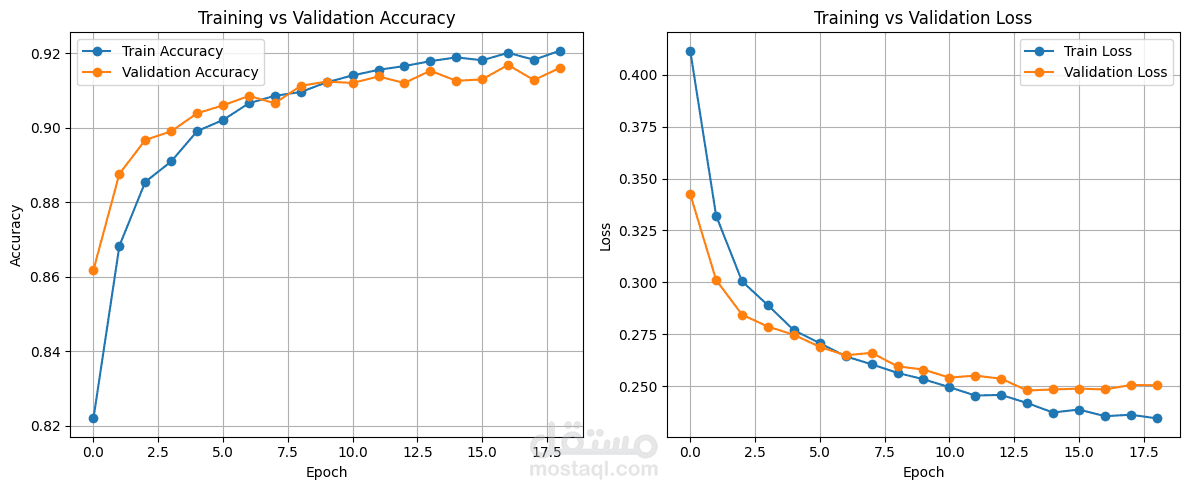
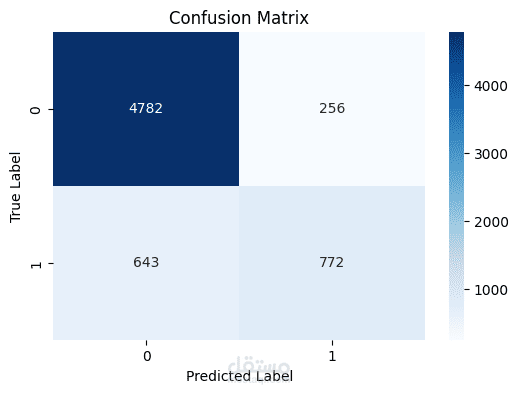
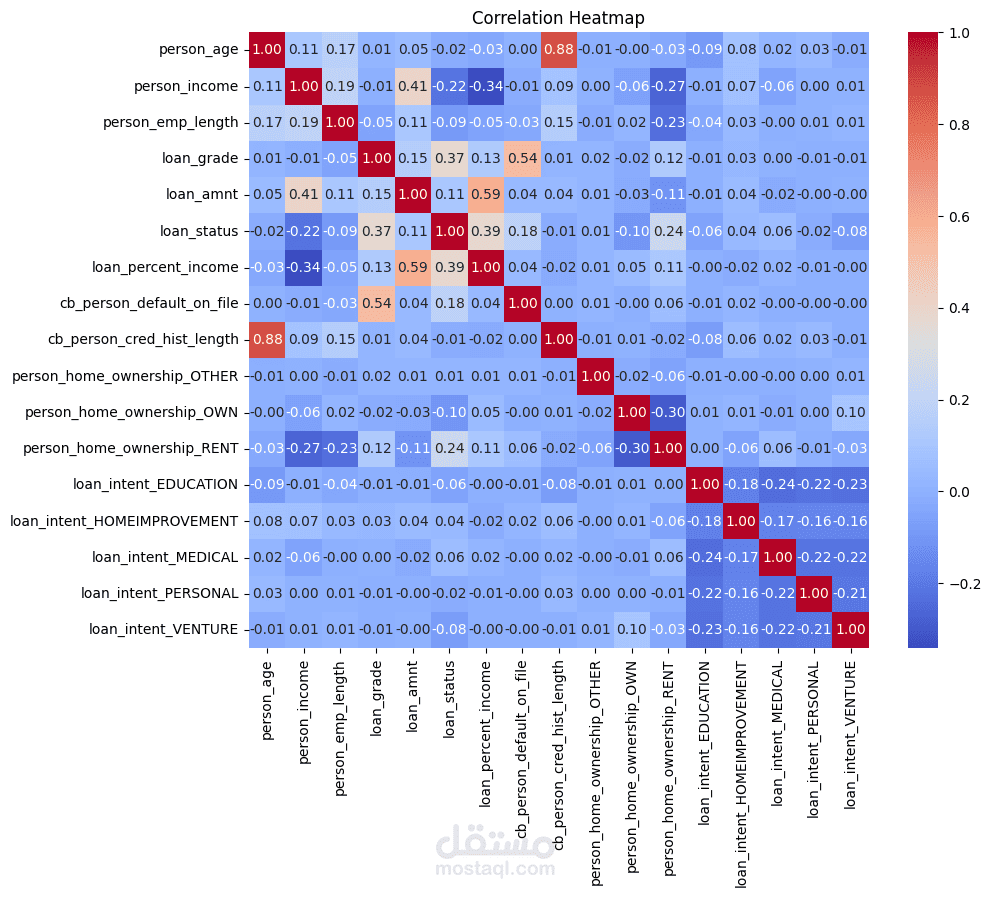
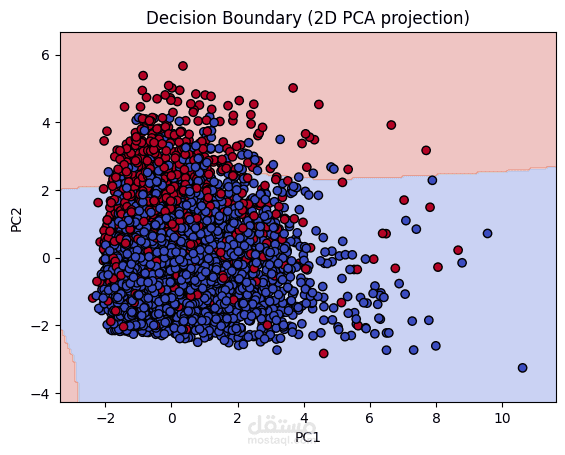
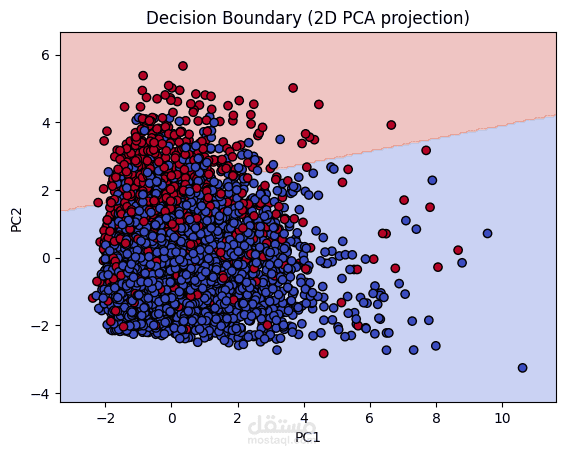
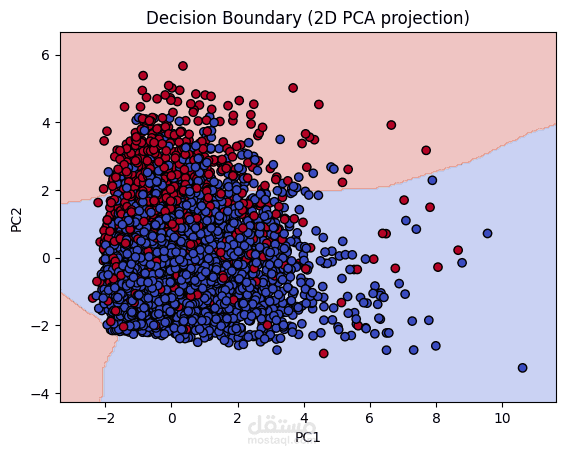
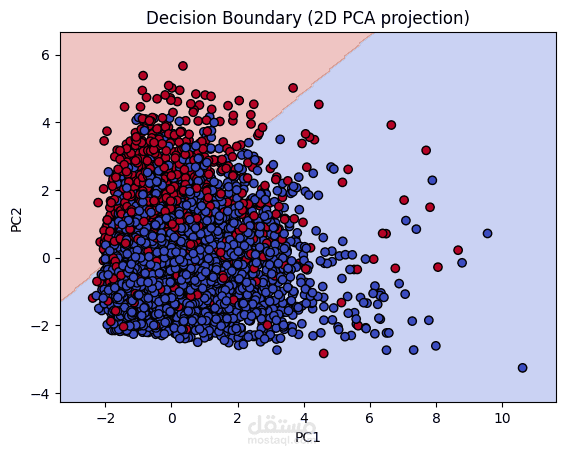
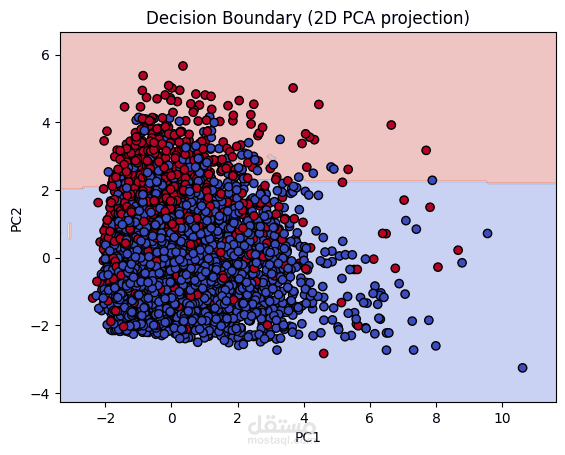
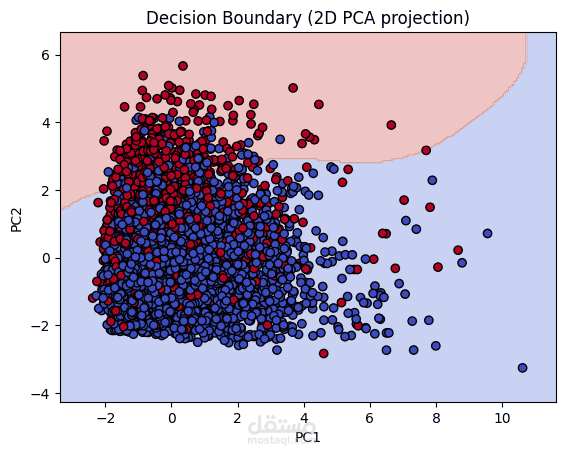
مشروع تعلّم آلي يهدف إلى التنبؤ بما إذا كان مقدم طلب القرض عالي المخاطر (أي من المحتمل أن يتخلف عن السداد) أم منخفض المخاطر، وذلك بالاعتماد على 32,581 سجلاً حقيقياً للقروض من مجموعة بيانات "Kaggle" الخاصة بمخاطر الائتمان (Credit Risk Dataset).
تم بناء مسار العمل (pipeline) بالكامل، شاملاً: تنظيف البيانات، وإزالة القيم الشاذة (outliers)، وهندسة الميزات (feature engineering)، والترميز (encoding)، والتحجيم (scaling).
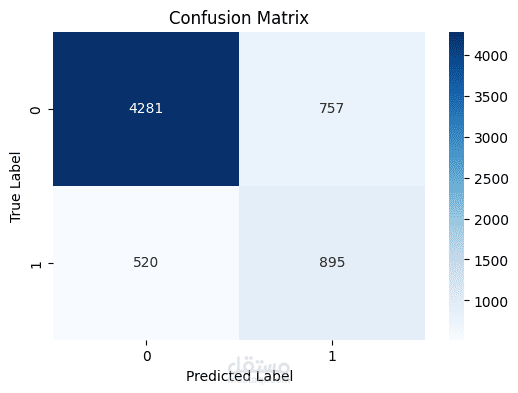
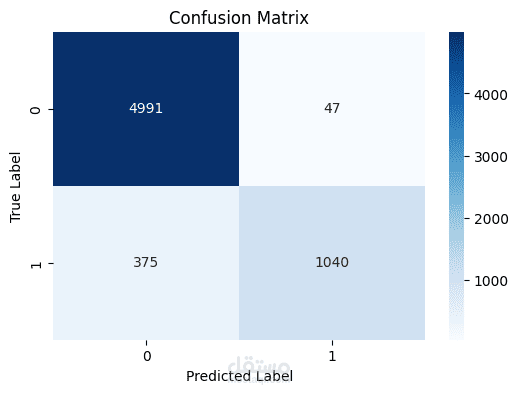
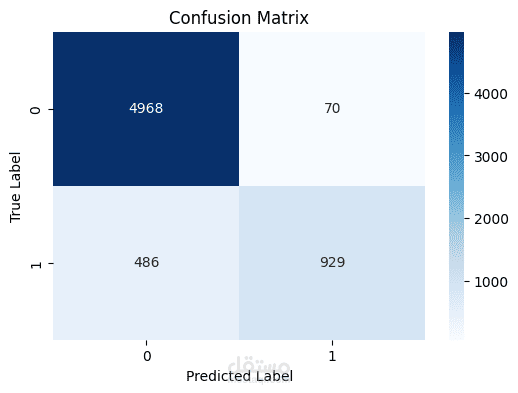
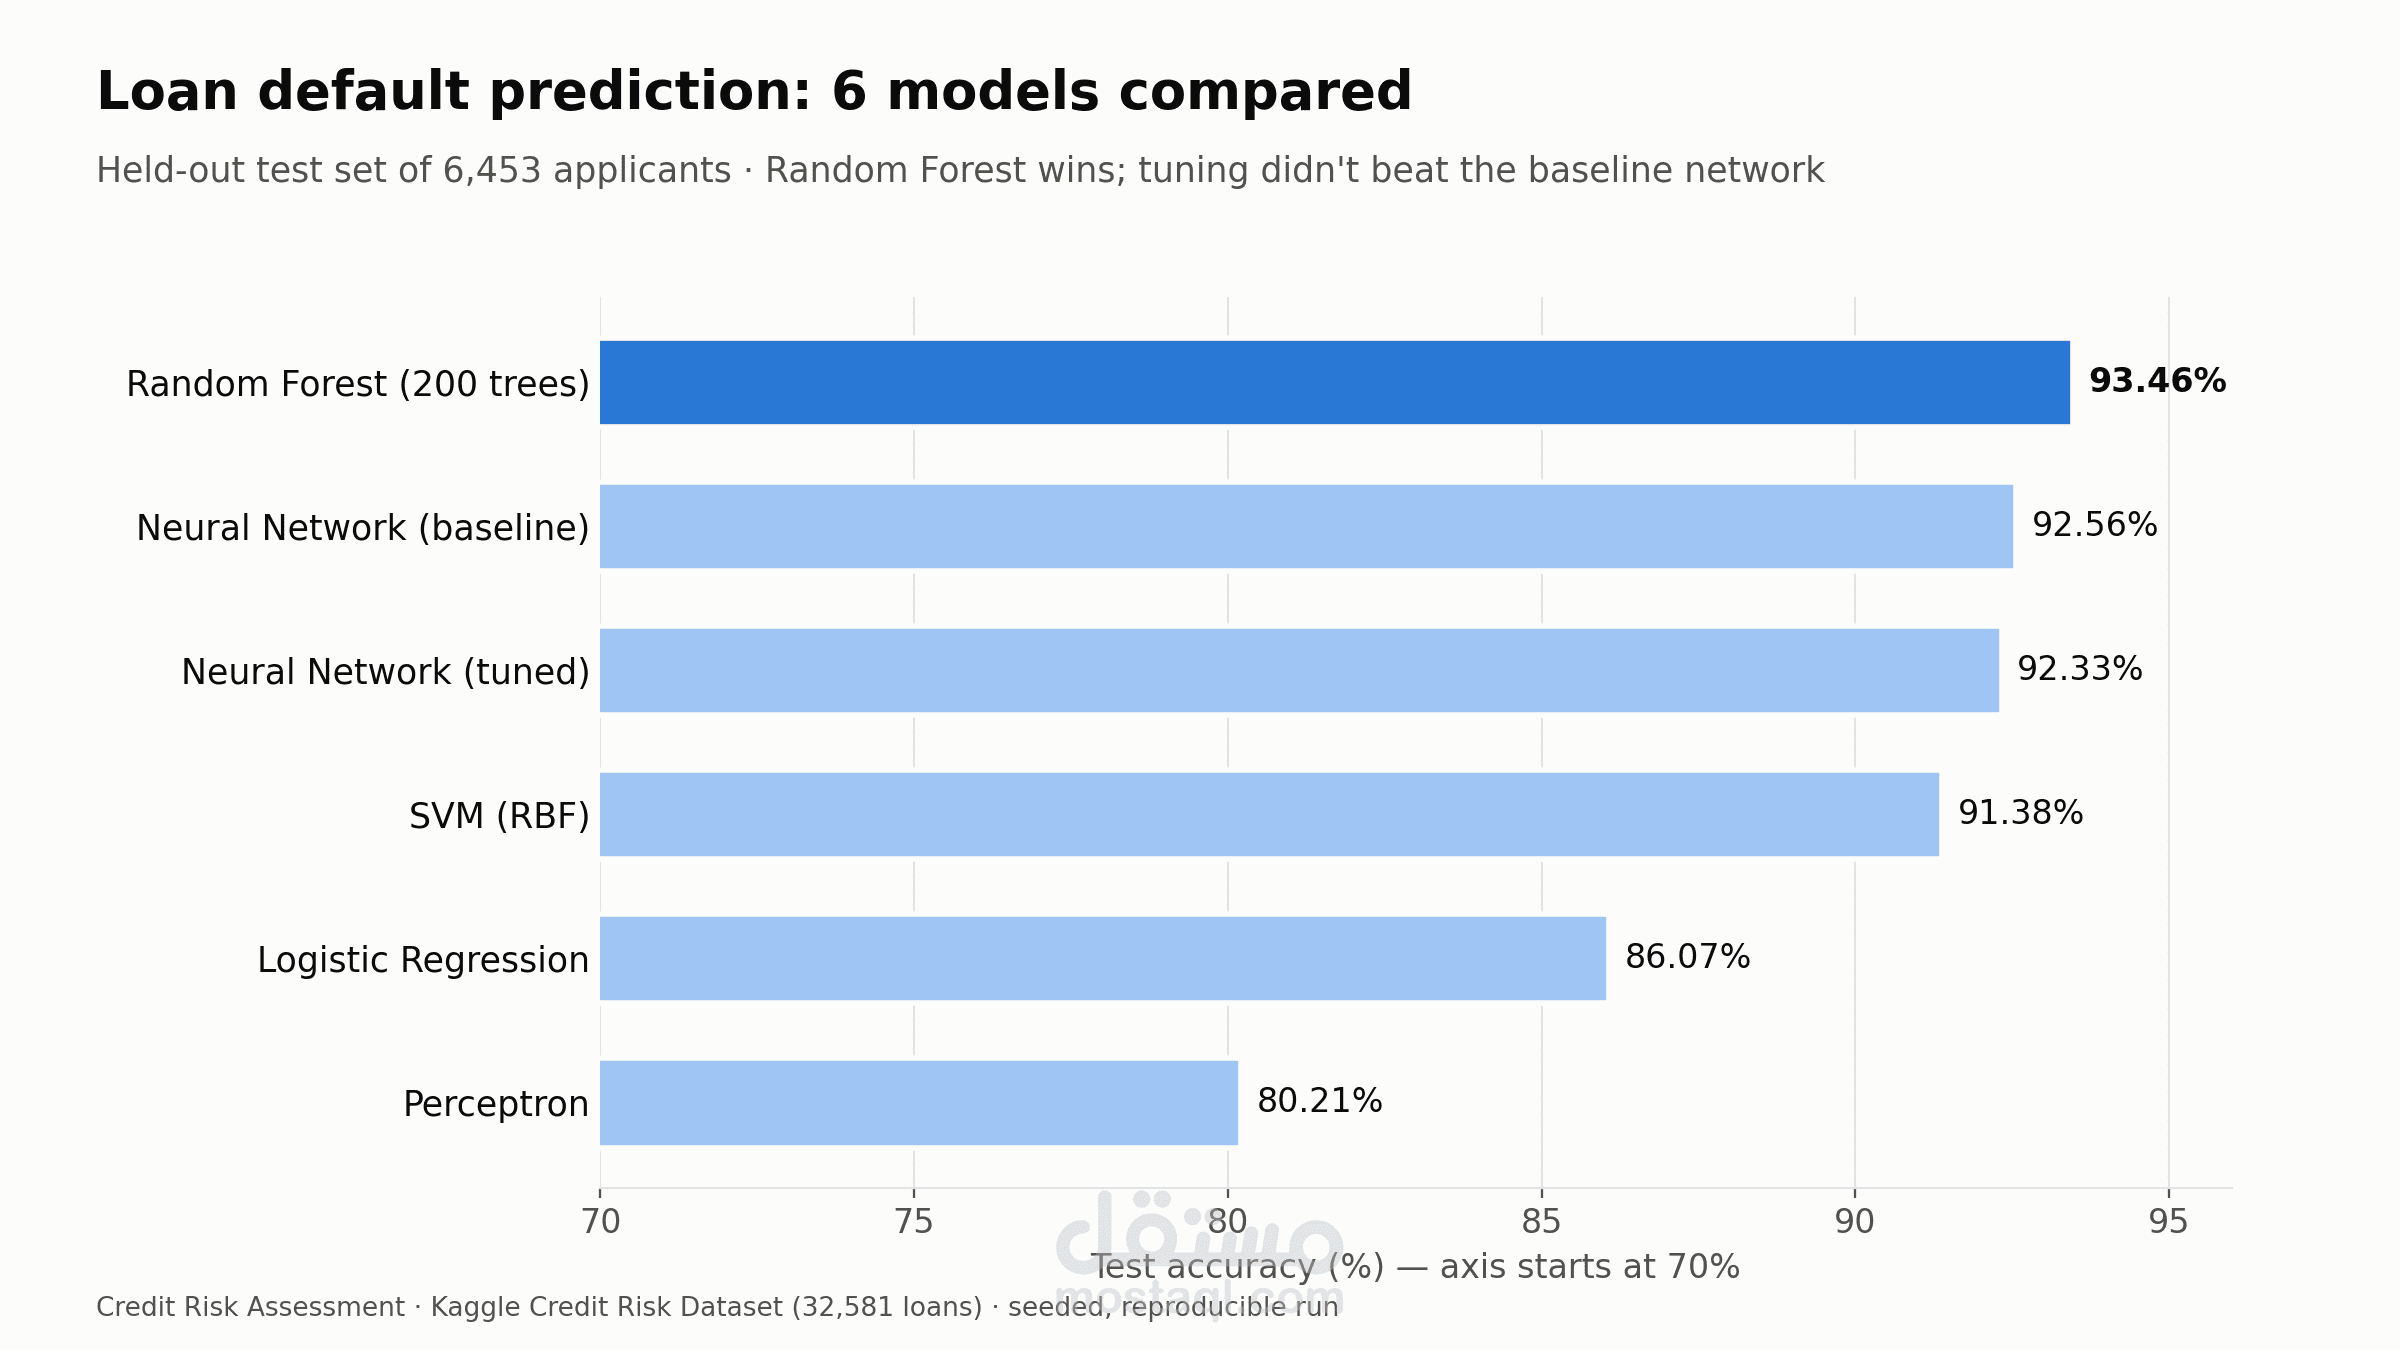
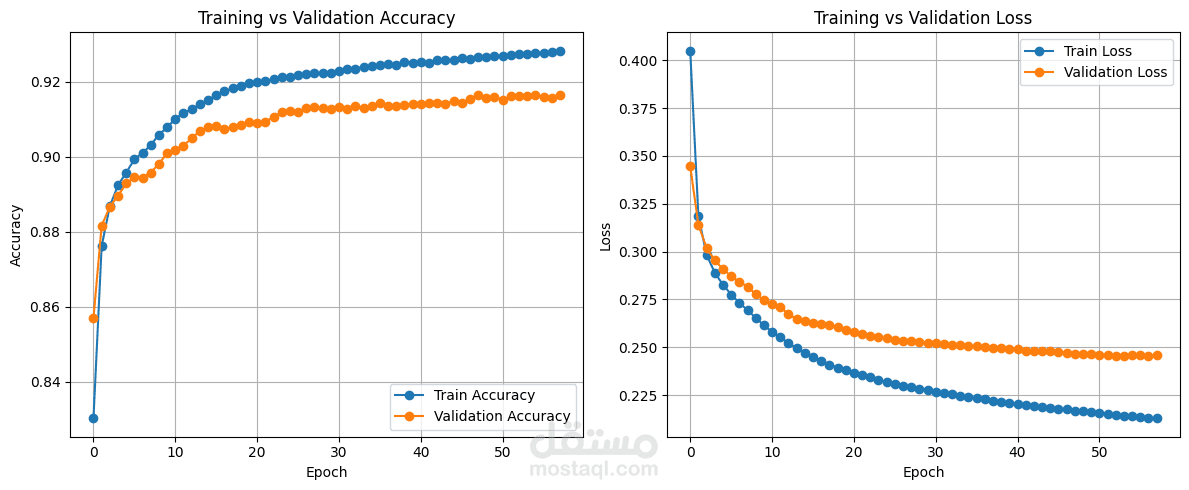
تم تدريب ومقارنة 6 نماذج: Perceptron، وLogistic Regression، وSVM، وRandom Forest، ونموذجين للشبكات العصبية (نموذج أساسي وآخر مُحسَّن).
تم تقييم كل نموذج باستخدام مجموعة اختبار منفصلة (held-out test set) تضم 6,453 متقدماً، مع التركيز على مقاييس الدقة (precision) والاستدعاء (recall) ودرجة F1 لفئة "التخلف عن السداد" (default class) بدلاً من الاعتماد على الدقة العامة (accuracy) وحدها، نظراً لأن نسبة المتخلفين عن السداد تبلغ 22% فقط من المتقدمين.
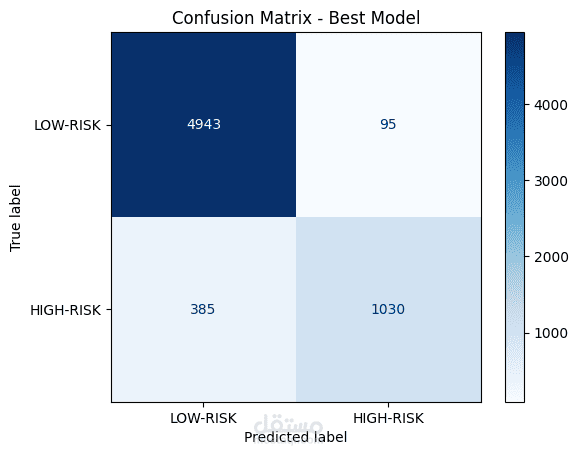
النموذج الأفضل: Random Forest، حيث حقق دقة عامة (accuracy) بنسبة 93.5%، ودقة (precision) بنسبة 95.7%، واستدعاء (recall) بنسبة 73.5%، ودرجة F1 بنسبة 83.1%.
تم ضمان إمكانية إعادة إنتاج النتائج بالكامل من خلال تثبيت جميع القيم العشوائية الأولية (random seeds) وتفعيل العمليات الحتمية (deterministic ops) في TensorFlow؛ حيث أدت ثلاث عمليات تشغيل منفصلة إلى نتائج متطابقة.
تم نشر النموذج كتطبيق ويب تفاعلي باستخدام Streamlit لإجراء تنبؤات فورية (في الوقت الفعلي) بشأن المخاطر.
المهارات: Python · Pandas · Scikit-learn · TensorFlow/Keras · Streamlit · تنظيف البيانات · هندسة الميزات · تقييم النماذج.