Text Cleaning & NLP Preprocessing (IMDB Reviews)
تفاصيل العمل
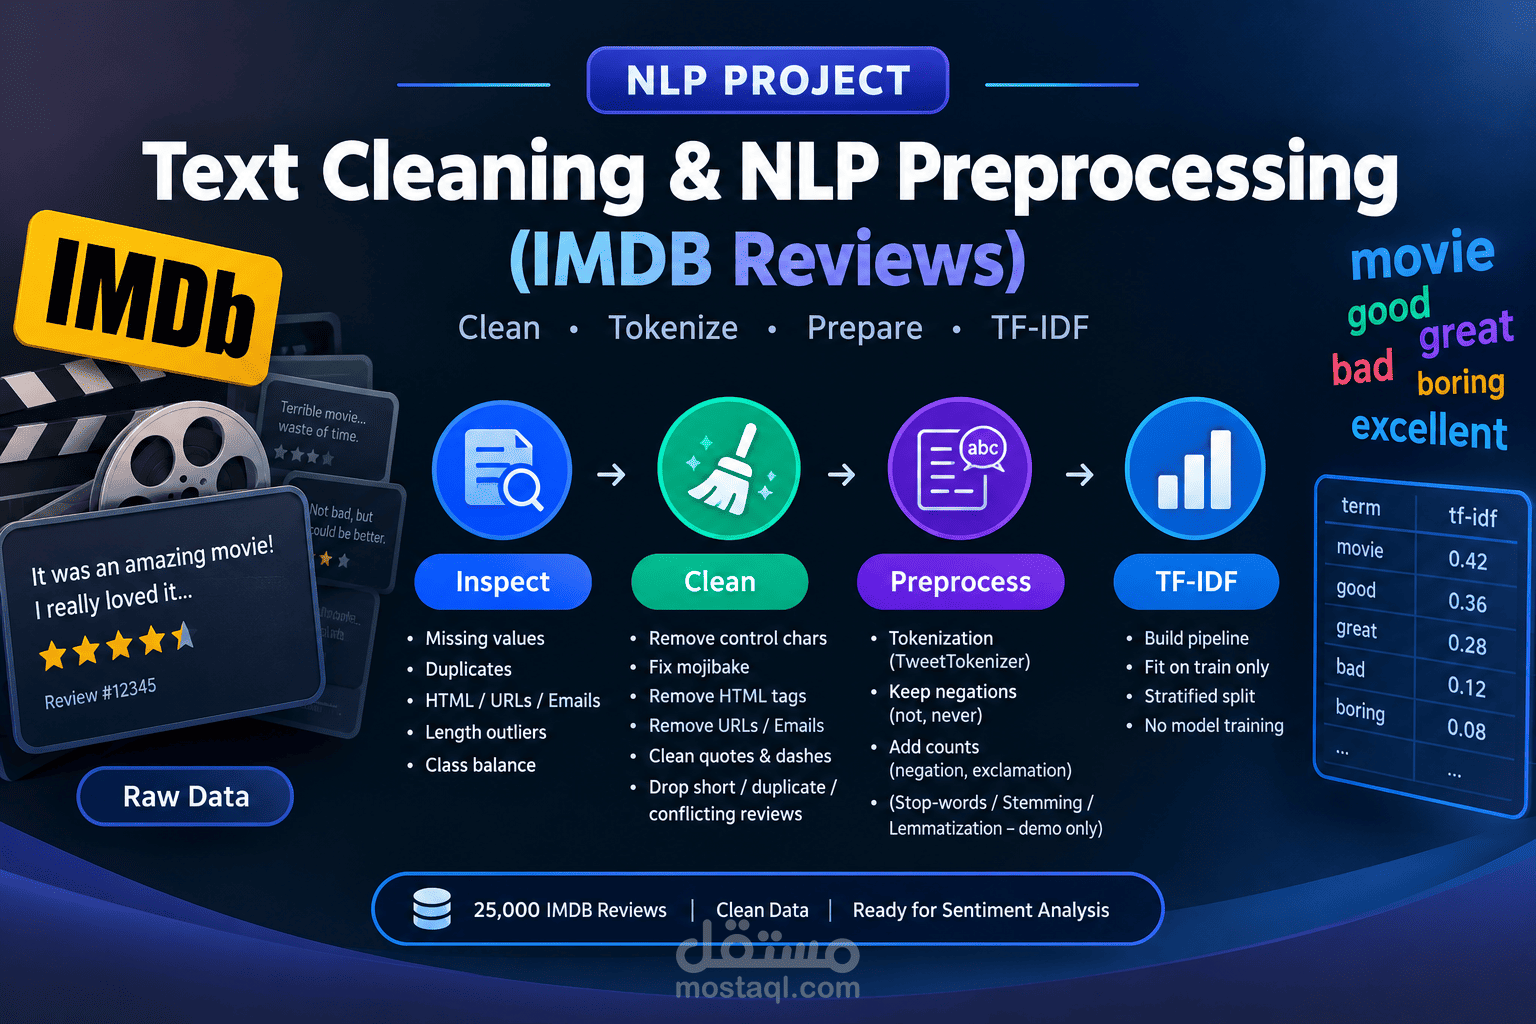
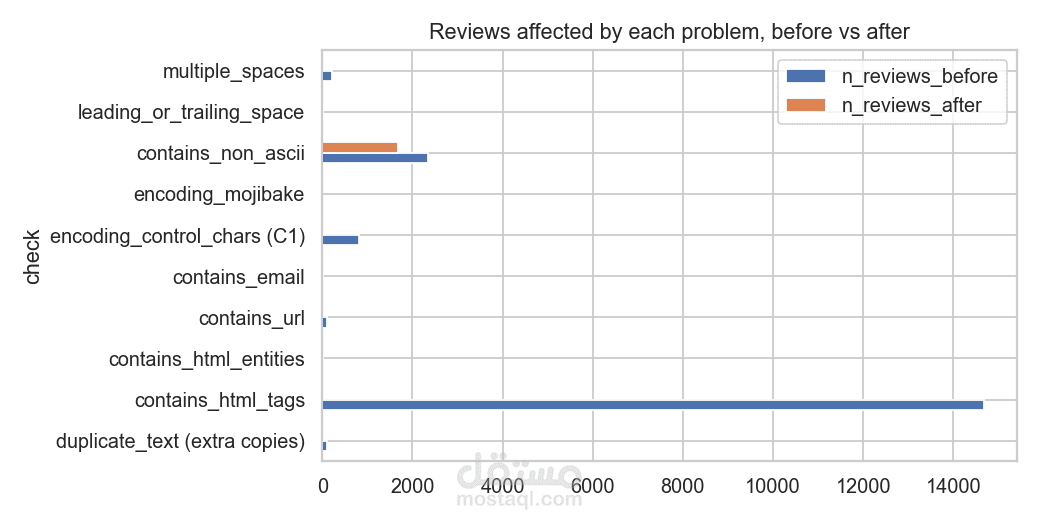
تطوير مشروع متكامل لمعالجة النصوص باستخدام تقنيات معالجة اللغات الطبيعية (NLP)، بهدف تجهيز 25,000 مراجعة حقيقية للأفلام من مجموعة بيانات IMDb لتكون جاهزة لتحليل المشاعر (Sentiment Analysis).
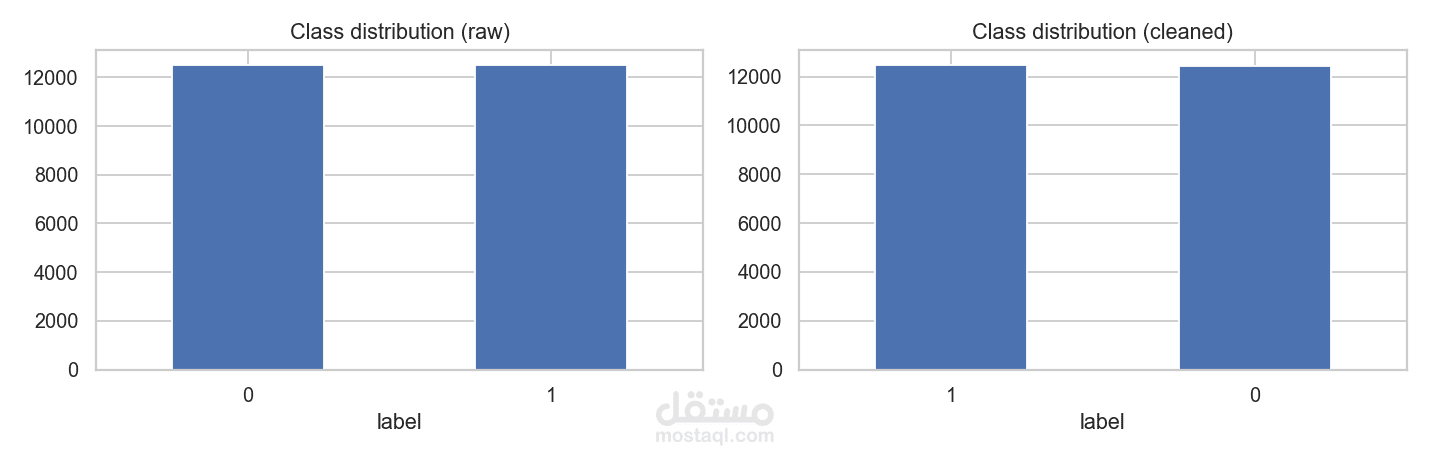
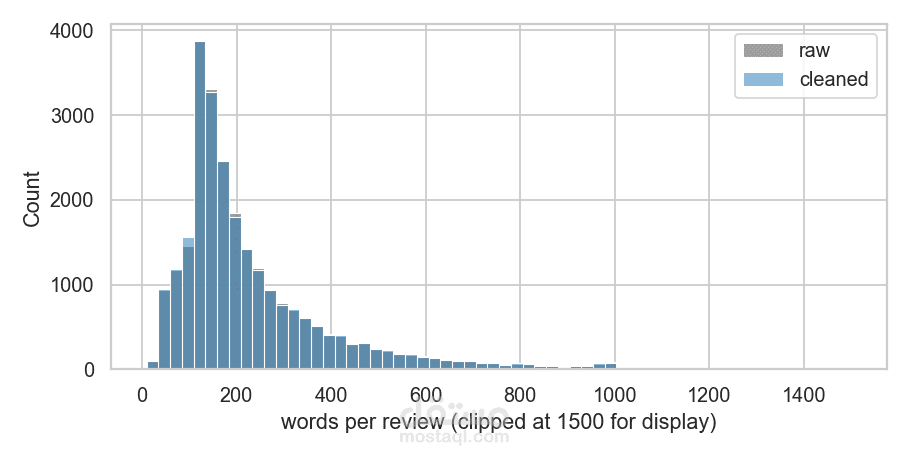
يتضمن المشروع فحص جودة البيانات لاكتشاف القيم المفقودة، والمراجعات المكررة، والنصوص الفارغة، ووسوم HTML، والروابط، والبريد الإلكتروني، ومشكلات الترميز، والقيم الشاذة في أطوال النصوص، بالإضافة إلى تحليل توزيع الفئات.
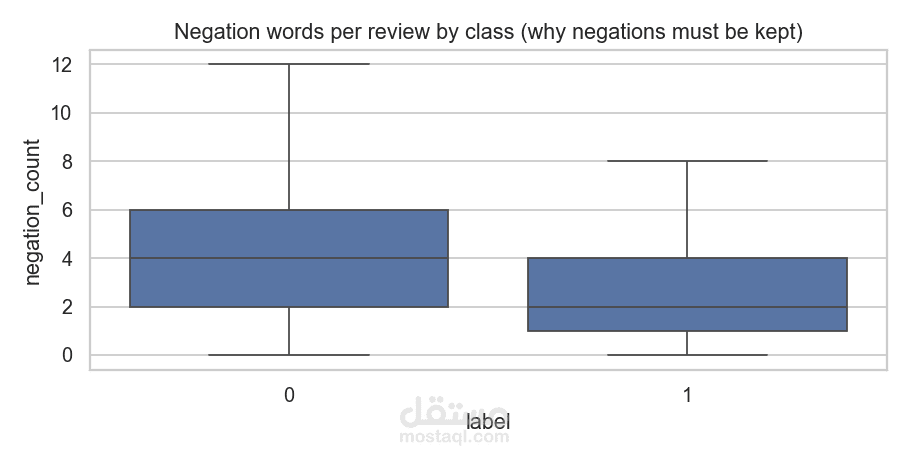
تم تنفيذ مجموعة من قواعد تنظيف النصوص لإزالة البيانات غير الضرورية وتصحيح مشكلات الترميز وتوحيد المسافات وعلامات الاقتباس والشرطات، مع الحفاظ على العناصر المهمة لتحليل المشاعر، مثل الأحرف الكبيرة، وعلامات التعجب والاستفهام، وأدوات النفي مثل (not وnever).
يعتمد المشروع على مكتبة NLTK لتنفيذ عملية Tokenization باستخدام TweetTokenizer، بالإضافة إلى استخراج خصائص نصية مثل عدد أدوات النفي وعلامات التعجب. كما يتضمن تجارب على إزالة الكلمات الشائعة (Stop-word Removal)، واستخراج جذور الكلمات (Stemming)، وإرجاع الكلمات إلى صيغتها الأساسية (Lemmatization)، دون تطبيقها على البيانات النهائية، بناءً على نتائج التقييم.
في المرحلة الأخيرة، تم إعداد واختبار مسار لاستخراج الخصائص باستخدام TF-IDF، بعد تقسيم البيانات بطريقة تحافظ على التوزيع النسبي للفئات (Stratified Split)، مع تدريب أداة استخراج الخصائص على بيانات التدريب فقط لتجنب تسرب البيانات (Data Leakage).
ينتج المشروع مجموعات بيانات نظيفة ومعالجة، وتقارير لجودة البيانات، وسجلات لعمليات التنظيف، وأمثلة توضح الفرق قبل المعالجة وبعدها، بالإضافة إلى تقرير نهائي شامل.
**التقنيات والأدوات المستخدمة:** Python، Pandas، NLTK، Scikit-learn، TF-IDF، NLP، Text Cleaning، Tokenization، Data Quality Analysis، وJupyter Notebook.
**ملاحظة:** يركز المشروع على تنظيف البيانات ومعالجتها وتجهيز الخصائص، ولم يتم تدريب أي نموذج لتصنيف المشاعر.