مشروع استخراج وتنظيف بيانات الكتب بـ Python (Books Web Scraping & Data Pipeline)
تفاصيل العمل
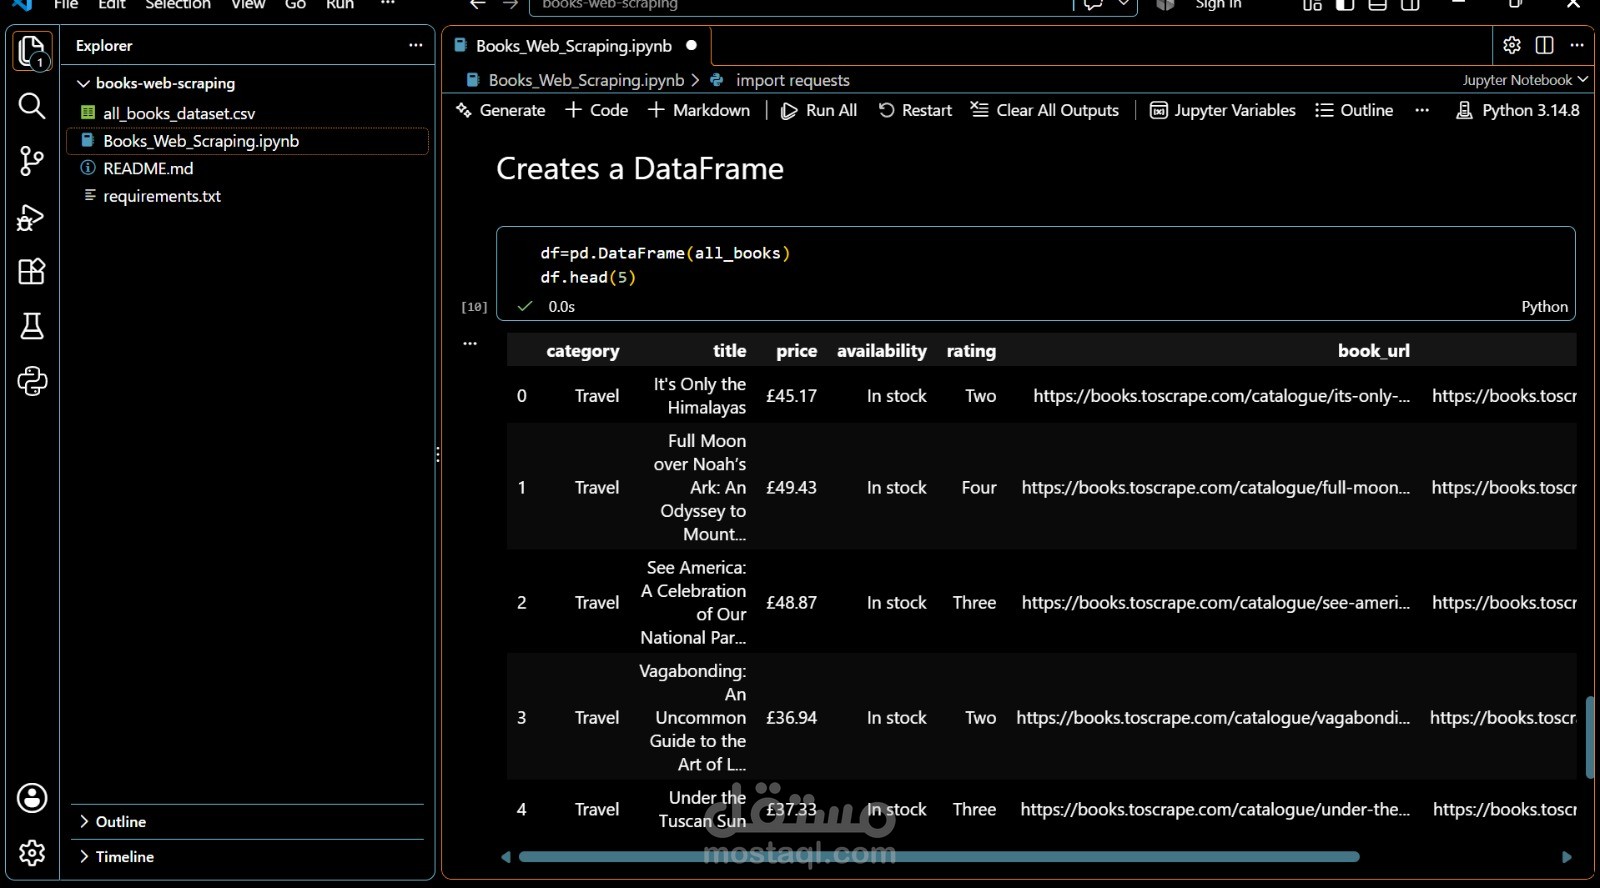
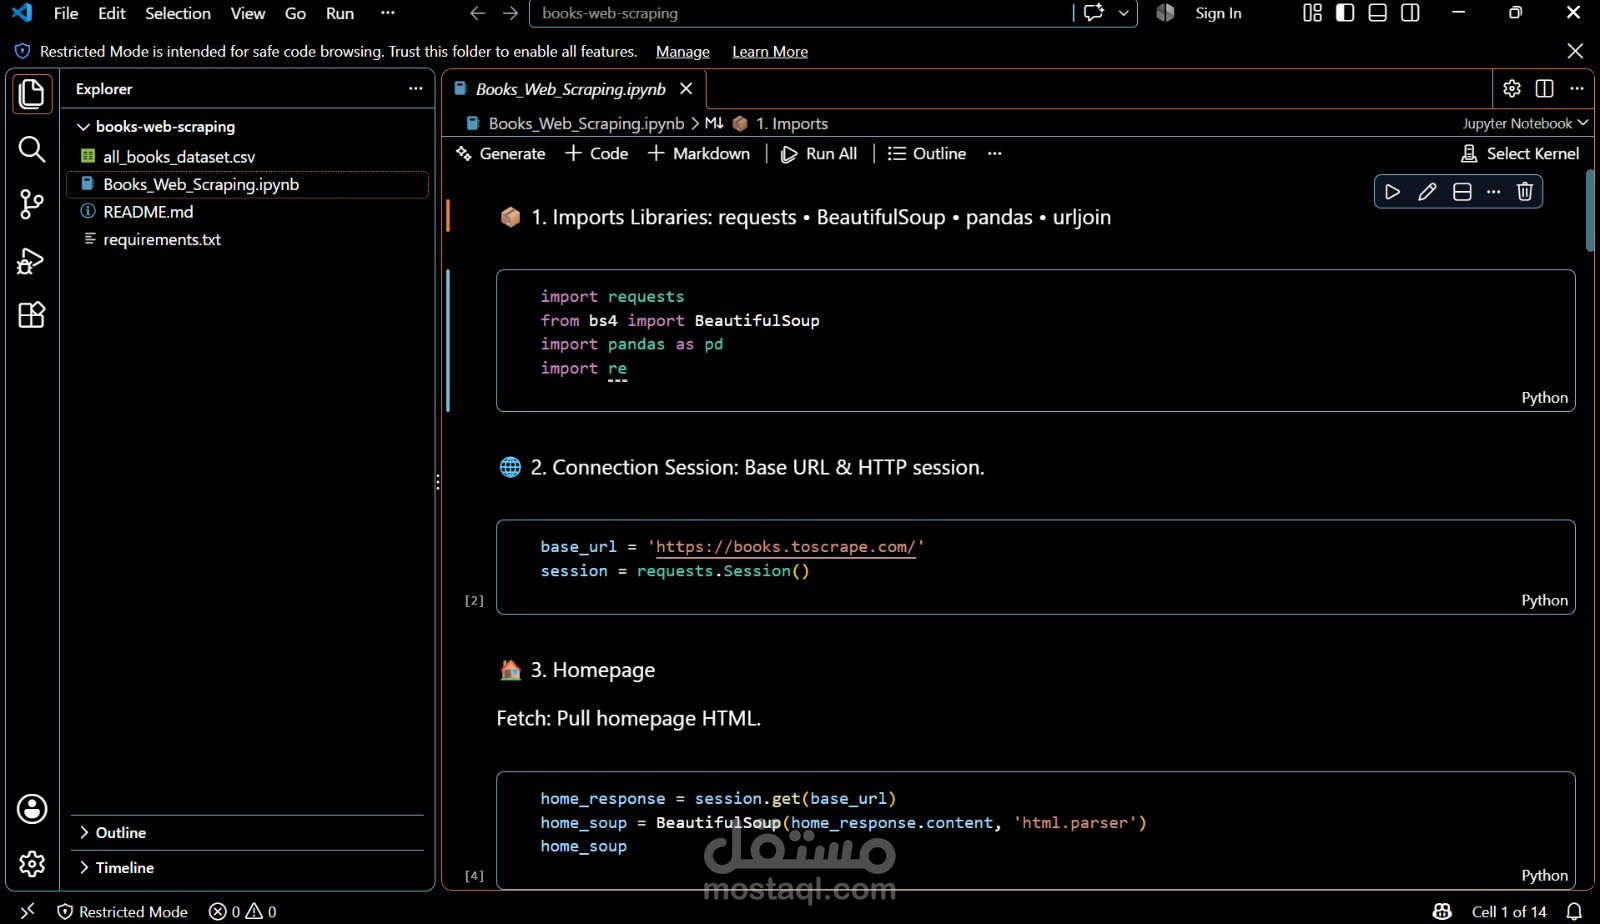
مشروع متكامل يهدف إلى جمع وتنظيف البيانات المهيكلة من موقع Books to Scrape باستخدام لغة Python، وبناء خط إنتاج بيانات (Data Pipeline) متكامل للتعامل مع البيانات الضخمة وتصديرها بصيغة جاهزة للتحليل.
المميزات وطريقة التنفيذ التقنية:
- إرسال طلبات HTTP والتعامل مع جلسات الاتصال باستخدام مكتبة Requests.
- تحليل واستخراج النصوص والبيانات من ملفات HTML بمرونة عن طريق BeautifulSoup.
- معالجة التنقل الآلي بين الأقسام والتنقل عبر صفحات الترقيم المختلفة (Pagination Handling).
- تنظيف النصوص والتأكد من مطابقة جودة البيانات باستخدام التعابير النمطية (Regular Expressions).
- معالجة البيانات، بناء الـ Schema، وتحويلها إلى جدول بيانات منظّم بواسطة مكتبة Pandas.
- تصدير البيانات النهائية بدقة عالية إلى ملف CSV جاهز للاستخدام في تحليل البيانات والتعلم الآلي.
التقنيات والأدوات المستخدمة:
Python | BeautifulSoup | Requests | Pandas | Regular Expressions | CSV Processing