سكرابر لأشهر أفلام IMDb
تفاصيل العمل
وصف المشكلة:
جمع بيانات الأفلام يدويًا من صفحات الويب مثل الترتيب والتقييم وعدد الأصوات وتاريخ الإصدار ومدة الفيلم والتصنيف العمري عملية تستغرق وقتًا وتكون عرضة للأخطاء.
الحل:
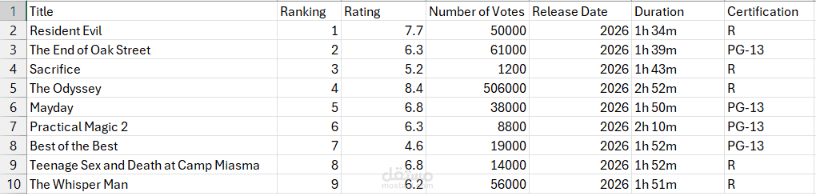
طورت Web Scraper باستخدام Python وRequests وBeautifulSoup لاستخراج بيانات الأفلام تلقائيًا من صفحات IMDb، ثم نظمت البيانات في Pandas DataFrame ونظفت القيم المفقودة وحولت الحقول إلى صيغ مناسبة للتحليل.
النتيجة:
تم تحويل بيانات الأفلام غير المنظمة على صفحات الويب إلى Dataset منظمة وقابلة للتحليل وتصديرها إلى ملف CSV، مما سهّل استخدامها في مشاريع تحليل البيانات لاحقًا.