Automated Machine Learning Pipeline – End-to-End ML System
تفاصيل العمل
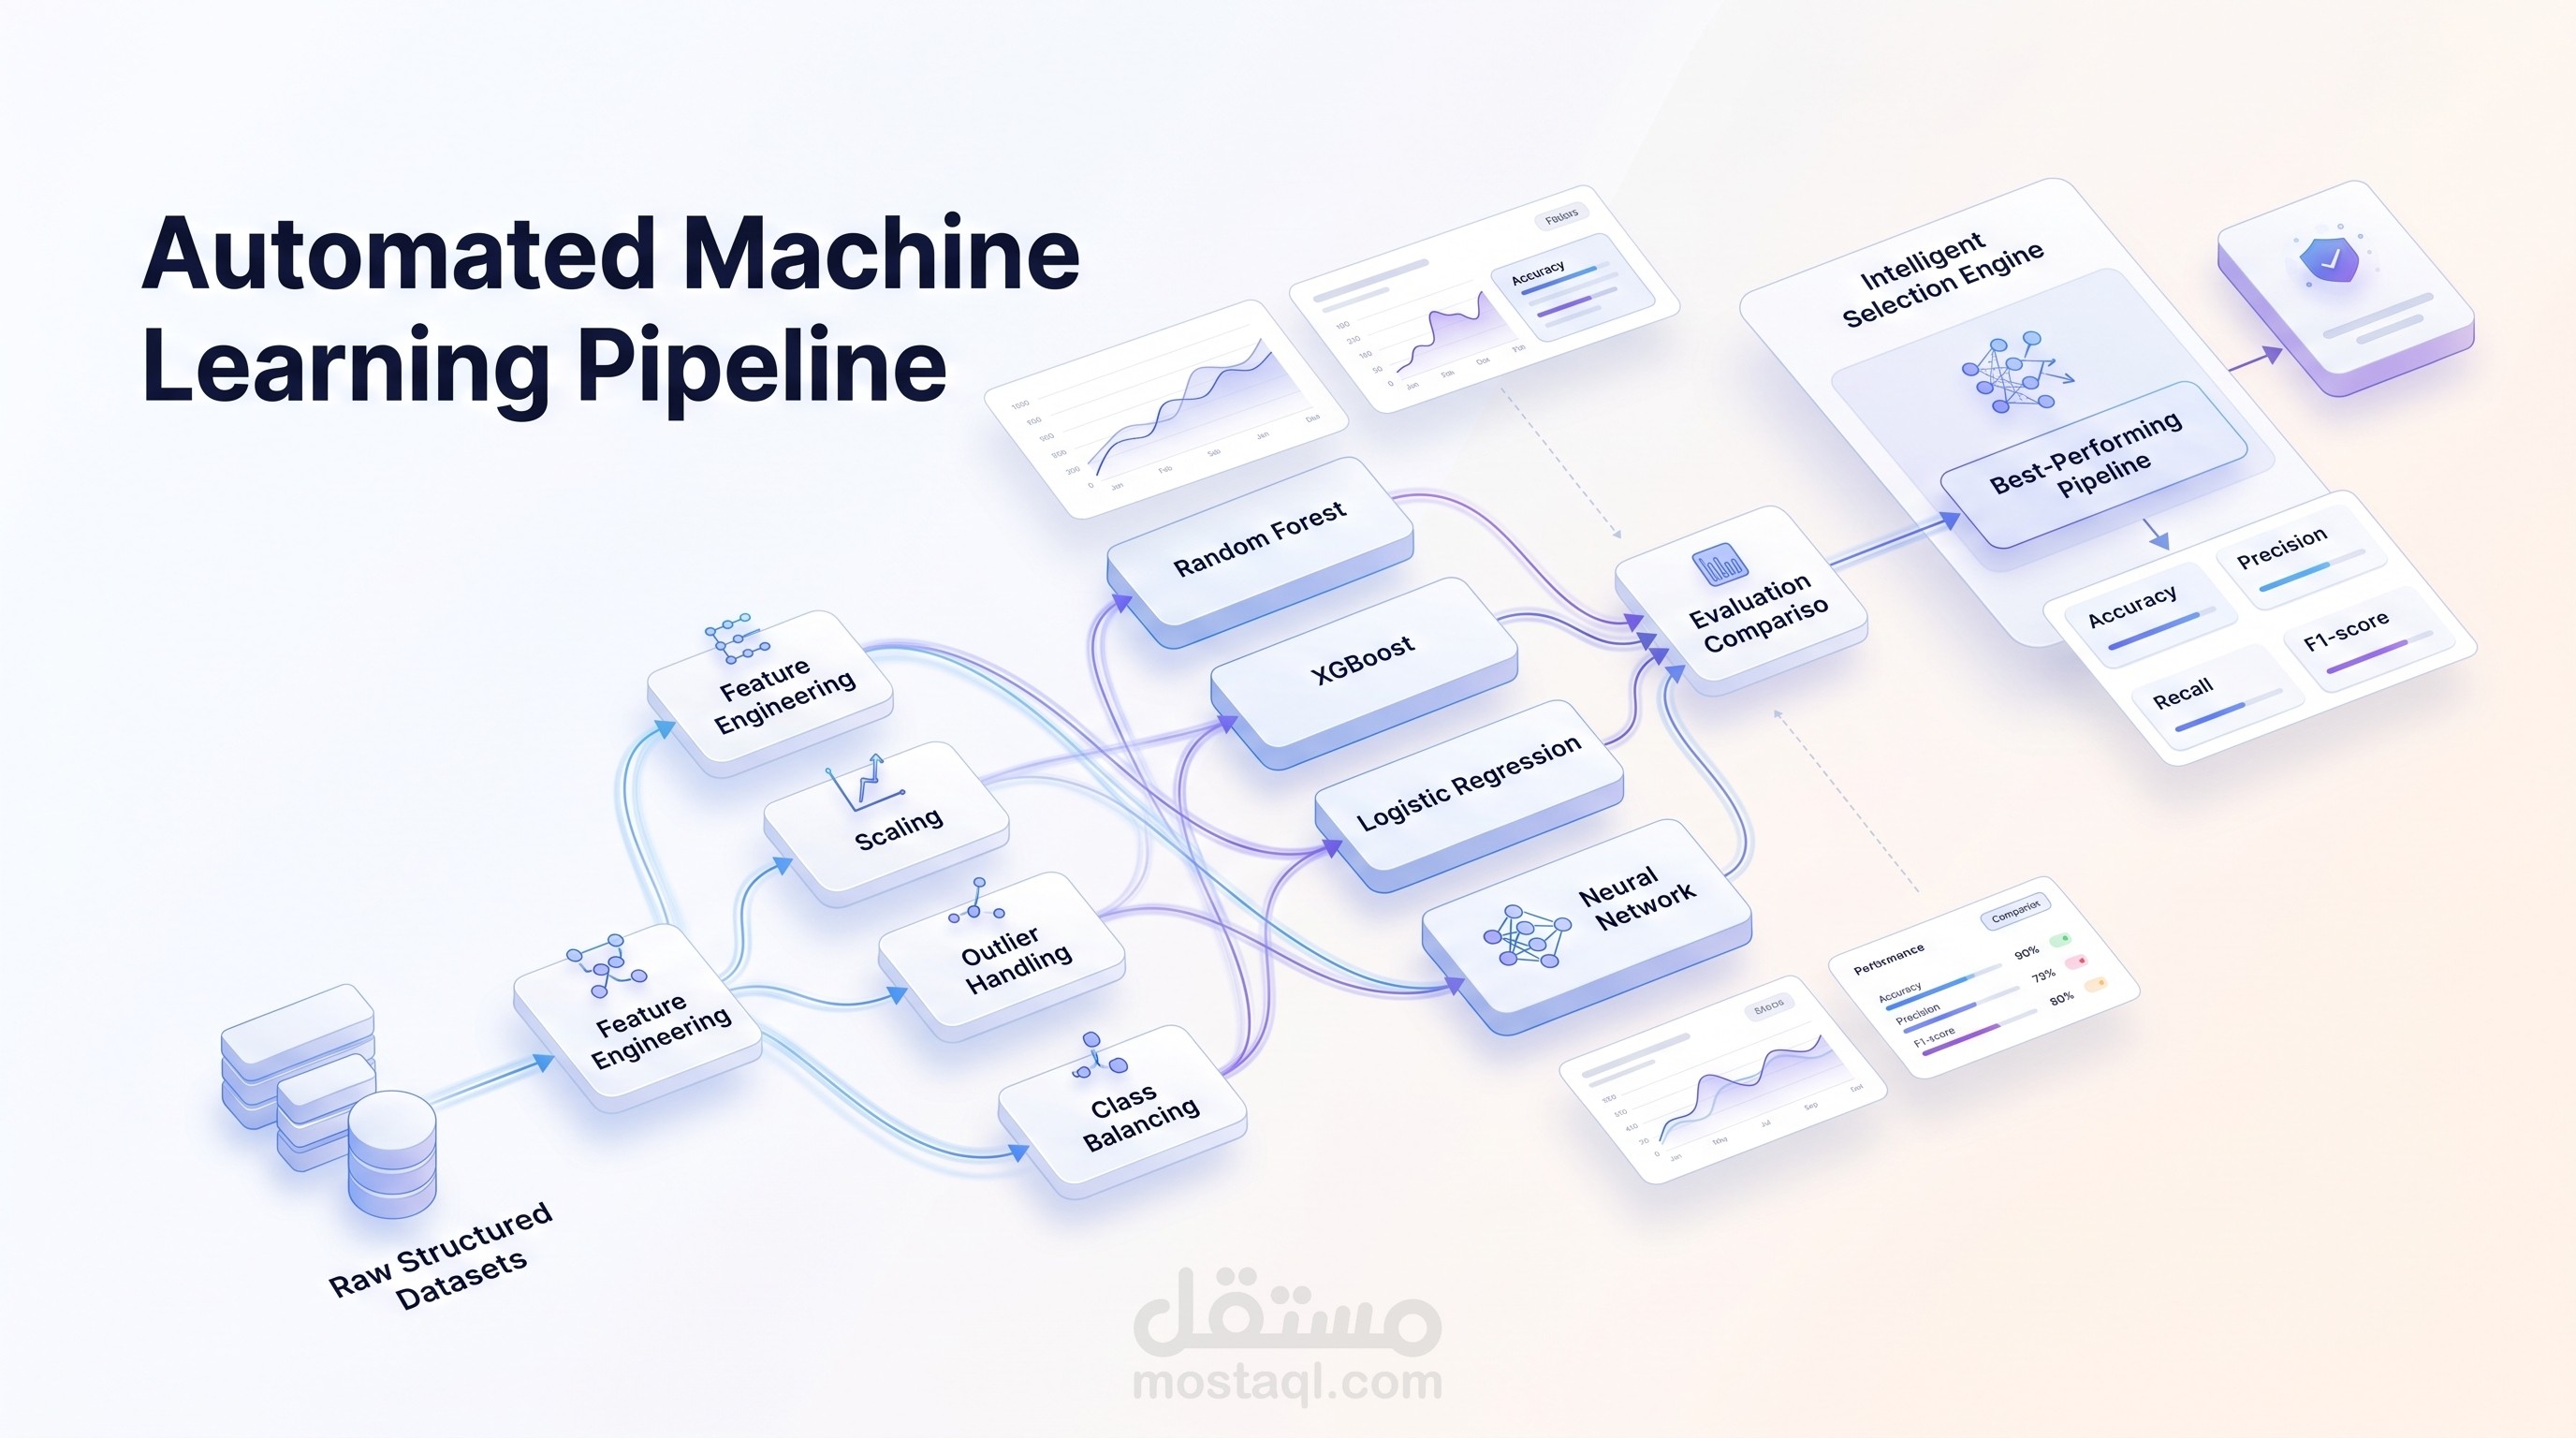
طورت نظام Automated Machine Learning مخصصًا لأتمتة عملية اختيار أفضل Machine Learning Pipeline بدل الاعتماد على التجربة اليدوية لكل Dataset.
يقوم النظام باختبار مجموعة من خطوات معالجة البيانات والنماذج المختلفة، ثم يقارن النتائج تلقائيًا لاختيار أفضل configuration بناءً على مقاييس الأداء.
أهم ما تم تنفيذه:
• معالجة Outliers باستخدام IQR وZ-score.
• تجربة عدة طرق Feature Scaling.
• التعامل مع عدم توازن البيانات باستخدام SMOTE وADASYN وUndersampling.
• اختبار عدة Machine Learning Models مثل Logistic Regression وRandom Forest وMLP وXGBoost.
• مقارنة النماذج باستخدام Accuracy وPrecision وRecall وF1-score.
• إعطاء أهمية خاصة للـRecall في الحالات التي تتطلب تقليل False Negatives.
• أتمتة عملية البحث عن أفضل combination من preprocessing وmodel configuration.
التقنيات المستخدمة:
Python, Scikit-learn, Pandas, NumPy, SMOTE, ADASYN, Random Forest, MLP, XGBoost.
النتيجة: Pipeline آلي يساعد على تقليل التجربة اليدوية وتسريع الوصول إلى configuration مناسب للبيانات والمشكلة المستهدفة.