IMDb Sentiment Intelligence | End-to-End NLP System
تفاصيل العمل
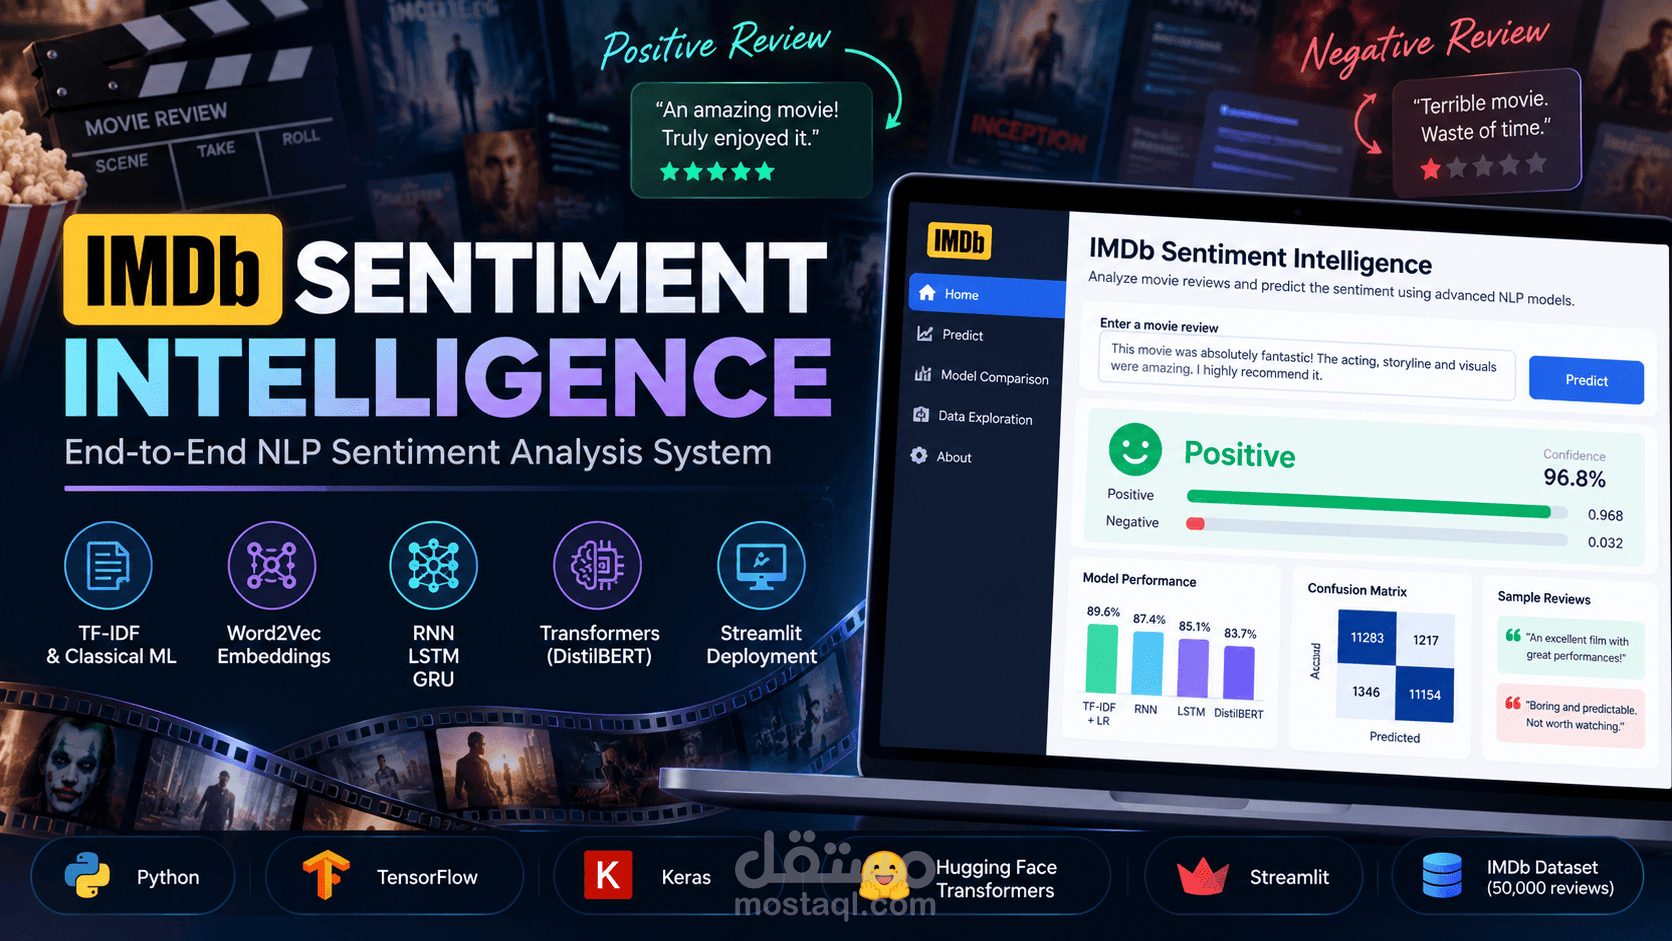
مشروع متكامل في معالجة اللغة الطبيعية لتطوير نظام ذكي يقوم بتحليل مراجعات الأفلام وتصنيف المشاعر إلى إيجابية أو سلبية باستخدام مجموعة من تقنيات تعلم الآلة والتعلم العميق والمحولات.
تم تنفيذ المشروع على مجموعة بيانات مراجعات أفلام IMDb التي تحتوي على 50,000 مراجعة، مع بناء خط معالجة متكامل للغة الطبيعية يبدأ من استكشاف البيانات وتنظيف النصوص وتجهيزها، مع الحفاظ على المعلومات اللغوية المهمة مثل النفي.
تم بناء وتقييم عدة أساليب ونماذج، بداية من تمثيل النصوص باستخدام TF-IDF مع الانحدار اللوجستي، ثم استخدام Word2Vec لتمثيل الكلمات دلاليًا، بالإضافة إلى نماذج التعلم العميق التي تشمل الشبكات العصبية المتكررة البسيطة RNN، وشبكات الذاكرة طويلة وقصيرة المدى LSTM، والشبكات ثنائية الاتجاه Bidirectional LSTM، ووحدات GRU، إلى جانب تجربة نموذج محولات مدرب مسبقًا باستخدام DistilBERT.
تضمن المشروع أيضًا تجارب Dropout للحد من فرط التعلم، وضبط حجم المفردات وطول التسلسل، بالإضافة إلى تحليل حالات التصنيف الخاطئ لفهم التحديات المرتبطة بالمشاعر المختلطة والنفي والسياق بعيد المدى.
حقق نموذج TF-IDF مع الانحدار اللوجستي دقة بلغت 89.58%، وبلغ مقياس F1 نحو 89.62% على مجموعة الاختبار الرسمية المكونة من 25,000 مراجعة.
وفي المرحلة النهائية، تم تطوير ونشر تطبيق ويب تفاعلي باستخدام Streamlit يسمح للمستخدم بإدخال مراجعة فيلم والحصول مباشرة على تصنيف المشاعر إلى إيجابية أو سلبية، بالإضافة إلى درجة الثقة واحتمالية كل فئة.
أبرز مراحل المشروع:
• تنظيف النصوص ومعالجتها وتجهيزها
• تمثيل النصوص باستخدام TF-IDF والانحدار اللوجستي
• إنشاء تمثيلات دلالية للكلمات باستخدام Word2Vec
• بناء الشبكات العصبية المتكررة RNN
• بناء شبكات LSTM وBidirectional LSTM
• بناء وتقييم نموذج GRU
• إجراء تجارب Dropout للحد من فرط التعلم
• ضبط حجم المفردات وطول التسلسل
• تجربة نموذج DistilBERT المدرب مسبقًا
• تقييم النماذج ومقارنتها
• تحليل حالات التصنيف الخاطئ وتفسير أسبابها
• تطوير ونشر التطبيق التفاعلي باستخدام Streamlit
التقنيات والأدوات المستخدمة:
Python، معالجة اللغة الطبيعية، Scikit-learn، TensorFlow، Keras، Word2Vec، RNN، LSTM، GRU، Hugging Face Transformers، DistilBERT، Streamlit