Machine learing
تفاصيل العمل
هل لديك بيانات كثيرة ولا تعرف ما الأنماط المخفية فيها؟ أقدم لك خدمة تنظيف البيانات وتجميعها إلى مجموعات متشابهة باستخدام التعلم غير الموجّه (Unsupervised Learning)، مع التحقق من جودة النتائج وعرضها في رسوم بيانية واضحة.
من أعمالي: تجميع بيانات استهلاك الكهرباء المنزلي
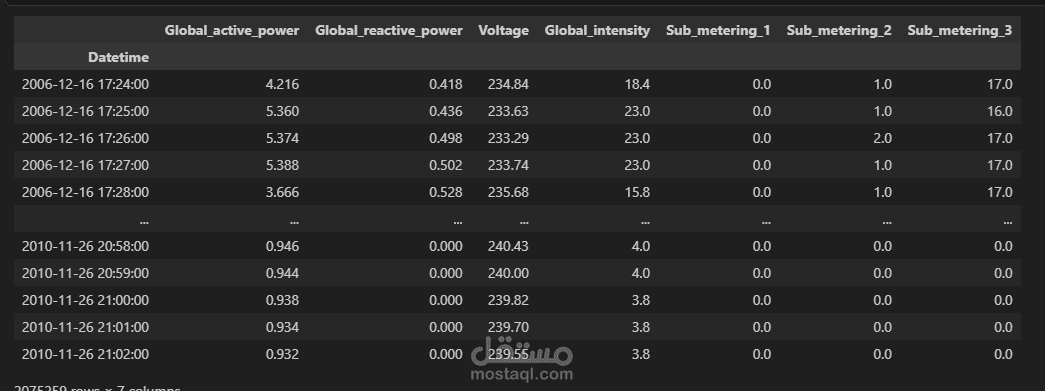
عملتُ على مجموعة بيانات تضم 2,075,259 قراءة مسجلة كل دقيقة بين ديسمبر 2006 ونوفمبر 2010، وفيها سبع متغيرات منها القدرة الكهربائية والجهد وشدة التيار وقراءات العدادات الفرعية. وقمتُ بما يلي:
تنظيف البيانات وتجهيزها، وتحويل الوقت والتاريخ إلى فهرس زمني [اذكر ما فعلته بالقيم المفقودة].
تحجيم البيانات باستخدام RobustScaler المعتمد على المدى الربيعي (IQR)، لأنه أقل تأثراً بالقيم الشاذة من التحجيم العادي.
تحديد عدد المجموعات المناسب بطريقة المرفق (Elbow Method).
التحقق من جودة التجميع بمقياس Silhouette [القيمة: ...].
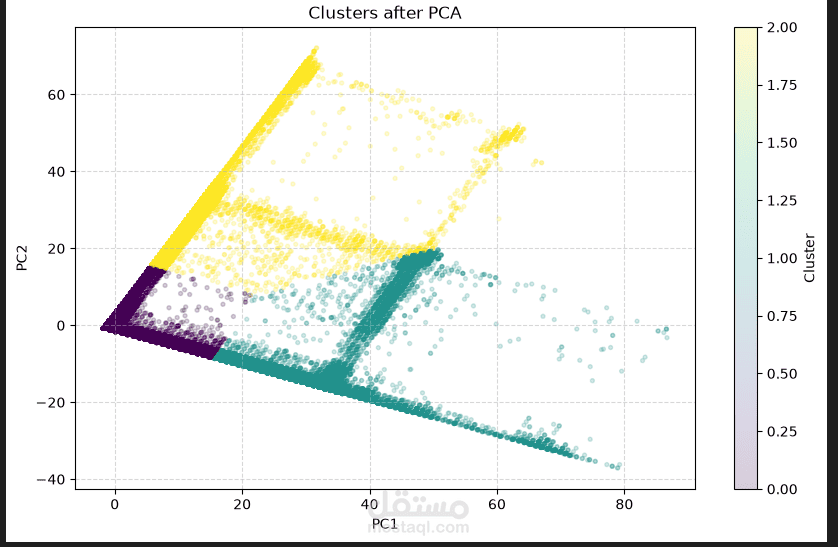
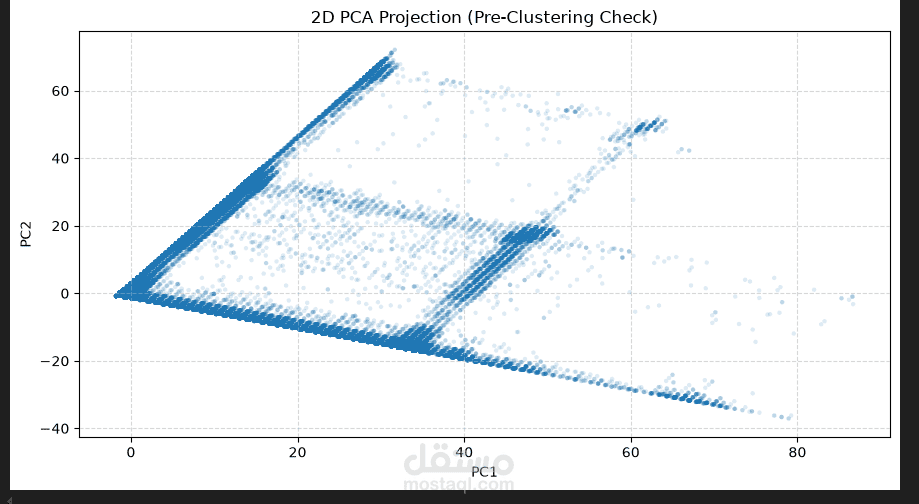
تقليل الأبعاد بتقنية PCA ورسم المجموعات في شكل ثنائي الأبعاد لعرض النتائج.
ماذا أقدم لك؟
تنظيف البيانات الكبيرة وتجهيزها بـ Python (Pandas و NumPy).
تجميع البيانات (Clustering) بخوارزمية [K-Means] باستخدام Scikit-Learn.
اختيار عدد المجموعات بطريقة Elbow والتحقق بمقياس Silhouette.
رسوم بيانية (Matplotlib و Seaborn) تشرح النتائج بشكل مفهوم.
تسليم الكود (Notebook) مع شرح مختصر للنتائج.
لماذا تختارني؟
لا أكتفي بتشغيل الخوارزمية، بل أتحقق من النتائج بمقاييس واضحة.
كود نظيف ومرتب، وتواصل واضح بالعربية والإنجليزية.
التزام بالموعد، وتعديلات بعد التسليl.