IMDb Movie Data Pipeline | ETL & Data Engineering
تفاصيل العمل
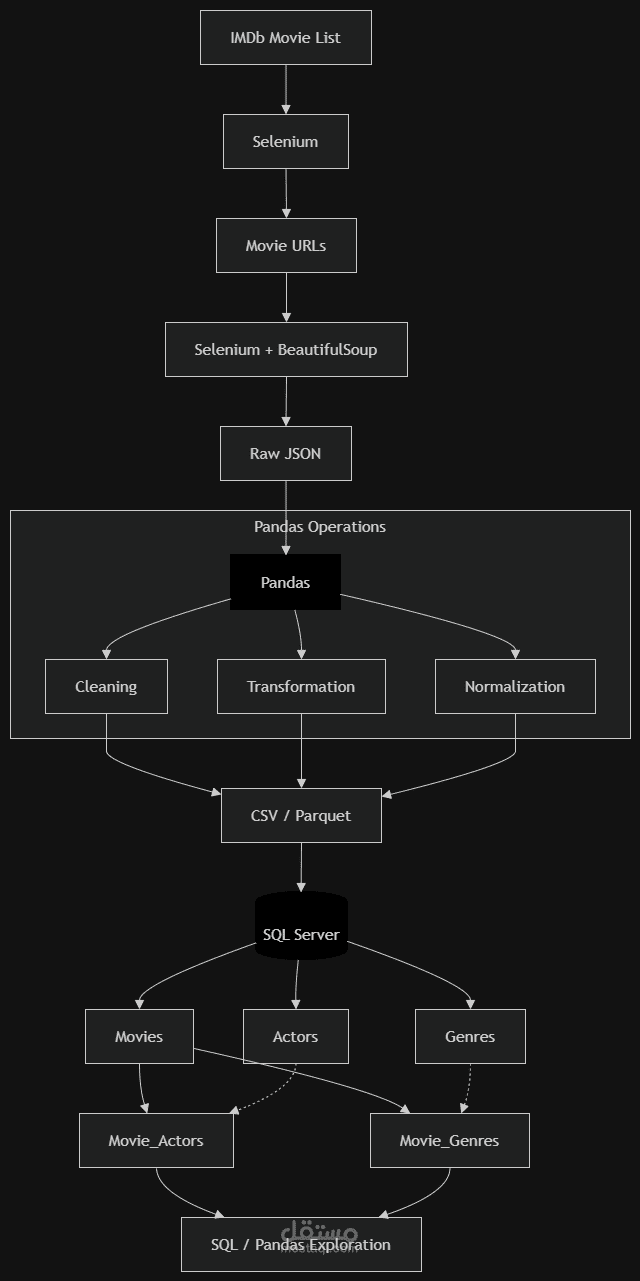
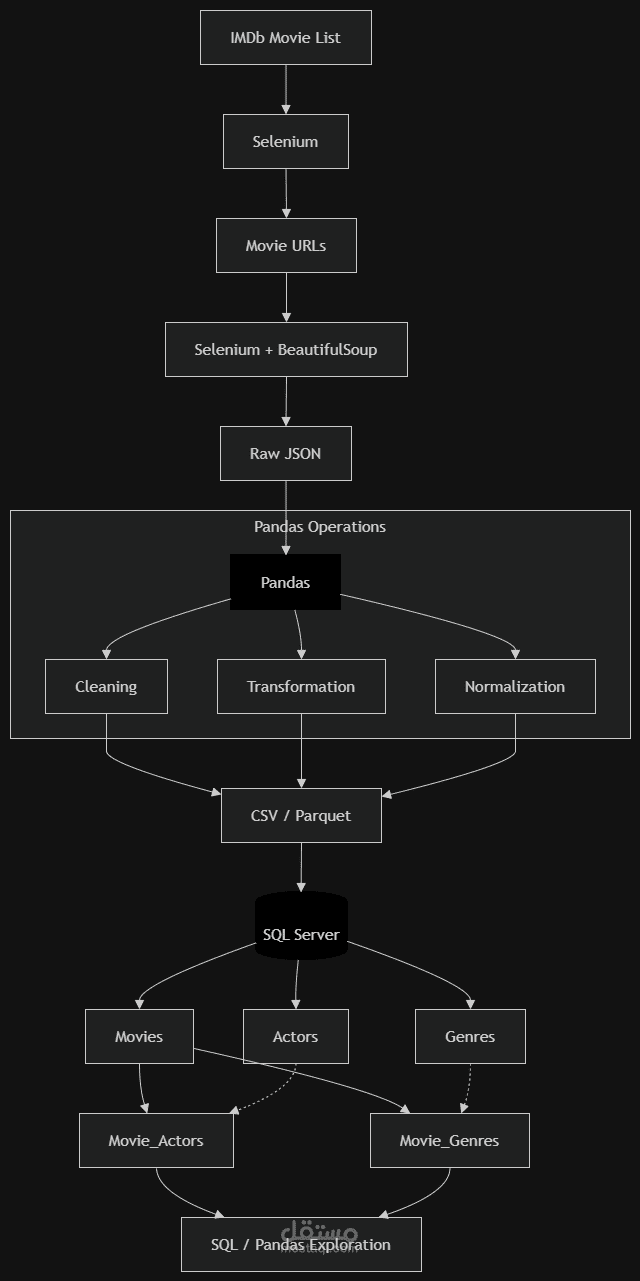
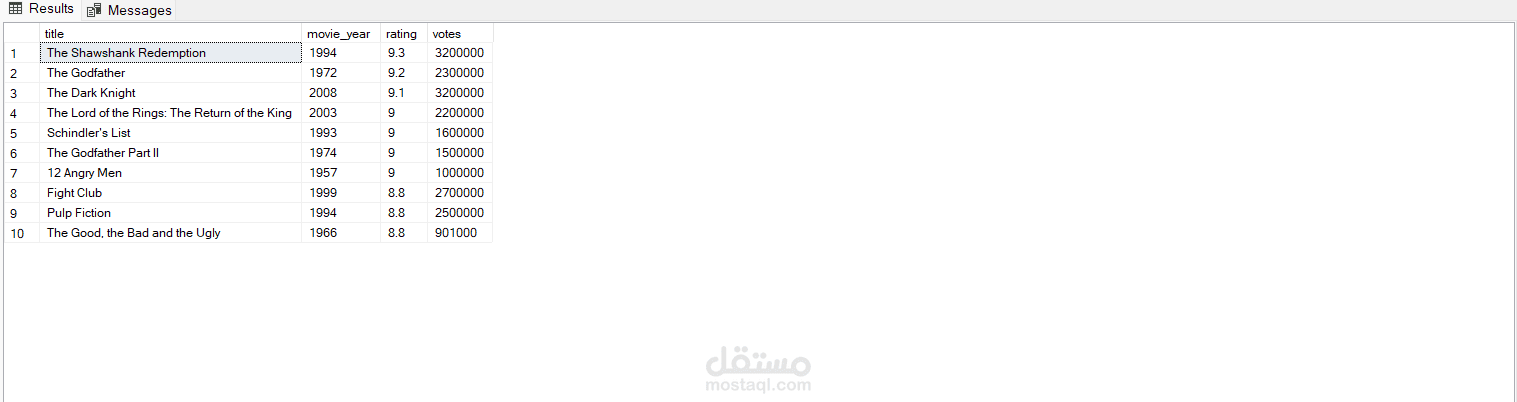
بنيت خط أنابيب بيانات متكامل (End-to-End Data Pipeline) لجمع ومعالجة بيانات الأفلام من IMDb وتحويلها من بيانات خام إلى بيانات منظمة وجاهزة للتحليل.
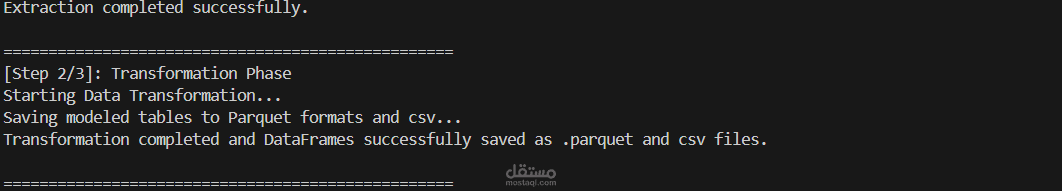
بدأت المشروع بمرحلة استخراج البيانات باستخدام Python وSelenium وBeautifulSoup، ثم قمت بتنظيف وتحويل البيانات باستخدام Pandas، مع معالجة القيم المفقودة والتكرارات وتوحيد أنواع البيانات.
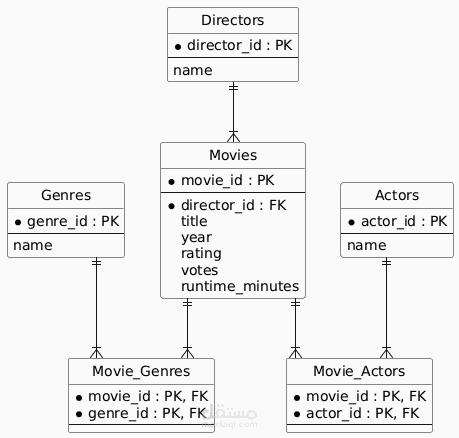
صممت قاعدة بيانات علائقية منظمة وفق مبادئ التطبيع (3NF)، وقسمت البيانات إلى جداول مترابطة للأفلام، الممثلين، المخرجين، الأنواع والتقييمات.
بعد ذلك قمت بتخزين البيانات بصيغ Parquet وCSV، ثم تحميلها إلى Microsoft SQL Server باستخدام SQLAlchemy مع تطبيق العلاقات والقيود بين الجداول.
استخدمت SQL لإجراء عمليات الاستعلام والتحقق من جودة البيانات واستخراج معلومات مفيدة من قاعدة البيانات.
الأدوات والتقنيات:
Python, Selenium, BeautifulSoup, Pandas, SQL, Microsoft SQL Server, SQLAlchemy, ETL, Web Scraping