football-data-analysis
تفاصيل العمل
1. المشكلة التي يحلها المشروع (The Problem Solved):
في عالم كرة القدم الحديثة، تمتلك الأندية والمحللون كميات ضخمة من البيانات العشوائية وغير المنظمة الخاصة بأداء اللاعبين والفرق أثناء المباريات. المشكلة الرئيسية تكمن في:
صعوبة استخراج رؤى عملية (Actionable Insights) من الأرقام الصماء والبيانات الضخمة دون معالجة وتحليل دقيق.
غياب الرؤية الشاملة لتقييم الأداء الفعلي للاعبين أو الفرق بشكل موضوعي بعيداً عن التقييمات الشفهية أو الانطباعات الشخصية.
الحاجة لتنظيف وهيكلة البيانات العشوائية (Raw Data) لتحويلها إلى مؤشرات أداء قياسية (KPIs) يُمكن الاعتماد عليها في اتخاذ القرارات التكتيكية أو صفقات الانتقالات.
2. الحل التقني والمنهجية (The Solution & Methodology):
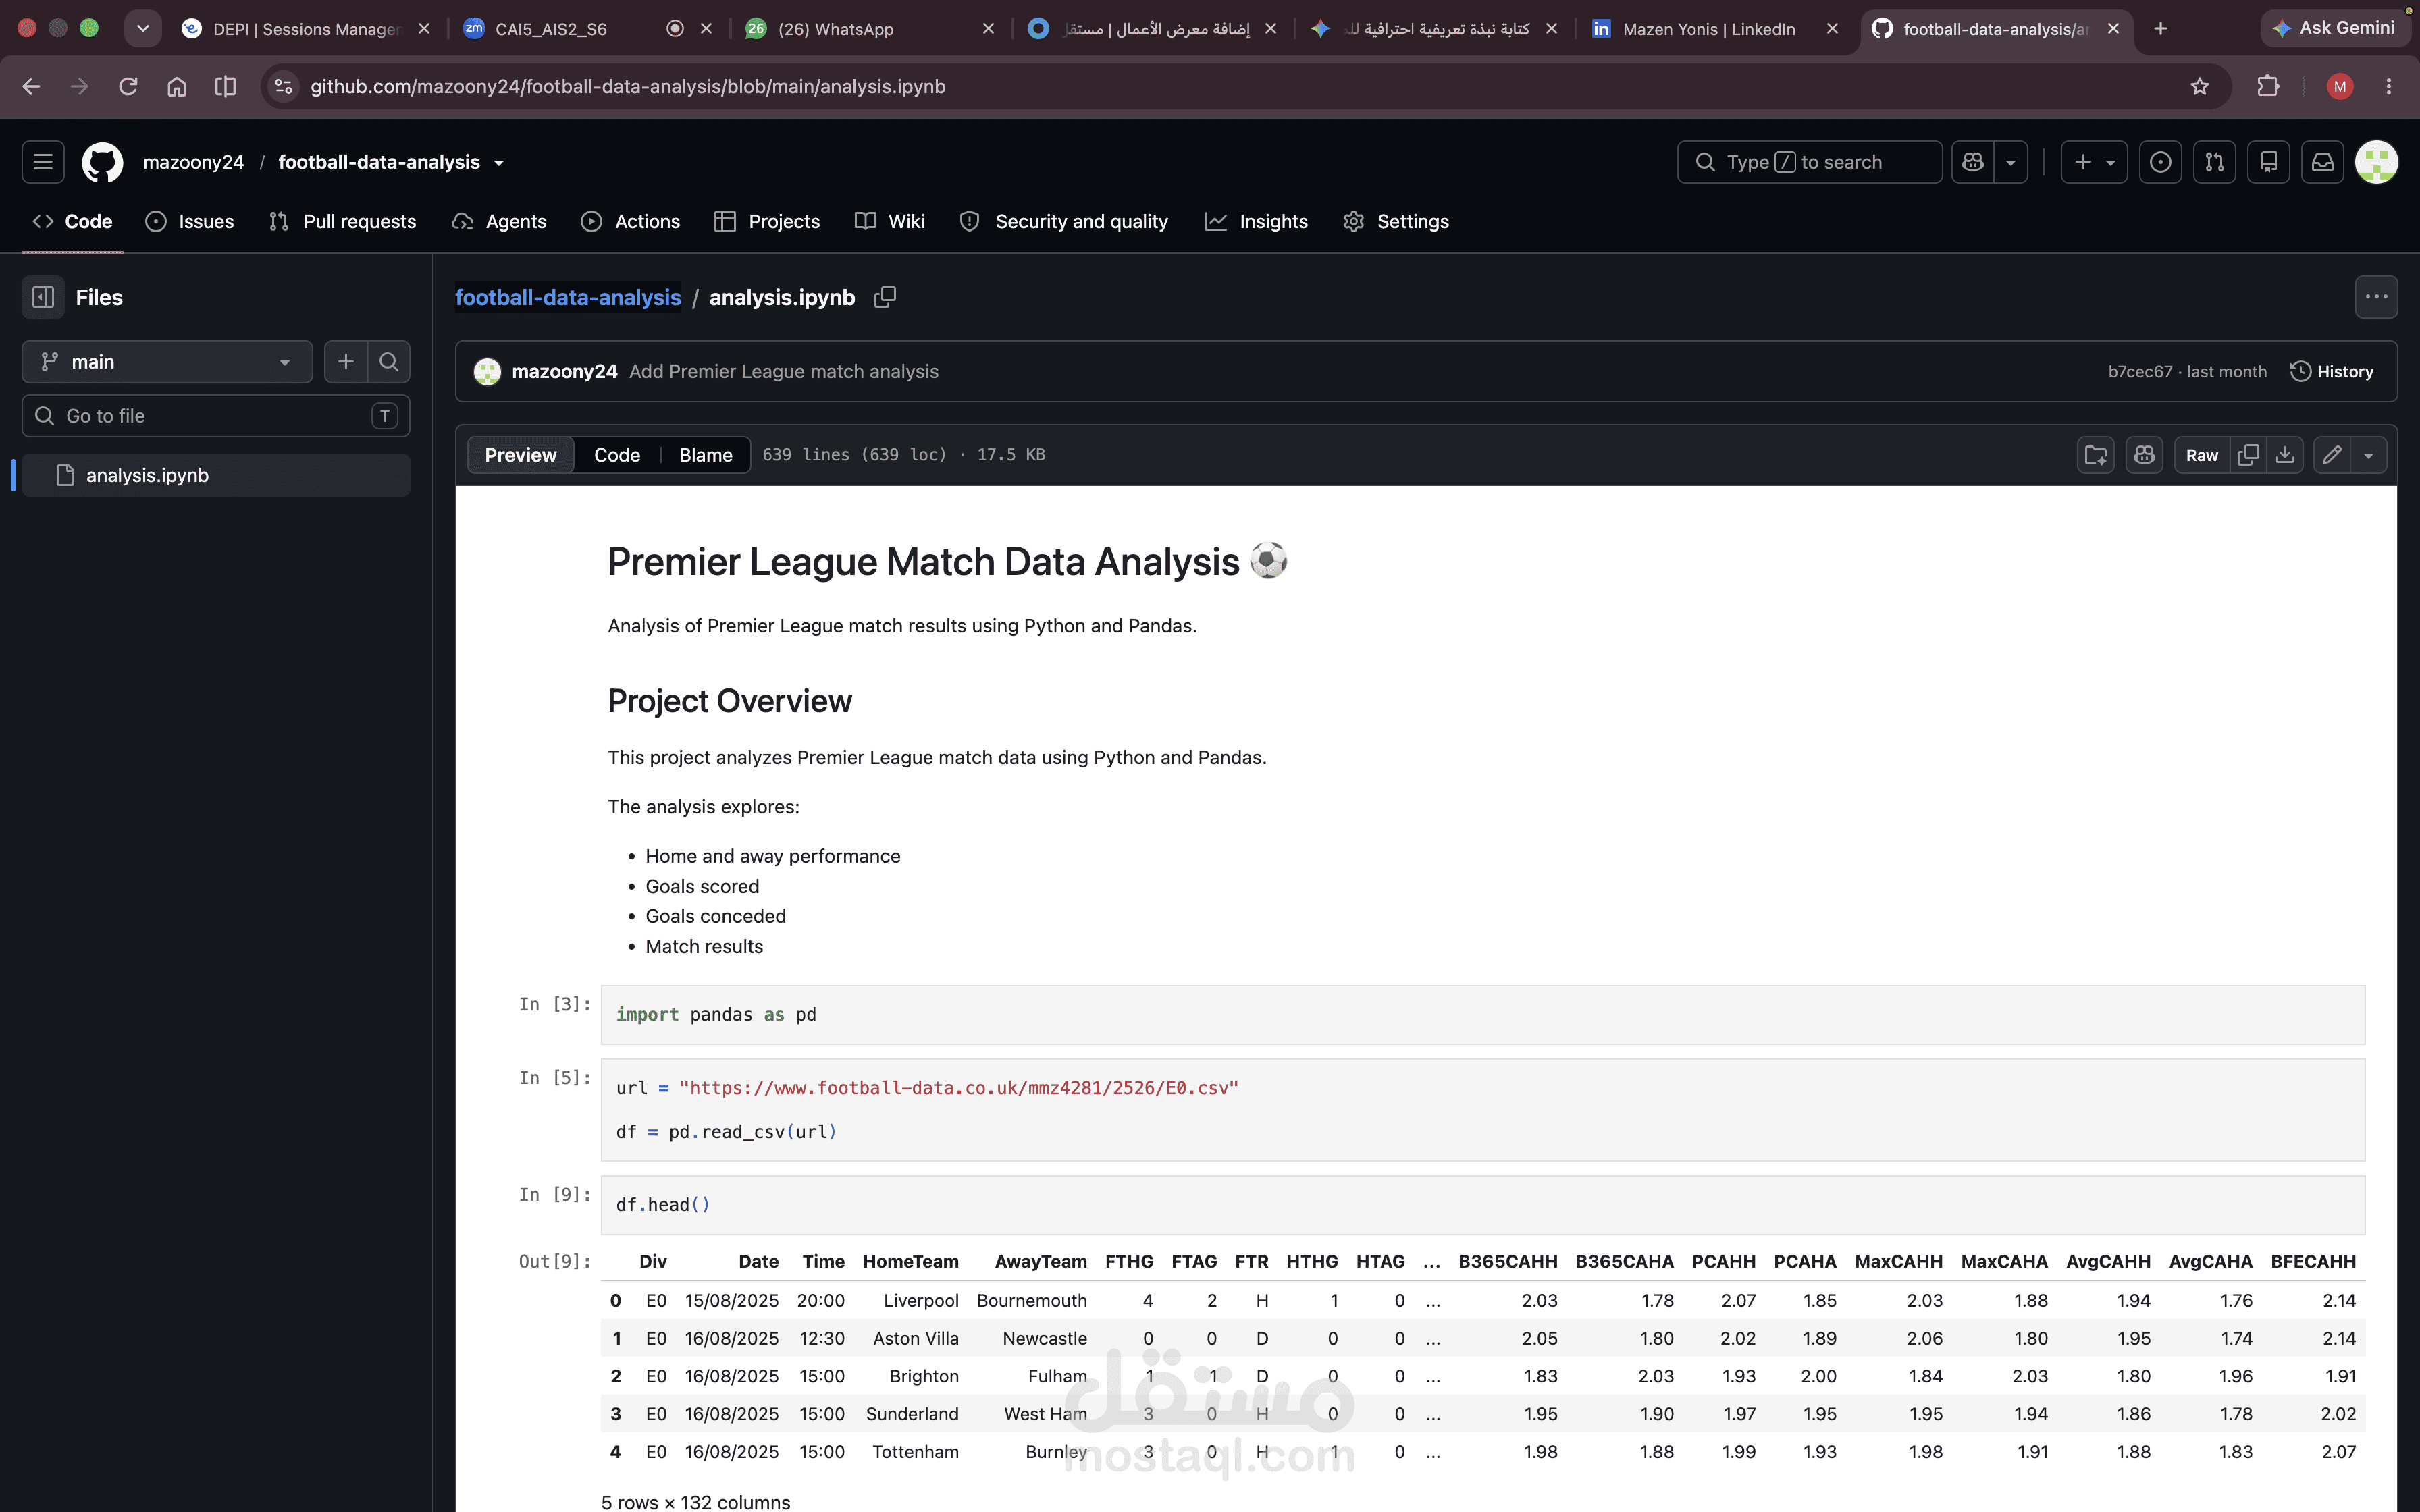
قام المشروع بحل هذه المشكلة من خلال بناء بيئة تحليل بيانات متكاملة باستخدام Python ومكتبات تحليل البيانات المتقدمة (Pandas, NumPy, Matplotlib, Seaborn)، حيث تم تحقيق الآتي:
استكشاف وتنظيف البيانات (EDA & Data Cleaning): معالجة البيانات الخام، التعامل مع القيم المفقودة (Missing Values)، وهيكلة البيانات في جداول منظمّة لجعلها جاهزة للتحليل الإحصائي.
استخراج مؤشرات الأداء (Feature Engineering & Metrics): حساب وإستخراج معدلات ومؤشرات أداء دقيقة للفرق واللاعبين (مثل معدلات التمرير، التسديد، صناعة الفرص، ونسب الاستحواذ/الأهداف).
التأطير البصري للبيانات (Data Visualization): تحويل الأرقام والإحصائيات المعقدة إلى مخططات ورسوم بيانية تفاعلية وواضحة، مما يسهل على المدربين أو الإدارة فهم نقاط القوة والضعف في الفريق/اللاعبين بسرعة وبدقة عالية.
3. القيمة المضافة للأعمال (Business & Sports Value):
دعم اتخاذ القرار: تمكين صناع القرار والمدربين من اتخاذ قرارات تكتيكية مبنية على أرقام وحقائق مثبتة بدلاً من التخمين.
تقييم الأداء والاستكشاف (Scouting & Performance Evaluation): المساعدة في مقارنة أداء اللاعبين ببعضهم بأسلوب علمي وموضوعي.
بنية برمجية قابلة للتكرار (Scalable Code Pipeline): كتابة كود برمجي منظم ومعيد للاستخدام، يُمكن تطبيقه بسهولة على مواسم مختلفة أو دوريات رياضية متعددة.