Spam Detection System
تفاصيل العمل
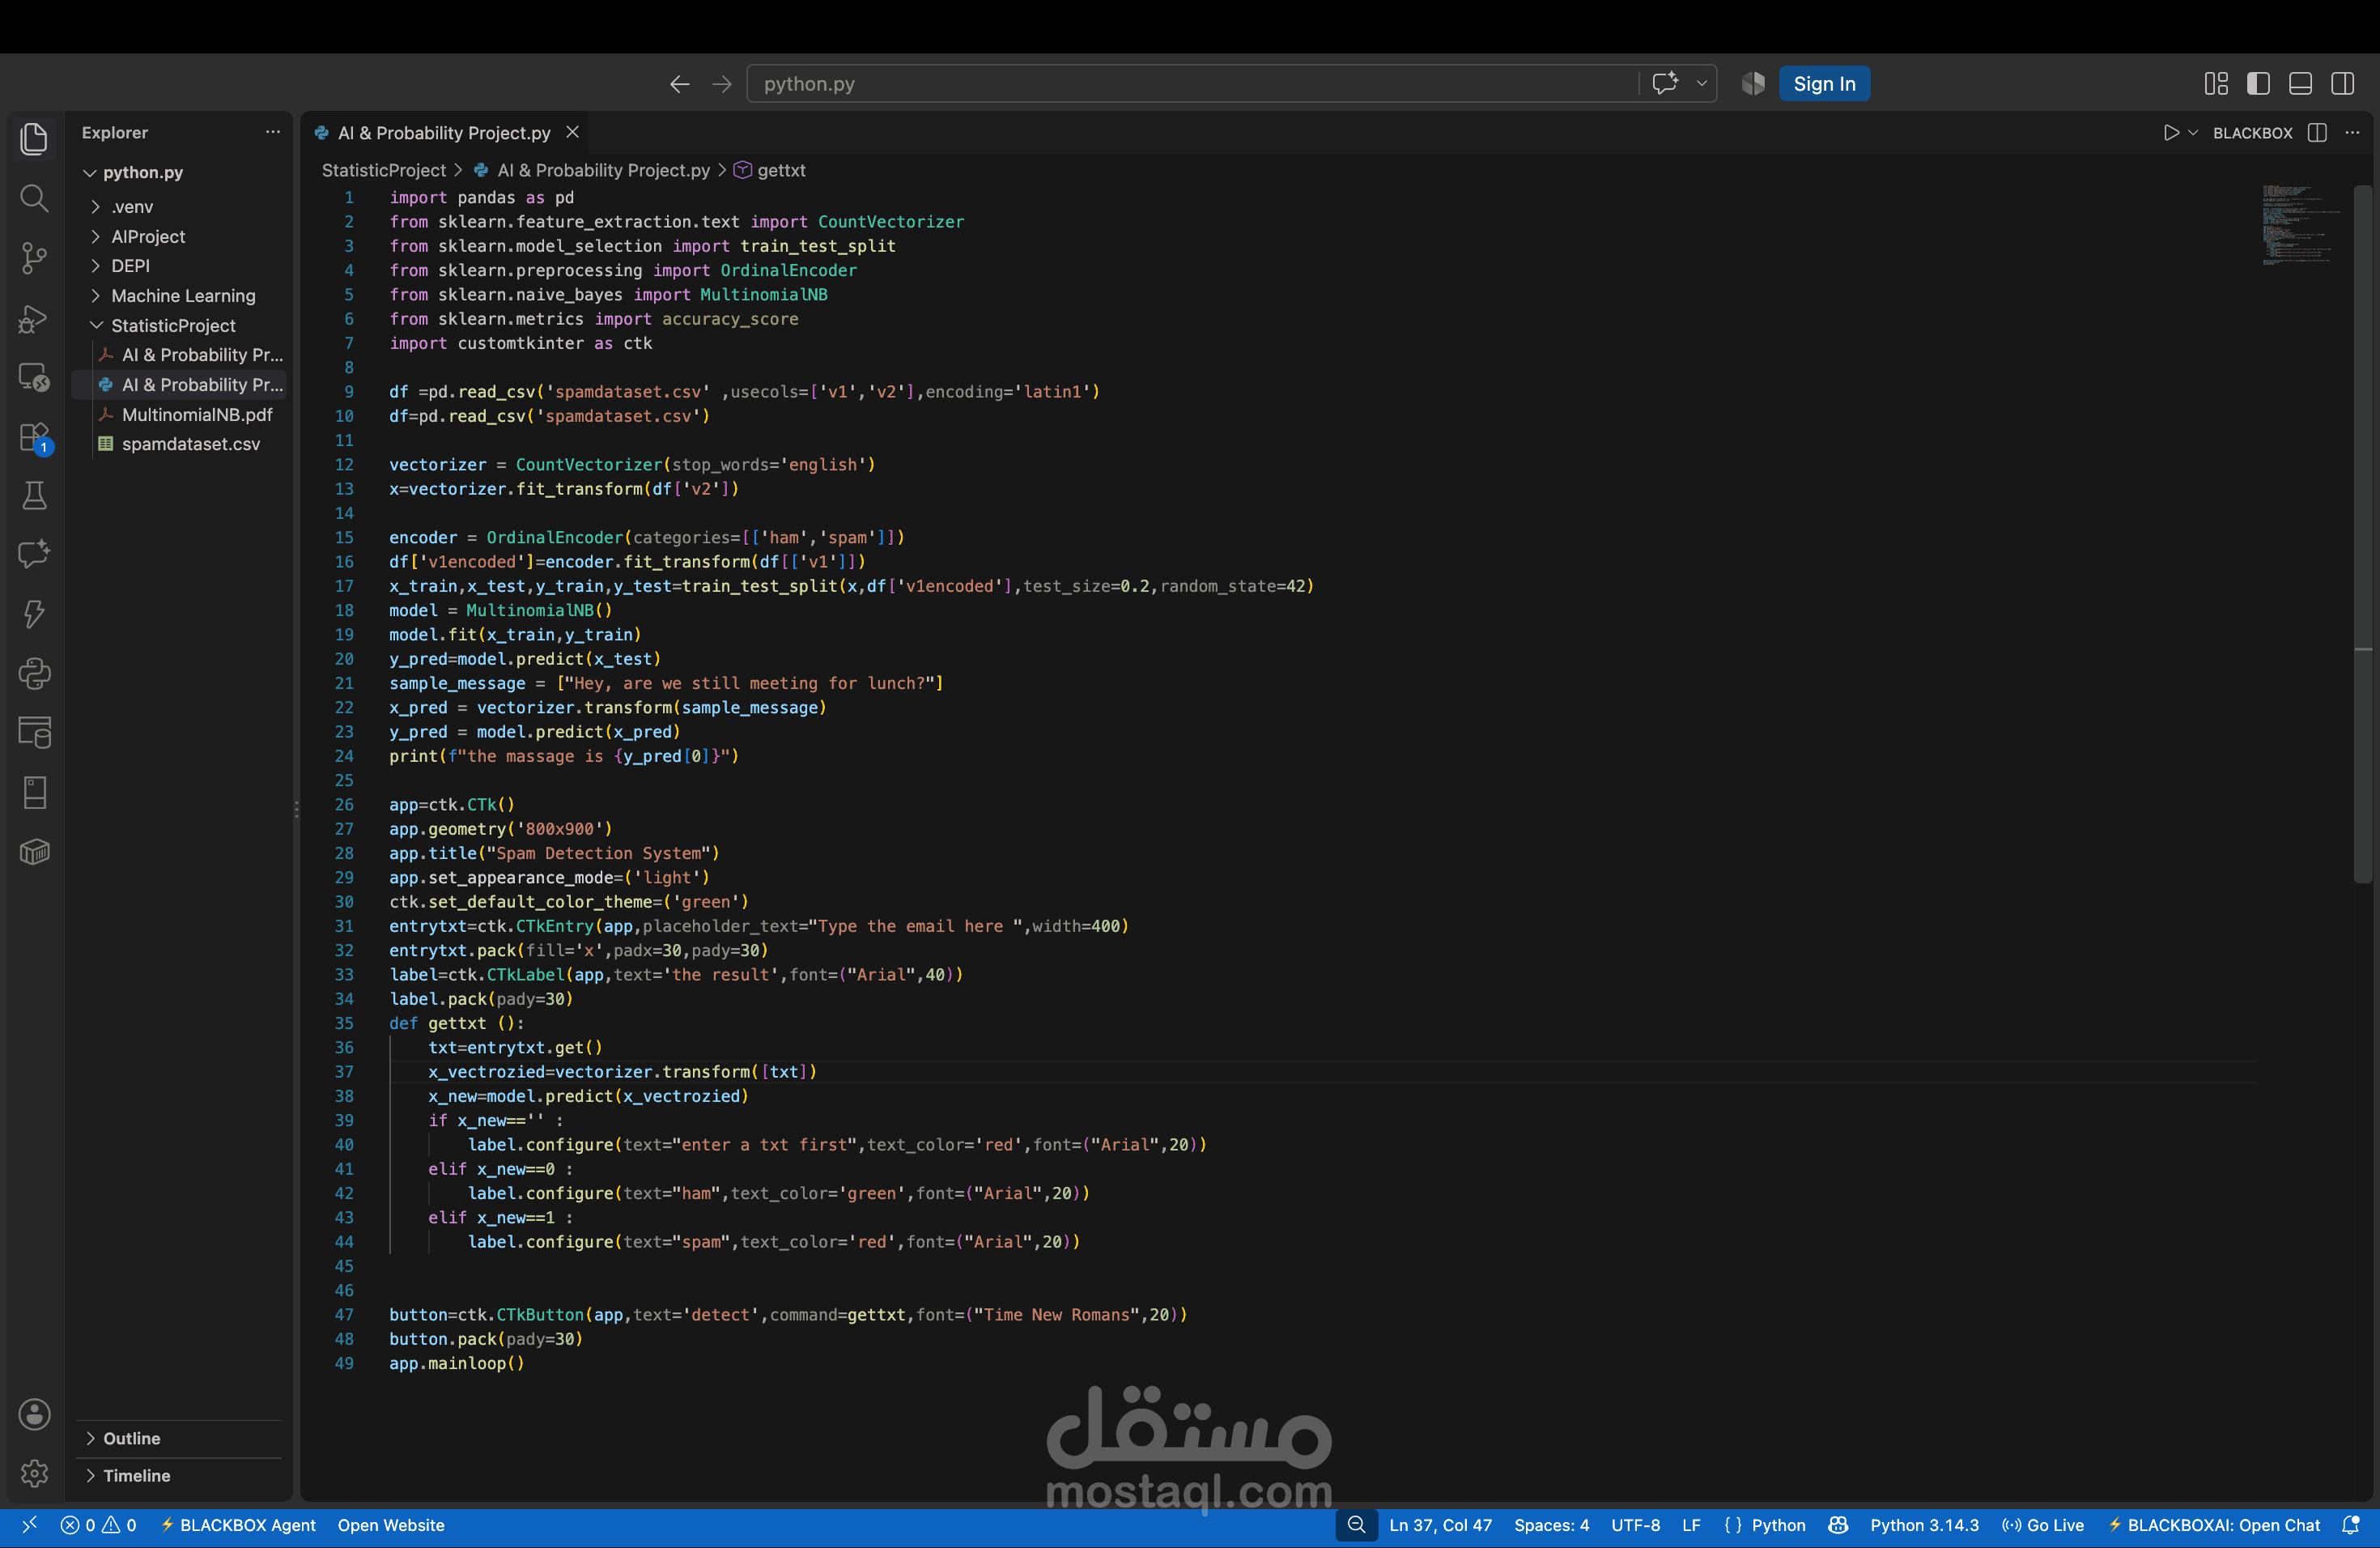
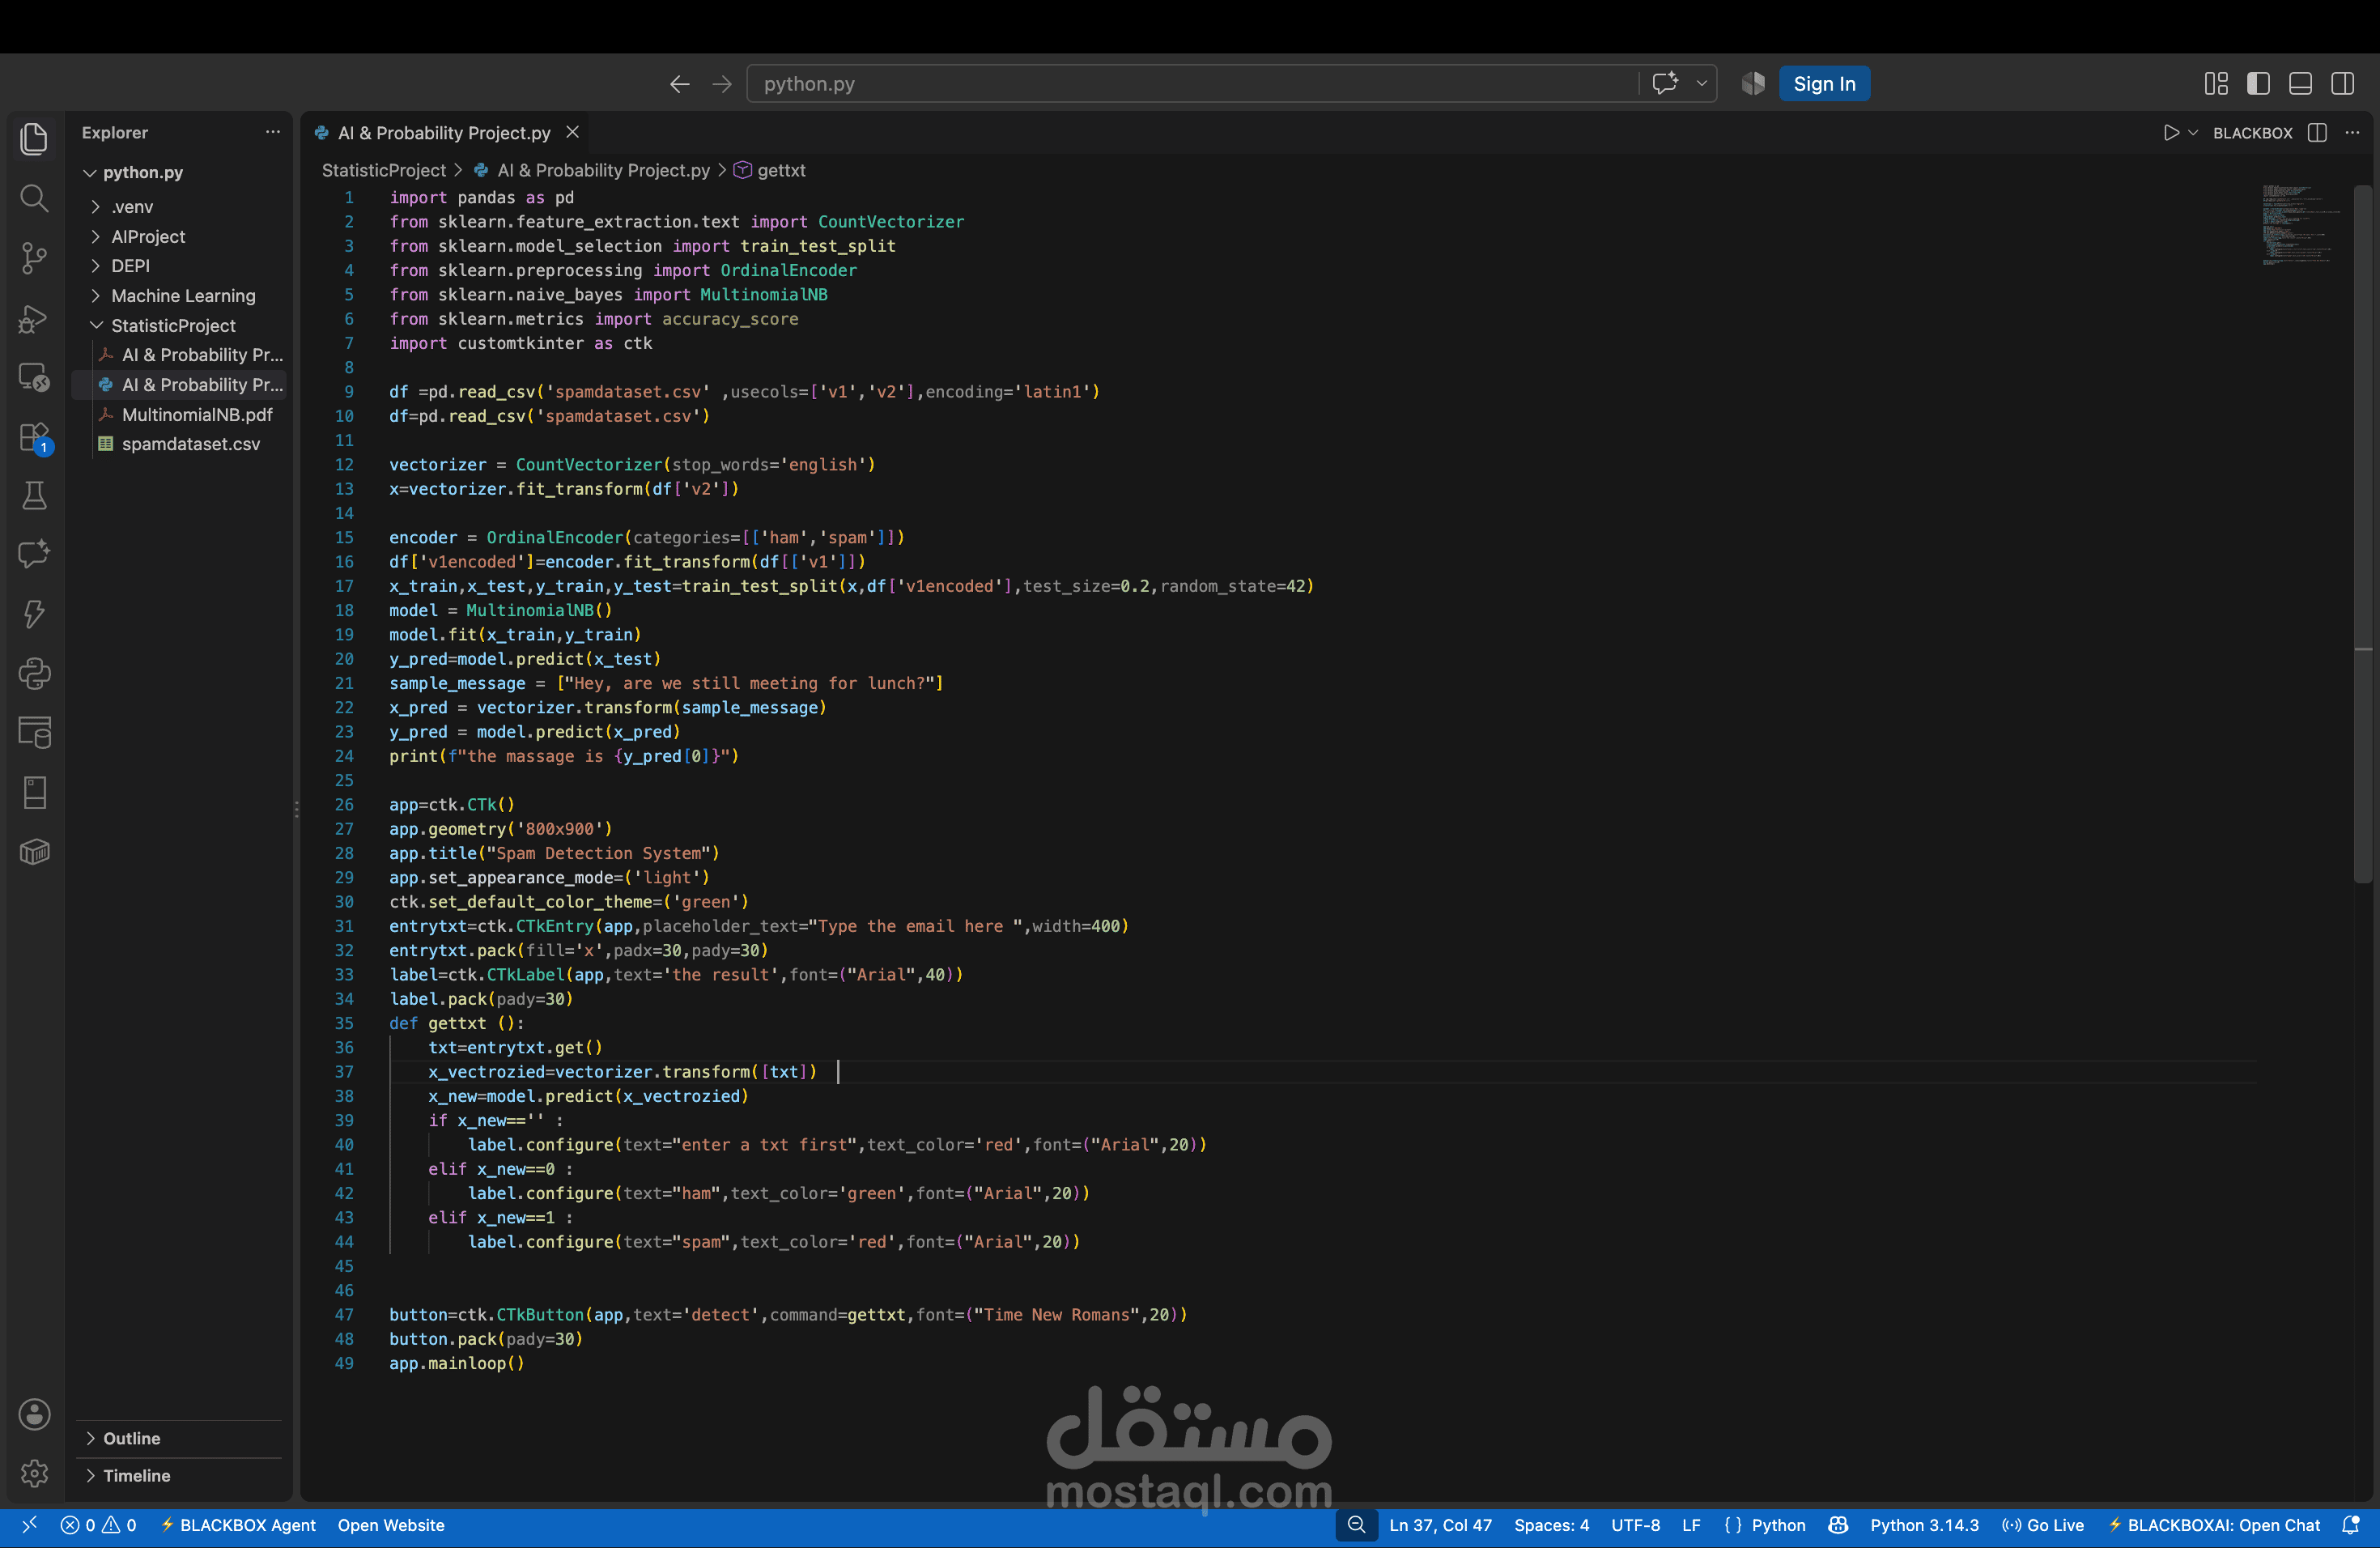
1. المكتبات المستخدمة (Imports)
pandas: لقراءة وتحليل بيانات الملفات (spamdataset.csv).
scikit-learn:
CountVectorizer: لتحويل النصوص إلى مصفوفة عداد كلمات (Vectorization) بعد استبعاد الكلمات الشائعة (stop_words='english').
OrdinalEncoder: لترميز التسميات النصية (مثل 'ham' و 'spam') إلى أرقام.
train_test_split: لتقسيم البيانات إلى مجموعة تدريب ومجموعة اختبار.
MultinomialNB: خوارزمية Naive Bayes المستخدمة في تصنيف النصوص والبريد العشوائي.
customtkinter: لإنشاء واجهة مستخدم رسومية حديثة تفاعلية.
2. معالجة البيانات وتدريب النموذج (Model Training Pipeline)
قراءة البيانات: يتم تحميل ملف الـ CSV وتحديد العمودين الأساسيين (v1 للتصنيف و v2 للنص).
معالجة النصوص: تحويل النصوص لتمثيل رقمي باستخدام CountVectorizer.
تدريب النموذج: تقسيم البيانات وتدريب نموذج MultinomialNB على بيانات التدريب.
اختبار سريع: تجربة النموذج على رسالة تجريبية من خلال الأوامر البرمجية وطباعة النتيجة.
3. واجهة المستخدم الرسومية (CustomTkinter GUI)
إعداد النافذة: إنشاء نافذة بعنوان "Spam Detection System" بمقاس
800×900
ومظهر فاتح (Light mode).
العناصر والواجهة:
مربع إدخال (CTkEntry): ليقوم المستخدم بكتابة أو لصق نص الرسالة.
زر إجرائي (CTkButton): باسم "detect" للتحقق من الرسالة، ومرتبط بالدالة gettxt.
عنصر عرض النص (CTkLabel): لعرض نتيجة الفحص.
الدالة التفاعلية (gettxt):
تأخذ النص المدخل من مربع النص.
تقوم بتحويله وتنفيذه عبر النموذج المدرب.
تعرض النتيجة بوضوح:
إذا كان الإدخال فارغاً: تظهر رسالة تنبيه باللون الأحمر.
إذا كانت الرسالة طبيعية (ham): تعرض النتيجة باللون الأخضر.
إذا كانت الرسالة عشوائية/ضارة (spam): تعرض النتيجة باللون الأحمر.