استخراج وتحليل بيانات 1,000 كتاب باستخدام Python وETL
تفاصيل العمل
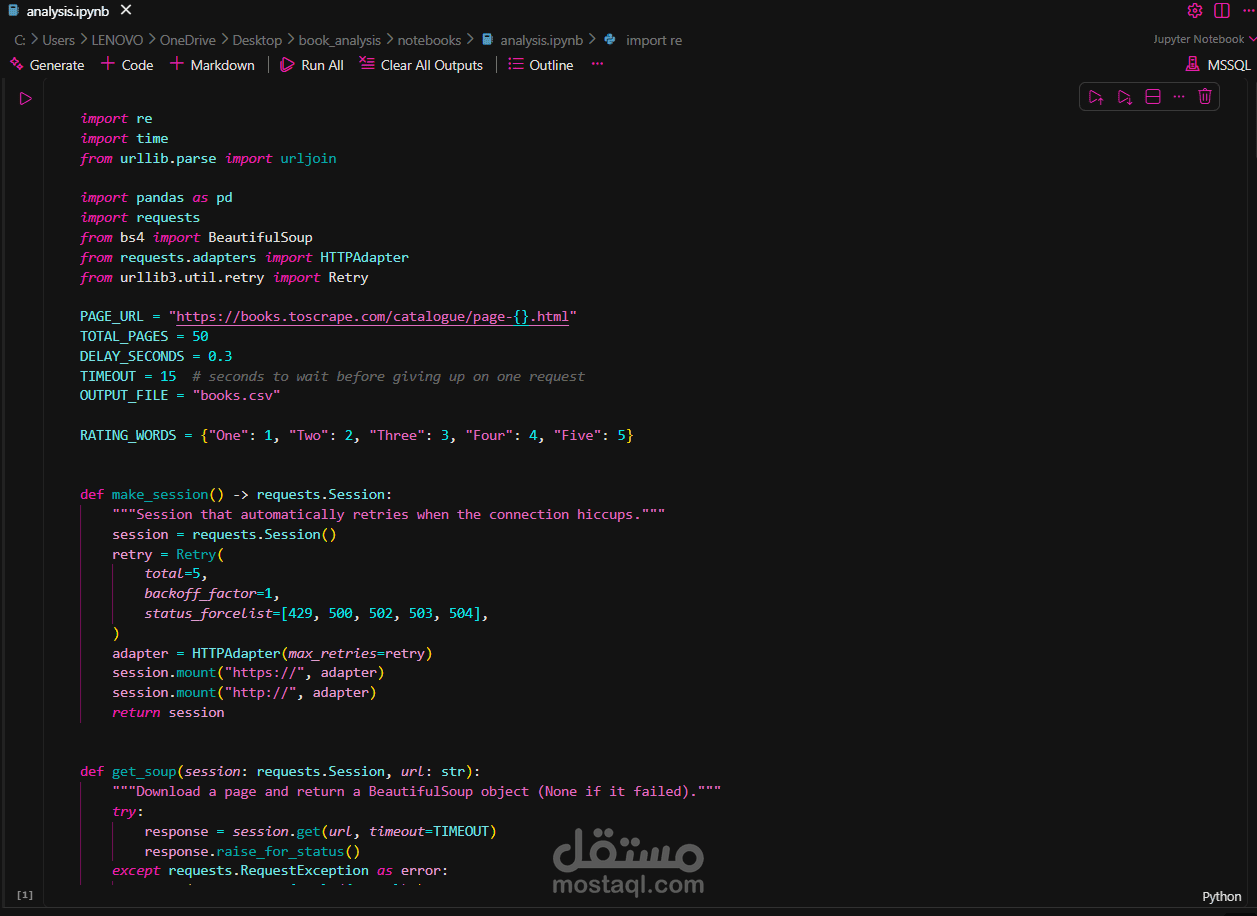
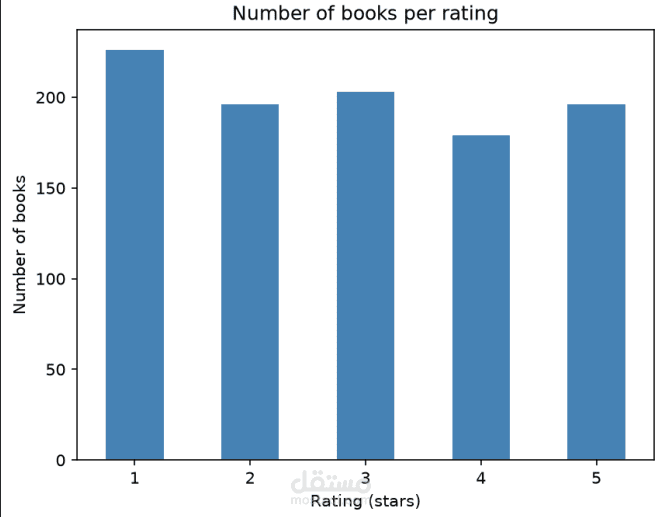
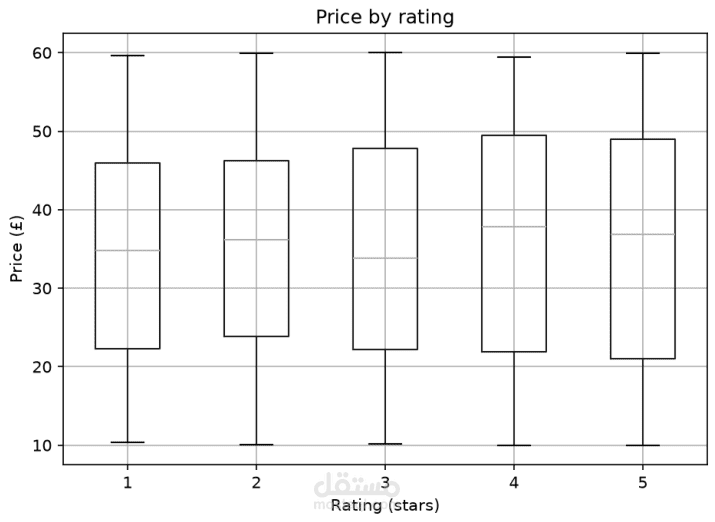
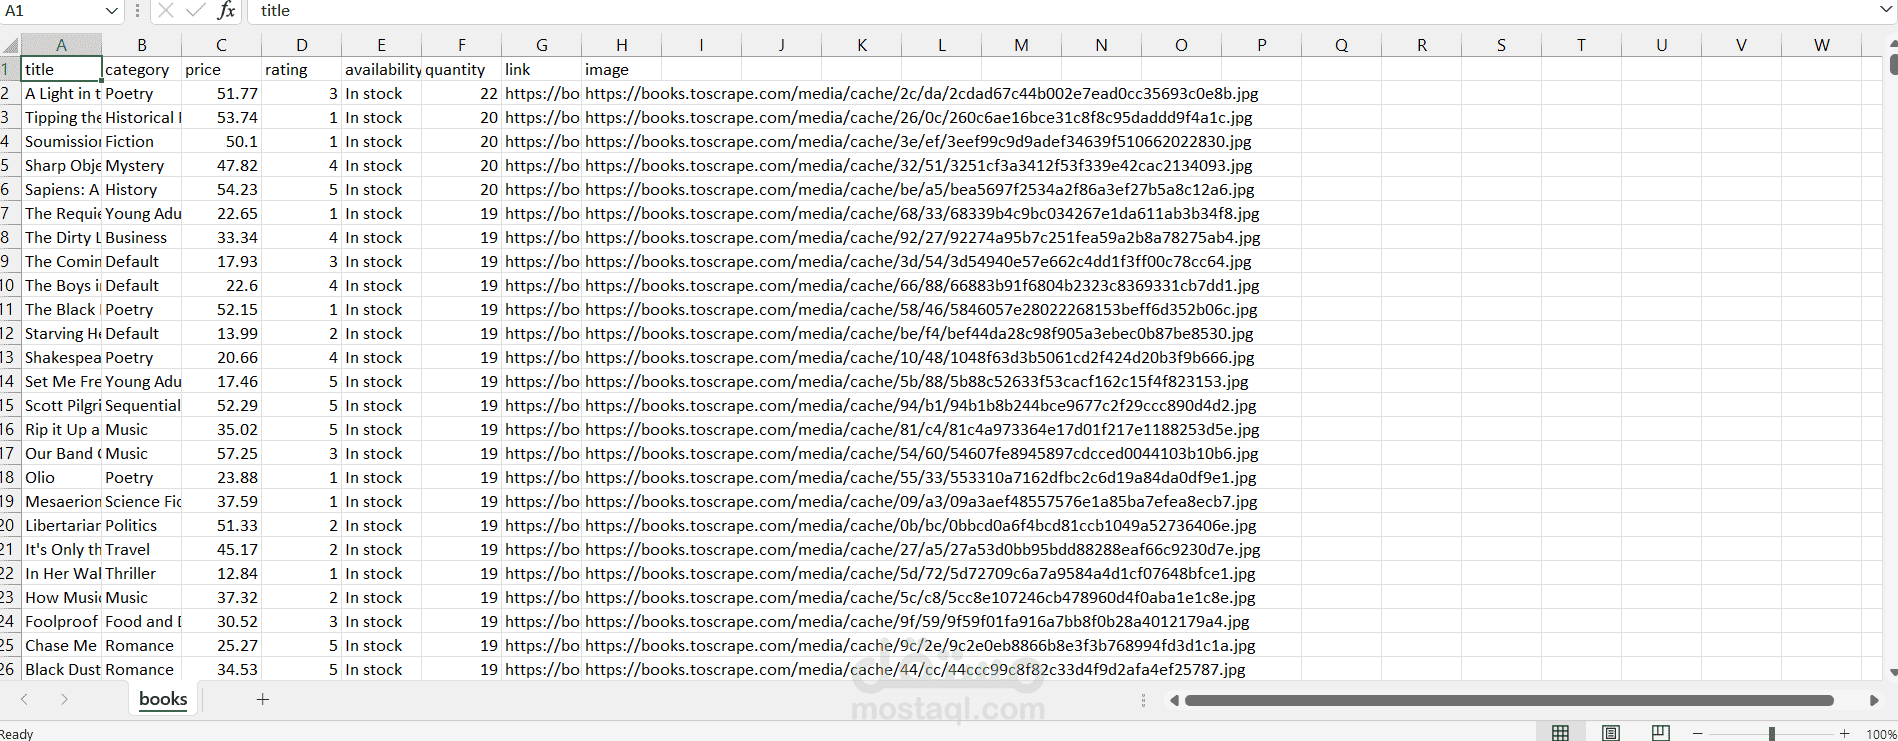
المشكلة: جمع بيانات عدد كبير من الكتب يدويًا يستغرق وقتًا طويلًا، كما أن البيانات تكون غير منظمة ويصعب تحليلها مباشرة.
الحل: بنيت Pipeline باستخدام Python لجمع بيانات 1,000 كتاب من 50 صفحة عبر Web Scraping باستخدام Requests وBeautifulSoup، ثم قمت بتنظيف وتحويل البيانات باستخدام Pandas وتجهيزها للتحليل.
النتيجة: تم إنشاء Dataset منظمة تحتوي على بيانات مثل اسم الكتاب، التصنيف، السعر، التقييم، التوفر والكمية، مع تحليل البيانات واستخراج Insights باستخدام Pandas وMatplotlib وSeaborn.