تنظيف ومعالجة بيانات العقارات باستخدام Python
تفاصيل العمل
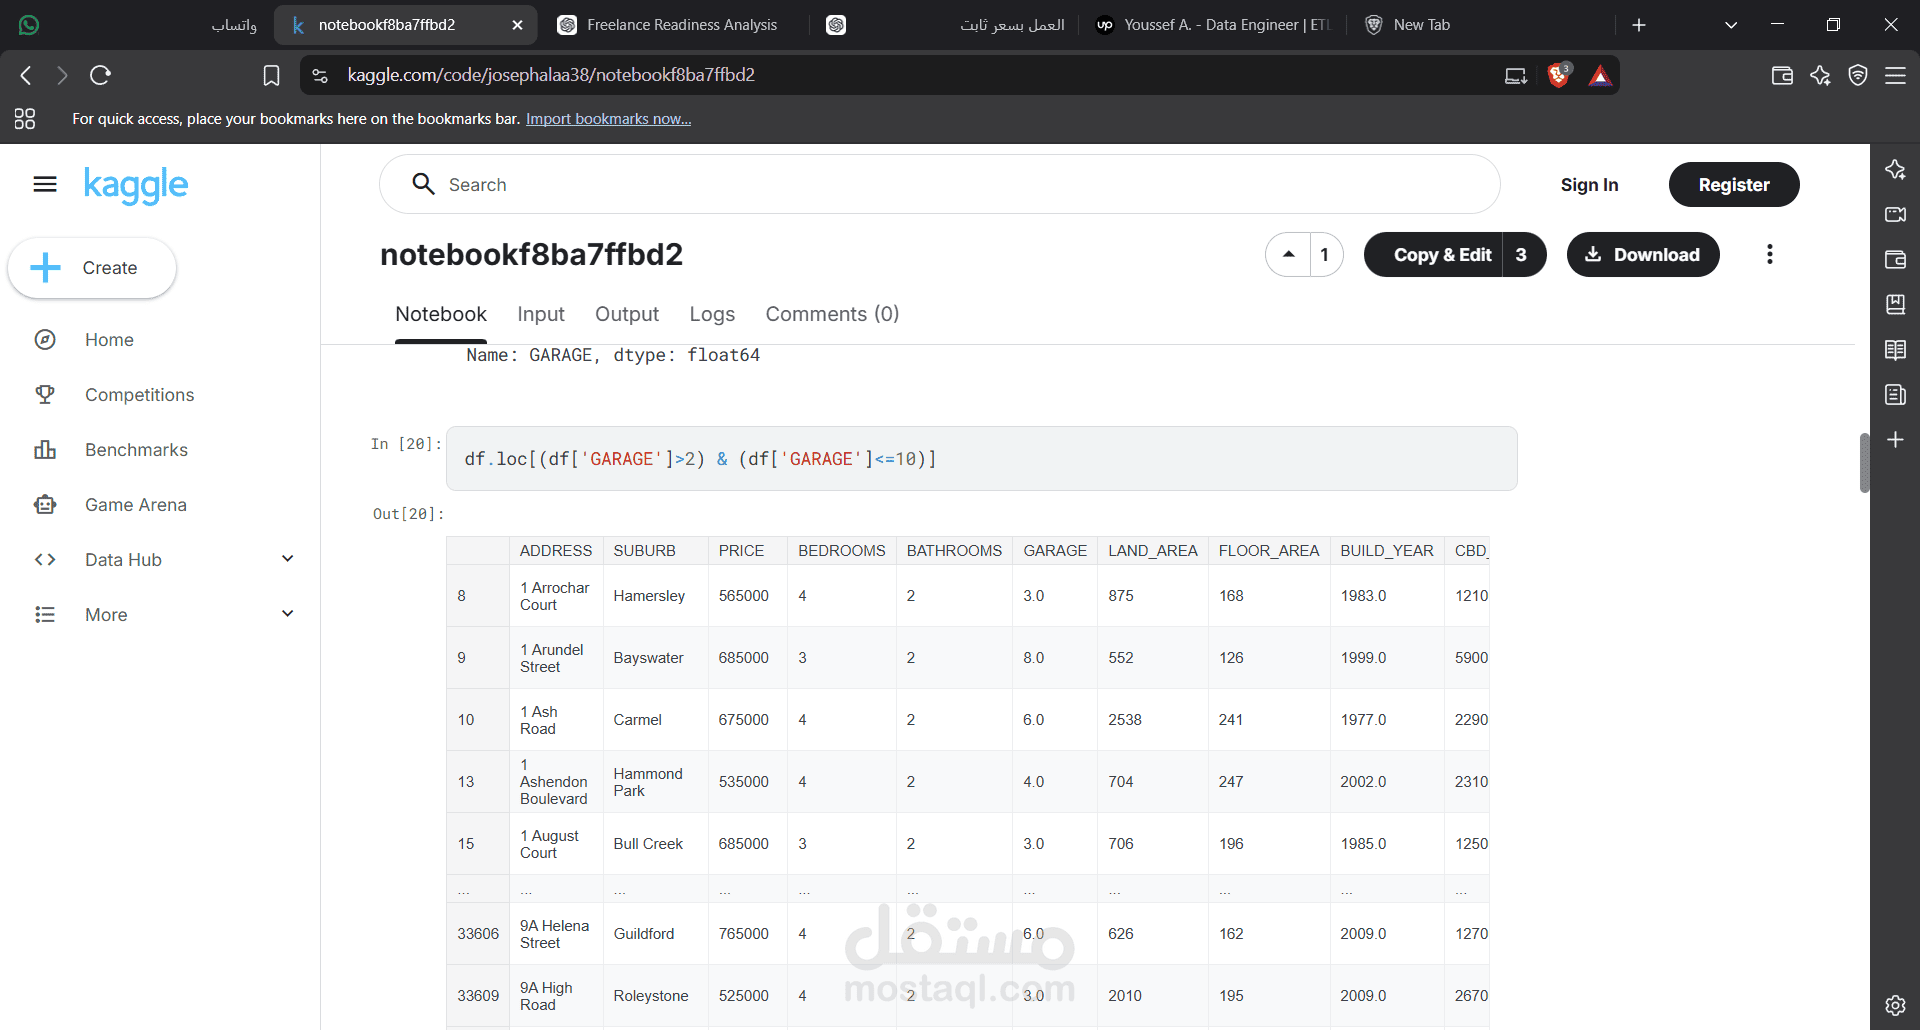
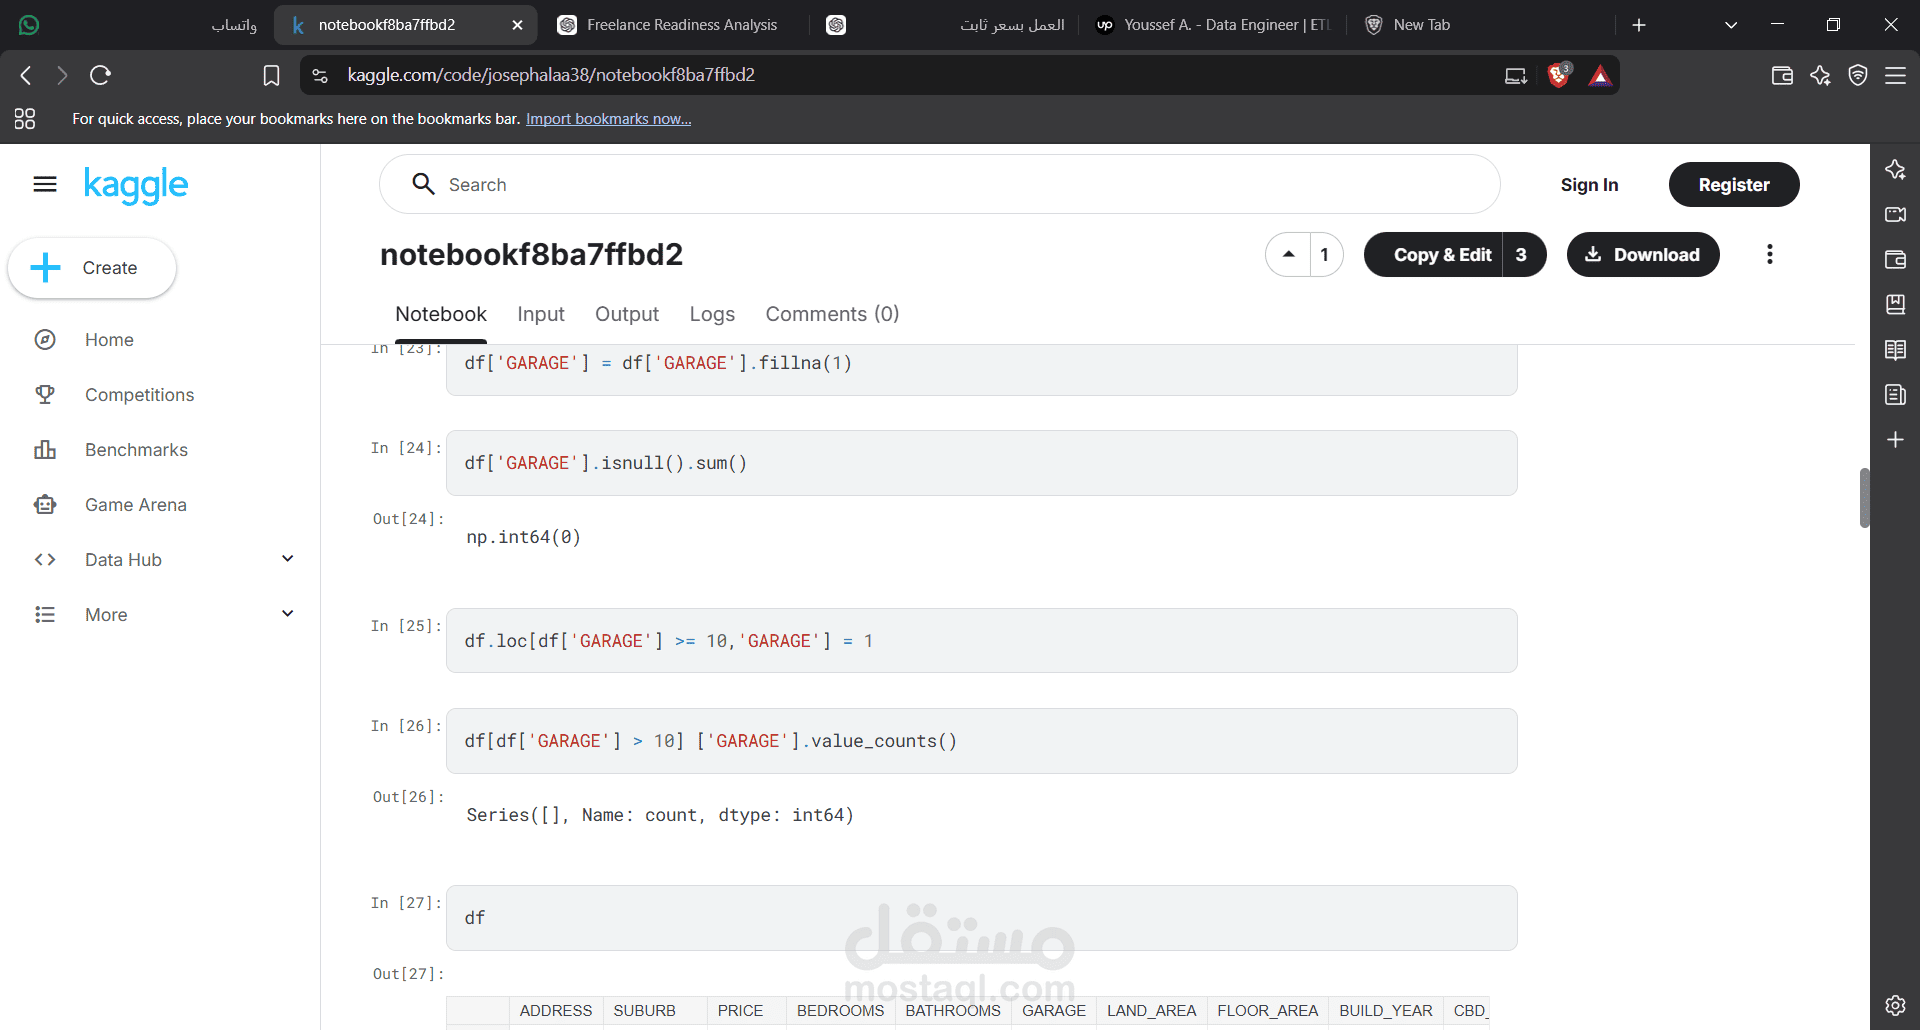
تنظيف ومعالجة بيانات العقارات باستخدام Python
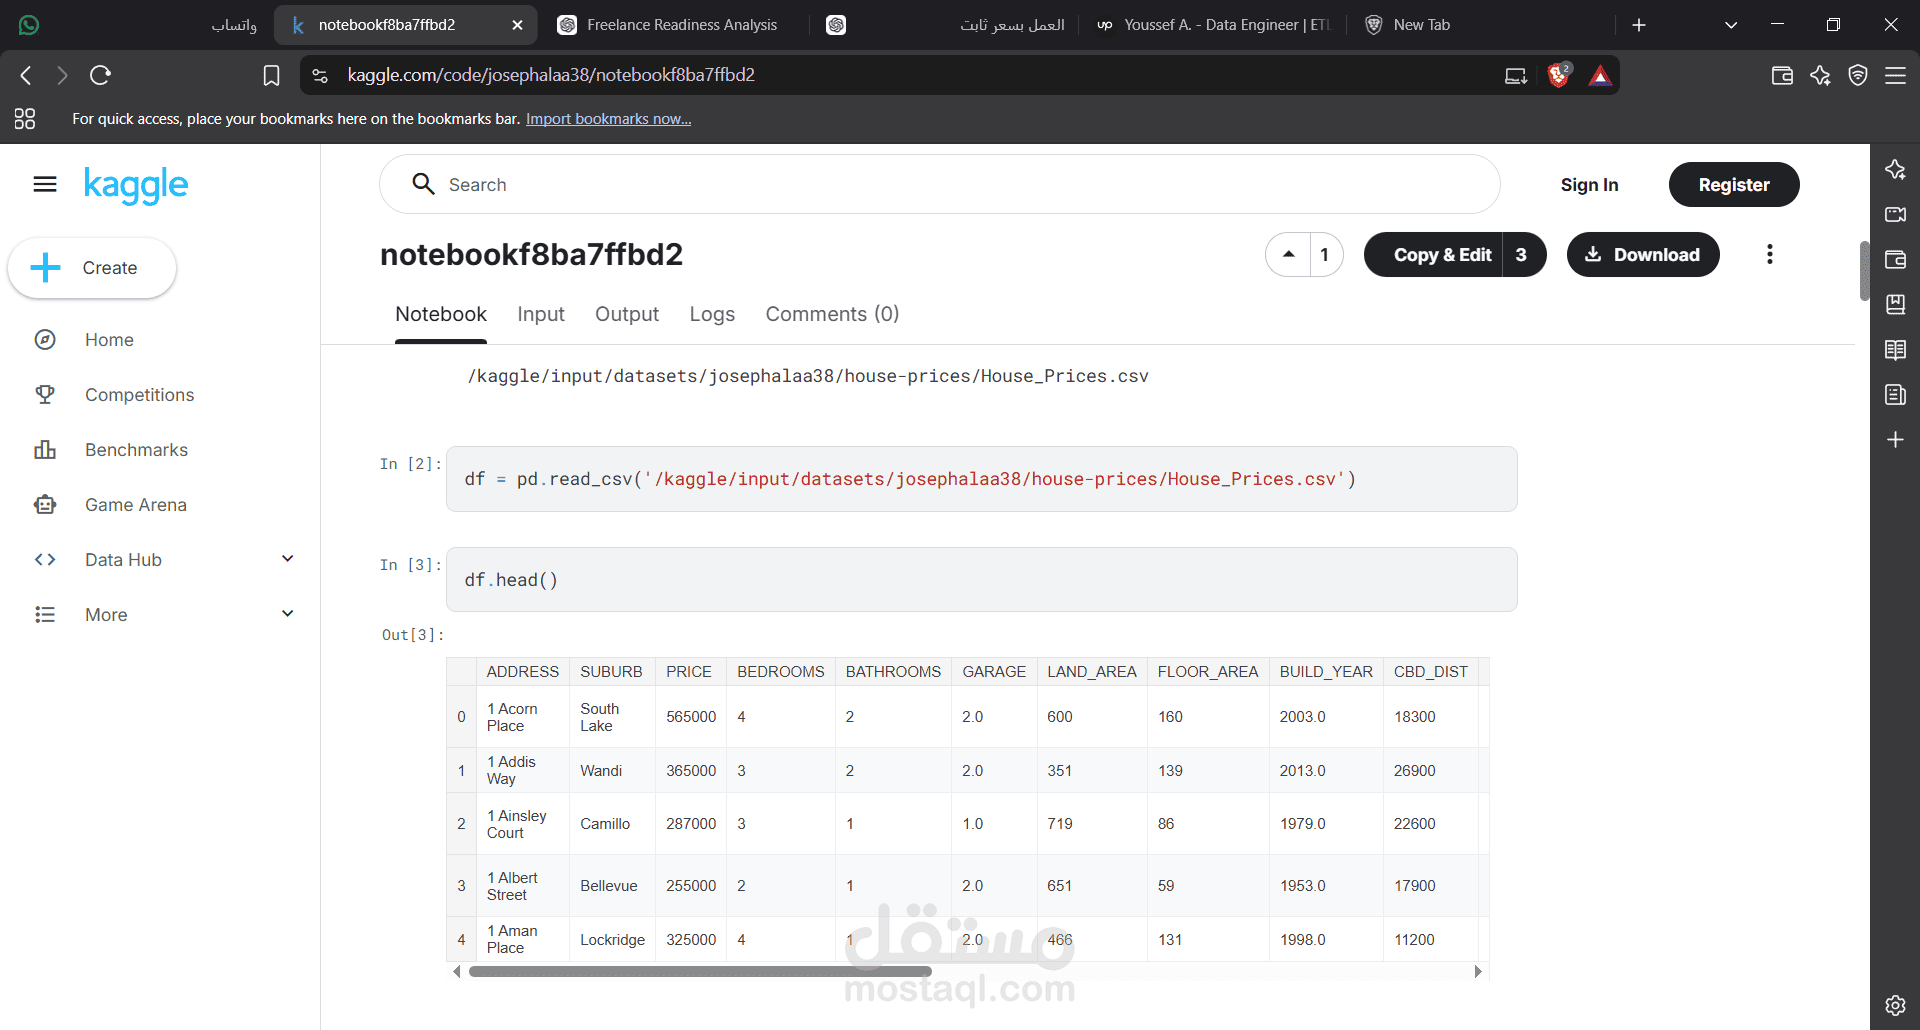
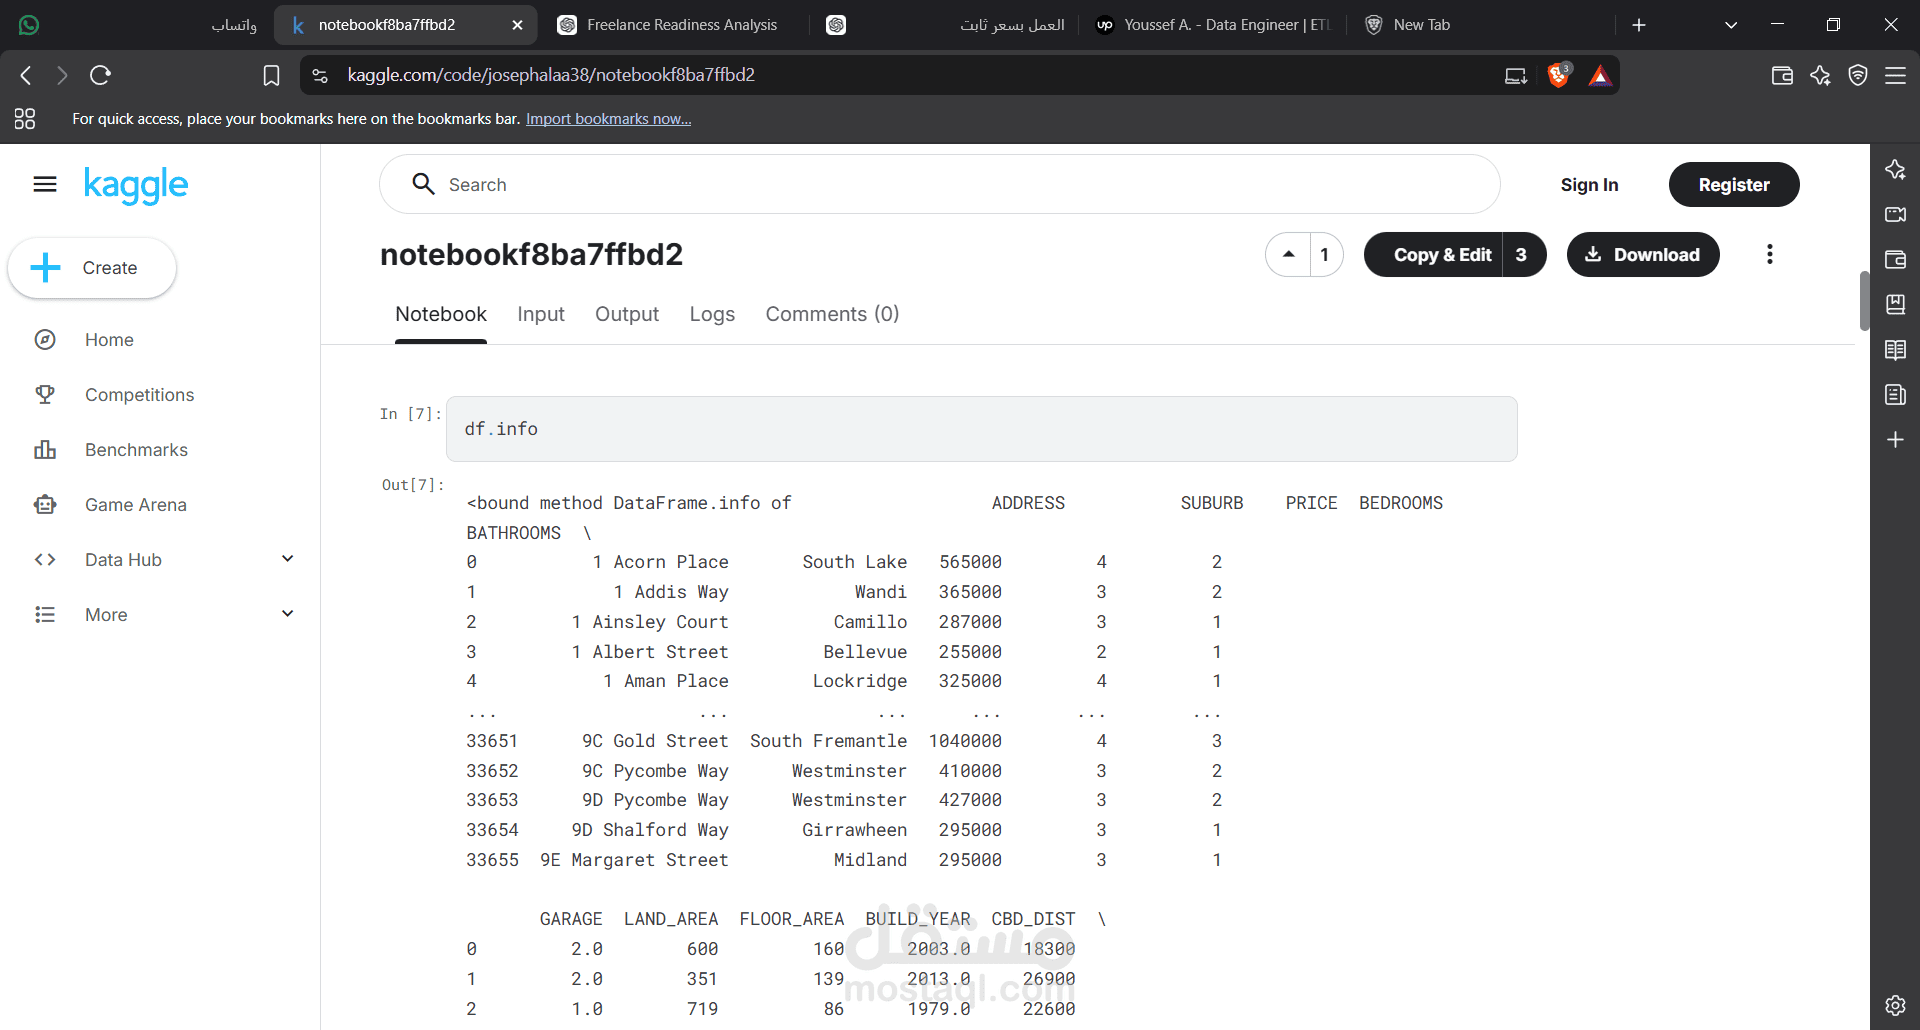
في هذا المشروع تم العمل على مجموعة بيانات عقارية كبيرة تحتوي على أكثر من 33,000 سجل، بهدف تحسين جودة البيانات وتجهيزها لتكون قابلة للاستخدام في التحليل وبناء نماذج تعلم الآلة.
تم تنفيذ عملية **Data Cleaning & Data Validation بشكل منهجي باستخدام Python وPandas وNumPy داخل بيئة Jupyter Notebook، مع التركيز على اكتشاف مشكلات جودة البيانات ومعالجتها مع الحفاظ على أكبر قدر ممكن من البيانات المفيدة.
ما تم تنفيذه في المشروع:
1. معالجة القيم المفقودة (Missing Values
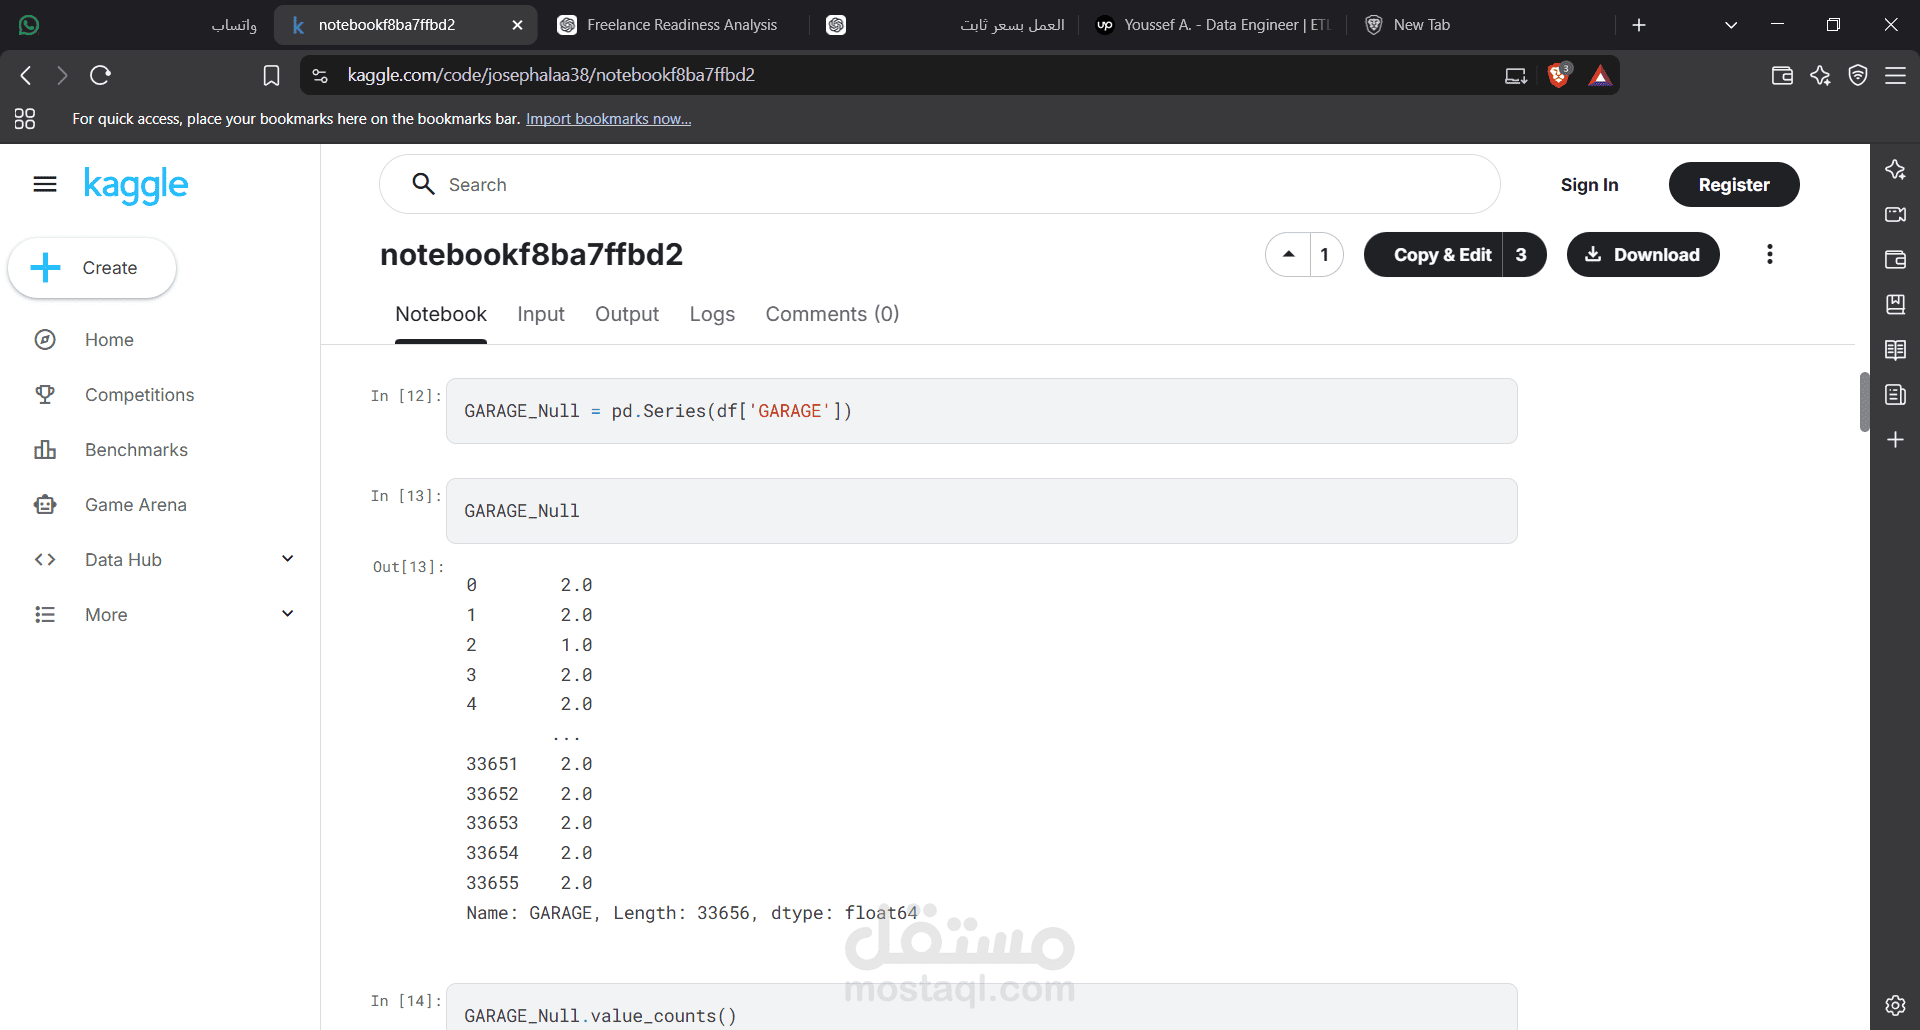
تم فحص جميع أعمدة البيانات لتحديد القيم المفقودة وتحليل نمط ونسبة النقص في كل عمود. بعد ذلك تم اختيار استراتيجية المعالجة المناسبة لكل حقل، سواء من خلال تعويض القيم المفقودة أو حذف السجلات عند الحاجة، بهدف الحفاظ على جودة البيانات وتقليل فقدان السجلات.
2. اكتشاف ومعالجة القيم الشاذة (Outlier Detection)
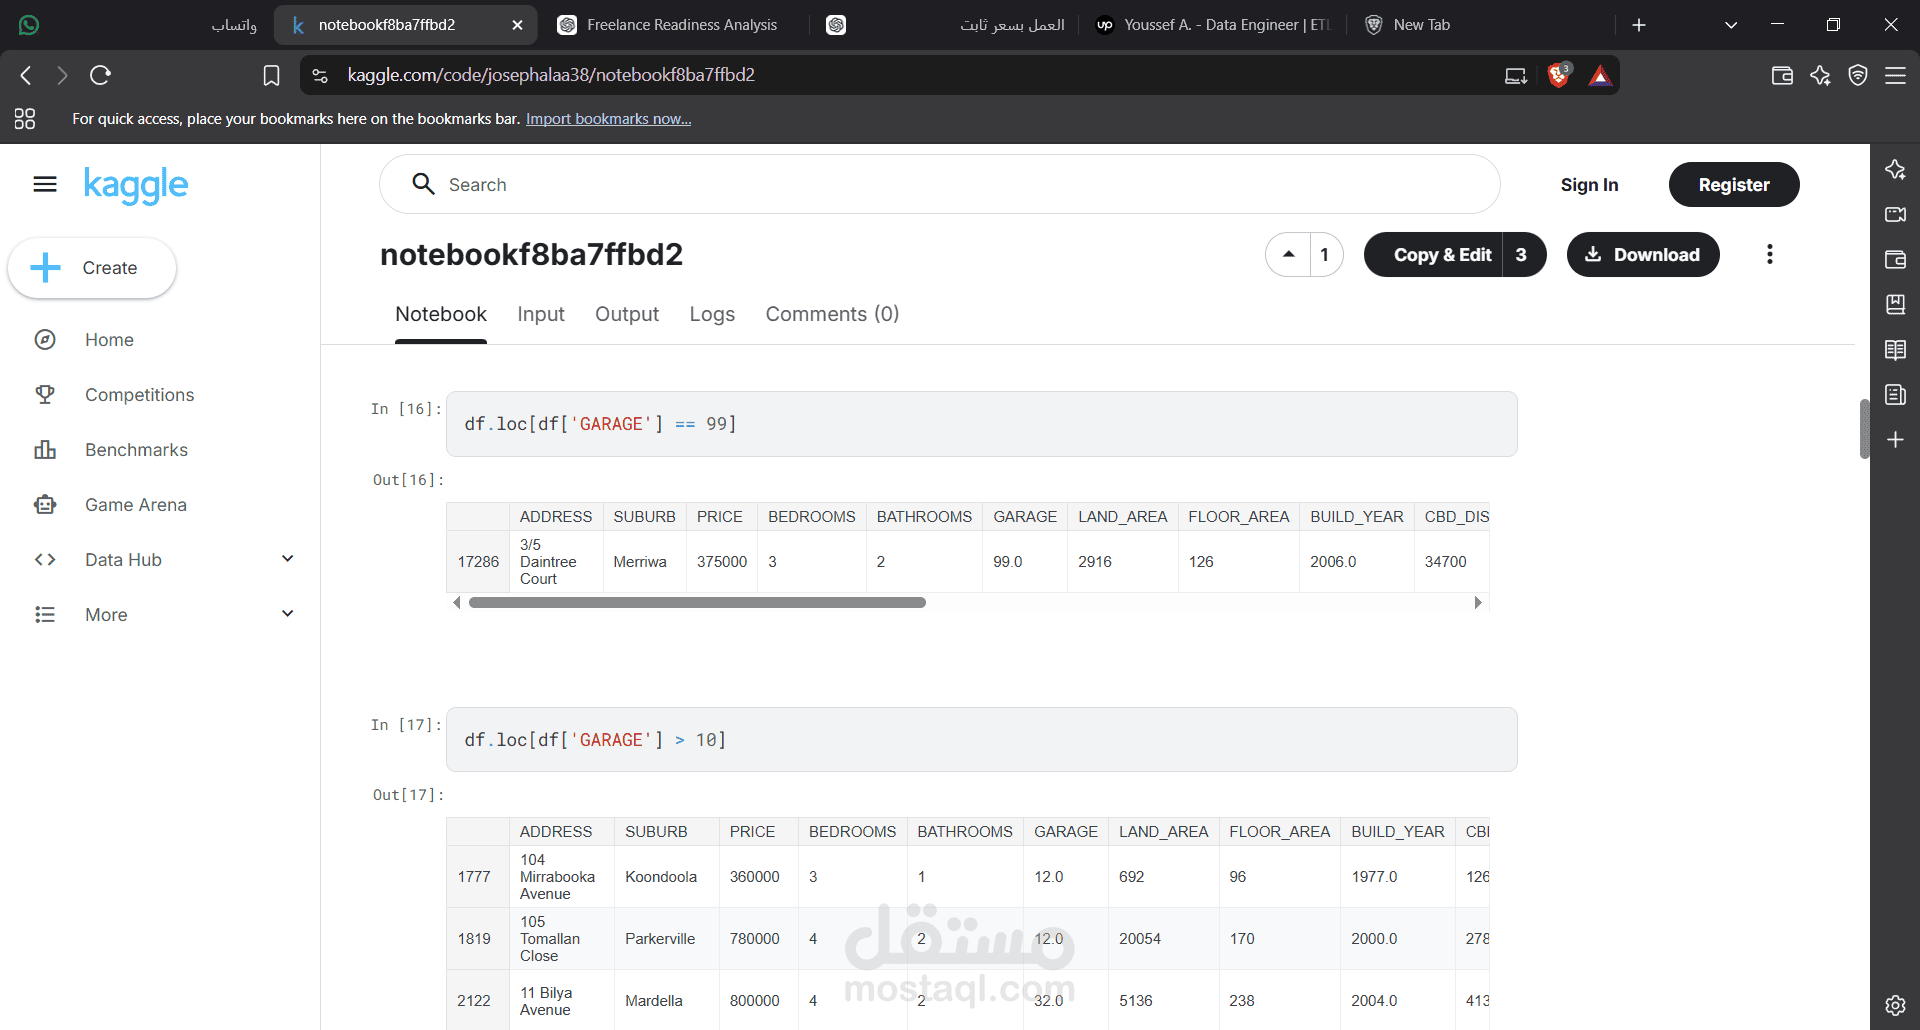
تم تحليل توزيع الأعمدة الرقمية واكتشاف القيم التي تقع خارج النطاقات المتوقعة. كما تم التحقق من القيم الشاذة لتحديد ما إذا كانت تمثل أخطاء في البيانات أو حالات حقيقية، ثم التعامل معها باستخدام أساليب مناسبة لتجنب تأثيرها السلبي على نتائج التحليل.
3. تحويل أنواع البيانات (Data Type Conversion)
تم التأكد من أن كل عمود يستخدم نوع البيانات المناسب لطبيعته، بما في ذلك تحويل الحقول الرقمية إلى `Integer` أو `Float`، والتعامل مع البيانات النصية والتصنيفية، مما يساعد على إجراء العمليات الحسابية والتحليلية بشكل صحيح.
4. توحيد تنسيق التواريخ (Date Standardization)
تم توحيد حقول التاريخ من خلال تحويل صيغ التاريخ المختلفة إلى تنسيق `Datetime` موحد، مما يسهل عمليات الفرز والتصفية والتحليل الزمني ويضمن التعامل الصحيح مع البيانات المرتبطة بالتاريخ.
الأدوات والتقنيات المستخدمة
Python
Pandas
NumPy
Jupyter Notebook
Data Cleaning
Data Validation
Missing Values Handling
Outlier Detection
Data Type Conversion
Date Standardization
النتيجة النهائية
تم تحويل Dataset كبيرة وغير جاهزة للتحليل إلى بيانات أكثر تنظيمًا واتساقًا وجودة، مع معالجة أهم مشكلات جودة البيانات وتجهيزها لتكون أساسًا مناسبًا لعمليات Data Analysis وMachine Learning Modeling.
Workflow
`Raw Dataset → Data Quality Assessment → Missing Values → Outlier Detection → Data Type Conversion → Date Standardization → Clean Dataset`