استخراج البيانات من موقع IMDB
تفاصيل العمل
استخراج وتنظيف بيانات أفضل 250 فيلمًا من IMDb
في هذا المشروع قمت بتطوير عملية **Web Scraping واستخراج بيانات الأفلام من IMDb** بهدف جمع وتنظيم بيانات قائمة أفضل 250 فيلمًا وتحويلها من بيانات غير منظمة على الويب إلى Dataset منظمة وقابلة للتحليل والاستخدام في مشاريع Data Analysis وData Engineering.
ما تم تنفيذه في المشروع
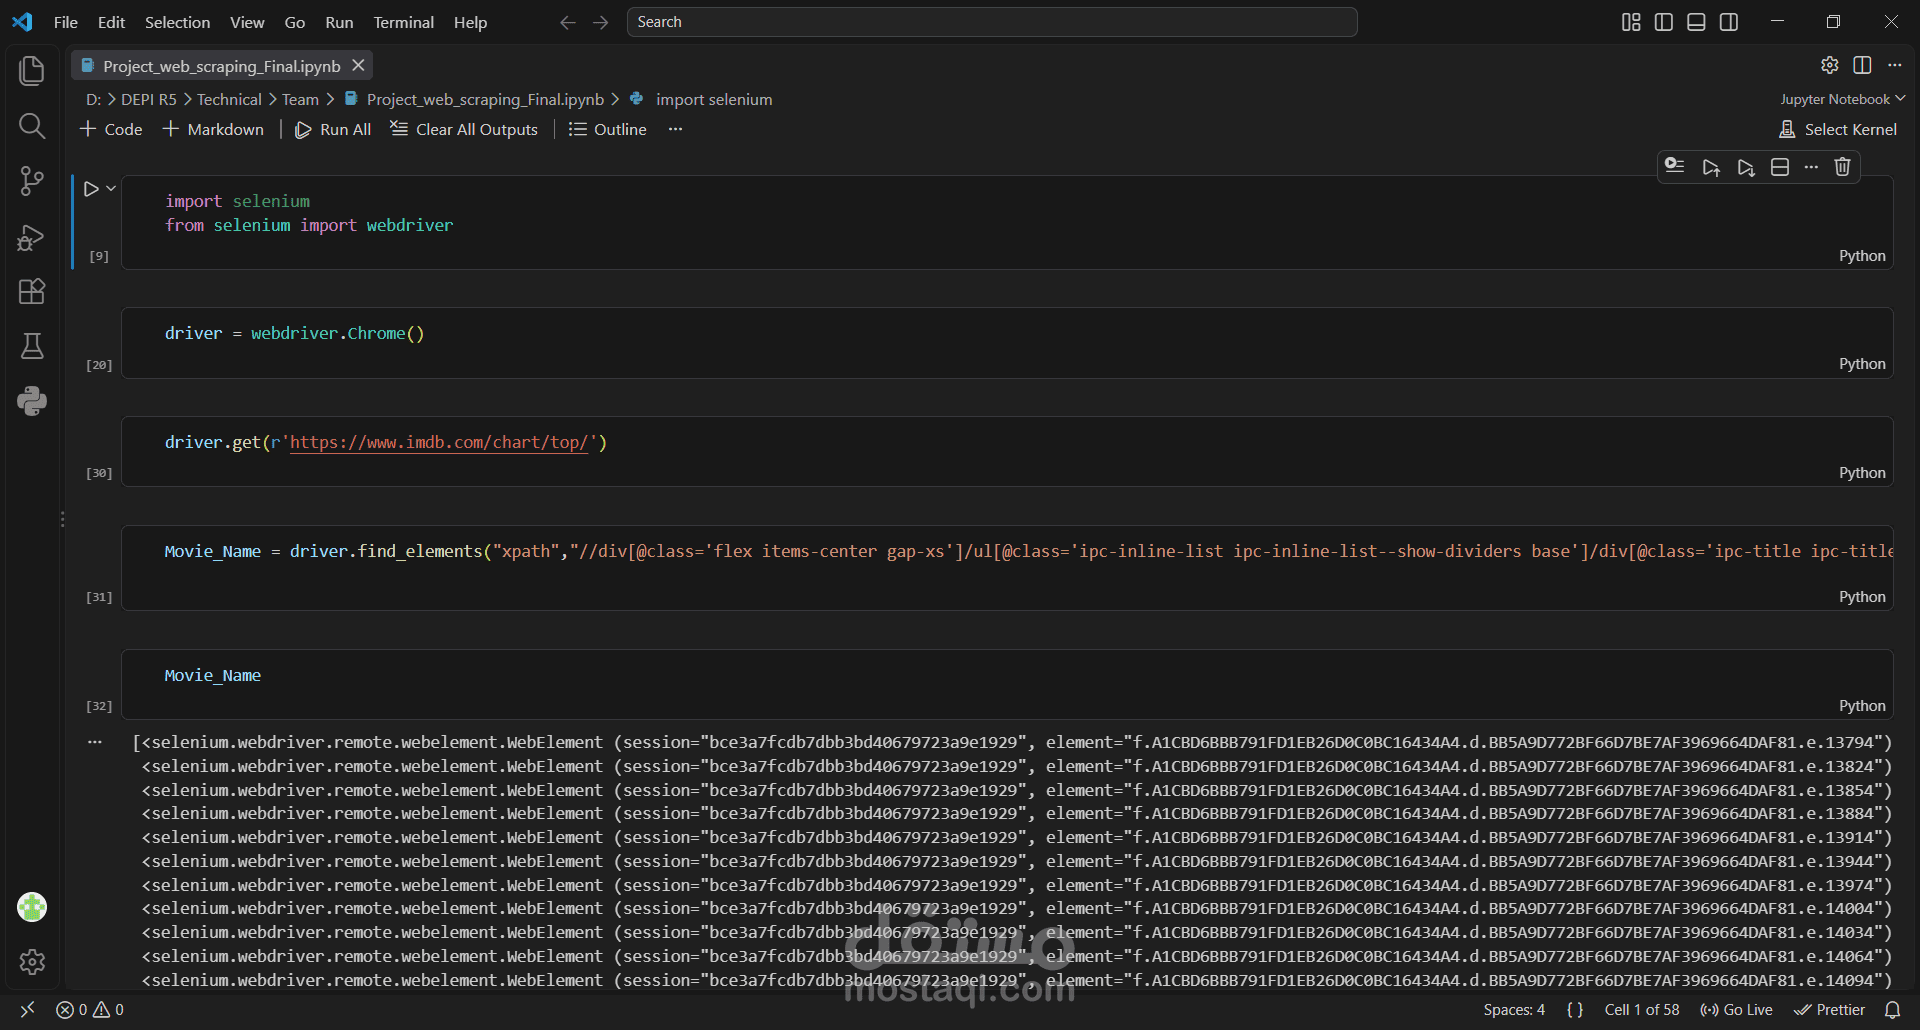
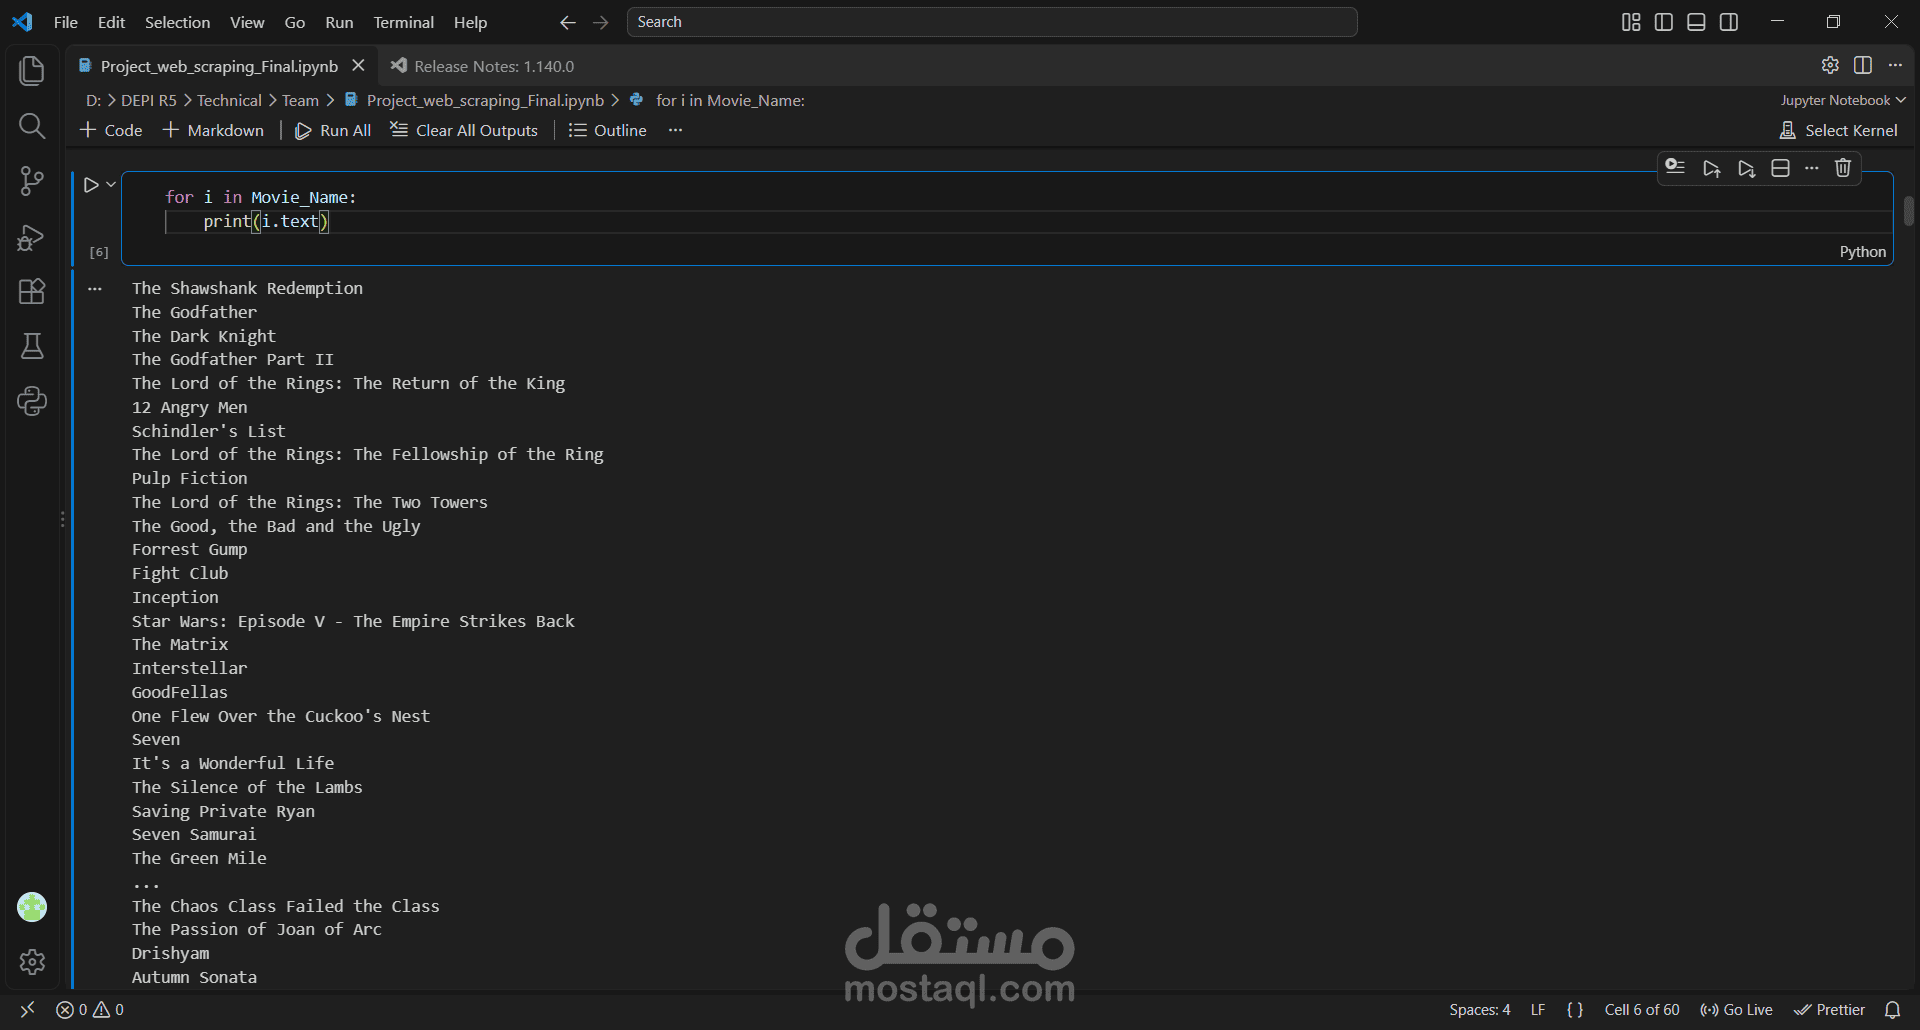
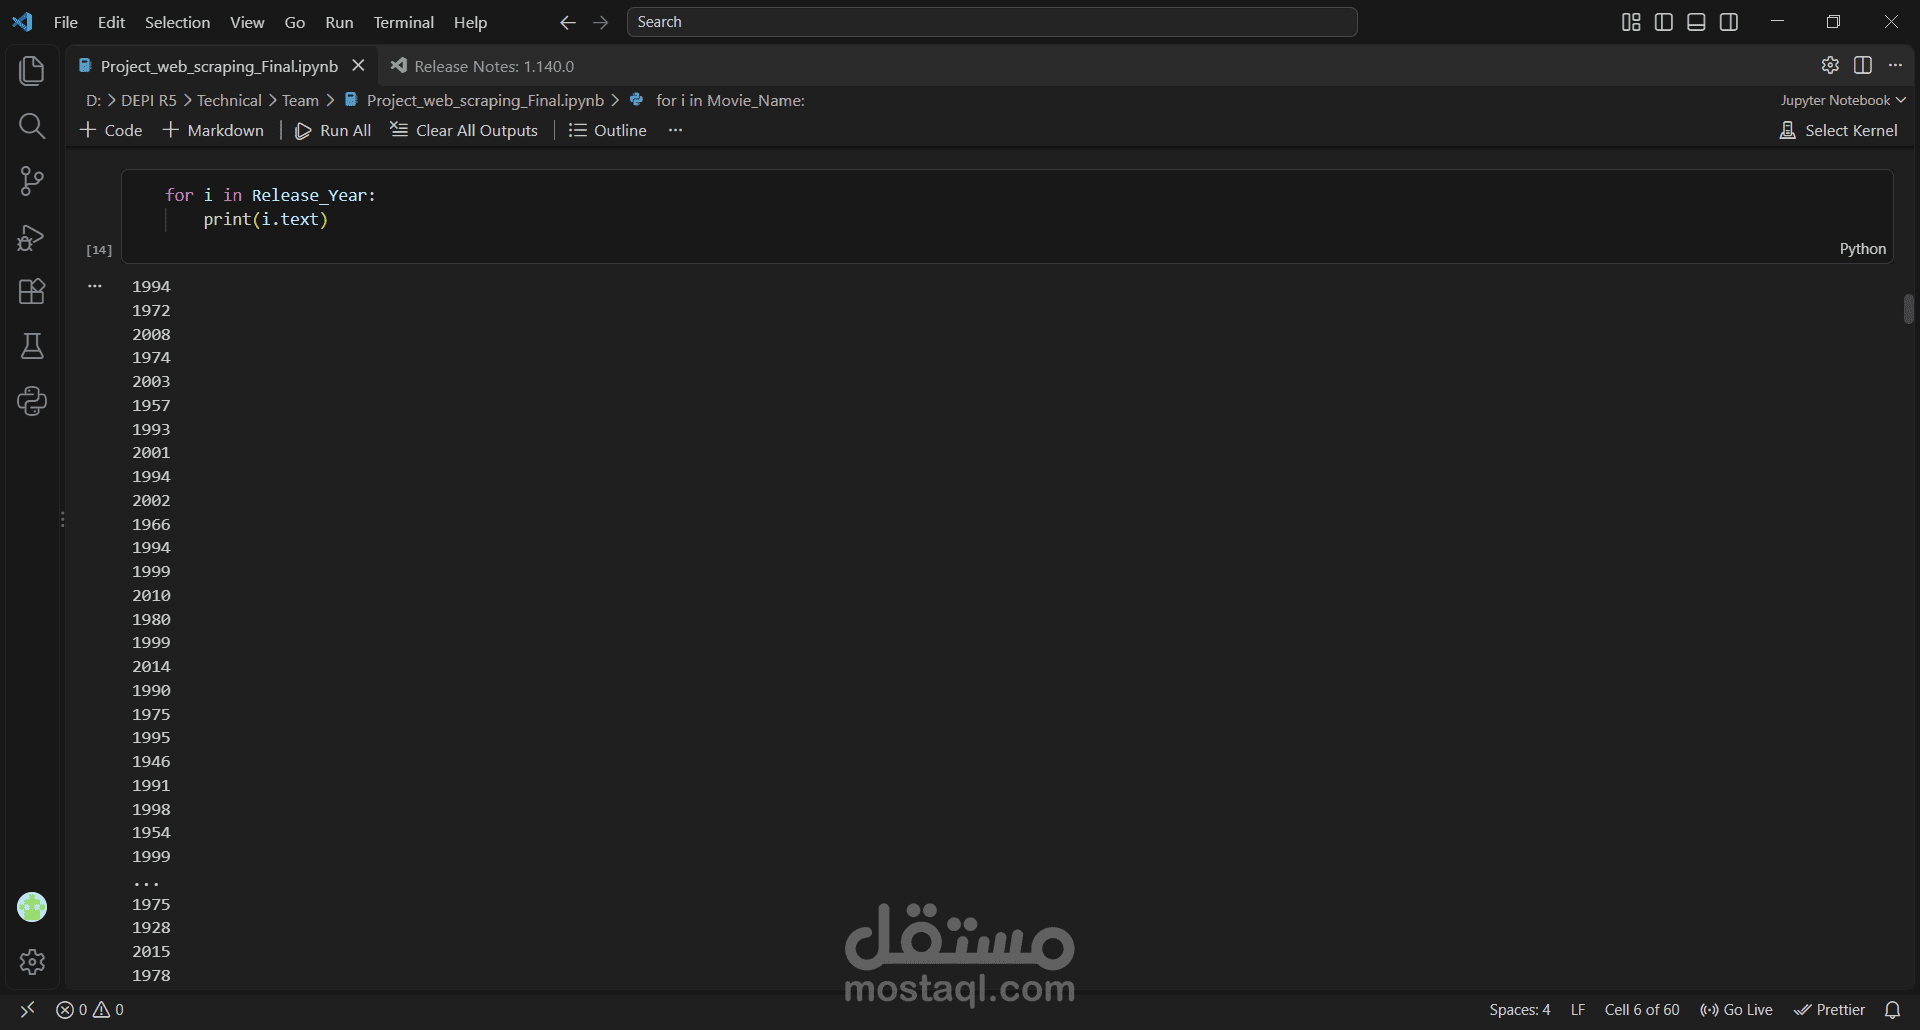
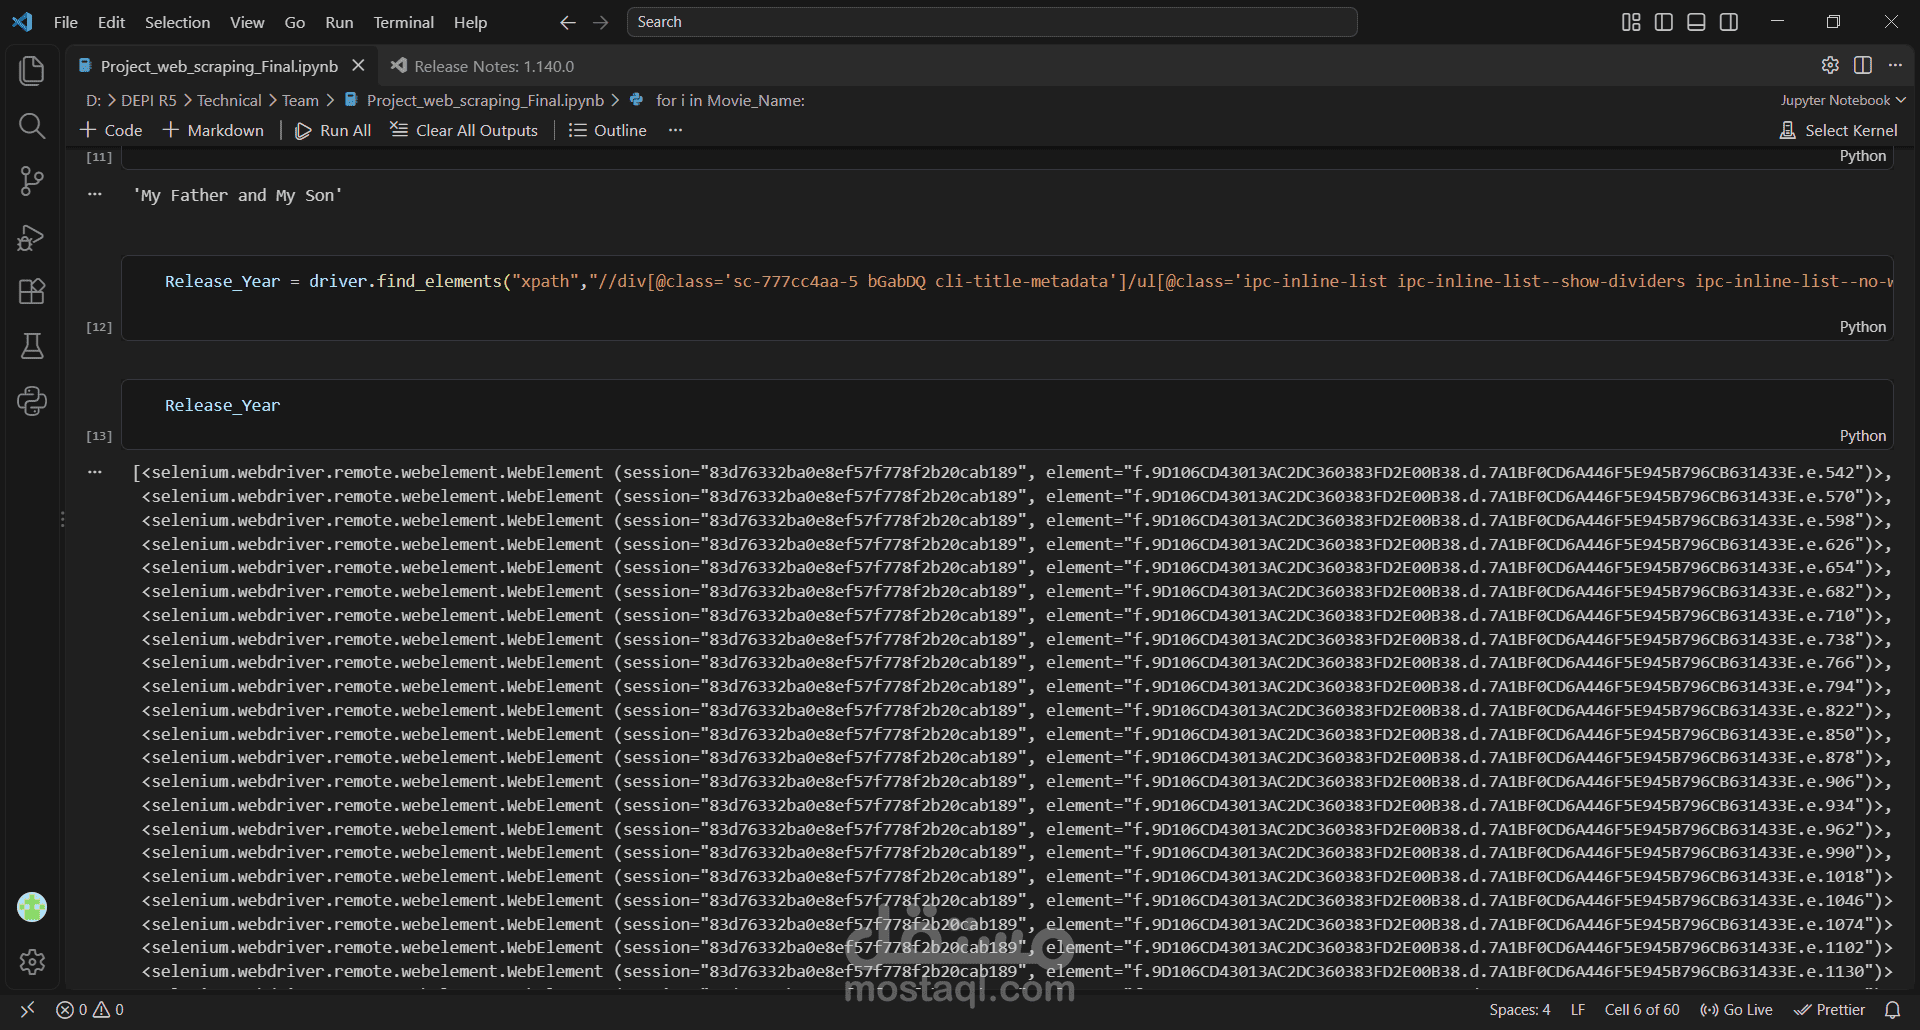
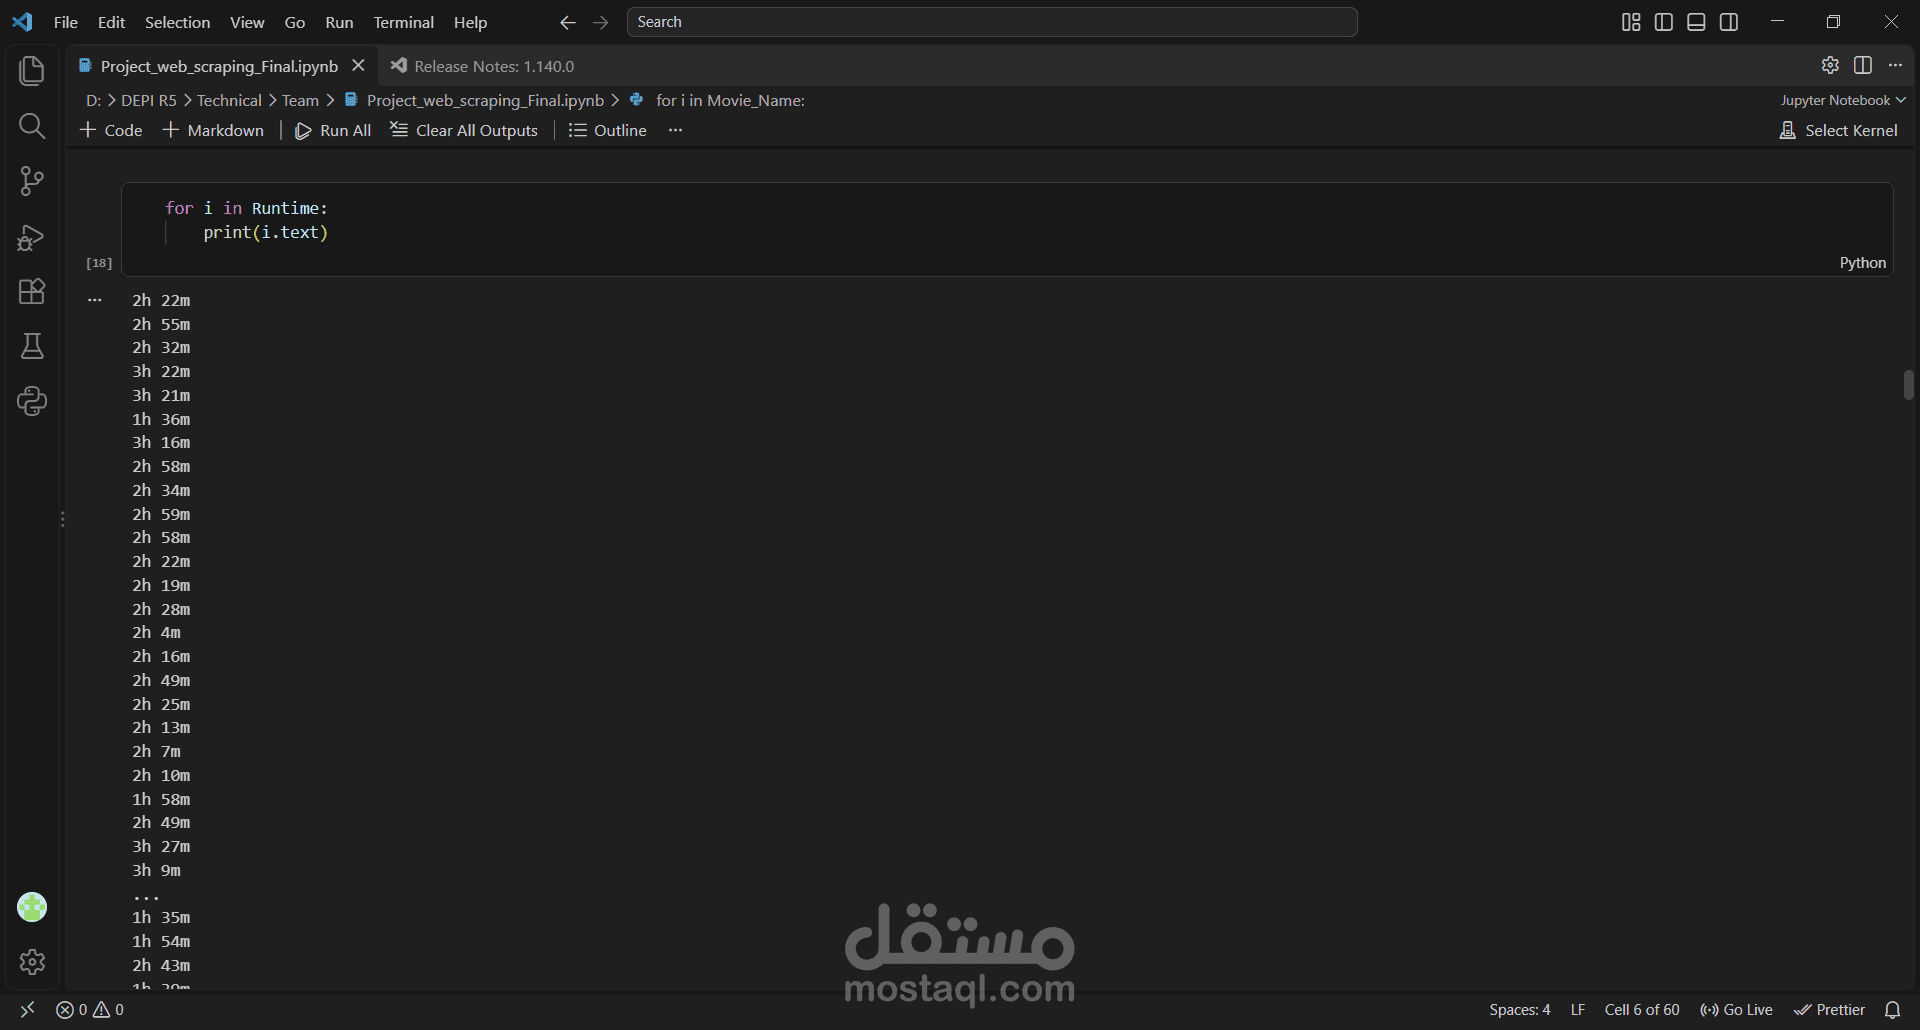
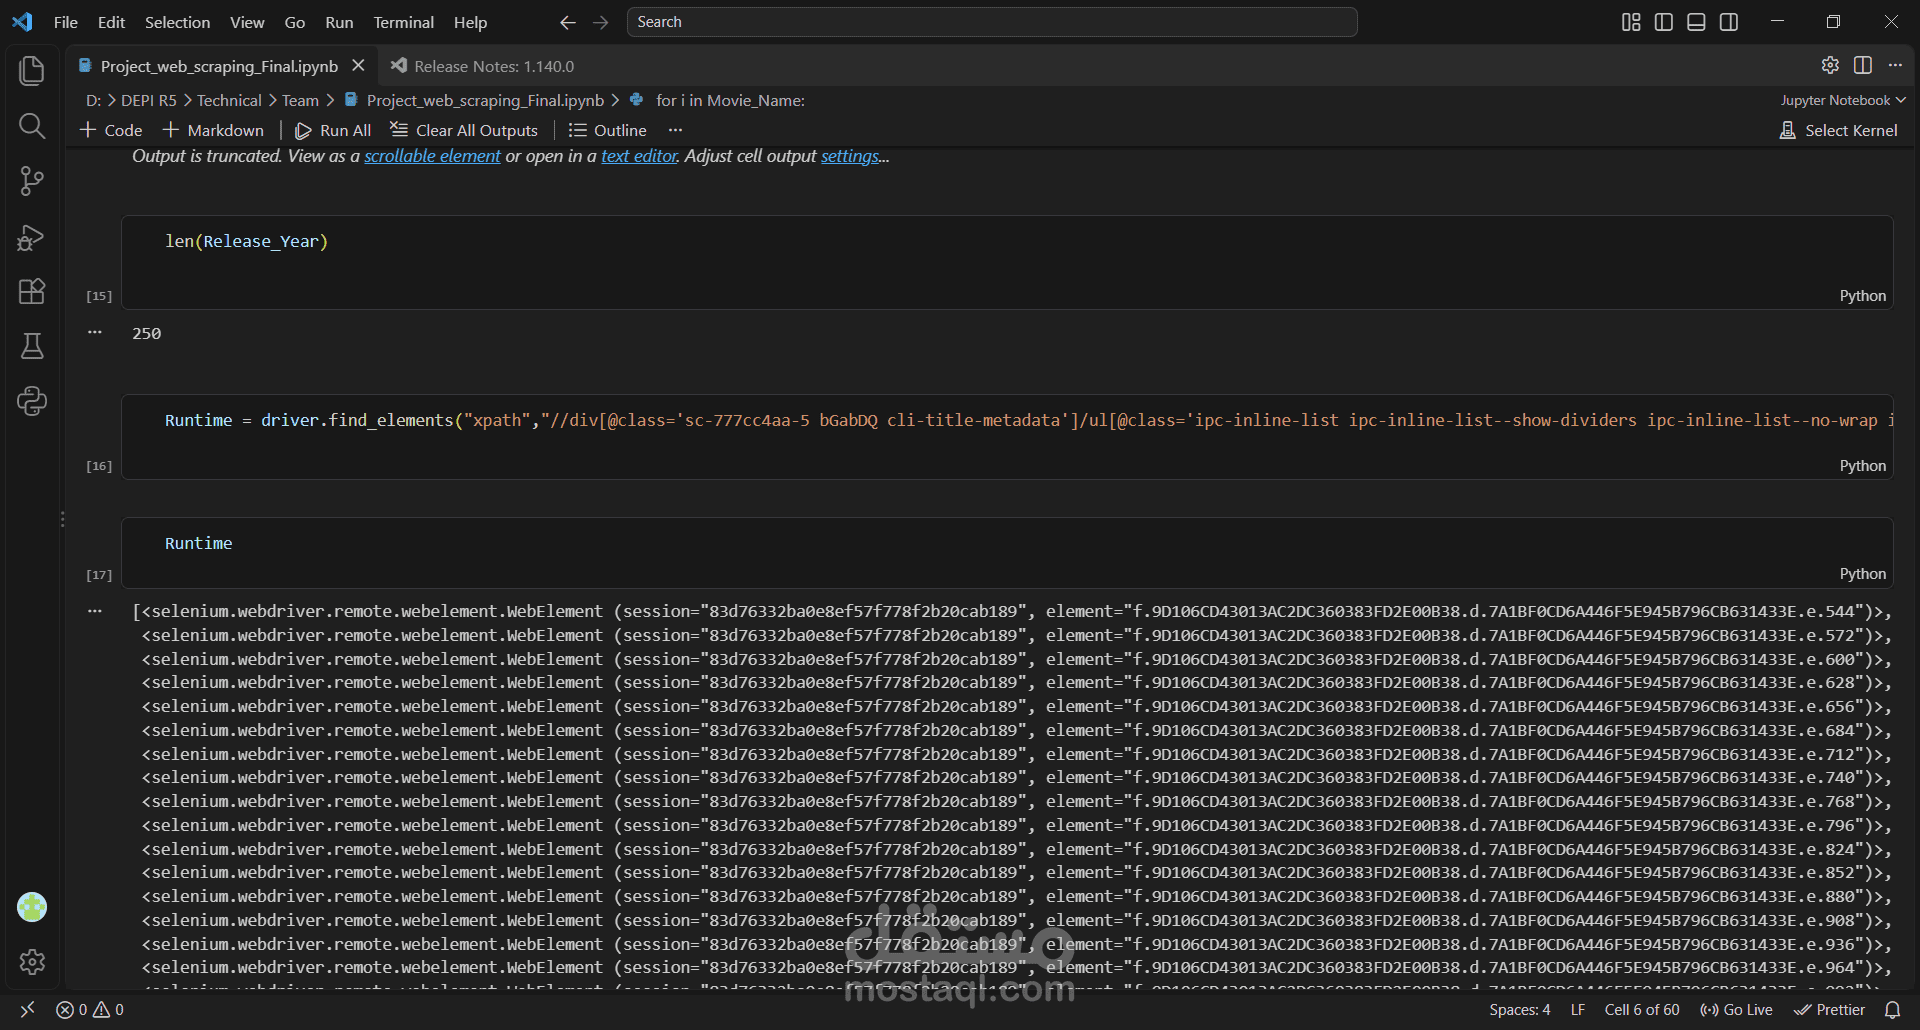
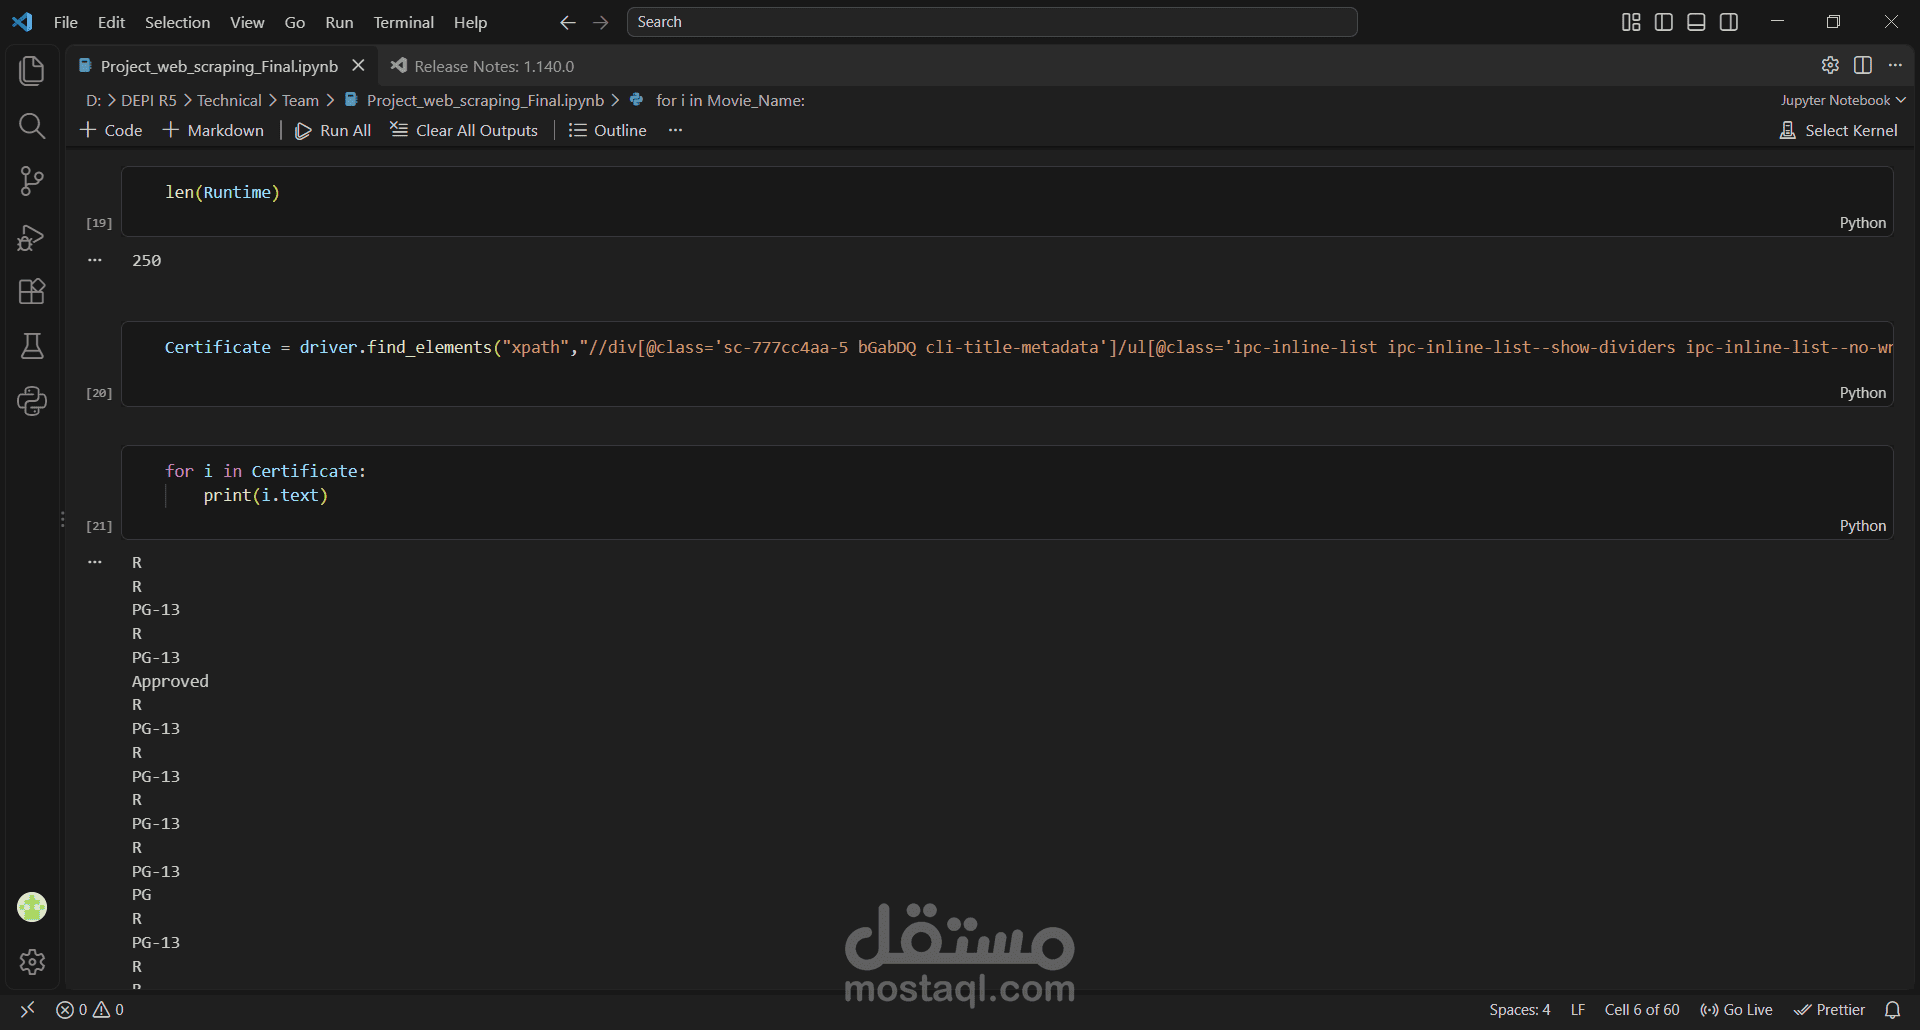
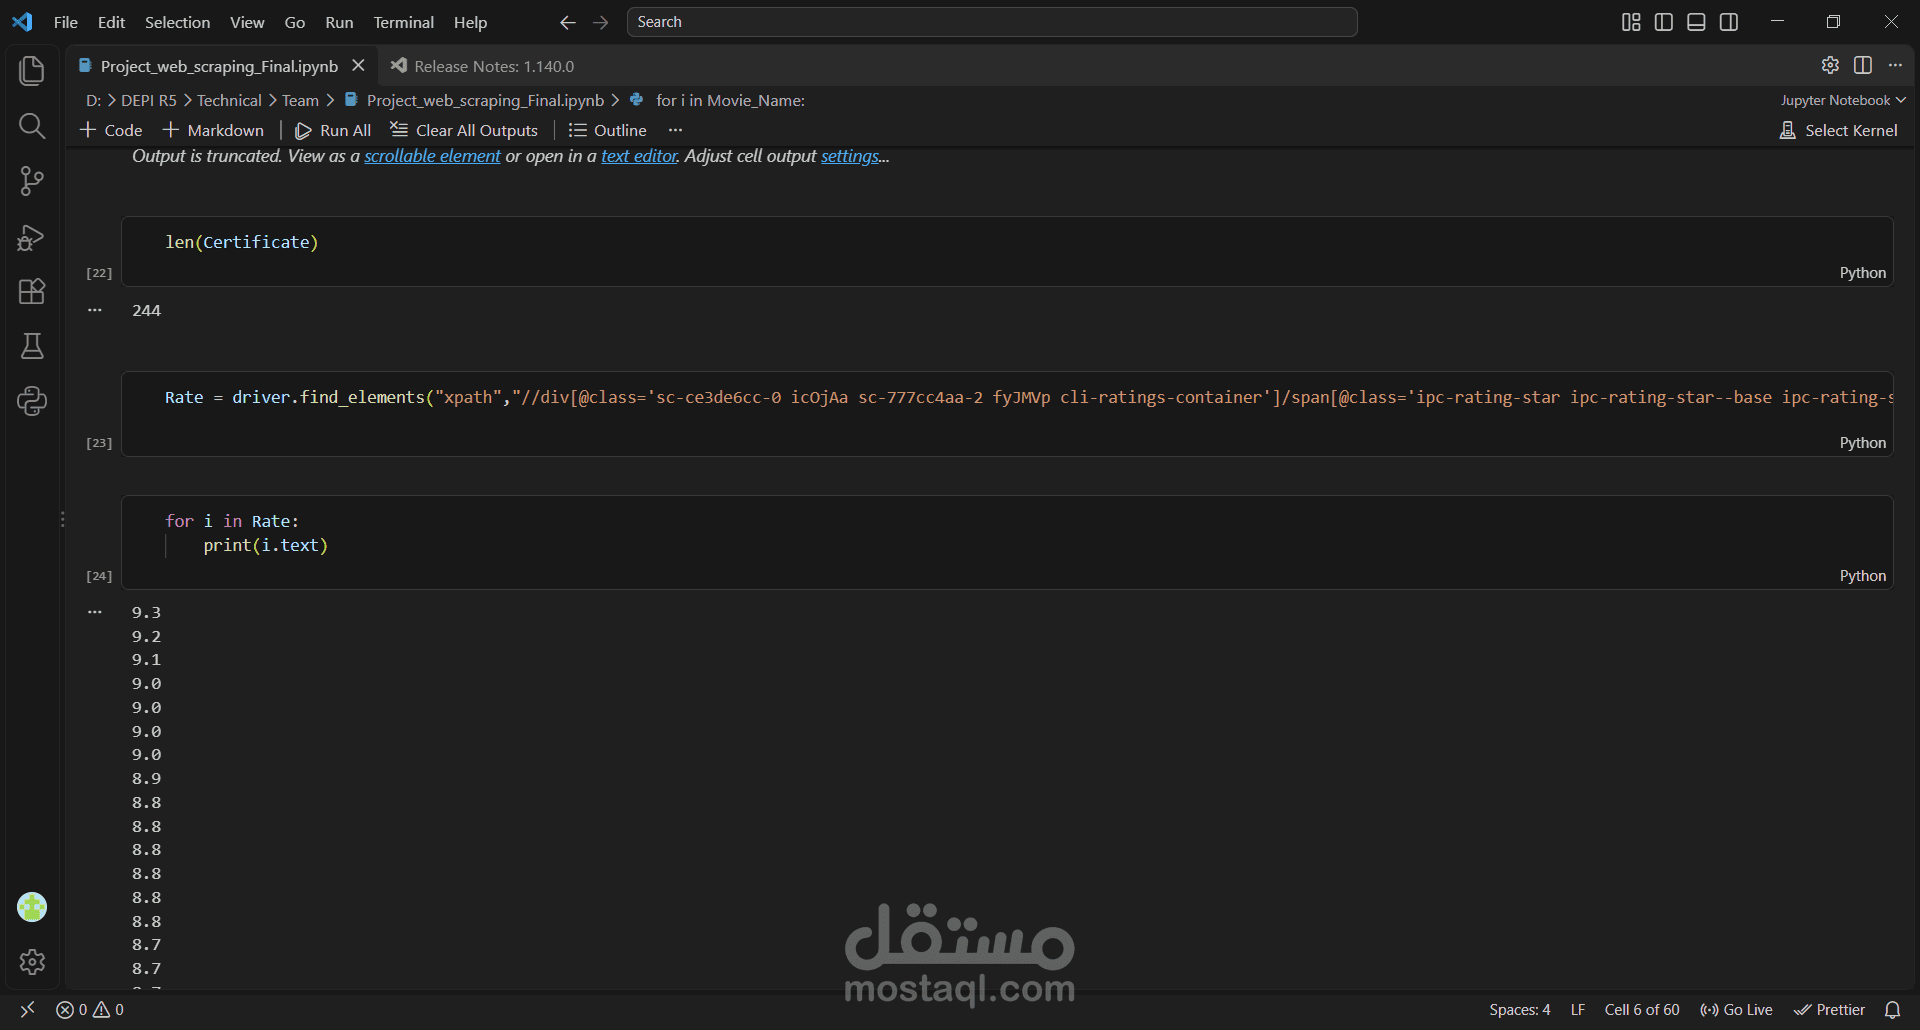
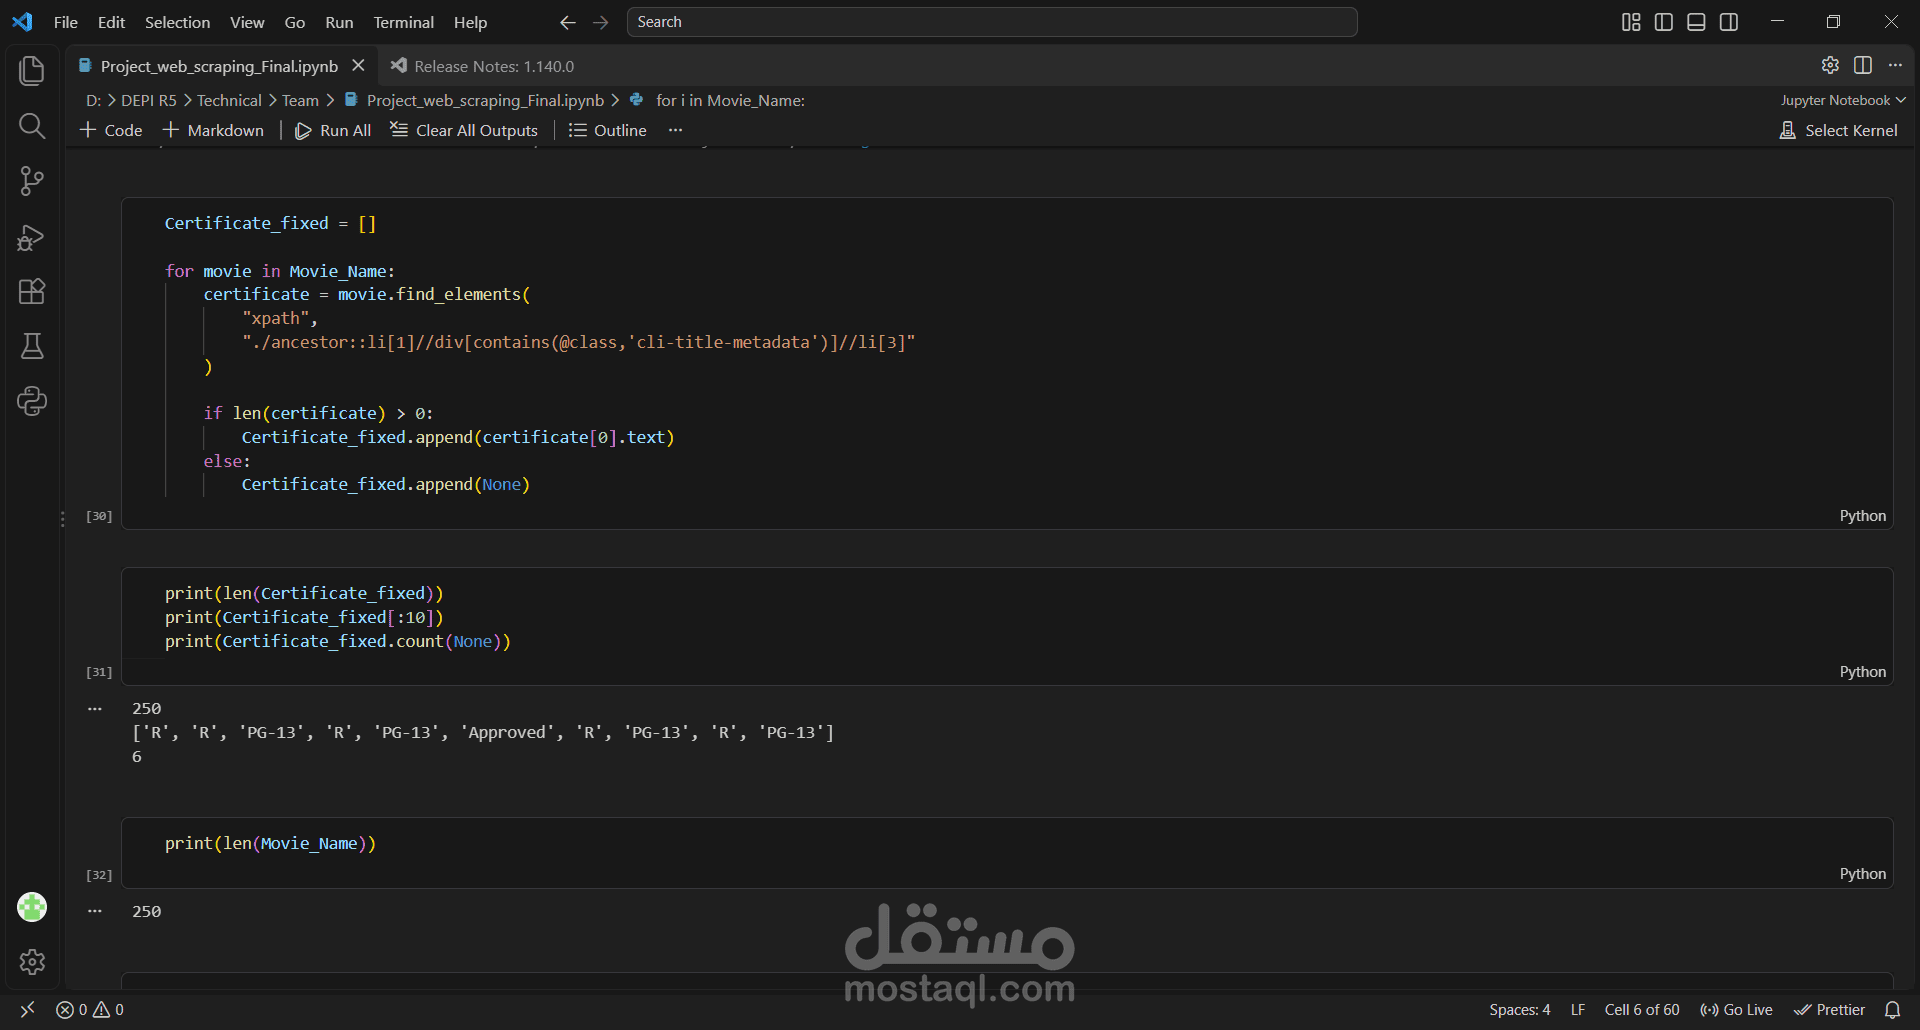
بدأت عملية جمع البيانات باستخدام **Python وSelenium WebDriver**، حيث تم تشغيل متصفح Chrome والوصول إلى صفحة IMDb الخاصة بقائمة Top 250، ثم استخدام XPath للوصول إلى العناصر المطلوبة واستخراج بيانات الأفلام بشكل آلي.
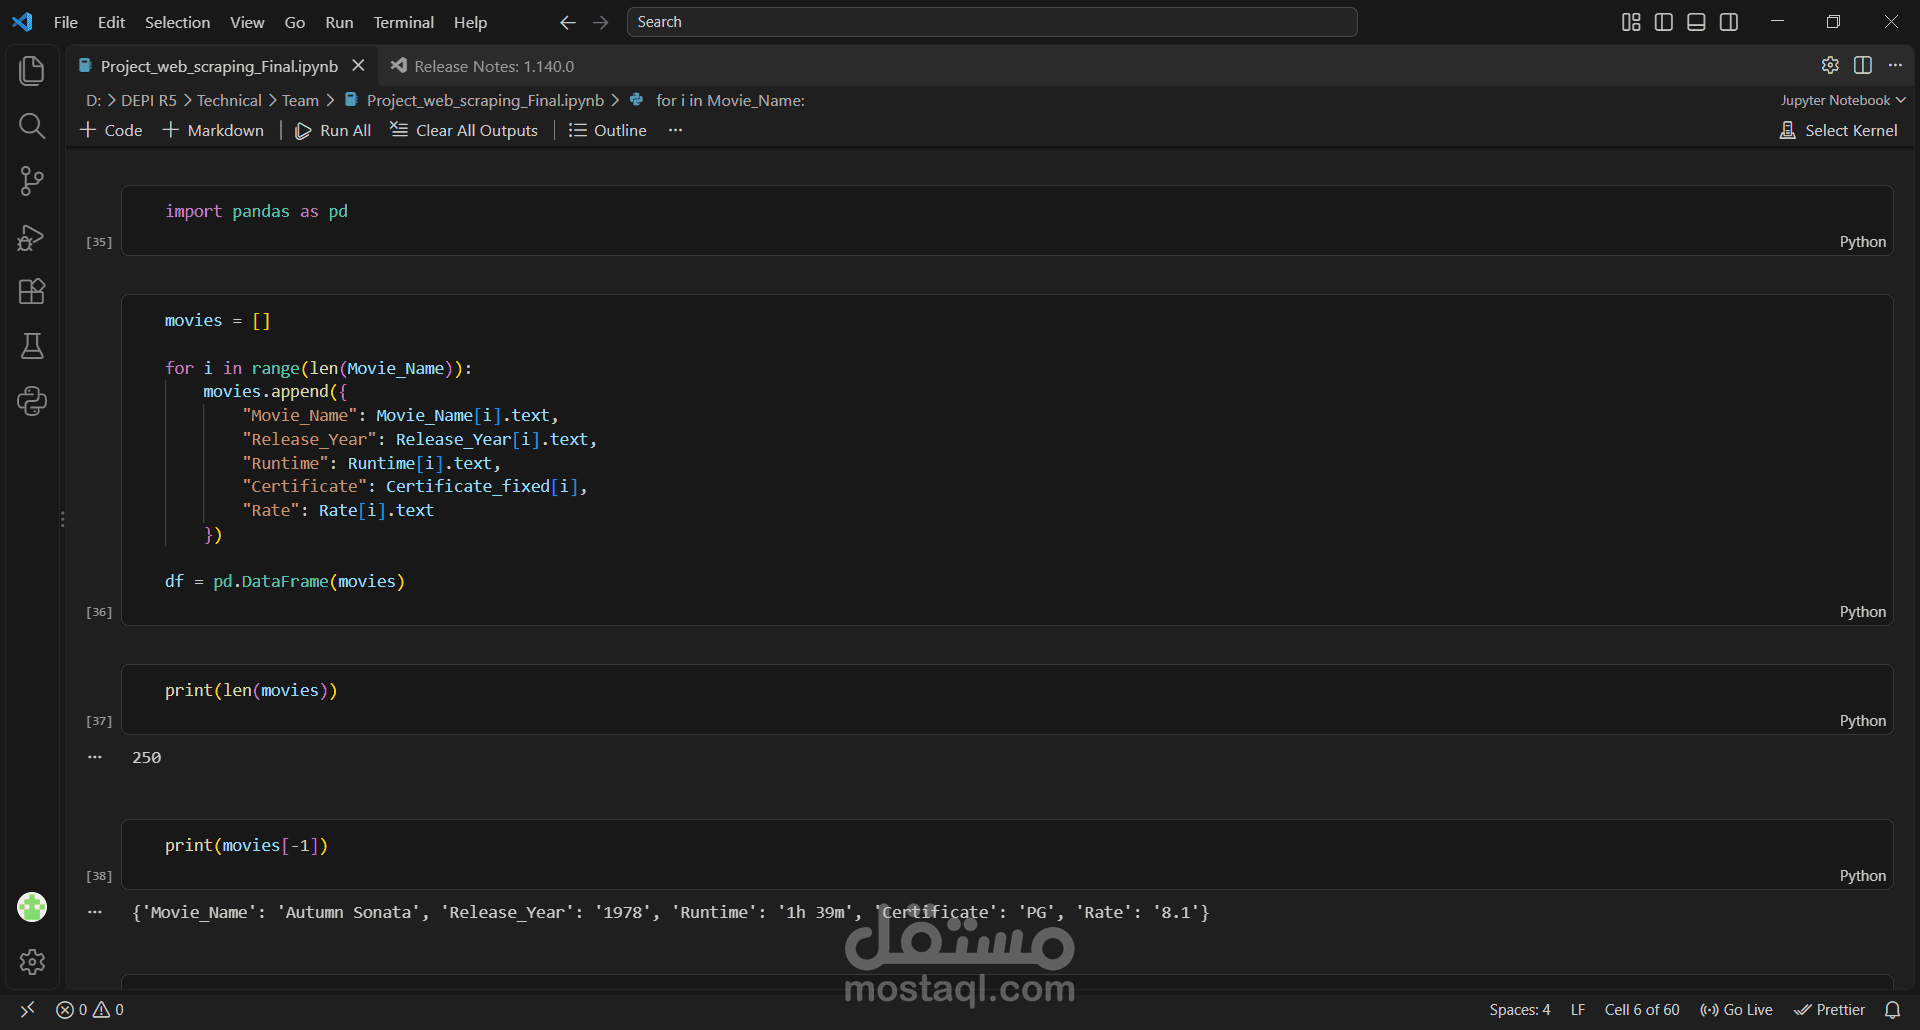
تم استخراج مجموعة من أهم المعلومات الخاصة بكل فيلم، وتشمل:
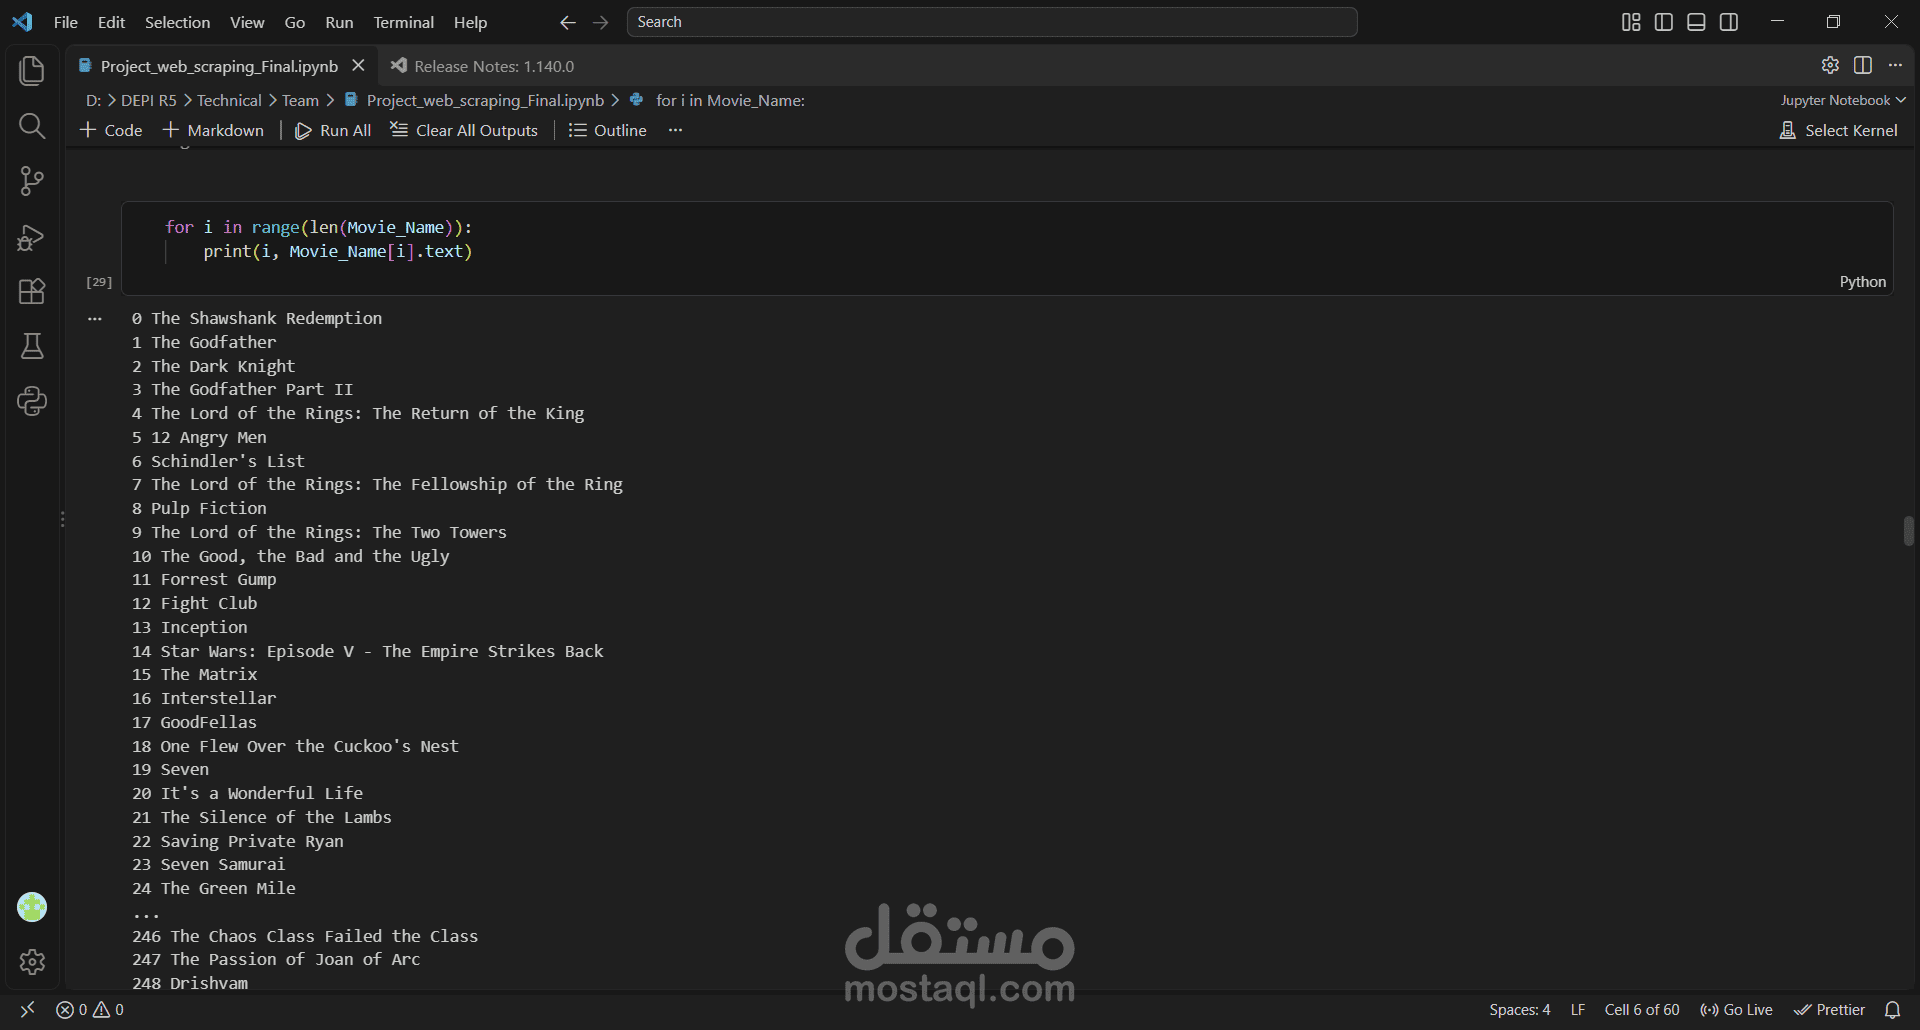
* اسم الفيلم (Movie Name)
* سنة الإصدار (Release Year)
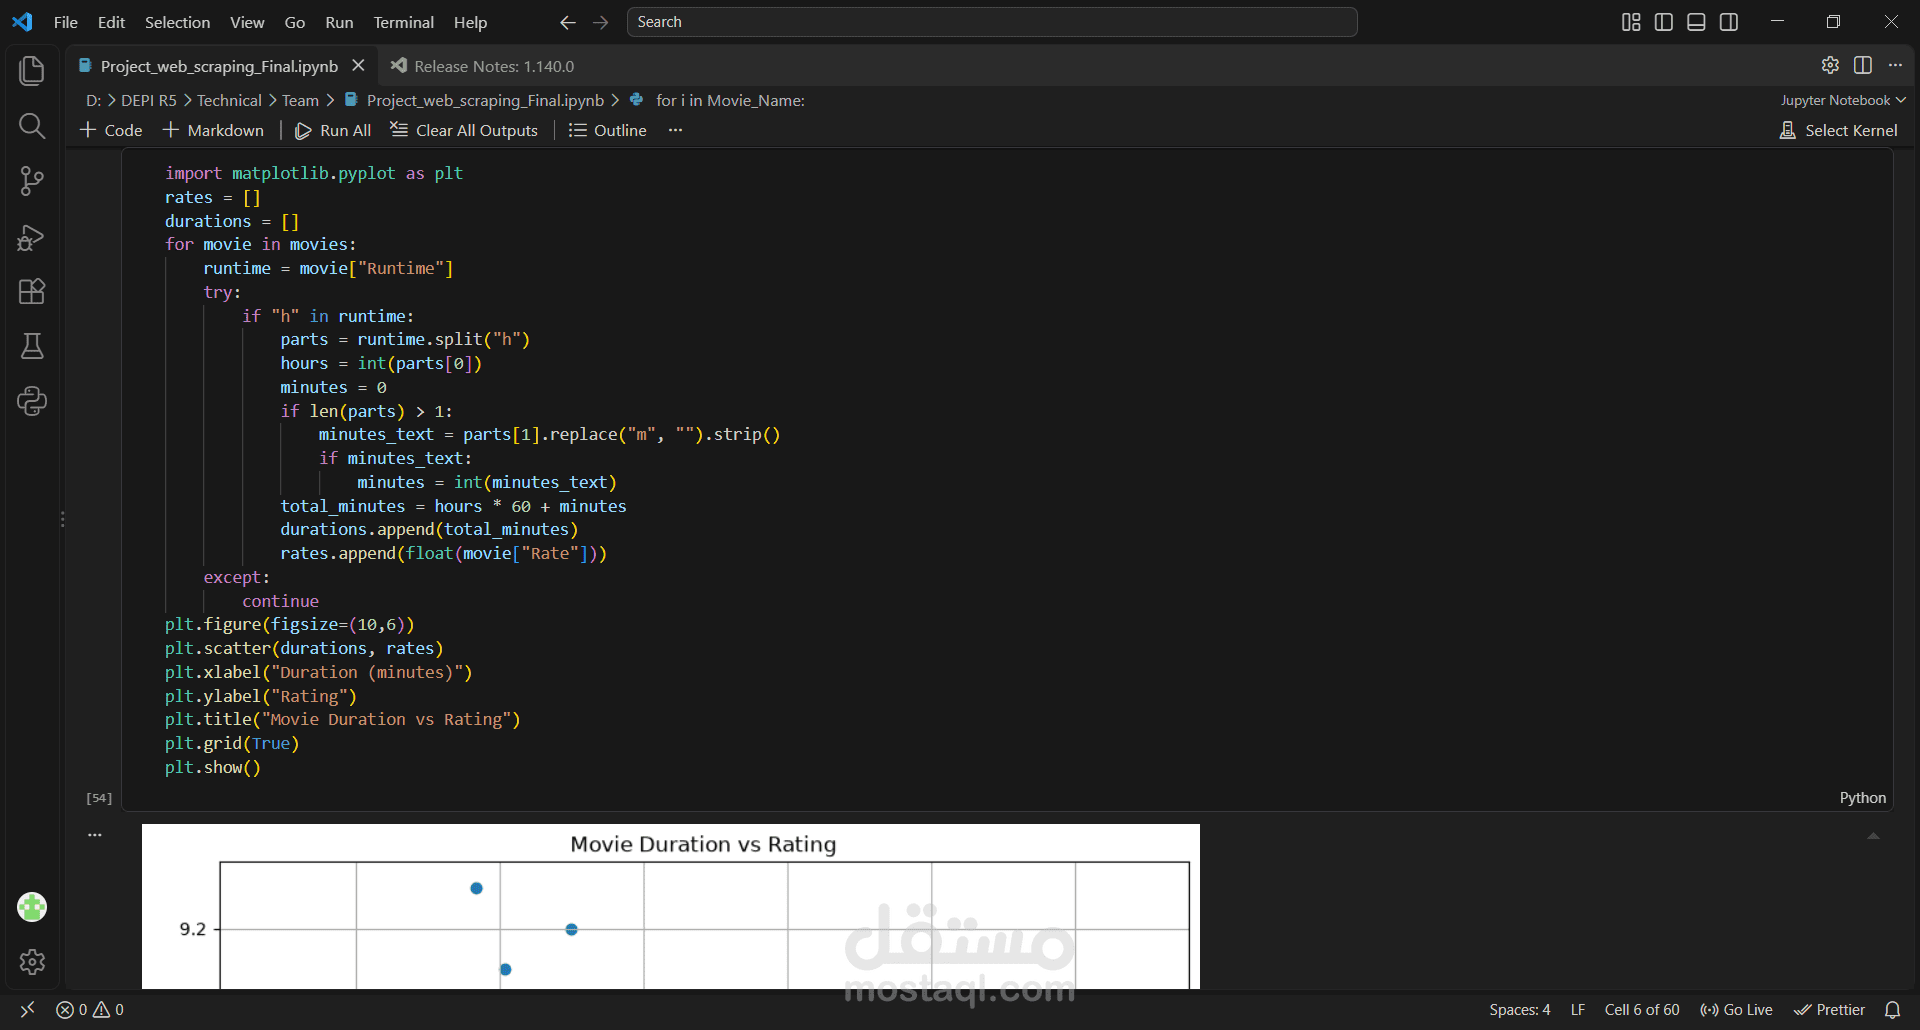
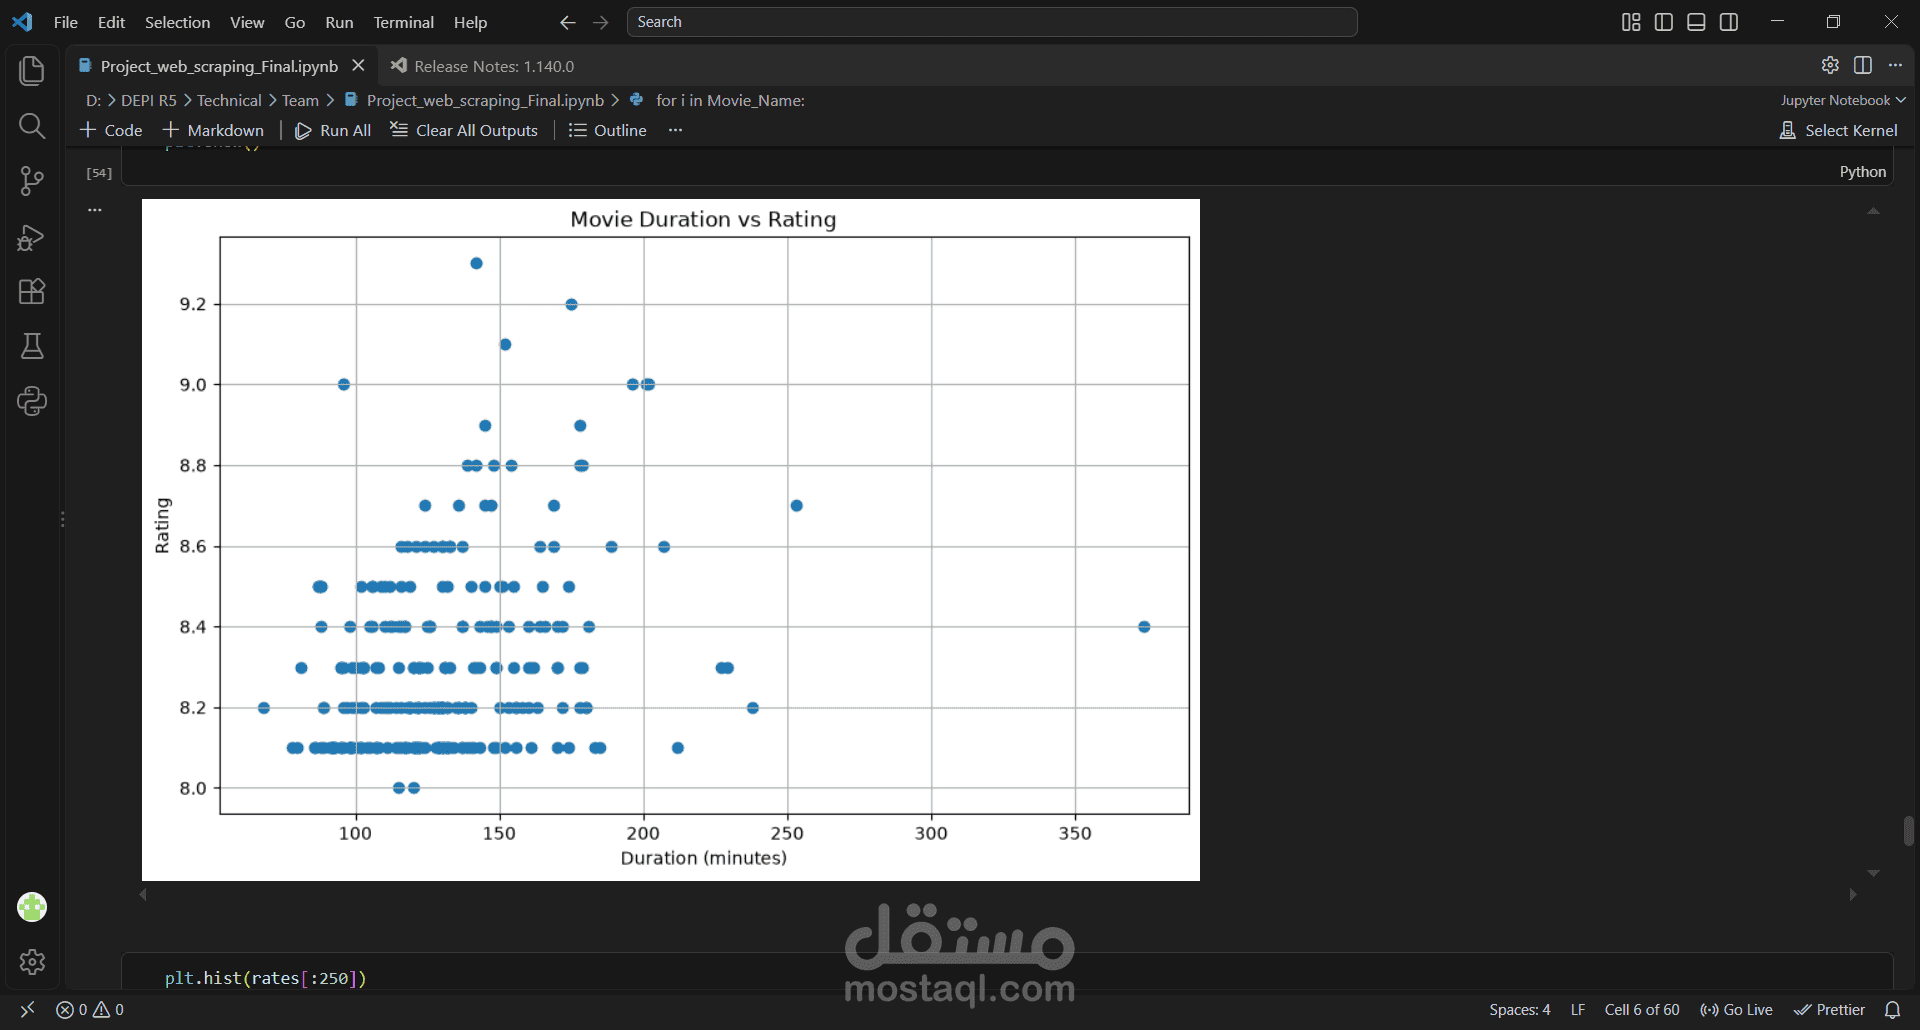
* مدة الفيلم (Runtime)
* التصنيف العمري (Certificate)
* تقييم الفيلم على IMDb (Rating)
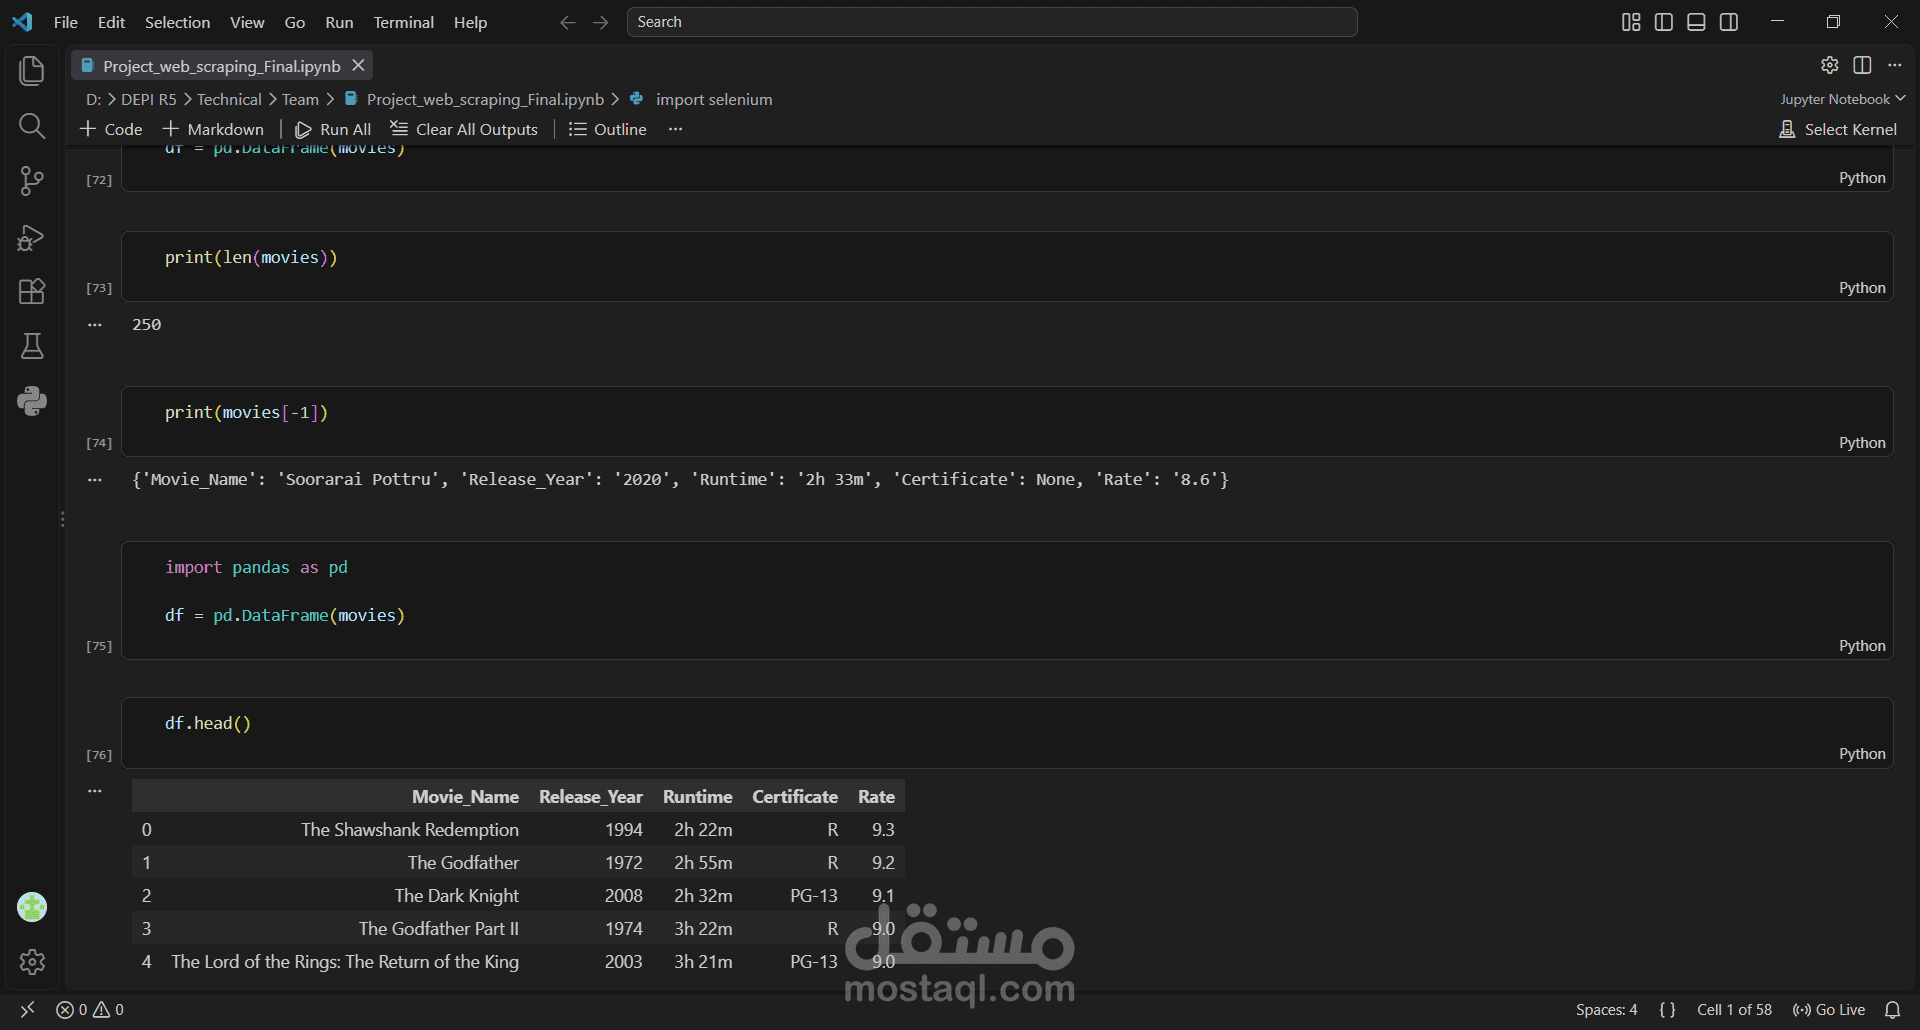
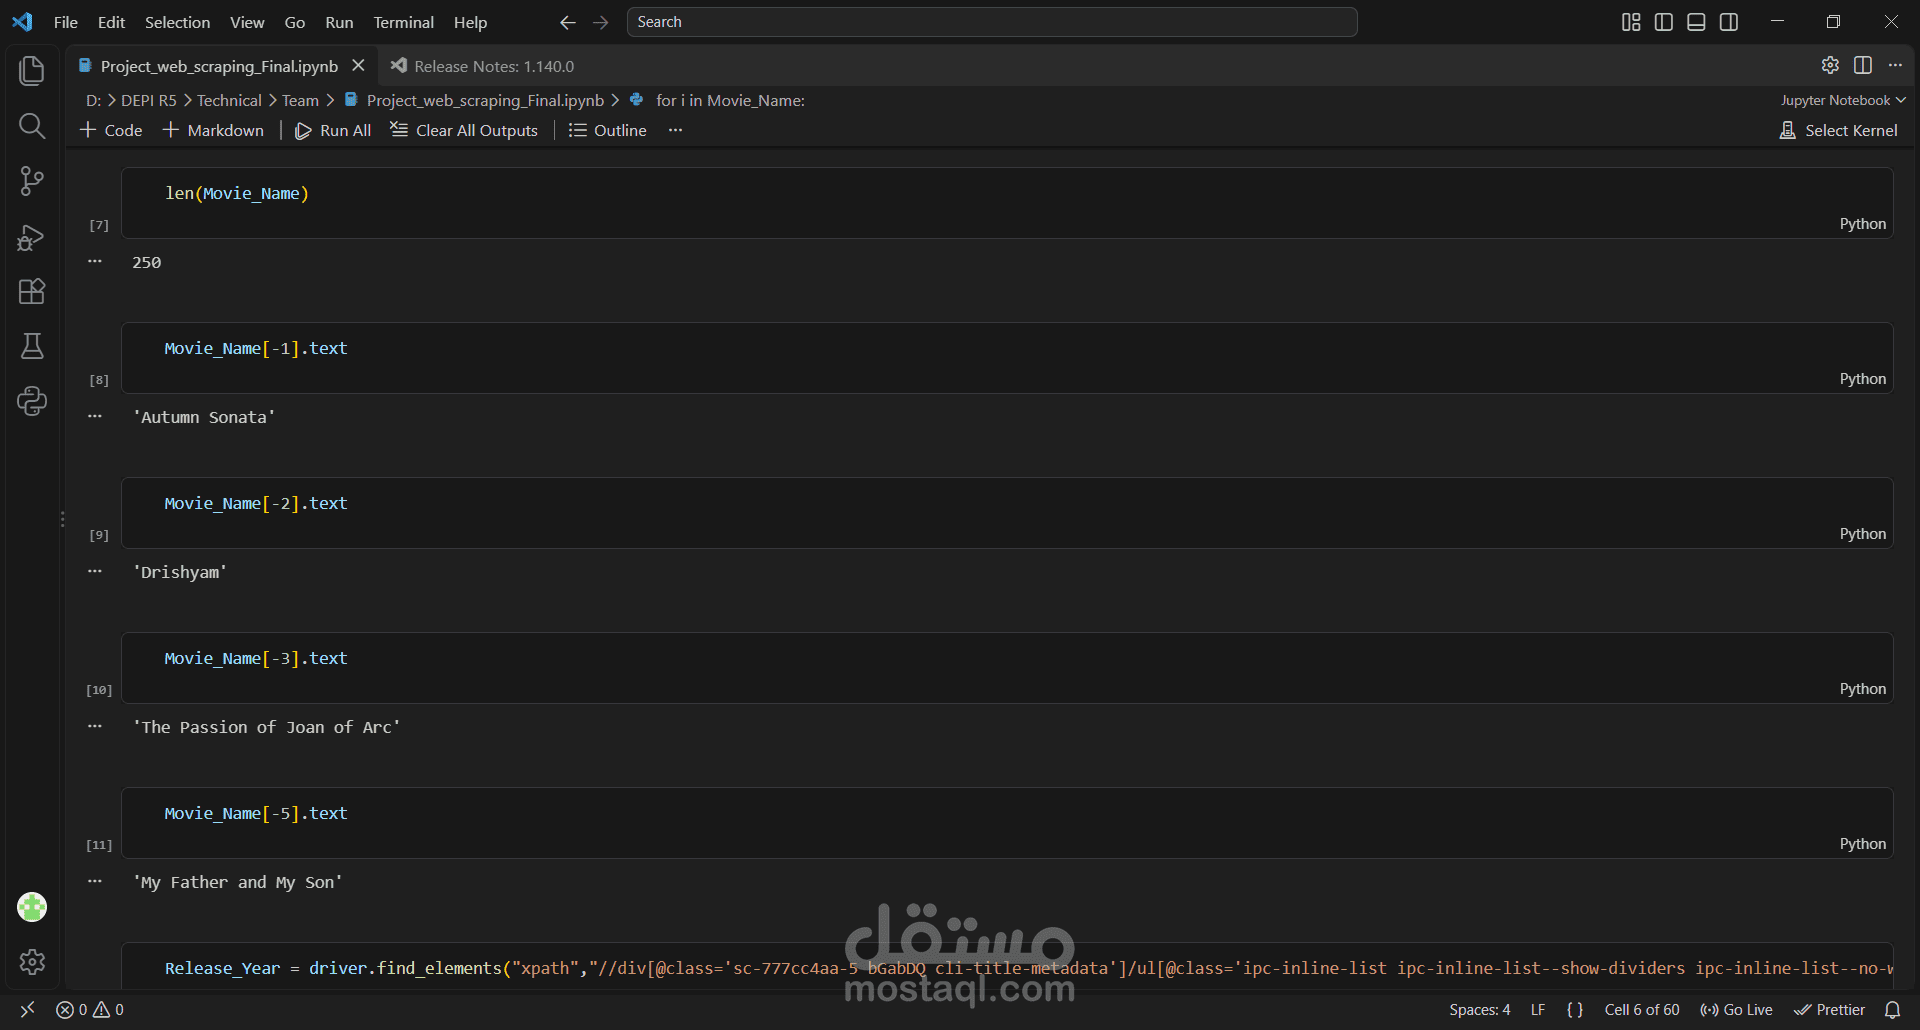
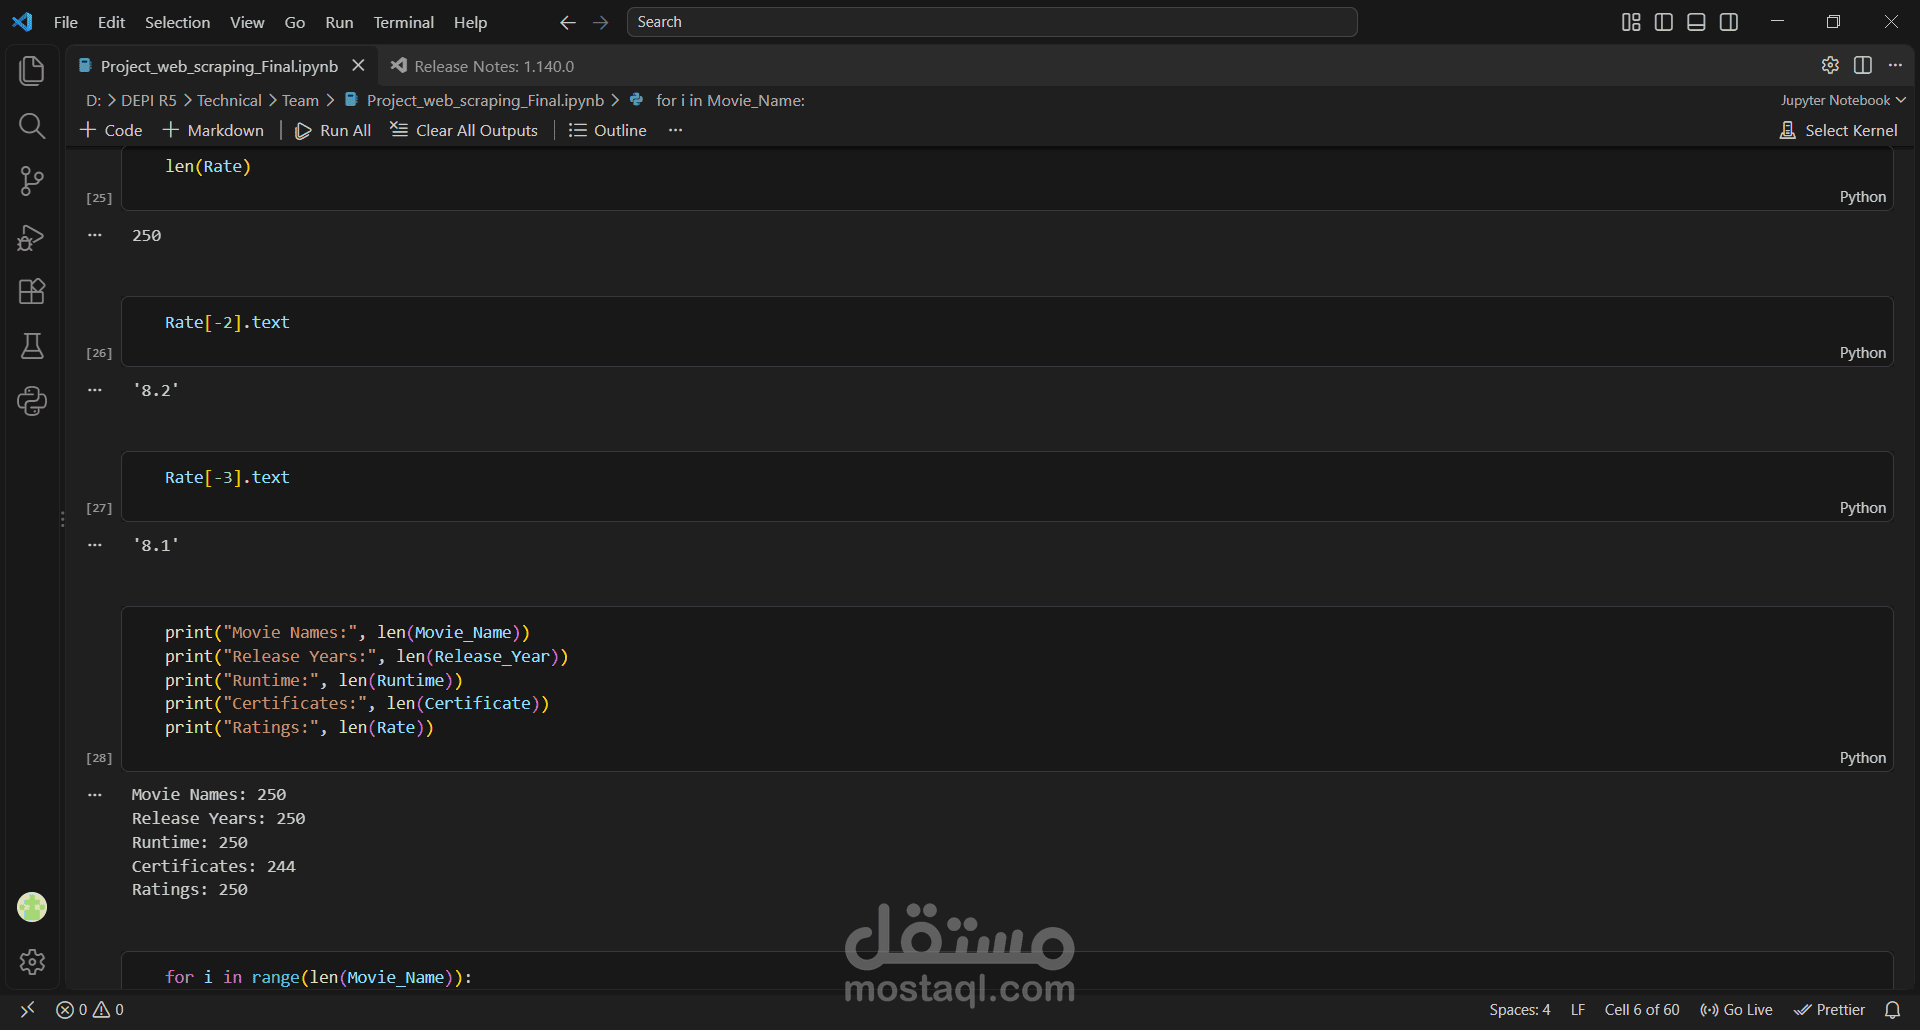
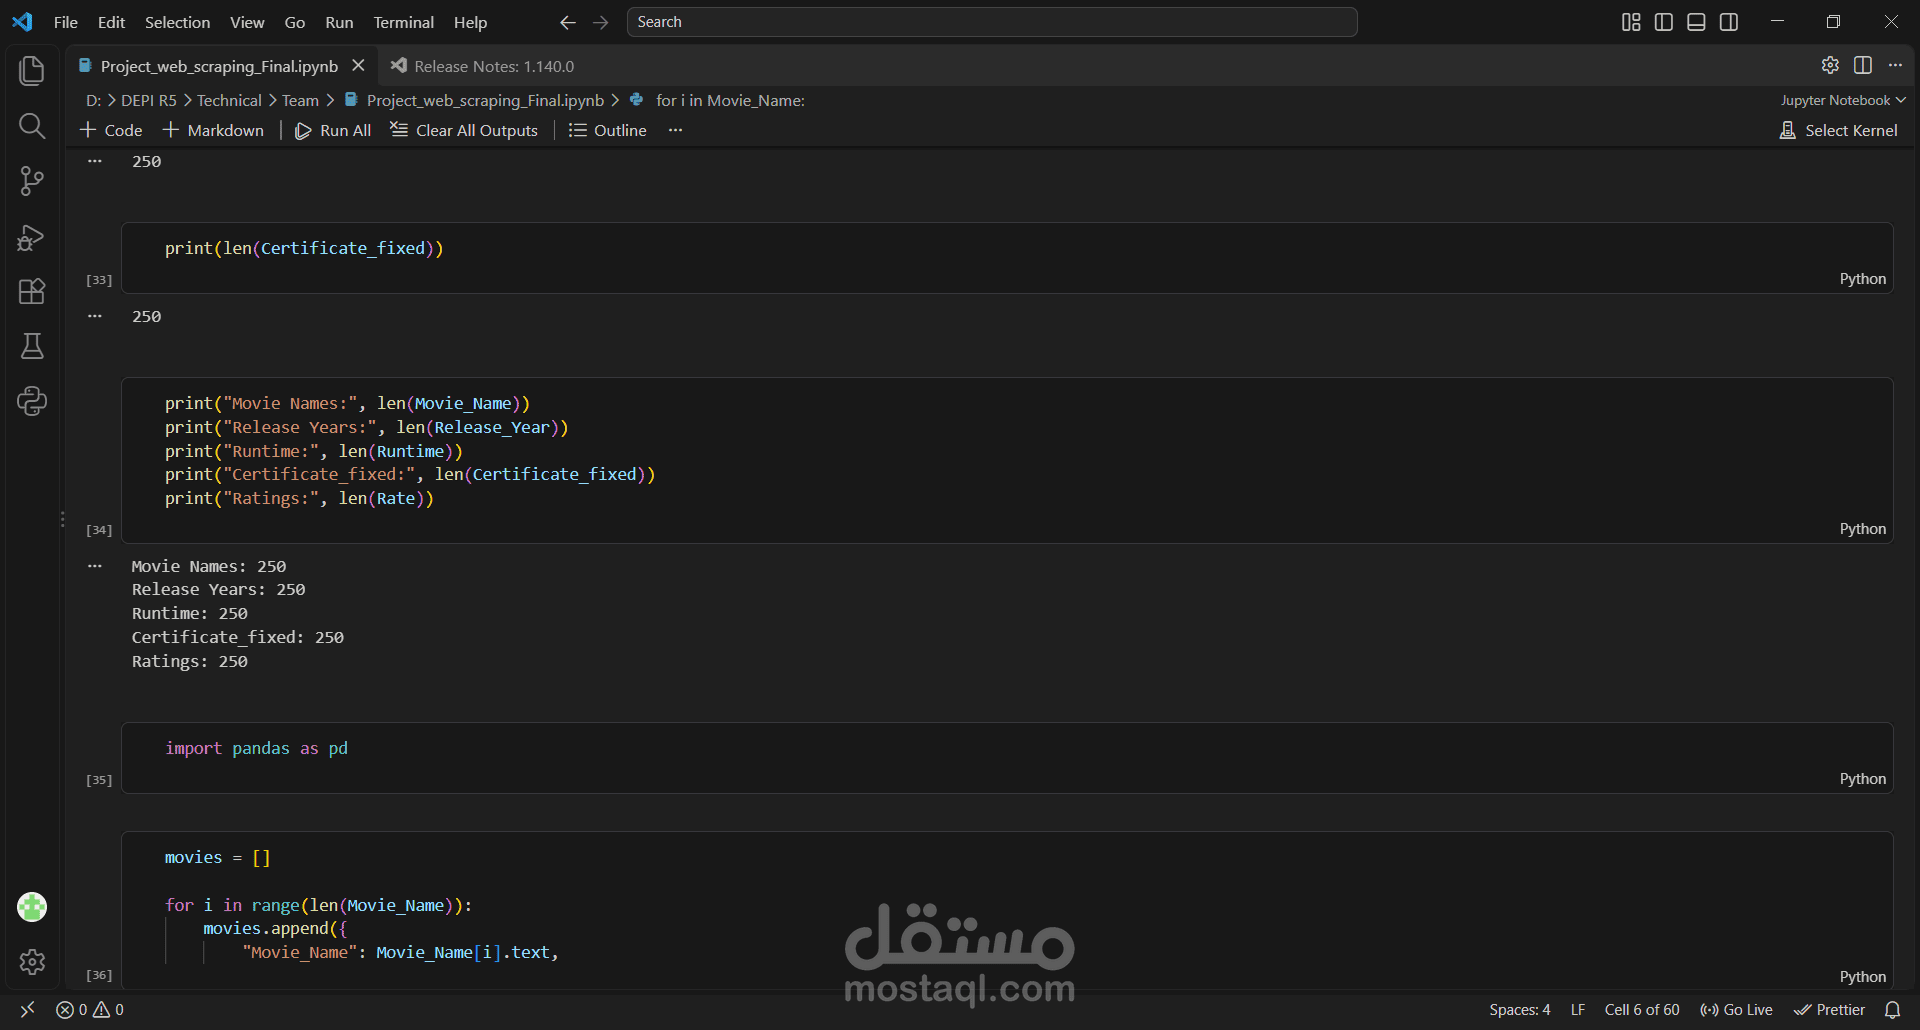
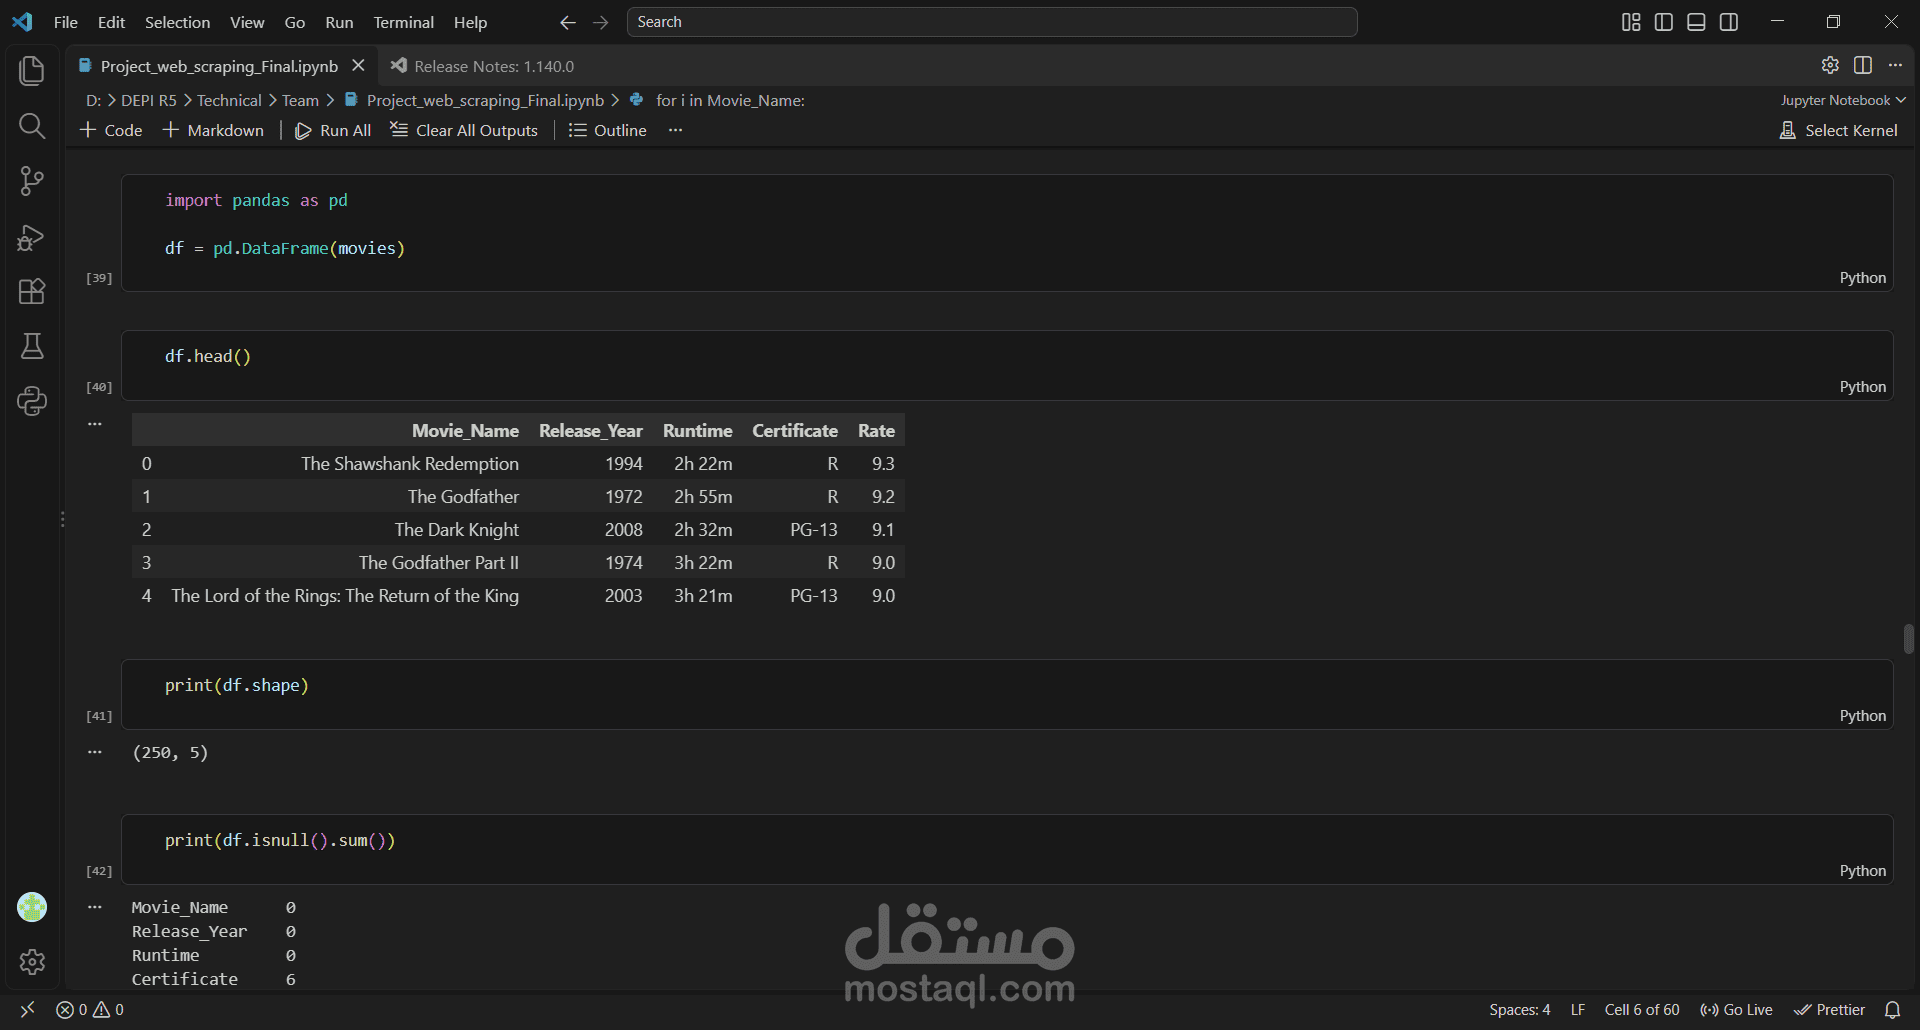
تم جمع بيانات **250 فيلمًا** ثم تحويل البيانات المستخرجة إلى DataFrame باستخدام **Pandas** لتسهيل عمليات الفحص والتنظيف والمعالجة.
Data Cleaning & Data Validation
بعد استخراج البيانات، تم تنفيذ عدة خطوات لتنظيف البيانات وتحسين جودتها:
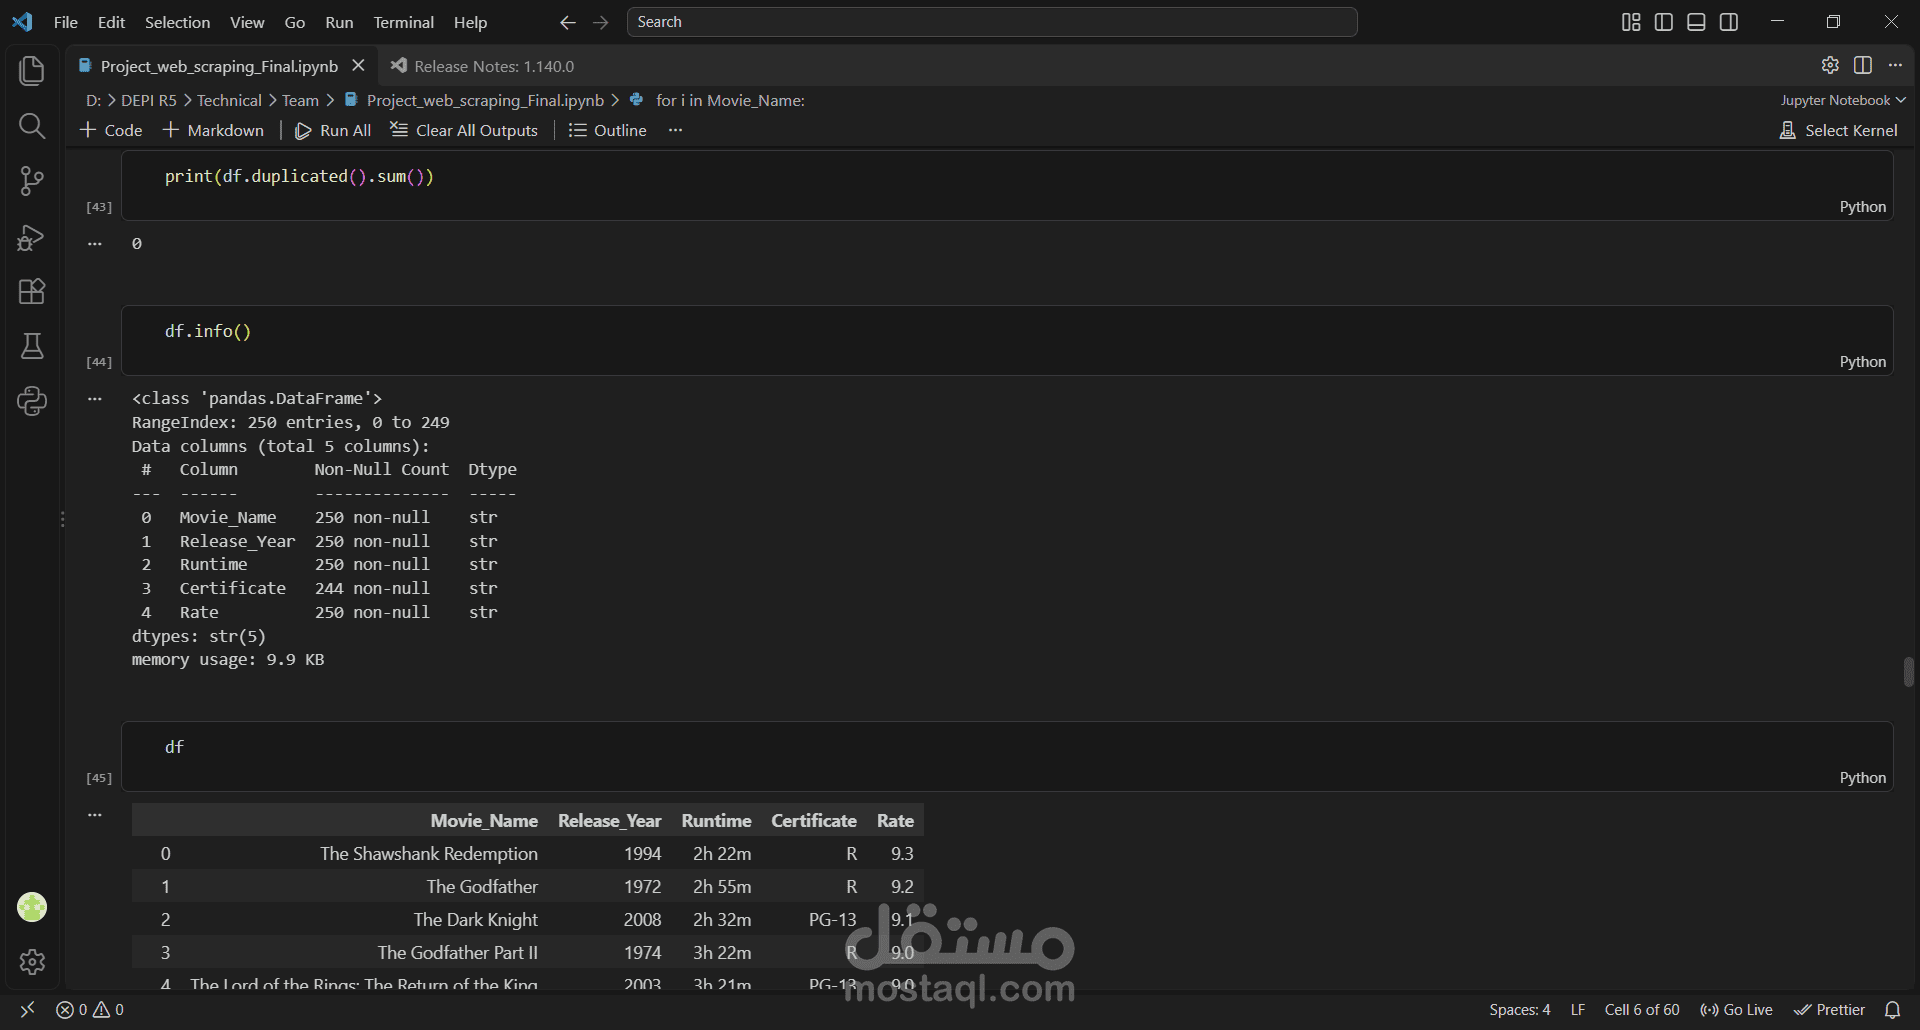
* فحص حجم الـ Dataset والتأكد من وجود **250 سجلًا و5 أعمدة**.
* التحقق من القيم المفقودة باستخدام `isnull()`.
* اكتشاف وجود قيم مفقودة في عمود **Certificate** ومعالجتها بقيمة `Not Rated`.
* إزالة المسافات الزائدة من أسماء الأفلام والتصنيفات باستخدام `str.strip()`.
* تحويل سنة الإصدار من نص إلى نوع رقمي `Integer`.
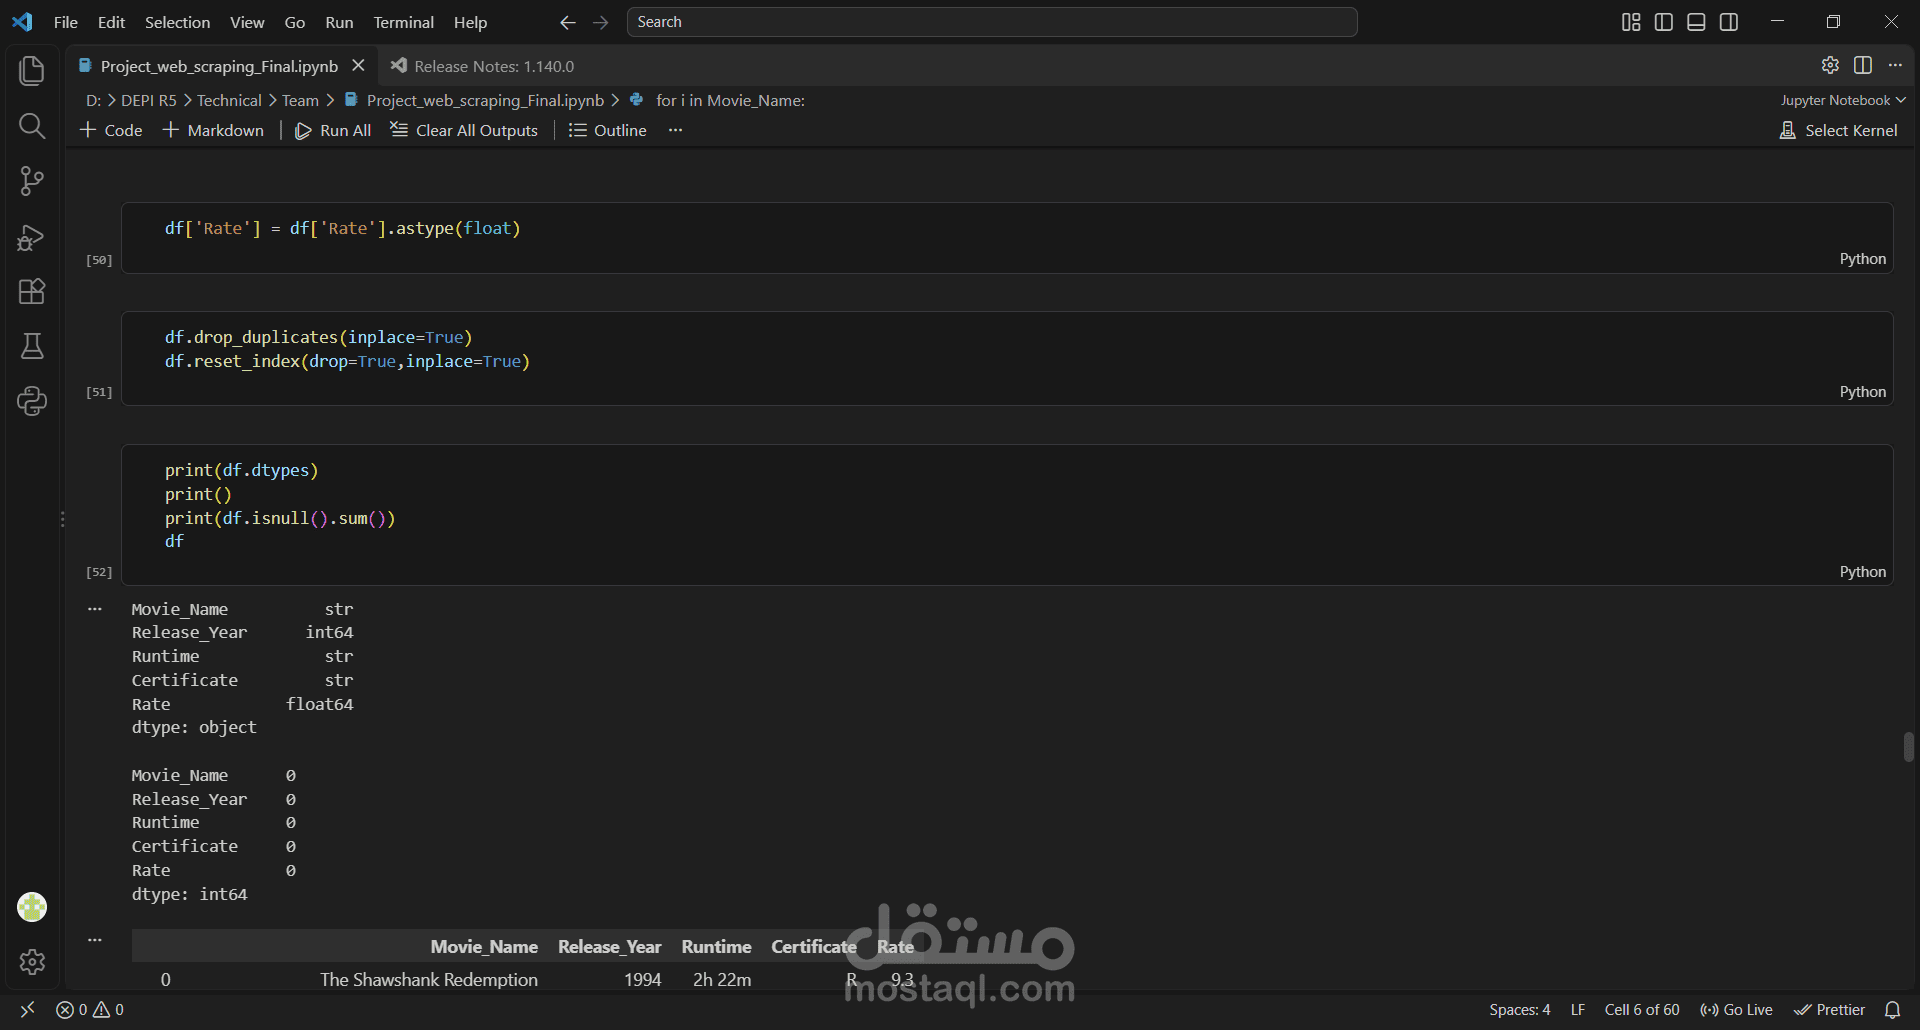
* تحويل تقييم IMDb من نص إلى `Float` ليصبح مناسبًا للتحليل والحسابات الرقمية.
* فحص البيانات المكررة باستخدام `duplicated()`.
* إزالة أي سجلات مكررة باستخدام `drop_duplicates()`.
* إعادة ترتيب الـ Index بعد عملية التنظيف.
* التحقق النهائي من أنواع البيانات والقيم المفقودة للتأكد من جودة البيانات النهائية.
النتيجة النهائية
في نهاية الـ ETL Process أصبحت البيانات في صورة **Structured Dataset** تحتوي على 250 سجلًا و5 أعمدة، مع أنواع بيانات مناسبة للتحليل، وبدون قيم مفقودة في الأعمدة النهائية.
المشروع يوضح عمليًا القدرة على تنفيذ Pipeline مبسط يبدأ من:
**Web Data Source → Web Scraping → Data Extraction → Data Cleaning → Data Validation → Structured Dataset**
الأدوات والتقنيات المستخدمة
* **Python**
* **Selenium**
* **Selenium WebDriver**
* **Pandas**
* **Jupyter Notebook**
* **XPath**
* **Data Cleaning & Data Validation**
* **Data Transformation**
* **Web Scraping**
* **Structured Data Preparation**
هذا المشروع يمثل تطبيقًا عمليًا على كيفية تحويل البيانات غير المنظمة من صفحات الويب إلى بيانات منظمة ونظيفة يمكن استخدامها لاحقًا في **Data Analysis, Visualization, Reporting أو Data Pipelines**.