NLP Resume Parser
تفاصيل العمل
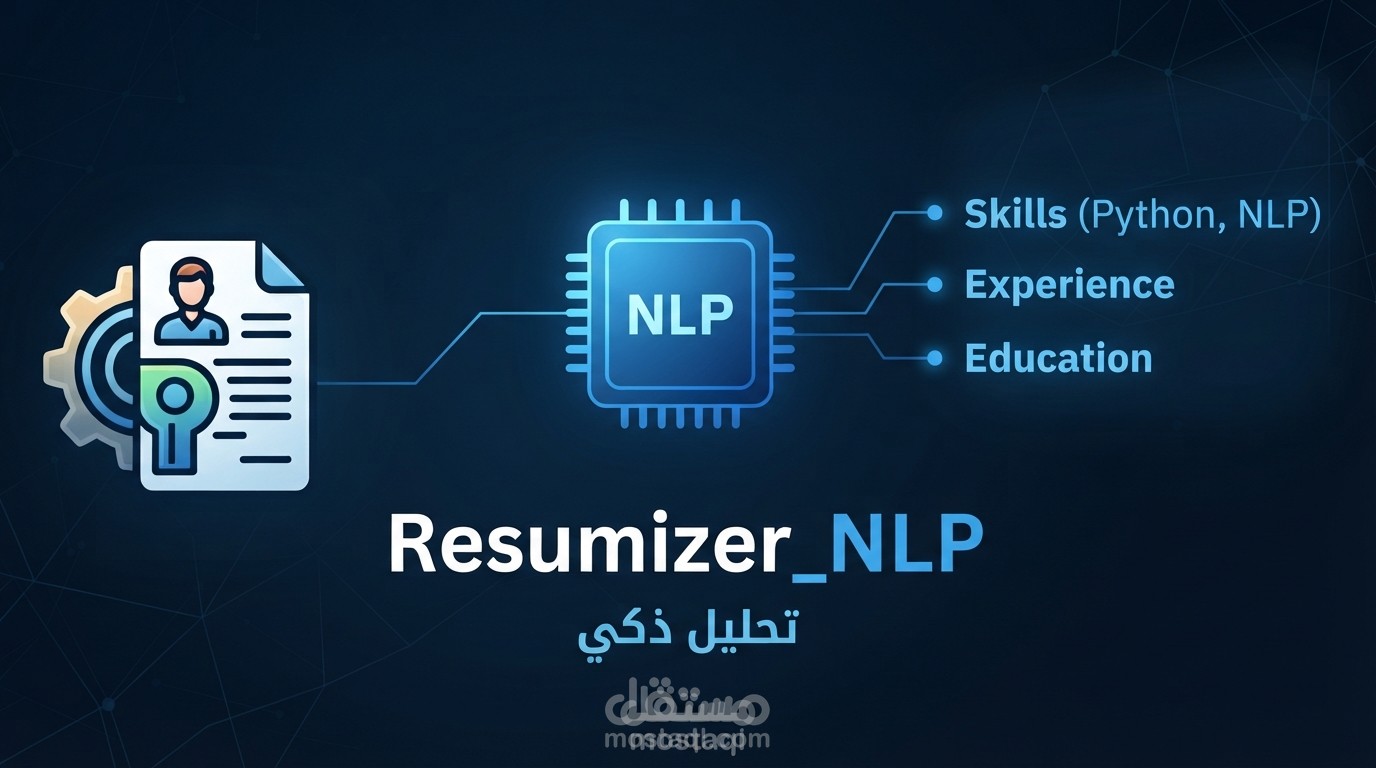
نبذة عن المشروع:
مشروع برمجية متكامل يعتمد على تقنيات معالجة اللغة الطبيعية (NLP) والذكاء الاصطناعي لتحليل السير الذاتية (CVs) بشكل تلقائي واستخراج البيانات الحيوية منها بدقة عالية، مما يوفر على مسؤولي التوظيف (HR) وأصحاب العمل ساعات طويلة من الفرز اليدوي.
الهدف من المشروع:
مساعدة الشركات ومنصات التوظيف في أتمتة عملية فرز السير الذاتية، وتحويل المستندات النصية (PDF أو Word) إلى هيكل بيانات منظم ويسهل البحث فيه وتقييمه مقارنةً بمتطلبات الوظائف.
المميزات والوظائف الأساسية:
استخراج البيانات التلقائي (Information Extraction): استخراج المعلومات الأساسية مثل: بيانات الاتصال، المهارات البرمجية والتقنية، الخبرات المهنية، والتاريخ التعليمي بدقة.
التلخيص الذكي (AI Summarization): توليد ملخص موجز وشامل للمرشح يبرز أهم نقاط القوة والخبرات المناسبة للدور الوظيفي.
التصنيف والتحليل (NLP & Text Processing): معالجة النصوص وتنظيفها باستخدام أحدث مكتبات وأدوات معالجة اللغة الطبيعية لفهم السياق والمحتوى بدقة.
واجهة مستخدم تفاعلية (User Interface): تصميم واجهة سهلة وبسيطة لرفع السير الذاتية وعرض النتائج والتحليلات بشكل منظم ومرتب.
التقنيات والأدوات المستخدمة:
لغة البرمجة: Python
مكتبات وأدوات معالجة اللغة الطبيعية (NLP): spaCy / NLTK / Transformers
معالجة الملفات والبيانات: Pandas, PyPDF2 / pdfplumber
الواجهة الأمامية/التفاعلية: Streamlit (أو الإطار المستخدم في مشروعك)