engineer-a-production-grade-end-to-end-Big-Data-pipeline-that-demonstrates-advanced-proficiency
تفاصيل العمل
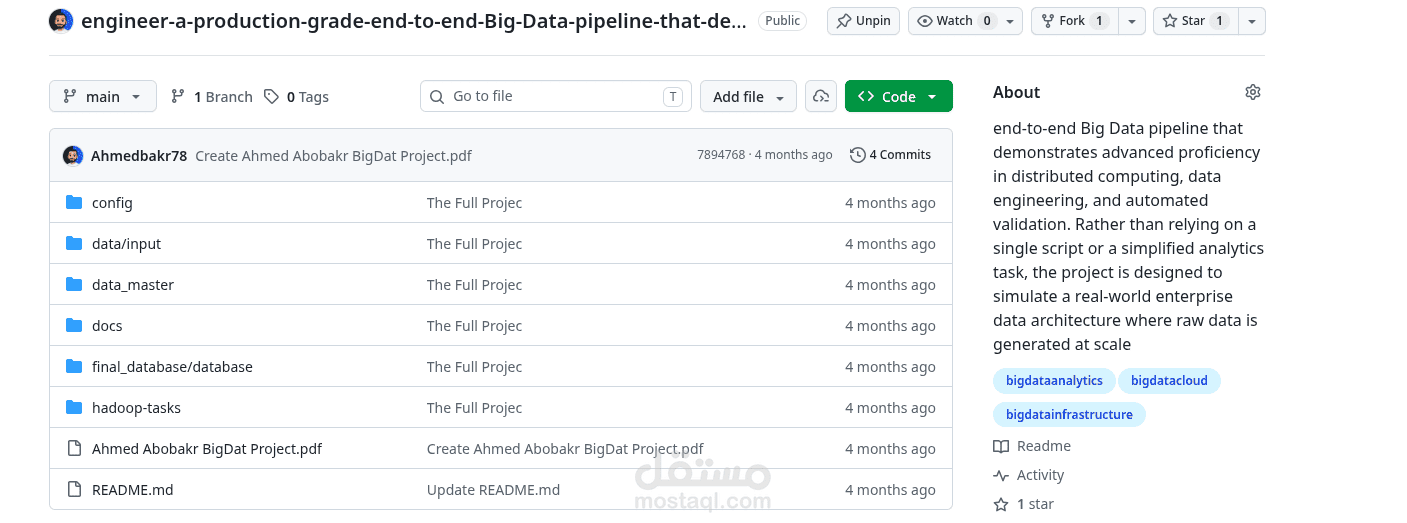
تصميم وتطوير خط أنابيب بيانات ضخمة متكامل من البداية إلى النهاية باستخدام Hadoop MapReduce، Python، Java، Bash، وDocker، لمحاكاة معمارية بيانات مؤسسية حقيقية. تضمن المشروع بناء نظام آلي لتوليد البيانات على نطاقين (بيانات اختبارية صغيرة وبيانات ضخمة تصل إلى ملايين الصفوف)، وتنظيمها في Data Hub مركزي، ودمجها في مجموعات بيانات رئيسية (Master Datasets) مع إزالة التكرار.
قمت بتنفيذ مهمتين MapReduce متقدمتين:
Task 2: تحليل Cache Join باستخدام Hadoop DistributedCache لتنفيذ Map-Side Join عالي الكفاءة، مع دمج سجلات الرحلة مع بيانات الكاش.
Task 18: تحليل تقسيم الفترات الزمنية للحضور باستخدام Custom Partitioner لتوجيه السجلات إلى Reducer محدد حسب الفترة (Morning/Afternoon/Night).
كما طبقت طبقة تحقق آلية تقارن مخرجات Hadoop مع نتائج متوقعة مسبقاً لضمان سلامة البيانات، مع دعم إعادة التشغيل دون تكرار (Idempotency). شمل المشروع حوسبة الحاويات (Docker) لضمان قابلية النقل، وتخزين النتائج في SQLite، وإنتاج تقارير جودة وتحقق بصيغة JSON. النتيجة: خط أنابيب إنتاجي موثق بالكامل، يعمل بكفاءة على بيئات مختلفة، ويضمن دقة البيانات وصحتها الرياضية.