Red-Whine Quality Prediction
تفاصيل العمل
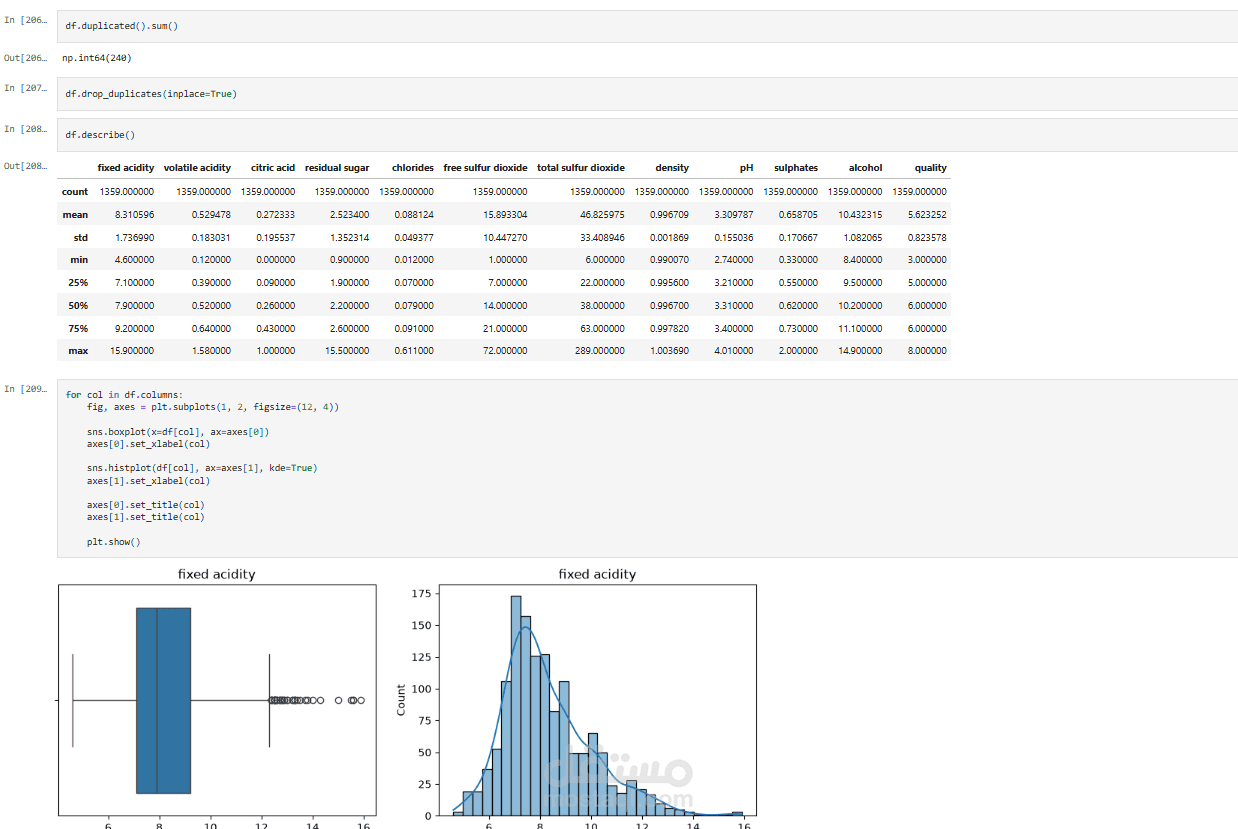
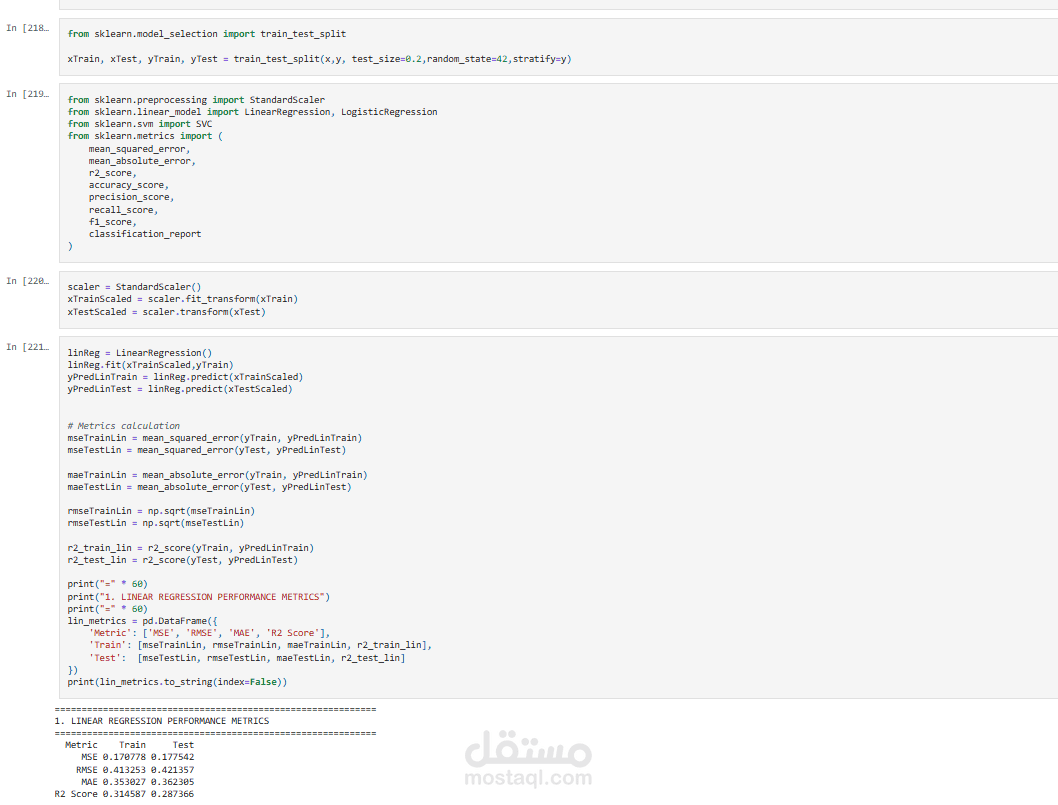
دراسة وتحليل شامل للبيانات (End-to-End Machine Learning) لتوقع وتقييم مستوى جودة النبيذ الأحمر بناءً على خصائصه الكيميائية والفيزيائية.
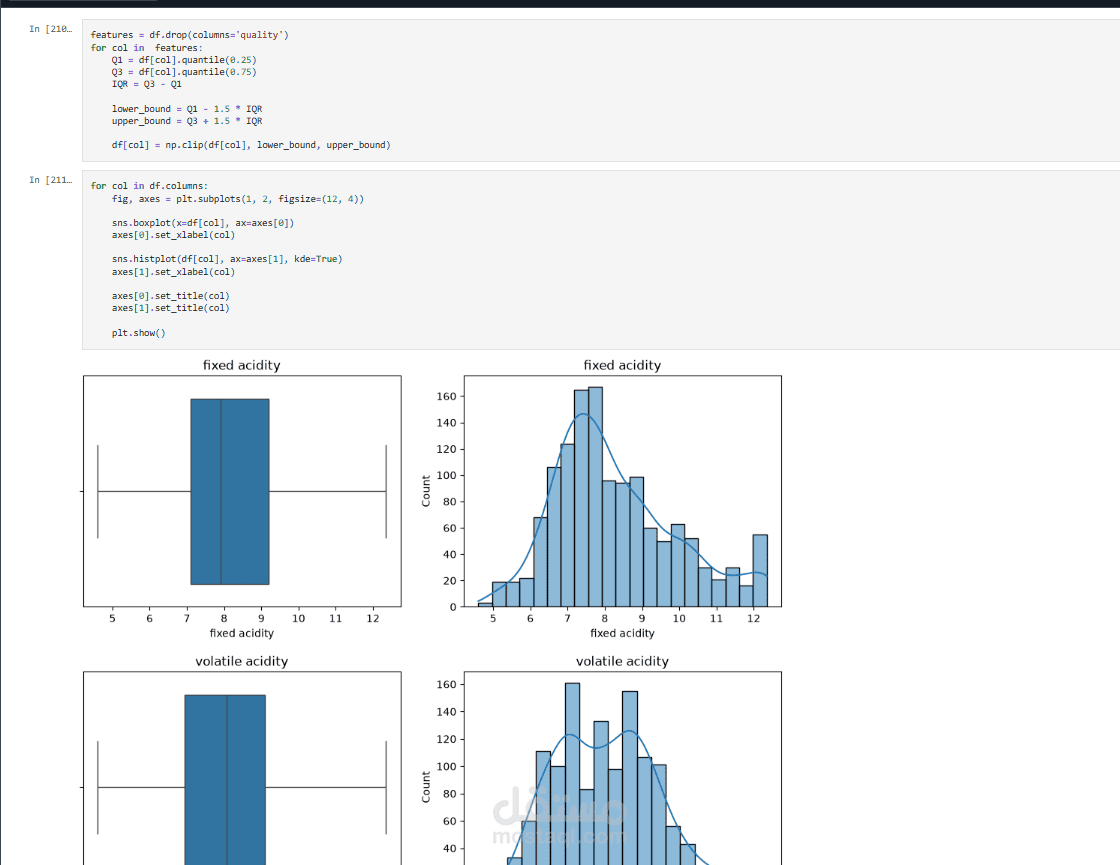
طبيعة العمل: يتضمن المشروع مرحلة مكثفة لتنظيف البيانات (Data Cleaning)، التعامل مع القيم الشاذة (Outliers Handling)، والتحليل الاستكشافي للبيانات (EDA) لفهم أثر الخصائص مثل الحموضة ونسبة الكحول على الجودة.
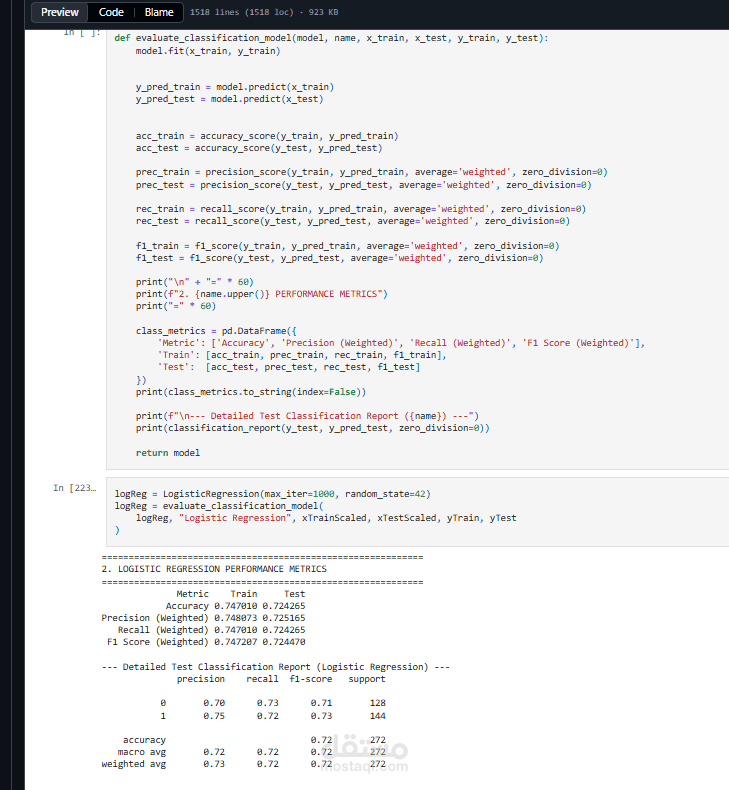
النمذجة والتنفيذ: تم تطبيق وتقييم عدة نماذج تصنيف وتراجع (Classification & Regression Models) لمقارنة أدائها واختيار النموذج الأعلى دقة في التنبؤ.
التقنيات المستخدمة: Python, Pandas, NumPy, Matplotlib, Seaborn, Scikit-Learn.