ASD Classification using Random Forest
تفاصيل العمل
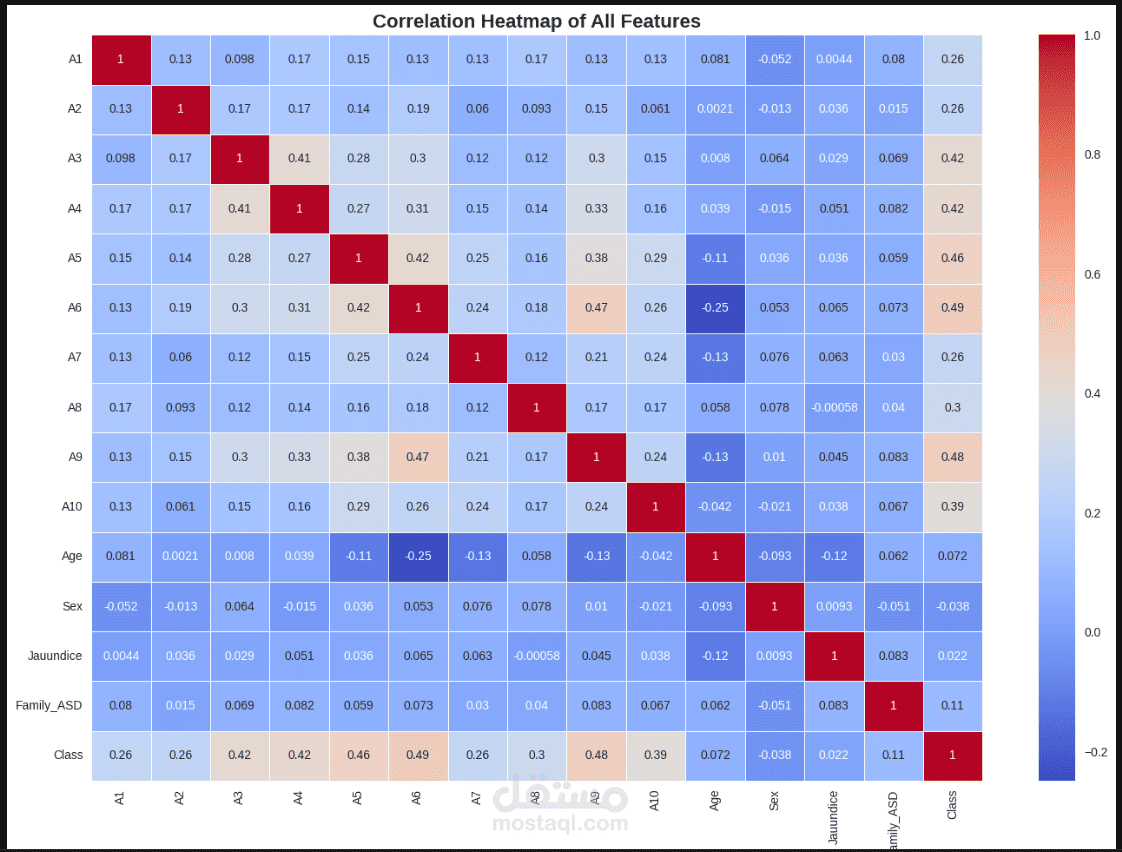
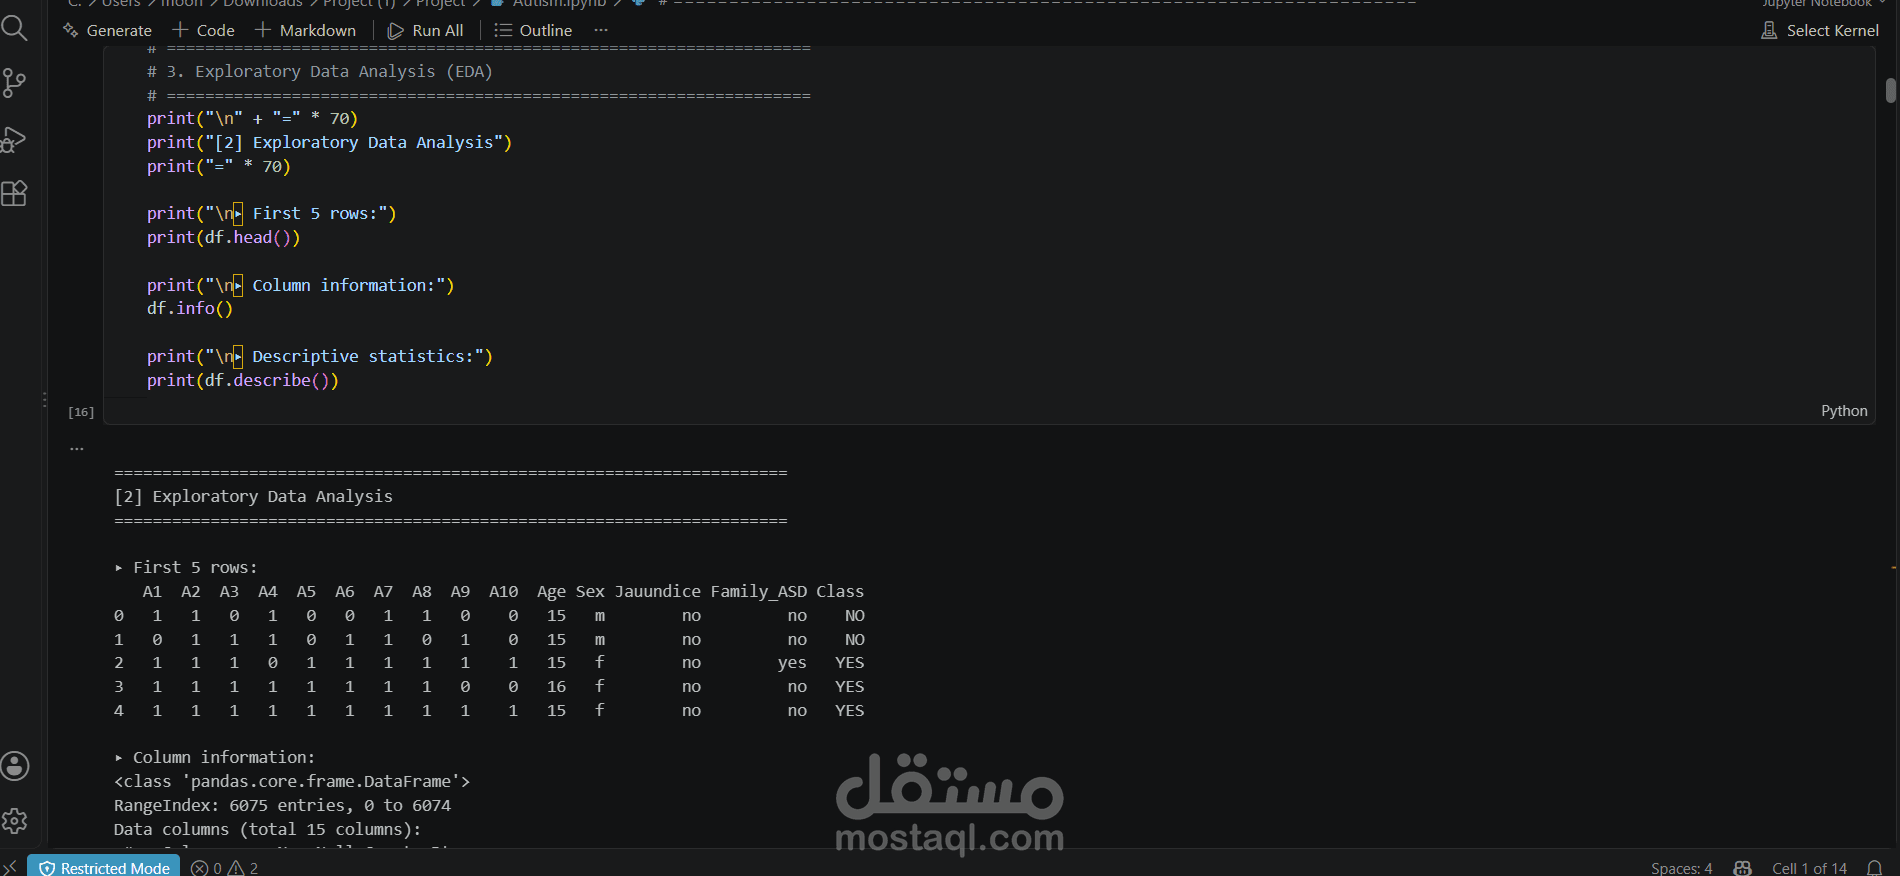
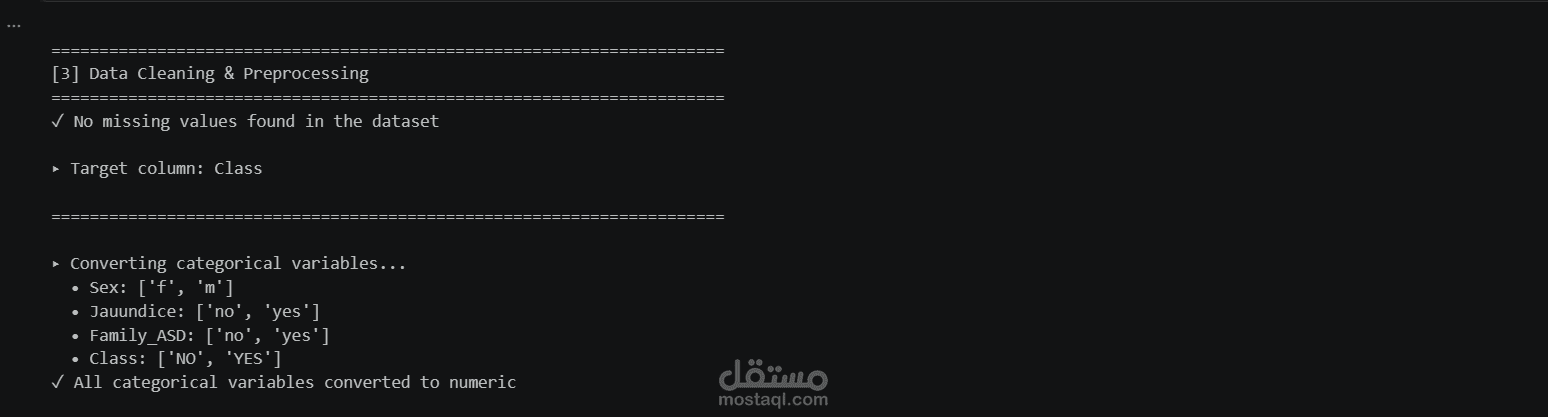
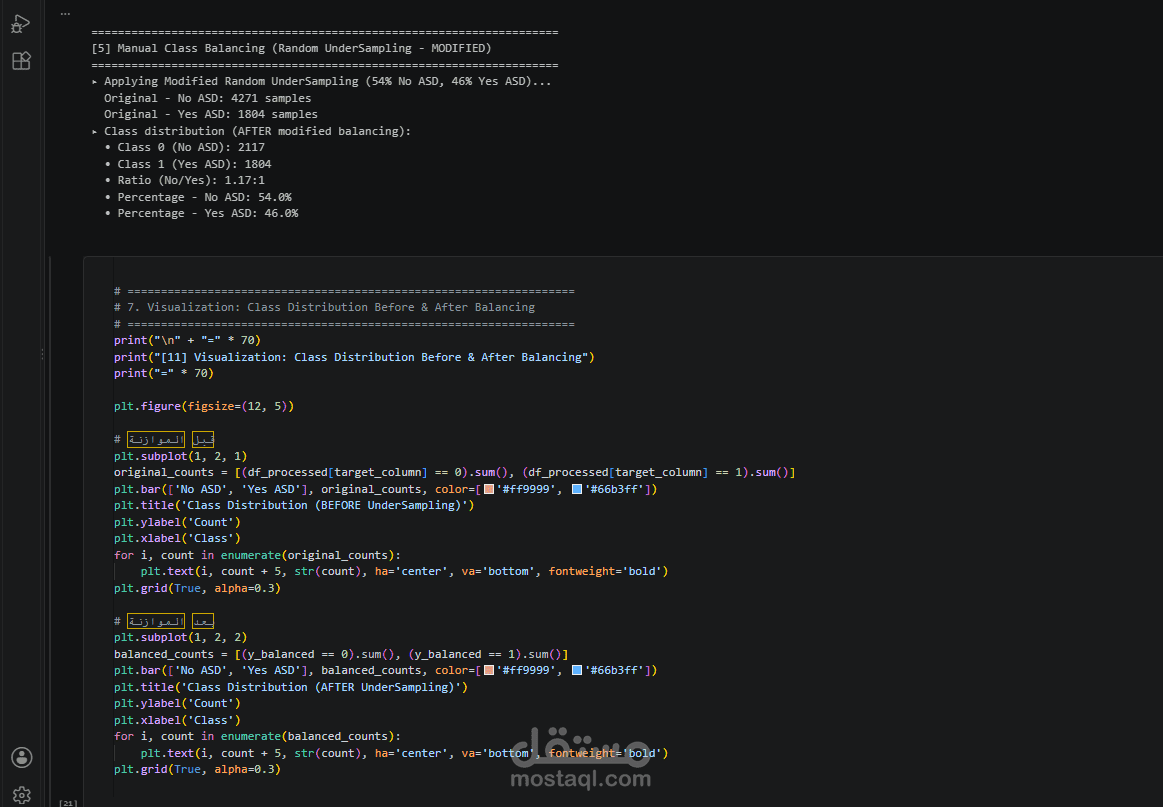
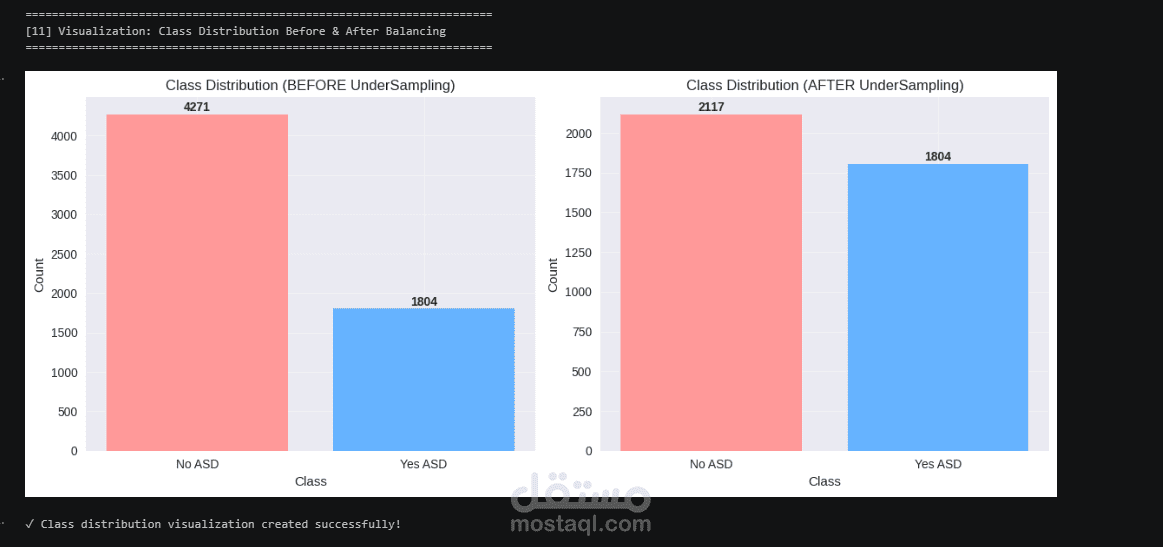
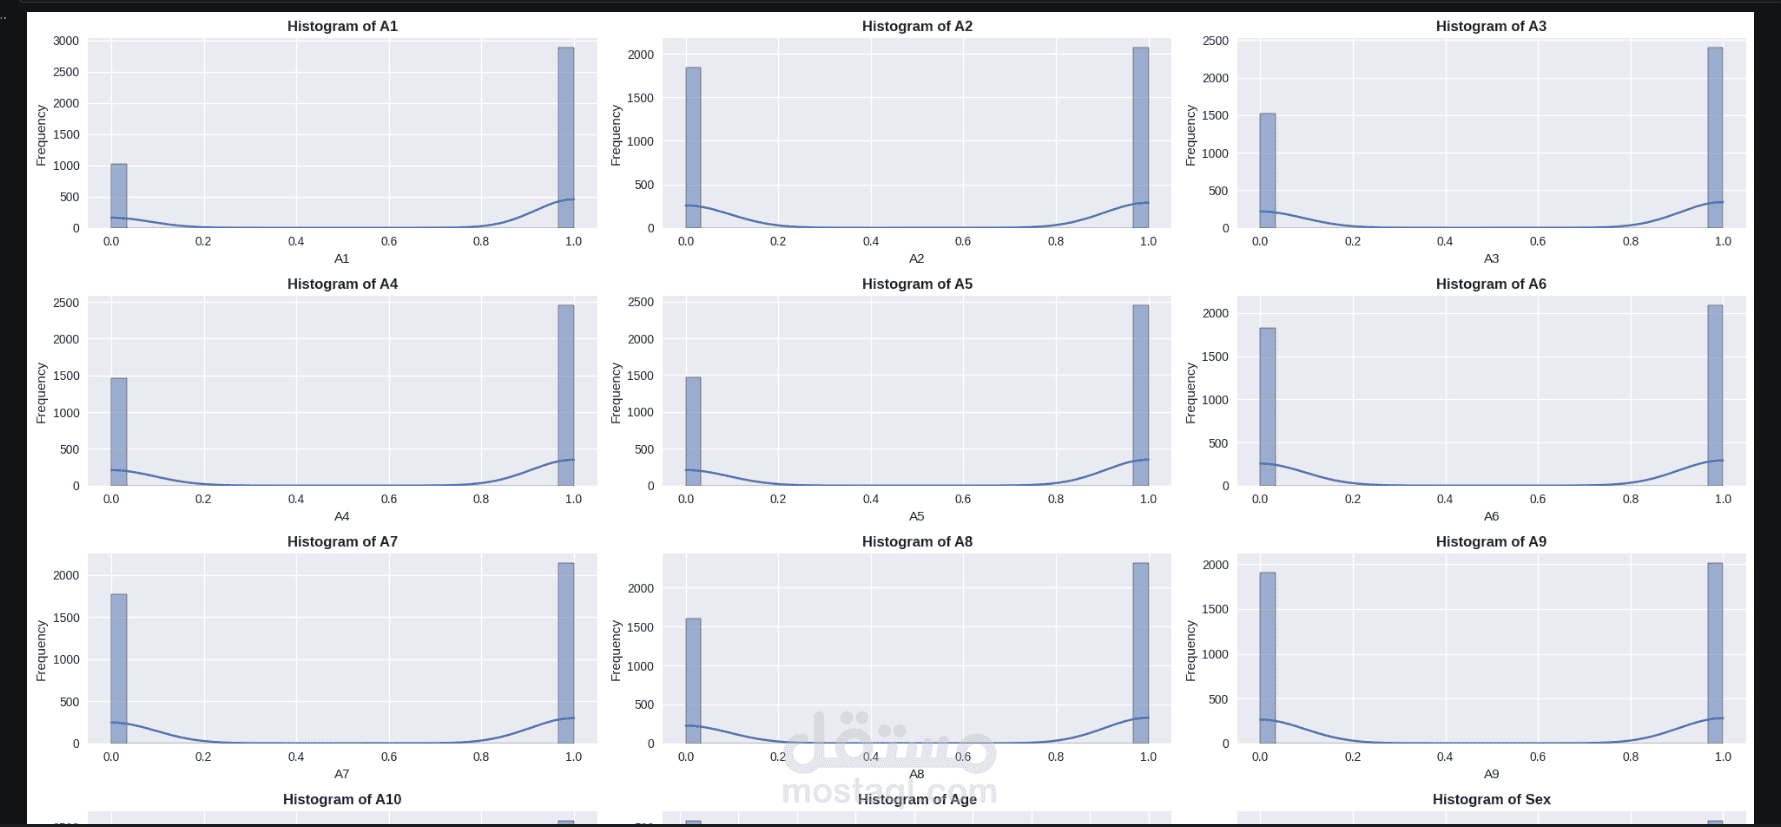
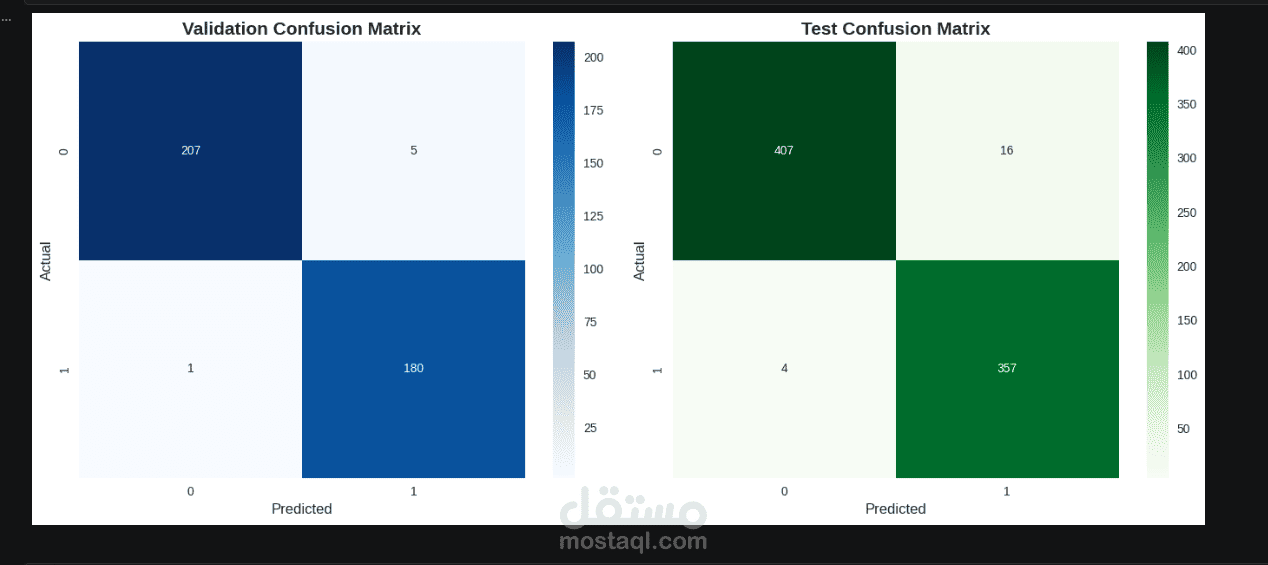
مشروع لتصنيف الحالات إلى فئتين: No ASD و Yes ASD باستخدام بيانات تحتوي على مجموعة من الخصائص. تم تجهيز البيانات وتحويل المتغيرات النصية إلى قيم رقمية، وتحليل العلاقات بين الـ Features، ثم معالجة مشكلة عدم توازن الفئات باستخدام Random UnderSampling. بعد ذلك تم تقسيم البيانات إلى Training وValidation وTest Sets، وتطبيق Standardization، ثم تدريب نموذج Random Forest Classifier وتقييم أدائه باستخدام Accuracy وPrecision وRecall وF1-Score، بالإضافة إلى Confusion Matrix وتحليل منحنيات التعلم.