Internship Selection Prediction
تفاصيل العمل
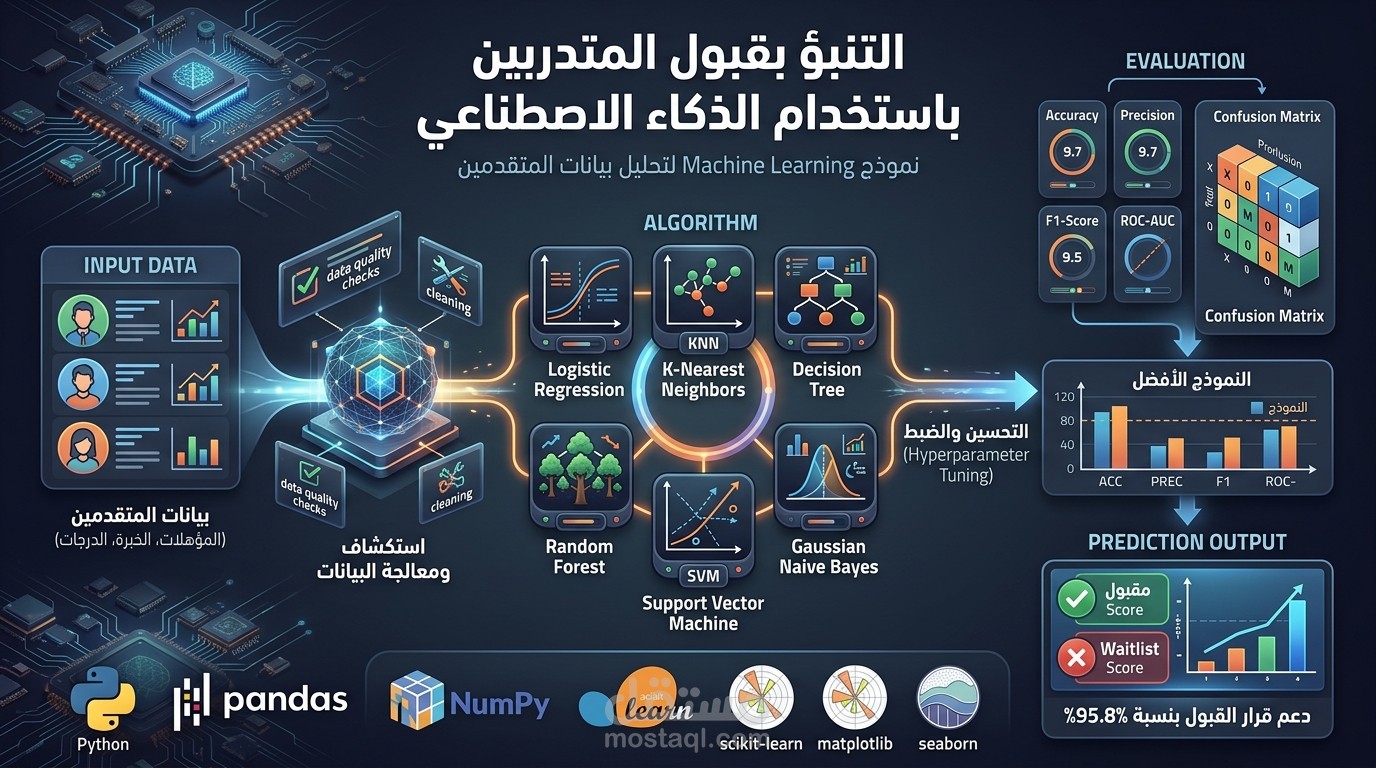
Internship Selection Prediction – التنبؤ بقبول المتدربين
هل يمكن الاستفادة من بيانات المتقدمين للتنبؤ بفرص قبولهم في برامج التدريب؟
في هذا المشروع، عملت على بناء نموذج Machine Learning يساعد في التنبؤ بقبول المتدربين بالاعتماد على البيانات المتاحة عن كل متقدم.
بدأت أولًا بفهم البيانات واستكشافها للتعرف على المتغيرات الموجودة والعلاقات بينها، ثم انتقلت إلى مرحلة تنظيف البيانات وتجهيزها لاستخدامها في نماذج التعلم الآلي. شمل ذلك معالجة البيانات وتجهيز المتغيرات الفئوية وتحويلها إلى صورة مناسبة للنماذج، بالإضافة إلى تطبيق Scaling على البيانات عند الحاجة.
بعد تجهيز البيانات، قمت بتدريب وتجربة مجموعة من نماذج التصنيف المختلفة، ومقارنتها لمعرفة أي منها يقدم نتائج أفضل مع بيانات المشروع، ومنها:
* Logistic Regression
* K-Nearest Neighbors (KNN)
* Decision Tree
* Random Forest
* Support Vector Machine (SVM)
* Gaussian Naive Bayes
لم أكتفِ بتدريب النماذج، بل ركزت على تقييم أدائها بشكل مفصل باستخدام Accuracy, Precision, Recall, F1-Score وROC-AUC ، إلى جانب Confusion Matrix لفهم حالات التنبؤ الصحيحة والأخطاء التي ارتكبتها النماذج.
بعد مقارنة النتائج، قمت بإجراء Hyperparameter Tuning لتحسين أداء النماذج ودراسة الإعدادات التي يمكن أن تؤثر على نتائجها، ثم قارنت النتائج النهائية للمساعدة في اختيار النموذج الأنسب للمشكلة.
دوري في المشروع
كان دوري بشكل أساسي في تحليل نتائج النماذج ومقارنتها، إجراء الاختبارات اللازمة، تنفيذ Hyperparameter Tuning، وتحليل مقاييس التقييم للوصول إلى النموذج الأكثر ملاءمة للبيانات.
الأدوات والتقنيات المستخدمة
Python • Pandas • NumPy • Scikit-learn • Matplotlib • Seaborn • Machine Learning
الهدف من المشروع
الهدف من المشروع هو الاستفادة من البيانات المتاحة عن المتقدمين وتحويلها إلى تنبؤات يمكن استخدامها كعامل مساعد في عملية اختيار المتدربين، بدلًا من الاعتماد على البيانات بشكل غير منظم.