Obesity Level Prediction | Machine Learning Classification
تفاصيل العمل
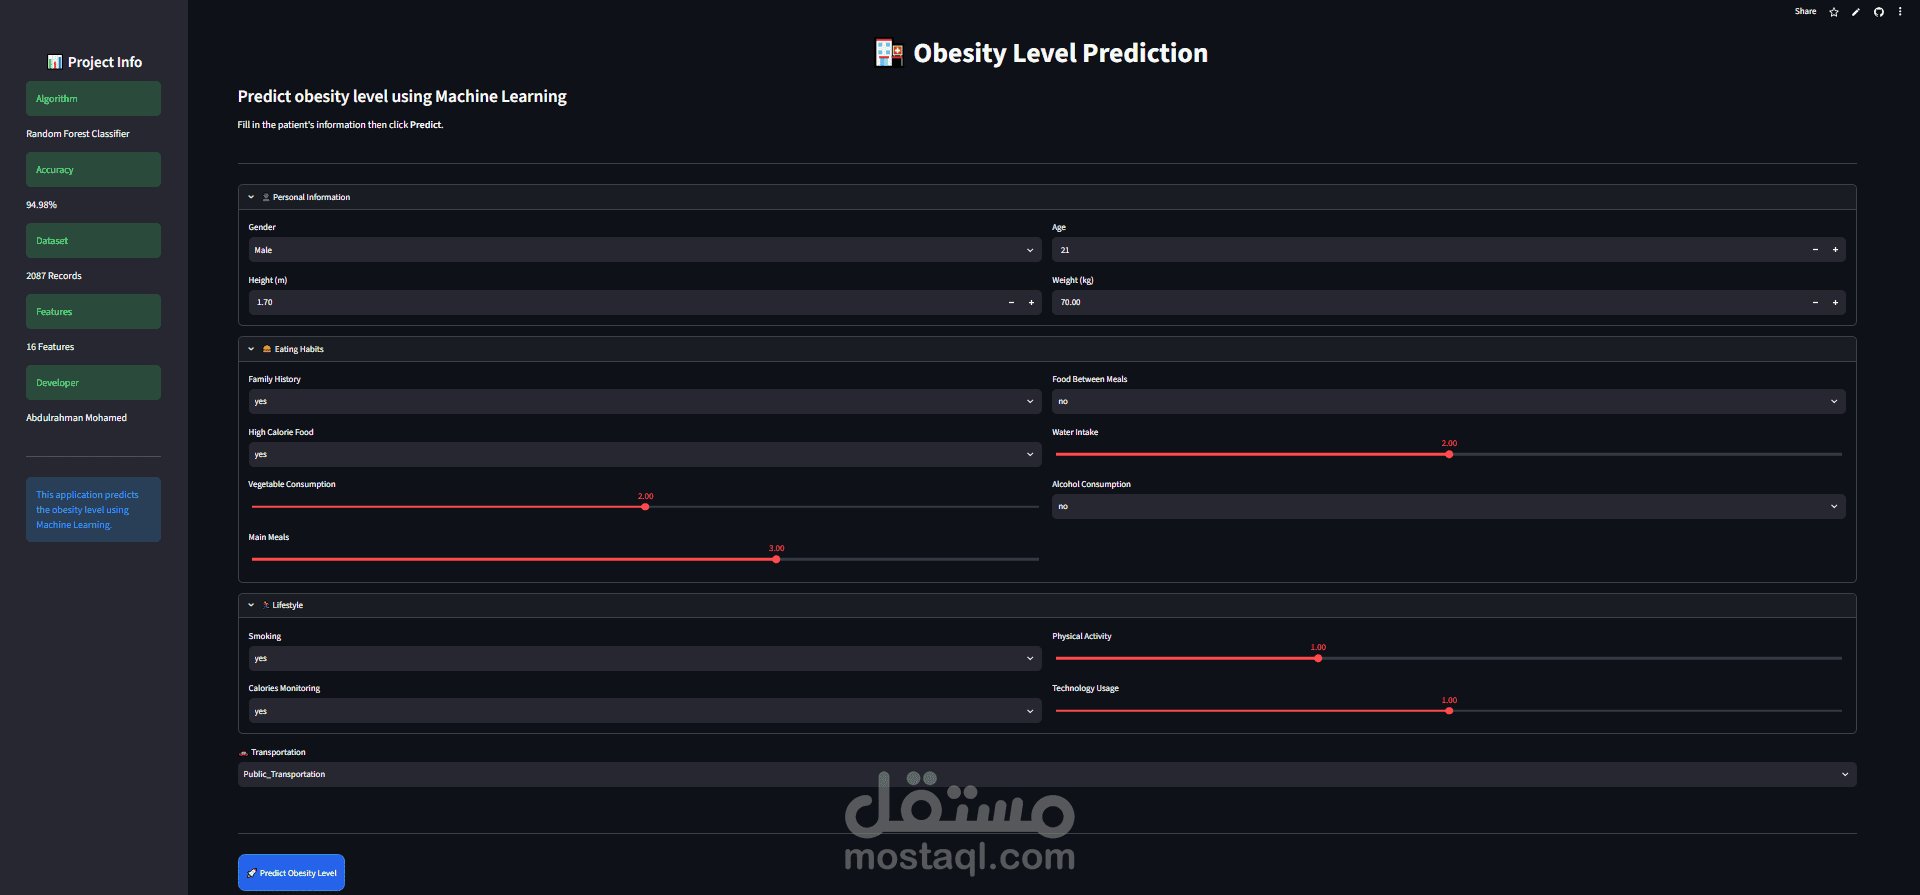
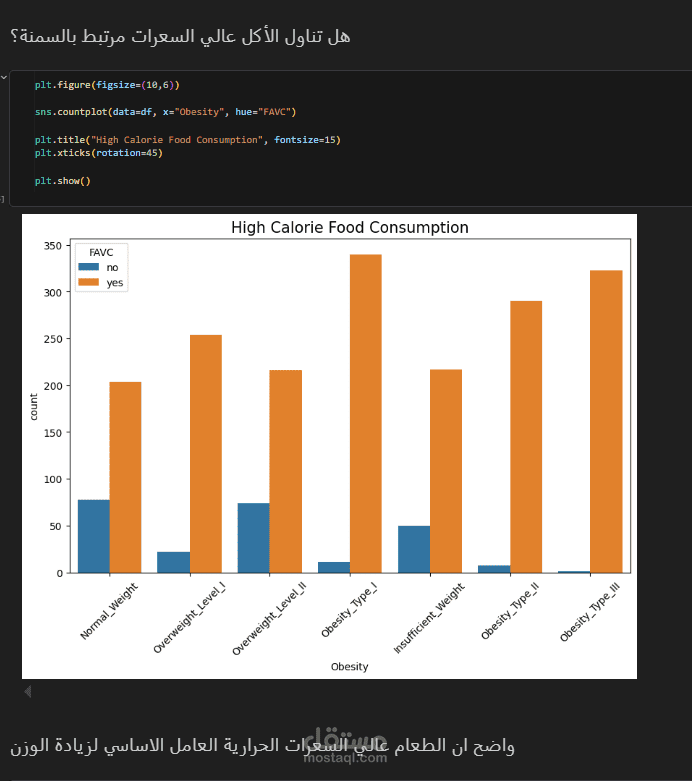
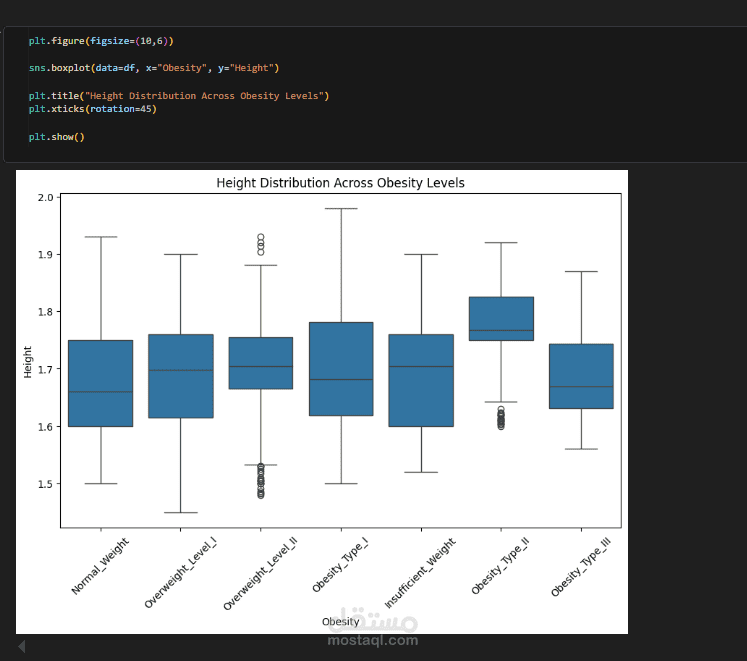
مشروع Machine Learning لتصنيف مستويات السمنة اعتمادًا على مجموعة من الخصائص الجسدية والعادات الغذائية والسلوكيات ونمط الحياة.
تم تنفيذ المشروع باستخدام Python بدايةً من فهم البيانات وتحليلها، مرورًا بمرحلة Exploratory Data Analysis (EDA) وتجهيز البيانات، ثم تدريب ومقارنة نماذج Machine Learning، وصولًا إلى تقييم النموذج الأفضل ونشره كتطبيق ويب تفاعلي باستخدام Streamlit.
### مراحل تنفيذ المشروع
• تحليل وفهم Dataset تحتوي على 2,111 سجلًا و16 Feature.
• فحص البيانات وأنواع المتغيرات والقيم المفقودة والبيانات المكررة.
• إجراء Exploratory Data Analysis لفهم توزيع البيانات والعلاقات بين المتغيرات.
• تنفيذ Univariate وBivariate وMultivariate Analysis بالإضافة إلى Correlation Analysis.
• تنظيف البيانات وإزالة السجلات المكررة.
• تجهيز Features وTarget للتدريب.
• معالجة المتغيرات المختلفة باستخدام ColumnTransformer.
• استخدام StandardScaler للمتغيرات الرقمية.
• استخدام OneHotEncoder للمتغيرات الاسمية.
• استخدام OrdinalEncoder للمتغيرات الترتيبية.
### نماذج Machine Learning
تم تدريب ومقارنة نموذجين للتصنيف:
• Logistic Regression — Accuracy: 88.52%
• Random Forest Classifier — Accuracy: 94.98%
وبناءً على النتائج، تم اختيار Random Forest كنموذج نهائي للمشروع.
### Model Evaluation
تم تقييم أداء النموذج باستخدام:
• Accuracy Score
• Confusion Matrix
• Classification Report
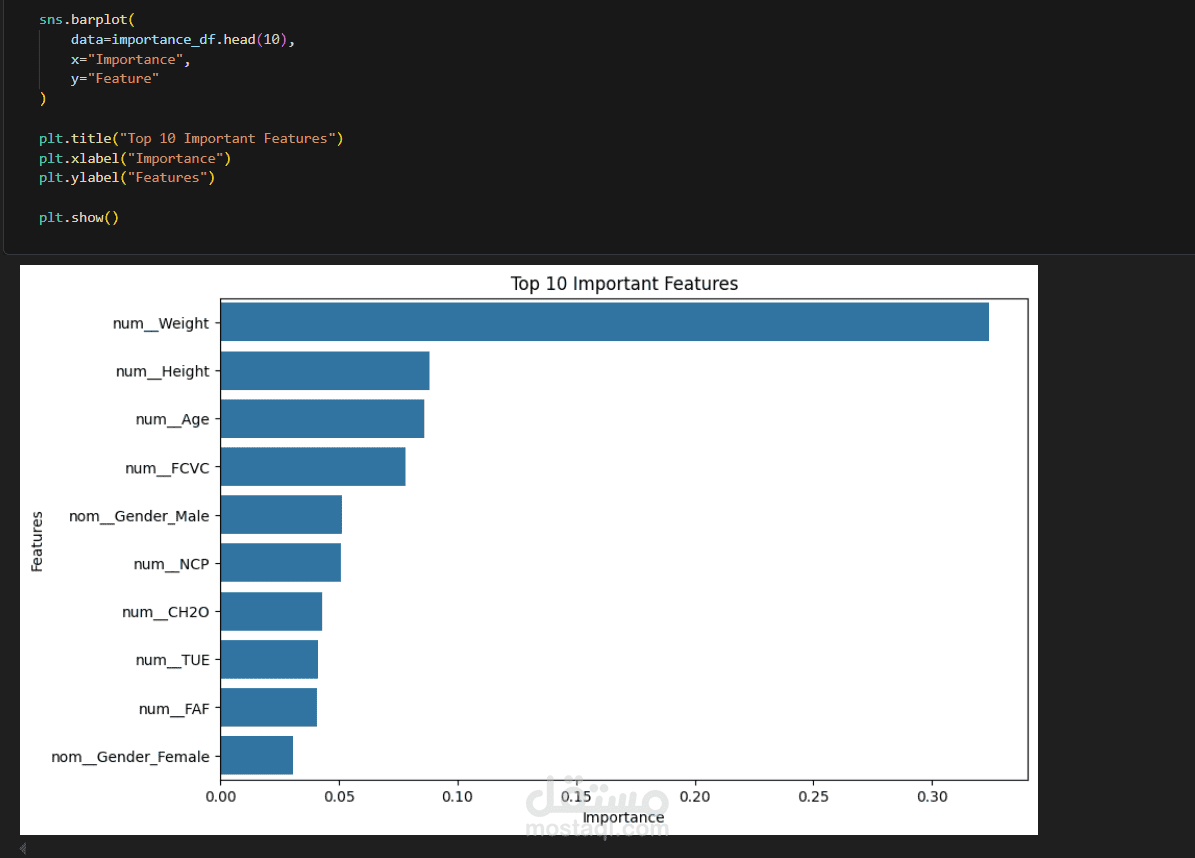
• Feature Importance
كما تم تحليل أهمية الخصائص لمعرفة العوامل الأكثر تأثيرًا في عملية التنبؤ، ومن أبرزها Weight وHeight وAge وبعض عوامل نمط الحياة.
### Deployment
تم تحويل النموذج النهائي إلى تطبيق ويب تفاعلي باستخدام Streamlit، بحيث يستطيع المستخدم إدخال البيانات الشخصية وعوامل نمط الحياة والحصول على مستوى السمنة المتوقع بشكل مباشر.
### التقنيات المستخدمة
Python – Pandas – NumPy – Scikit-learn – Matplotlib – Seaborn – Joblib – Streamlit
### النتيجة
تم بناء Pipeline متكامل للتنبؤ يبدأ من Data Understanding وEDA وData Preprocessing، ثم Model Training وEvaluation، وينتهي بنشر نموذج Machine Learning داخل تطبيق تفاعلي قابل للاستخدام.