ستخراج وتحليل بيانات الكتب باستخدام Python وWeb Scraping
تفاصيل العمل
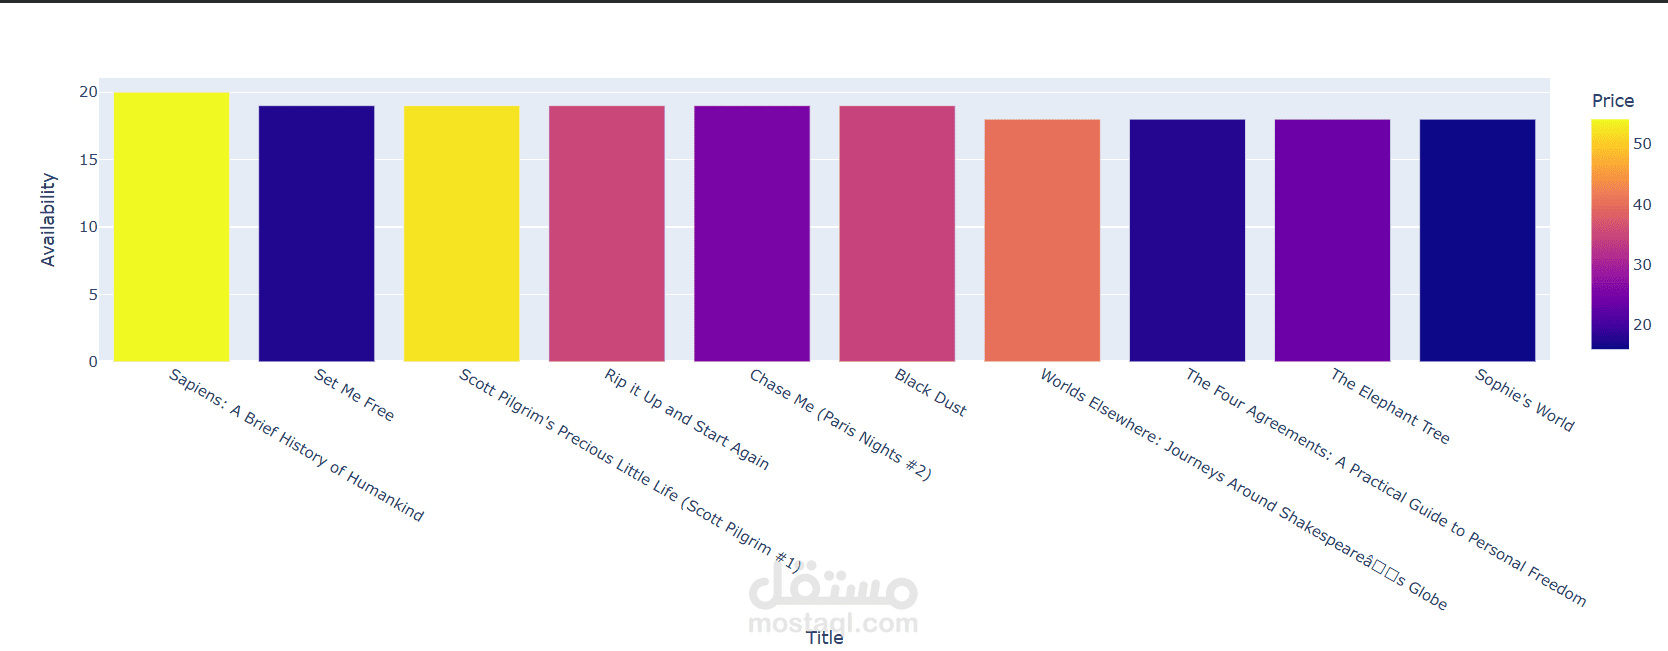
قمت بتنفيذ مشروع لاستخراج وتحليل بيانات الكتب من موقع Books to Scrape باستخدام Python.
شمل العمل:
- جمع بيانات جميع الكتب عبر صفحات الموقع باستخدام Requests وBeautifulSoup.
- استخراج: اسم الكتاب، السعر، التقييم، حالة/كمية التوفر، والتصنيف.
- تنظيم البيانات داخل DataFrame باستخدام Pandas وتصديرها إلى ملف CSV.
- تنظيف البيانات وتحويل السعر إلى رقم والتوفر إلى كمية رقمية، وتحويل التقييمات من نص إلى قيم من 1 إلى 5.
- فحص البيانات للتأكد من عدم وجود قيم مكررة أو ناقصة.
- إجراء تحليل استكشافي للبيانات باستخدام الإحصاءات الوصفية.
- إنشاء رسوم بيانية تفاعلية باستخدام Plotly لتحليل:
- الكتب الأعلى تقييمًا والأكثر توافرًا في المخزون.
- الكتب ذات التقييم المرتفع والسعر الأقل.
- التصنيفات التي تضم أكبر عدد من الكتب بتقييم 5 نجوم وإجمالي مخزونها.
الأدوات المستخدمة: Python، Pandas، Requests، BeautifulSoup، Matplotlib، Seaborn، Plotly.