تنظيف وتجهيز وتحليل بيانات نجاح الطلاب باستخدام Python
تفاصيل العمل
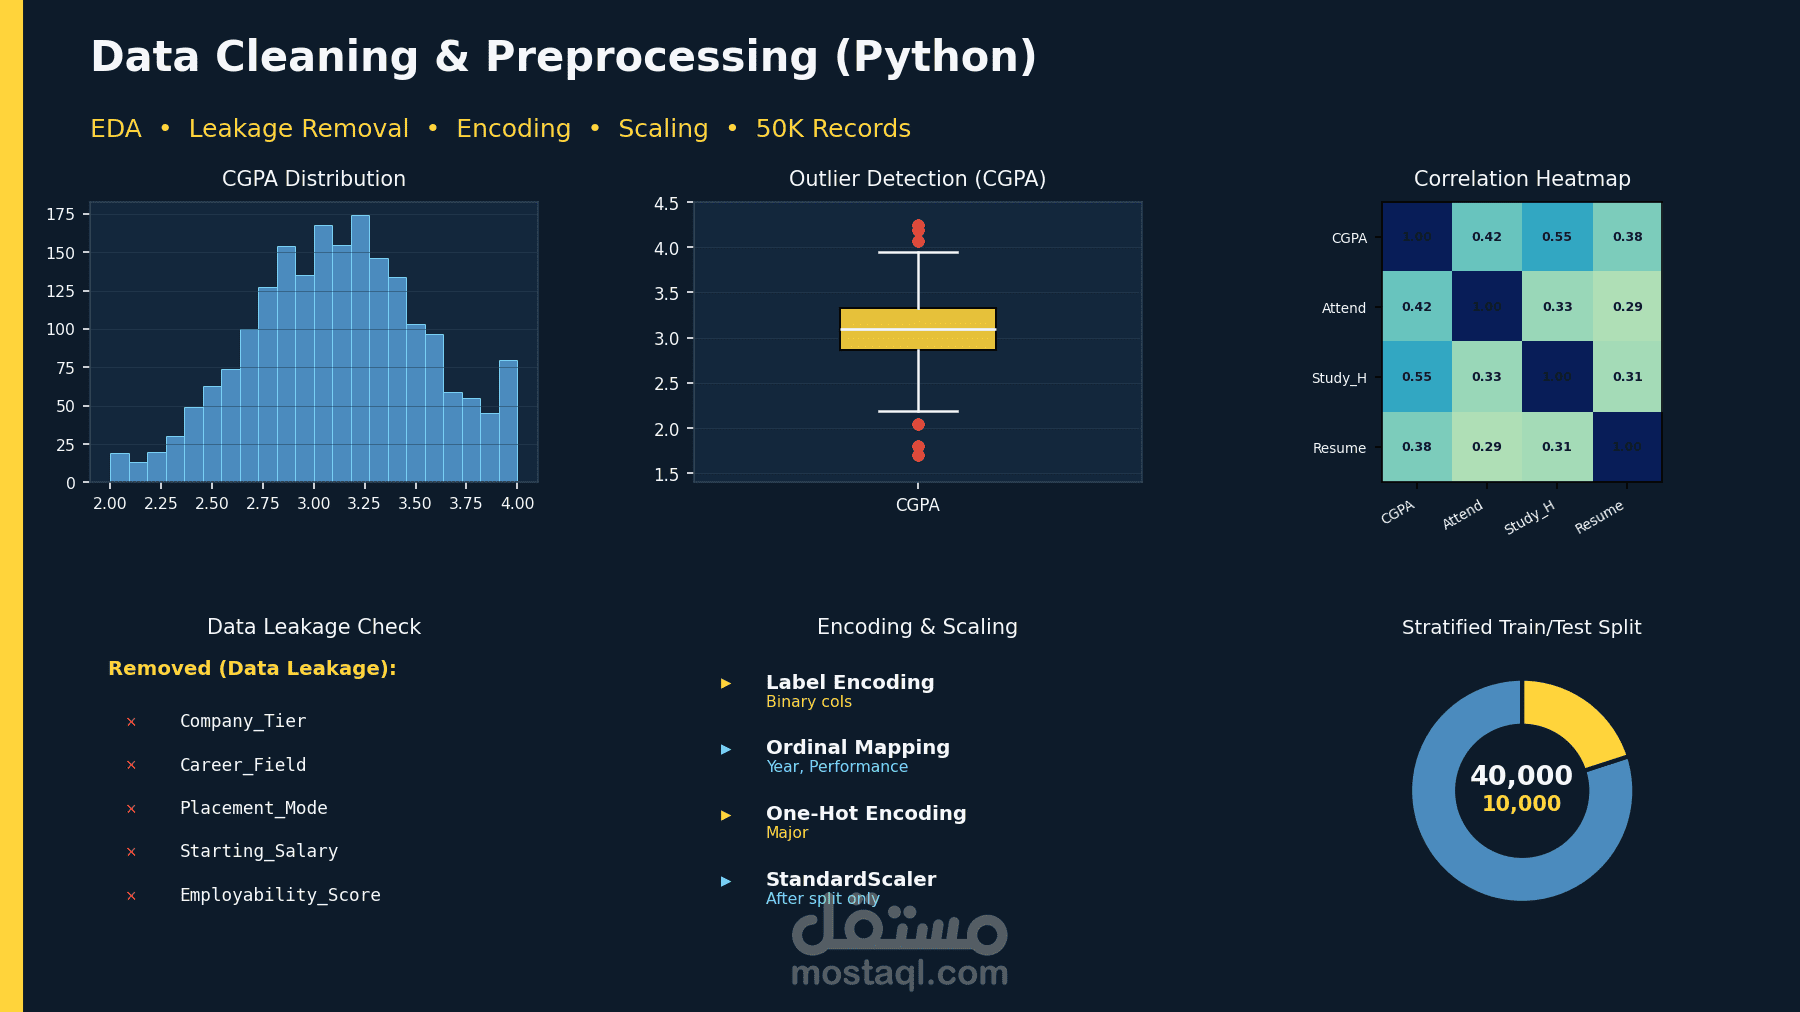
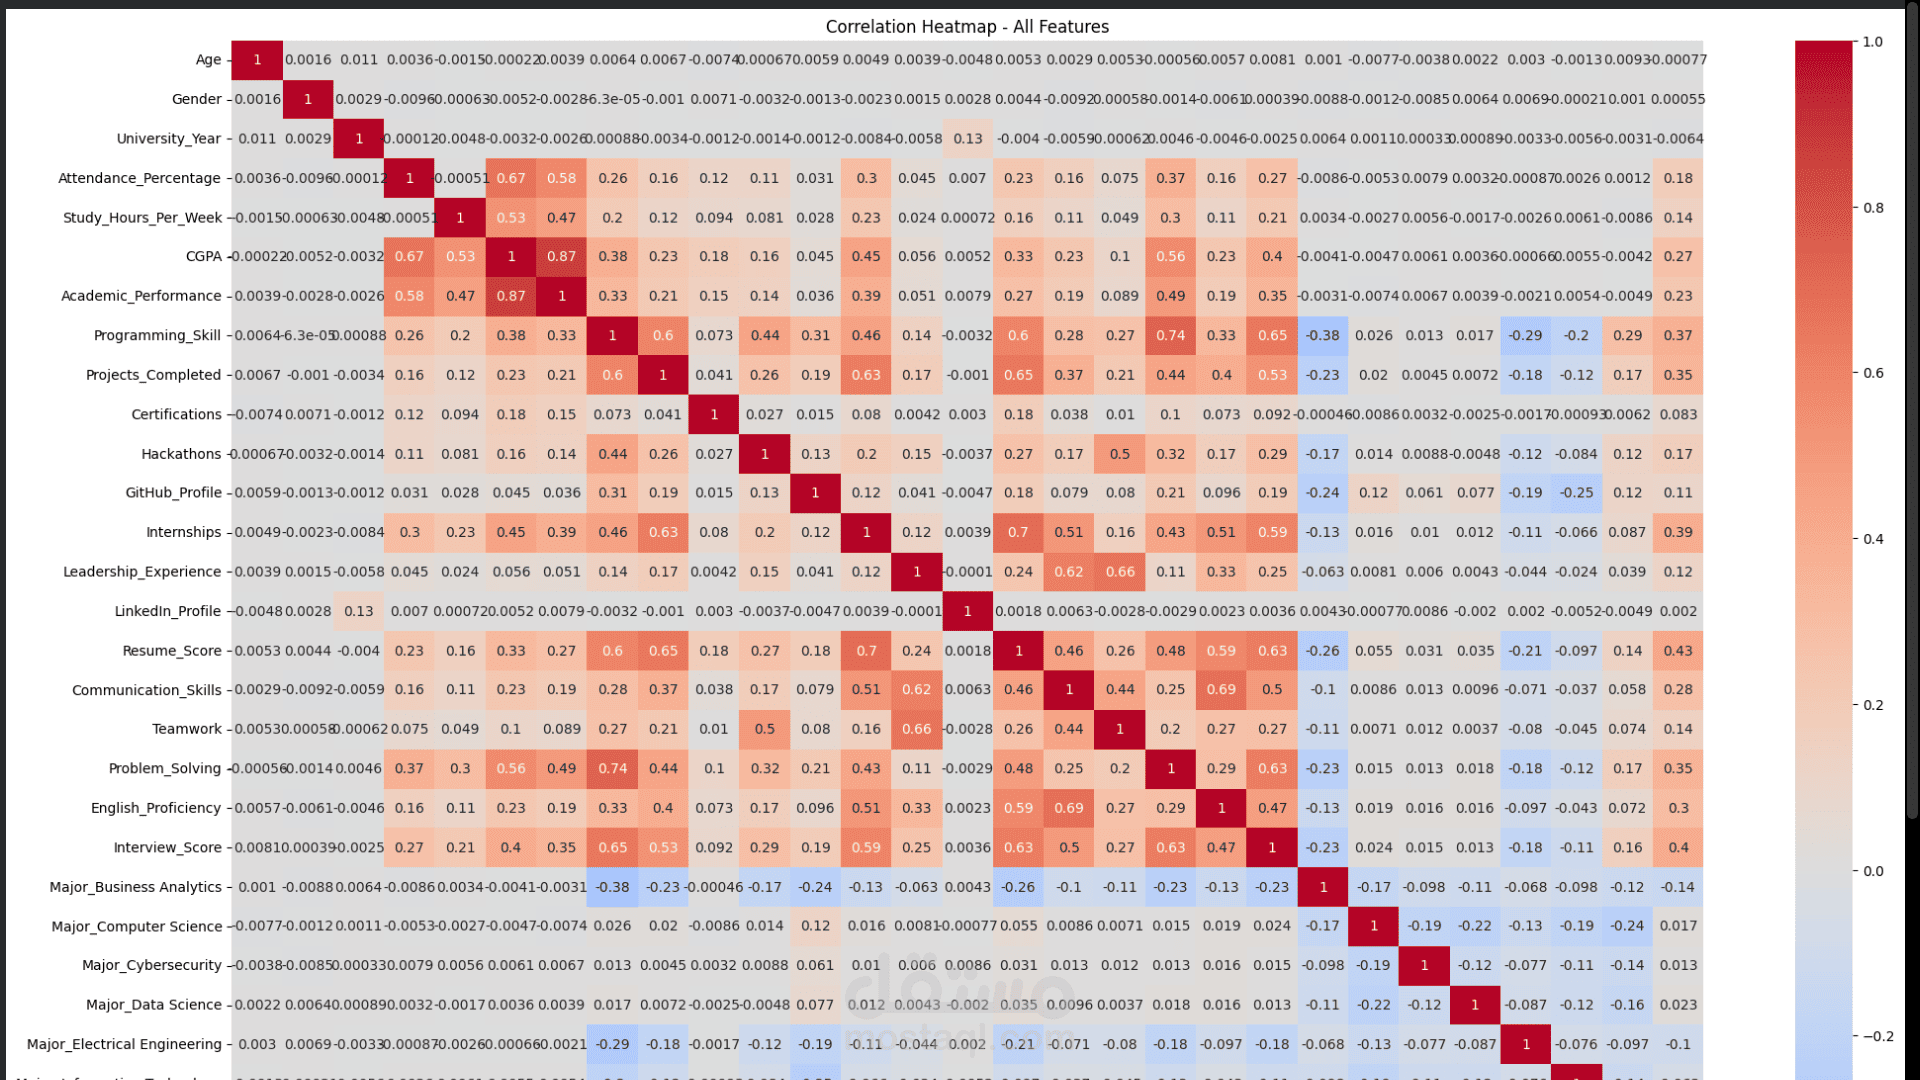
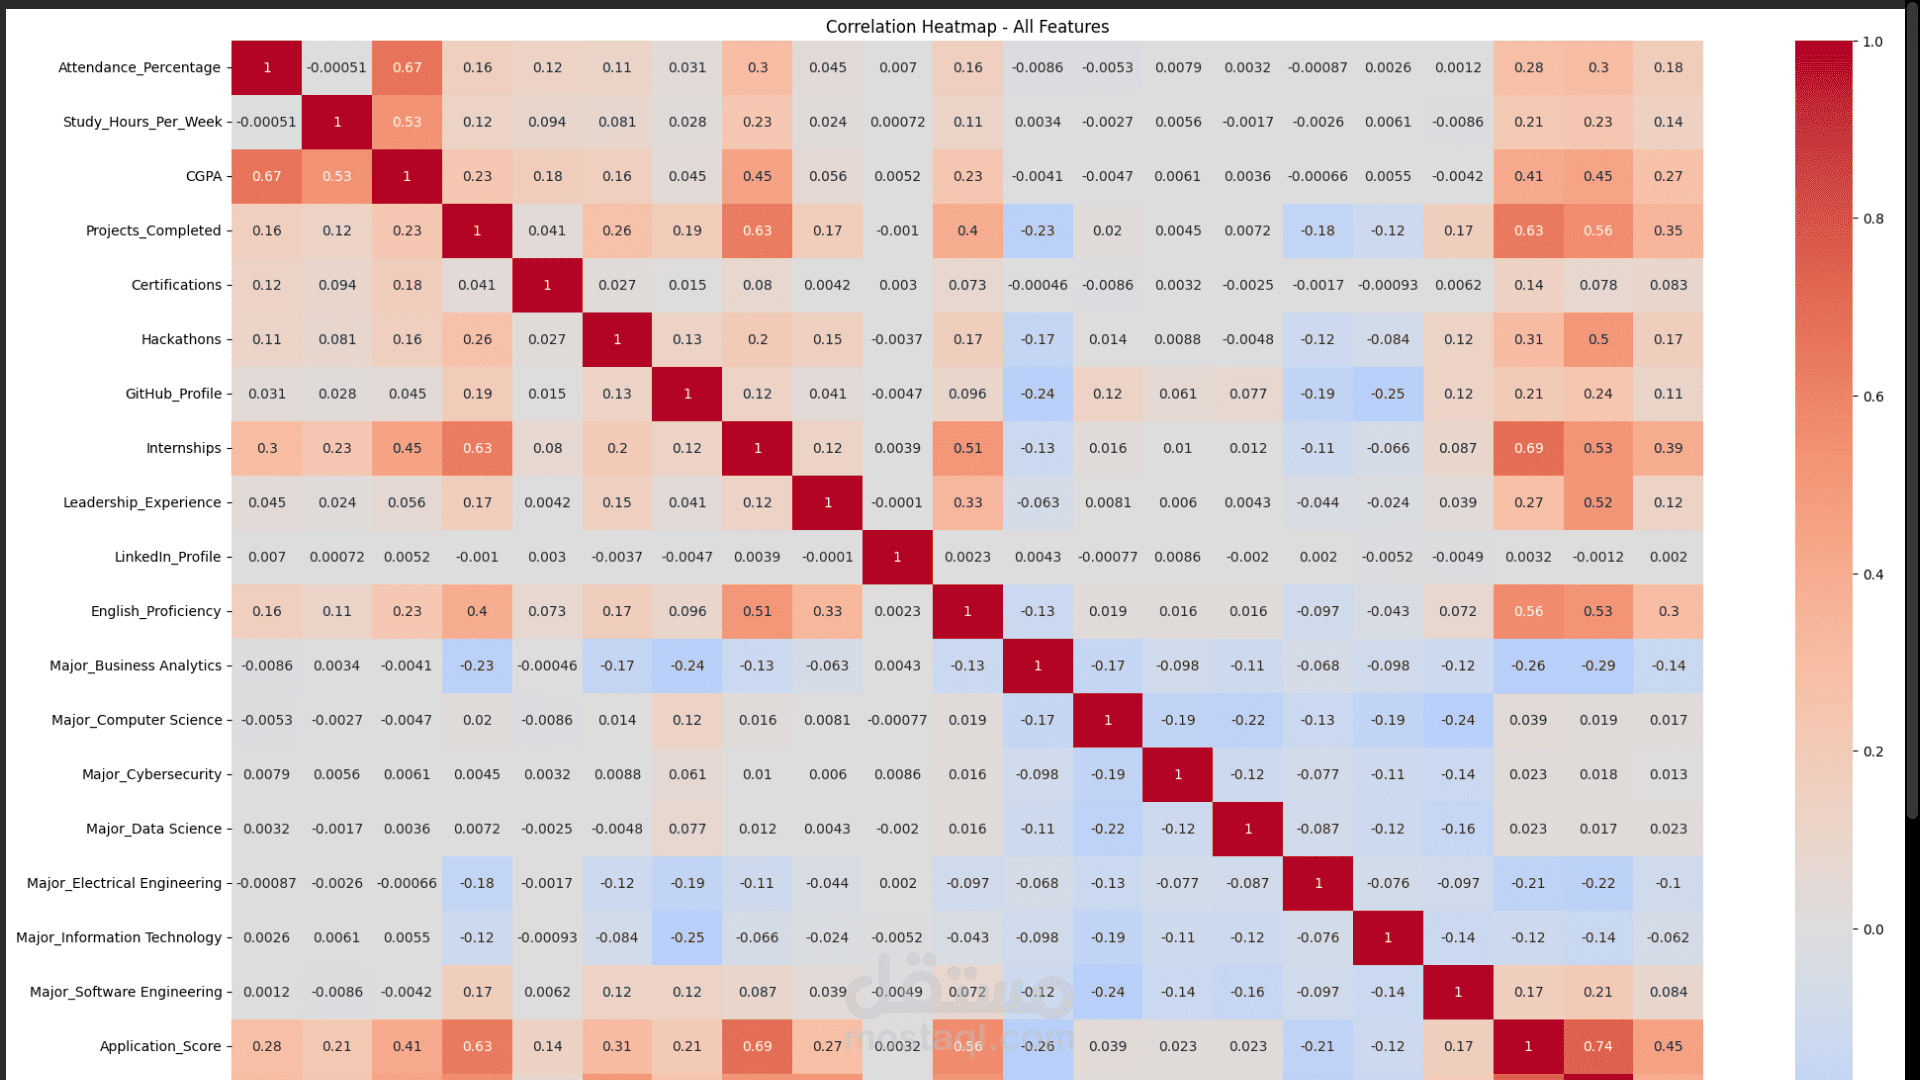
في هذا الجزء من المشروع قمت بتجهيز وتحليل Dataset تحتوي على بيانات 50,000 طالب و29 متغيرًا، بهدف إعداد البيانات بشكل مناسب لمرحلة Machine Learning.
شملت مرحلة العمل:
-فحص هيكل البيانات وأنواع المتغيرات باستخدام info()وdescribe().
-التحقق من وجود Missing Values وDuplicate Records.
- تحليل المتغيرات وفهم طبيعتها وقيمها المختلفة.
-تحديد المتغيرات التي قد تسبب Data Leakageواستبعادها من الـFeatures، مثل`Company_Tier` و`Career_Field` و`Placement_Mode` و`Starting_Salary_USD` و`Employability_Score`. - التعامل مع الـCategorical Features حسب طبيعة كل متغير؛ باستخدام Label Encoding / Mappingللمتغيرات المناسبة، وOne-Hot Encodingللـ Major.
- إجراء EDA باستخدام الرسوم البيانية لفهم توزيع البيانات والعلاقات بين المتغيرات.
- تقسيم البيانات إلى Training وTesting Sets باستخدام train_test_split مع stratify.
- تطبيق StandardScalerعلى البيانات بعد تقسيمها.
الأدوات المستخدمة:
Python, Pandas, NumPy, Matplotlib, Seaborn, Scikit-learn.