Default of Credit Card Clients-ML-Project
تفاصيل العمل
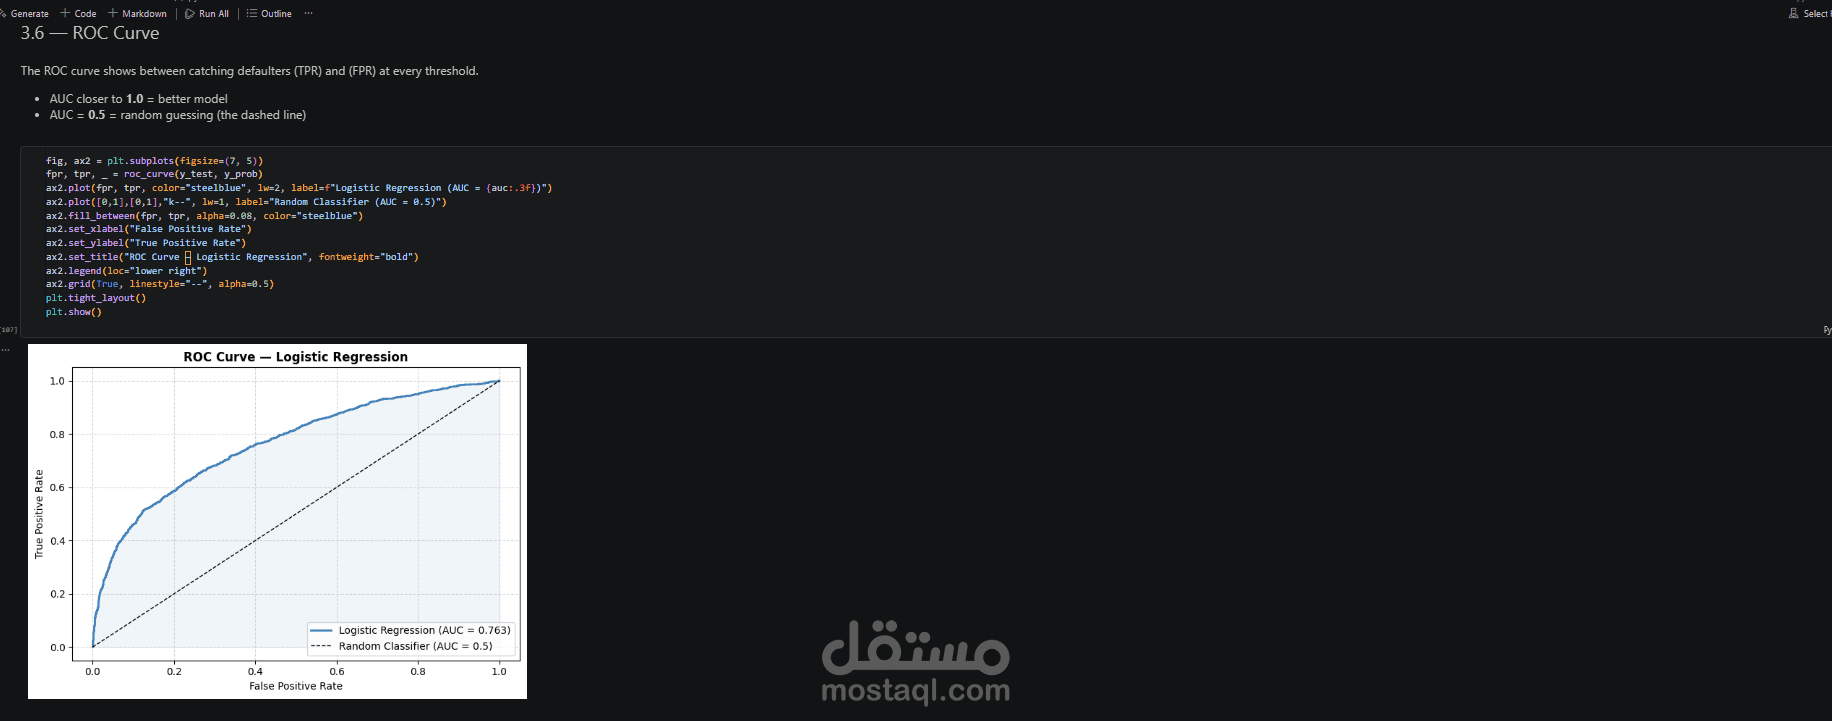
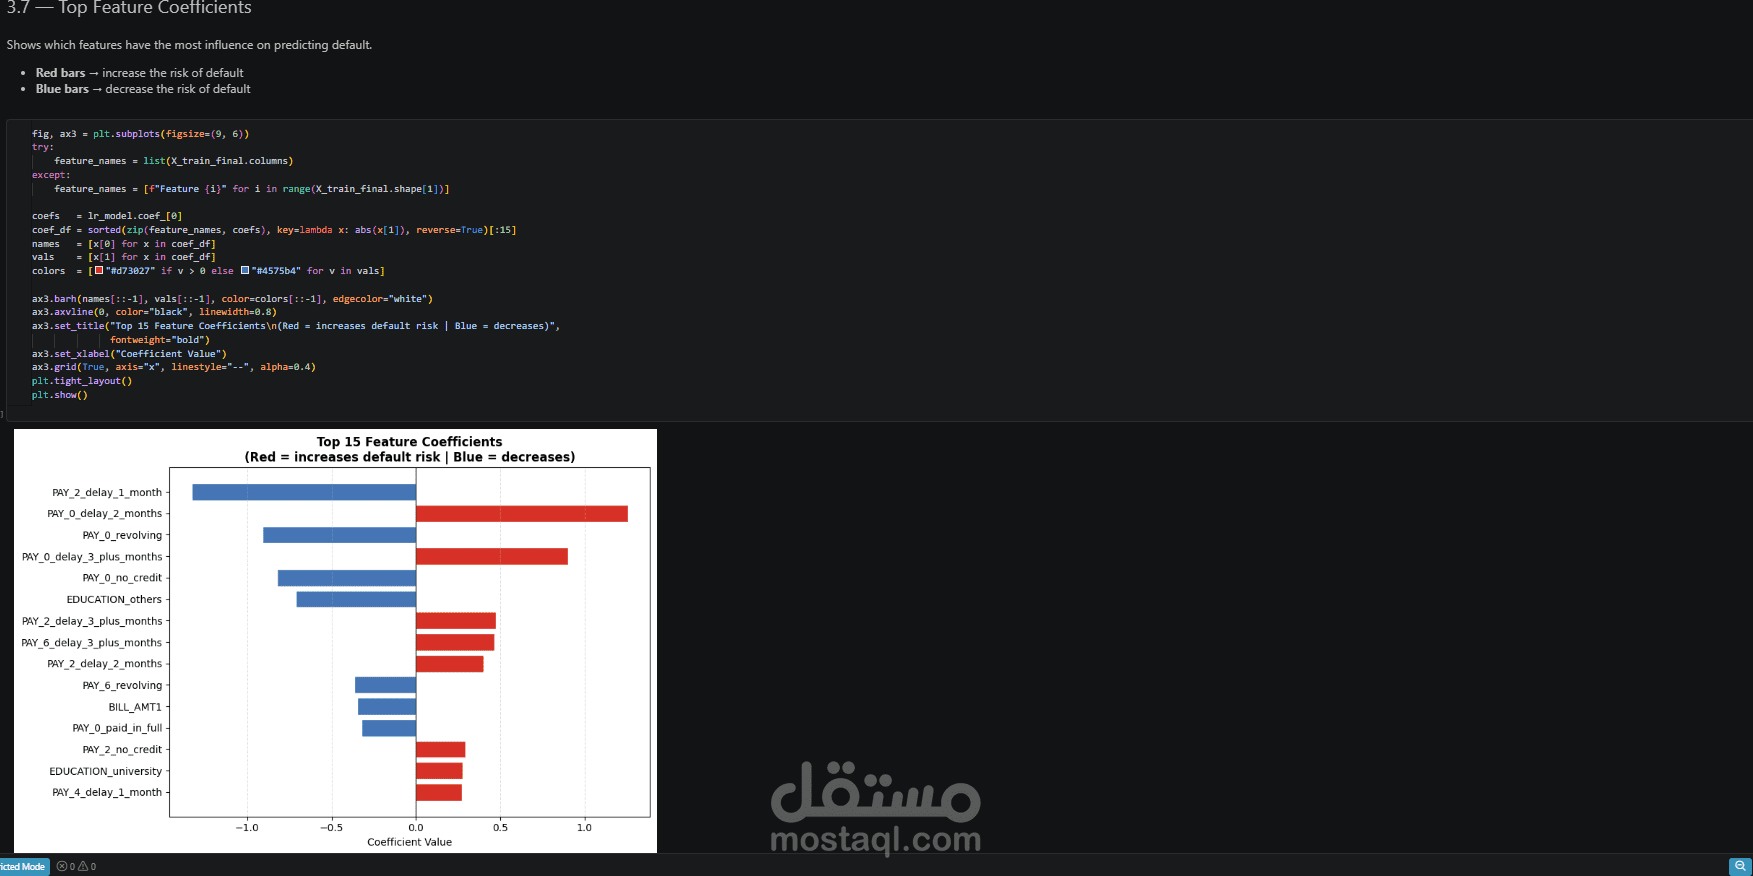
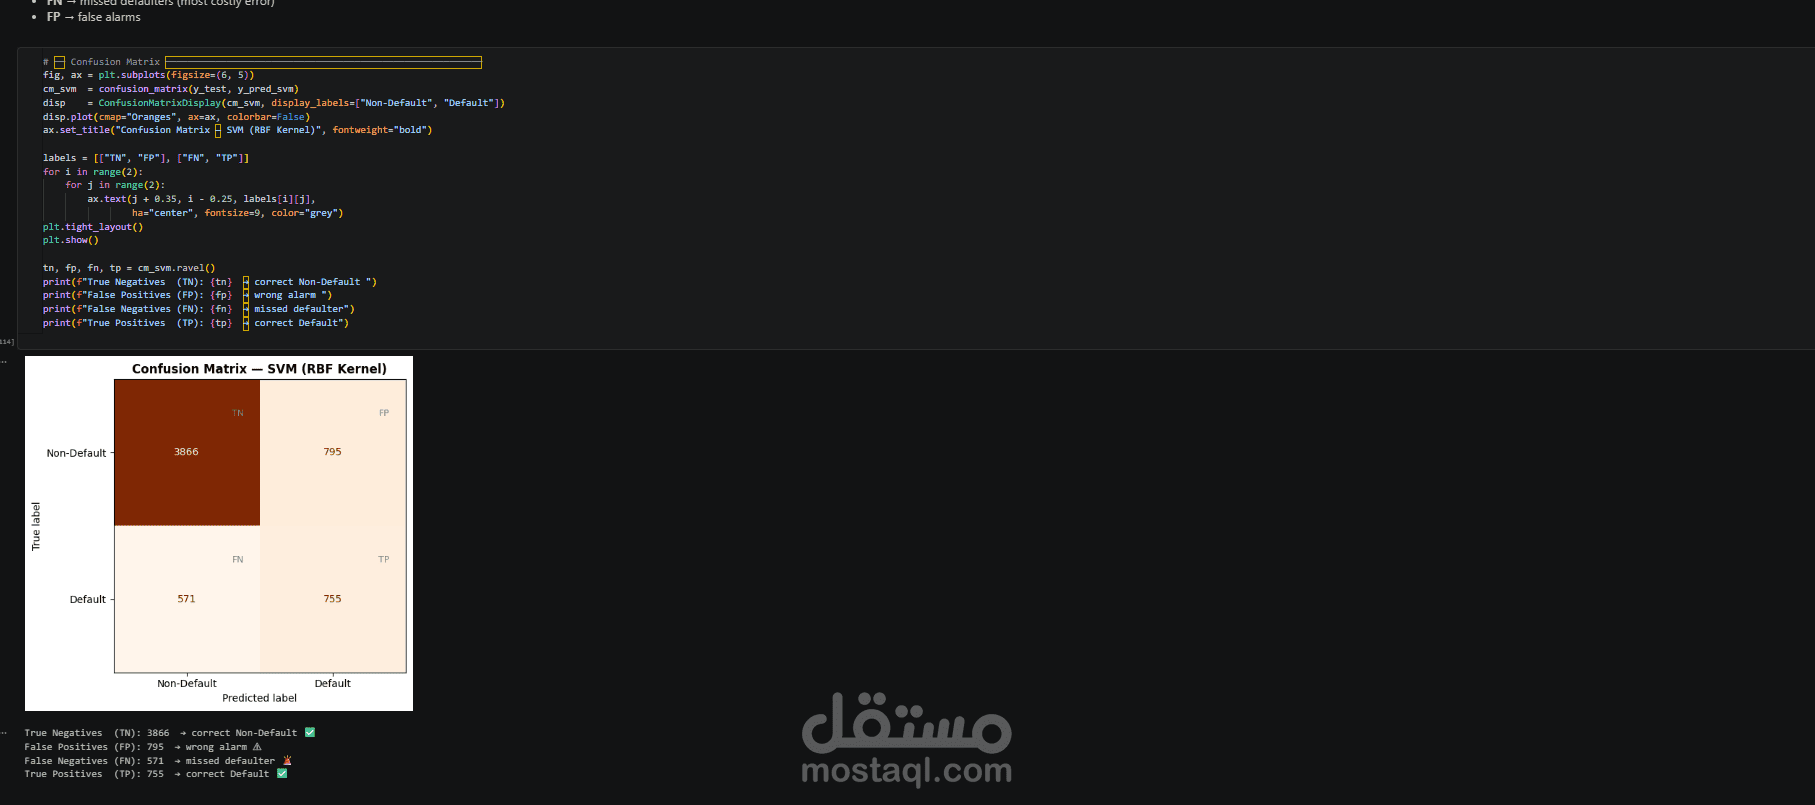
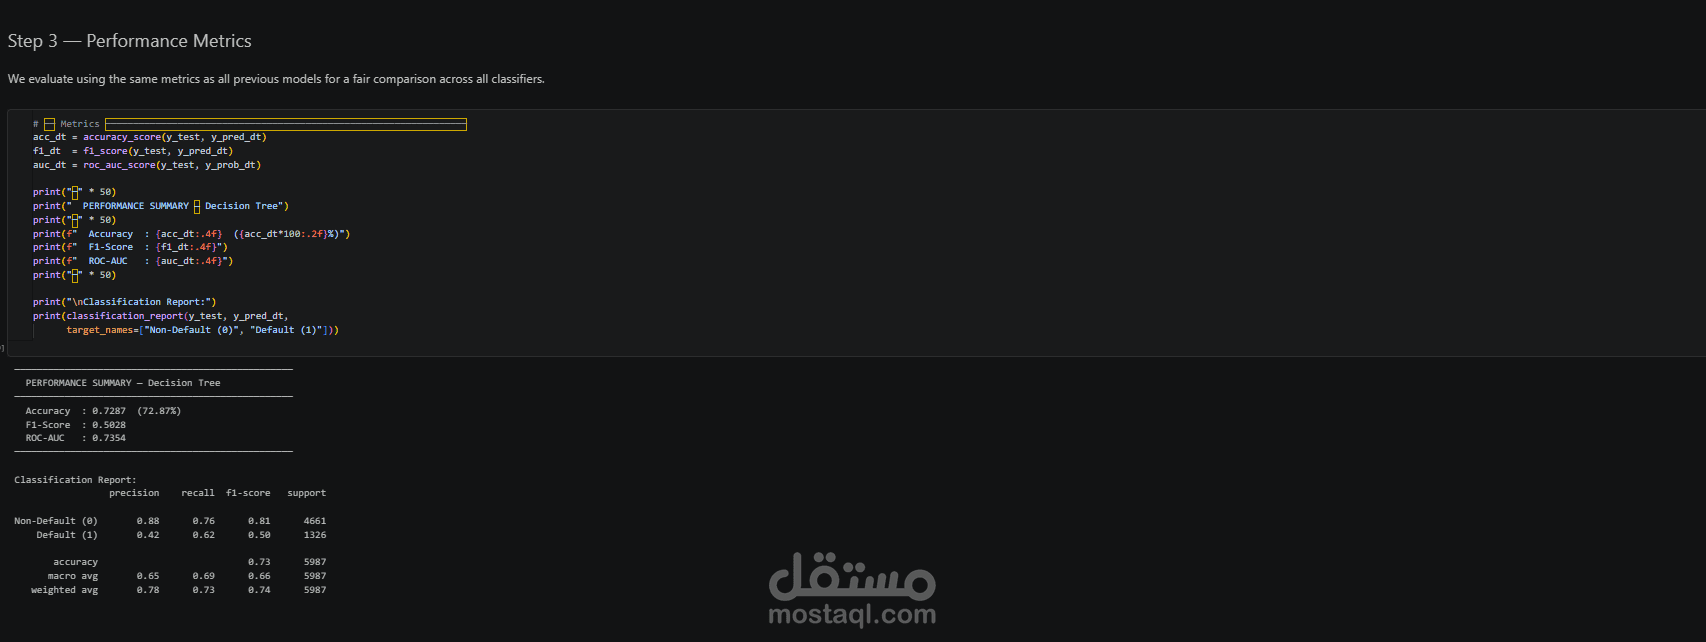
وصف مشروع توقع تعثر سداد بطاقات الائتمان باستخدام Machine Learning
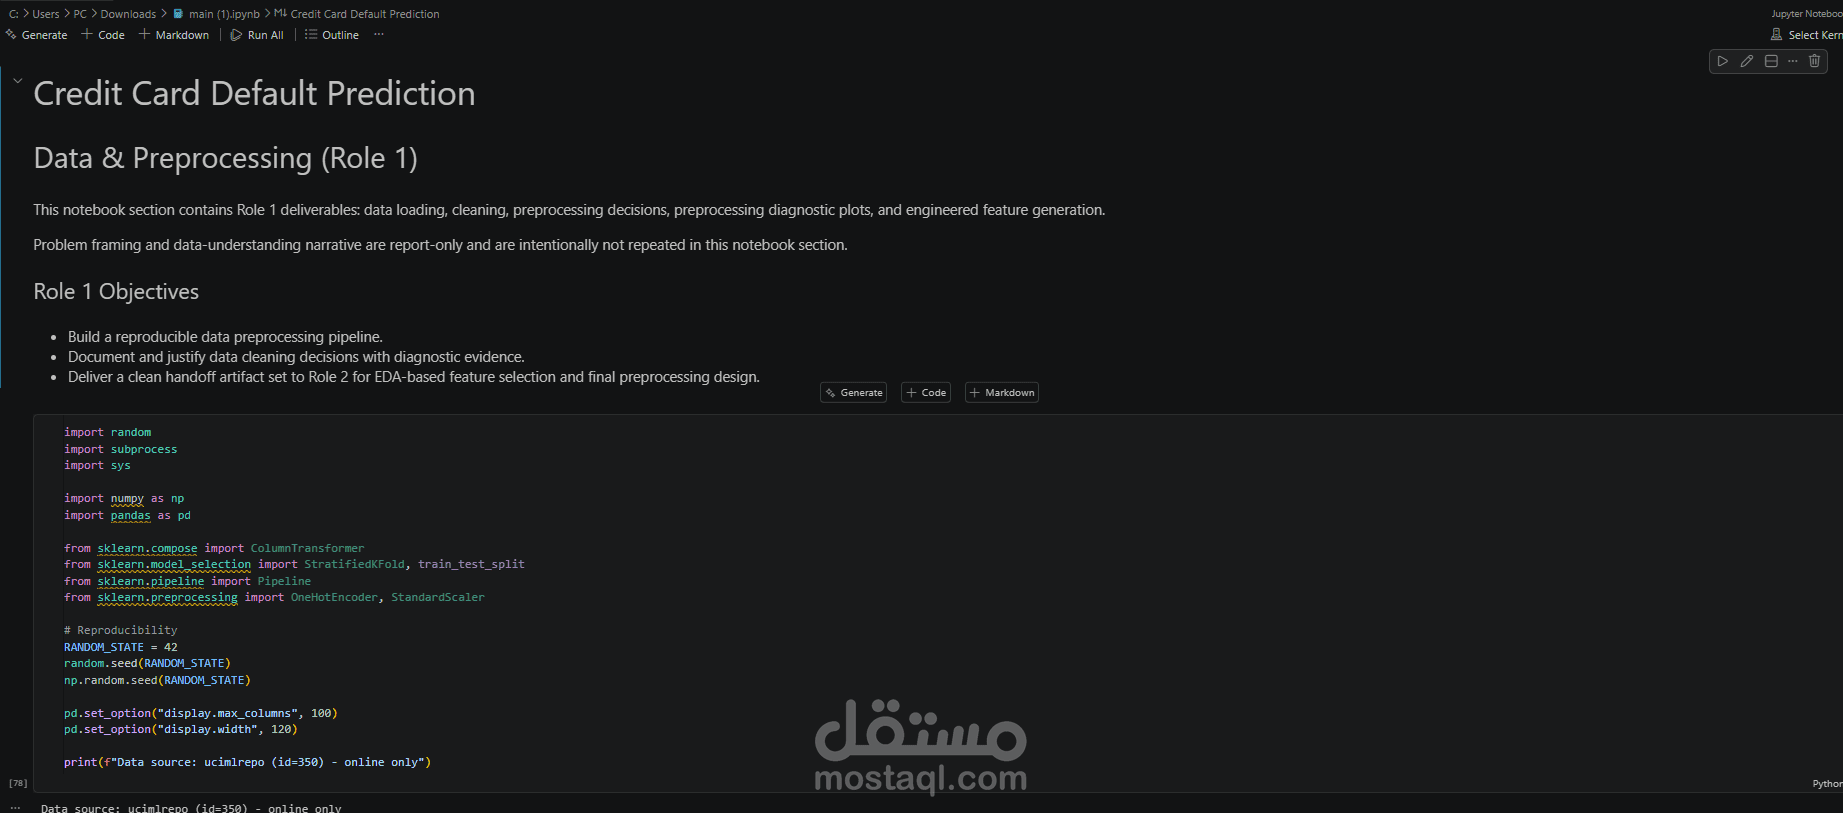
تم تنفيذ مشروع متكامل لتحليل بيانات العملاء والتنبؤ باحتمالية تعثر العميل عن سداد بطاقة الائتمان في الشهر التالي باستخدام تقنيات تعلم الآلة.
اعتمد المشروع على مجموعة بيانات تحتوي على 30,000 سجل و24 متغيرًا، وتم تنفيذ مراحل المشروع بداية من تحميل البيانات وتنظيفها وتحليلها، وصولًا إلى بناء ومقارنة عدة نماذج Machine Learning وتقييم نتائجها.
مراحل تنفيذ المشروع:
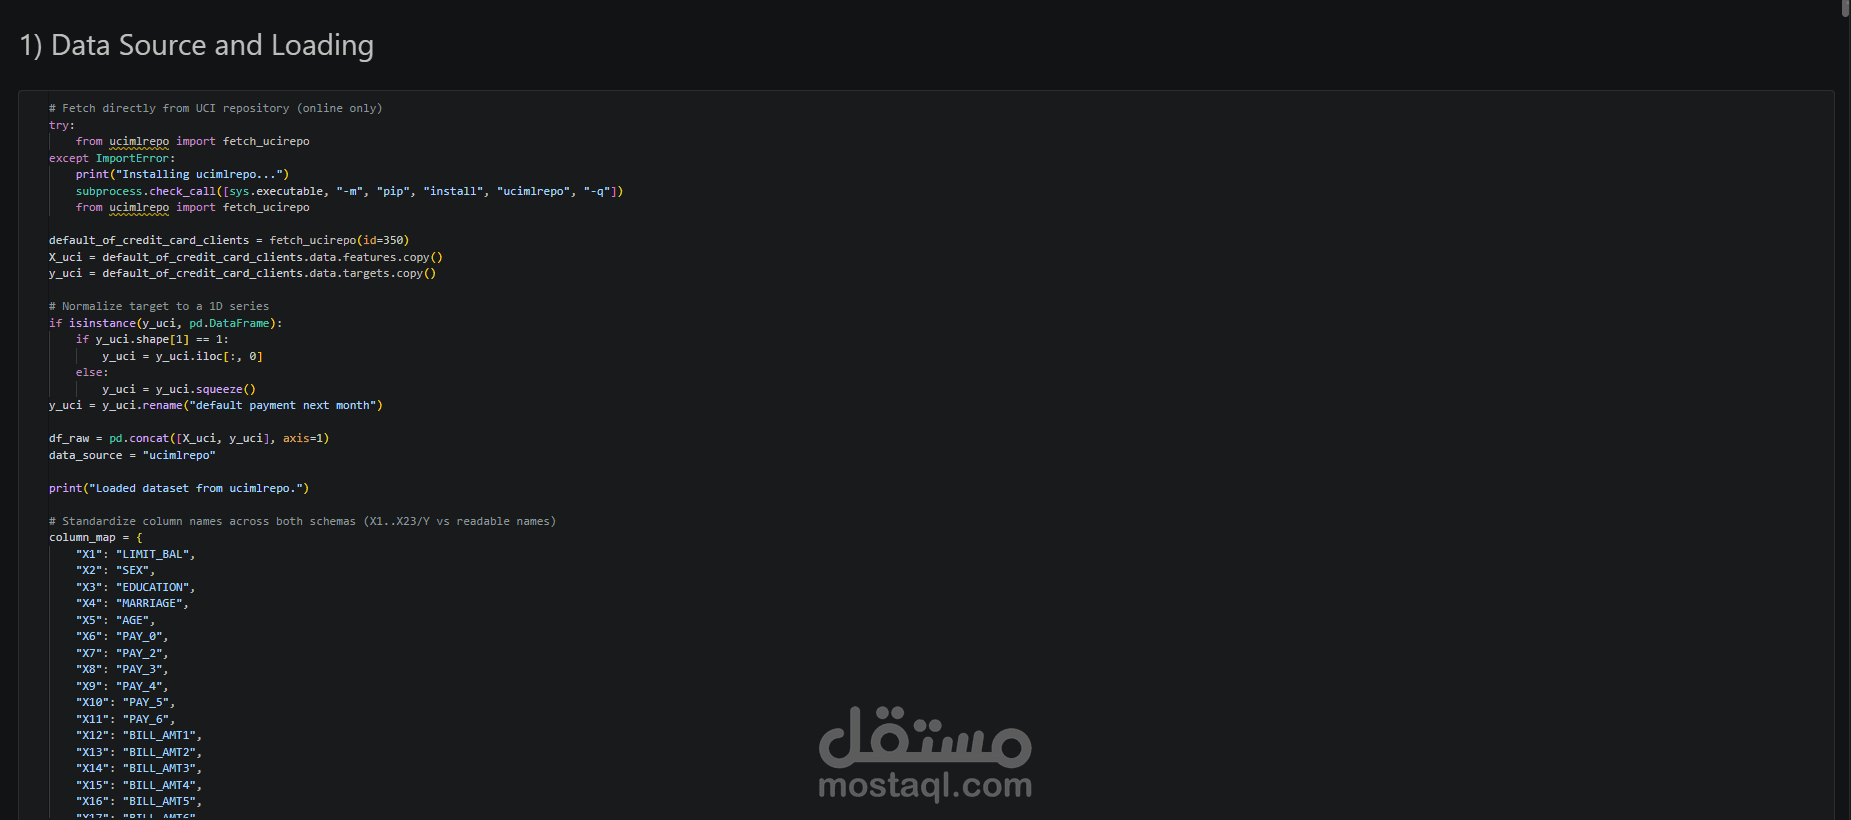
1. تحميل وتجهيز البيانات:
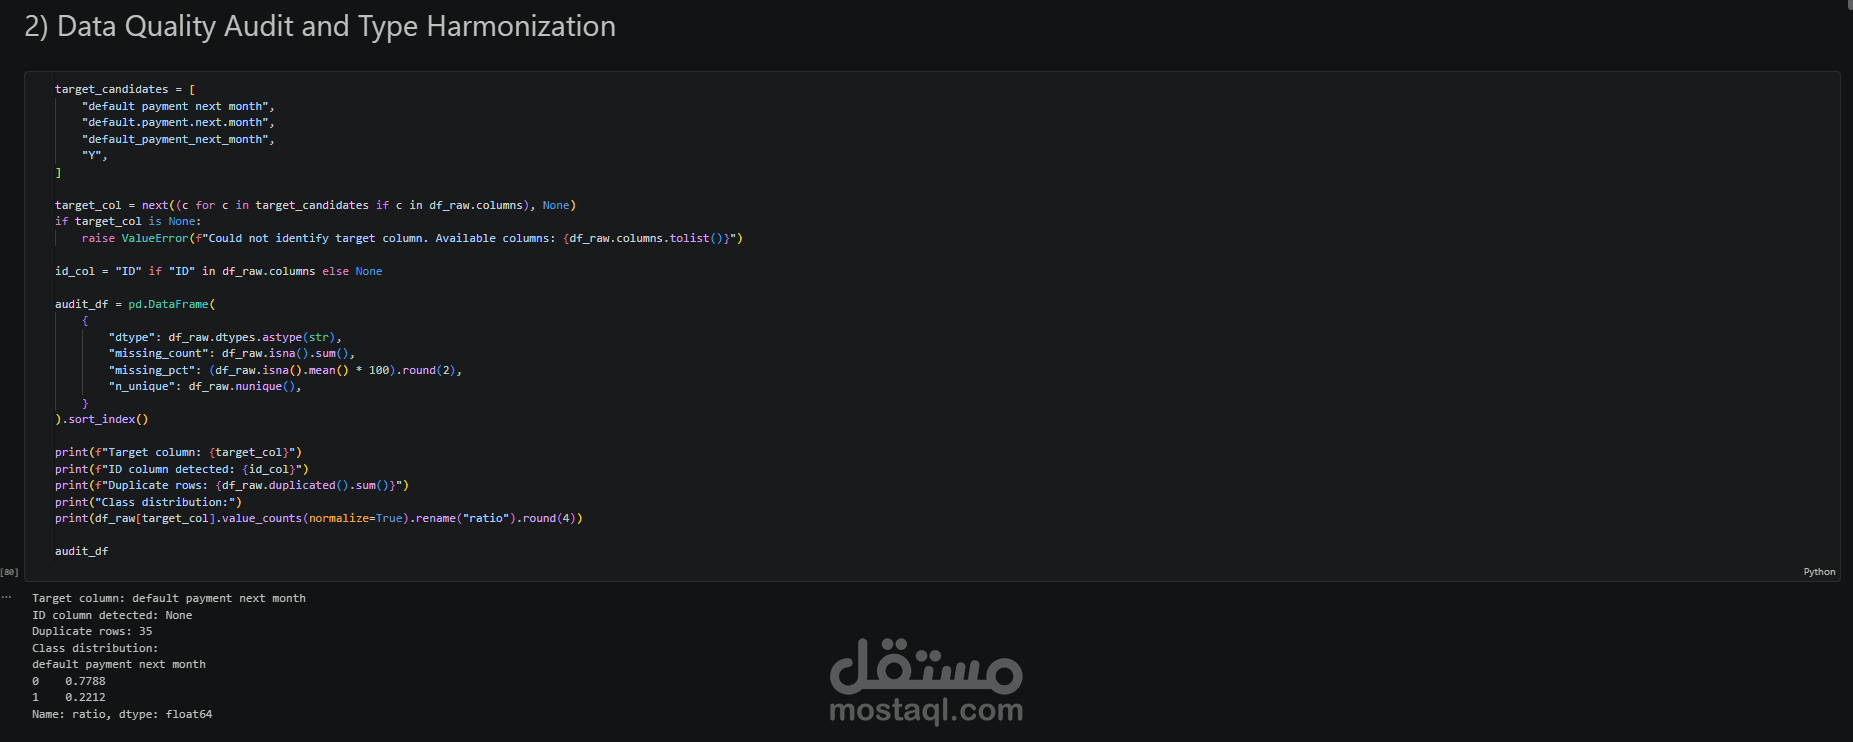
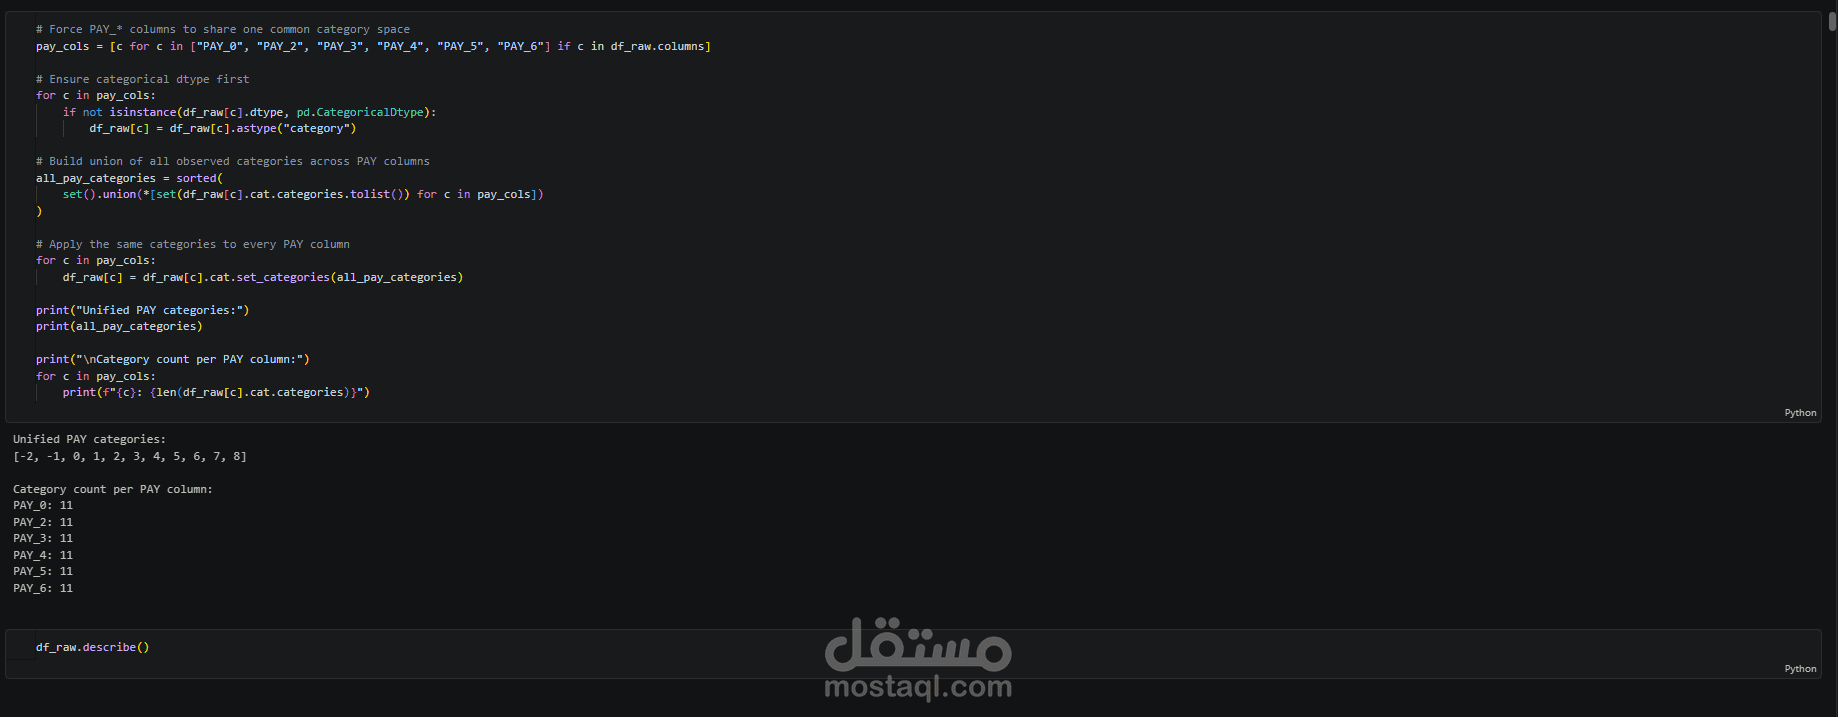
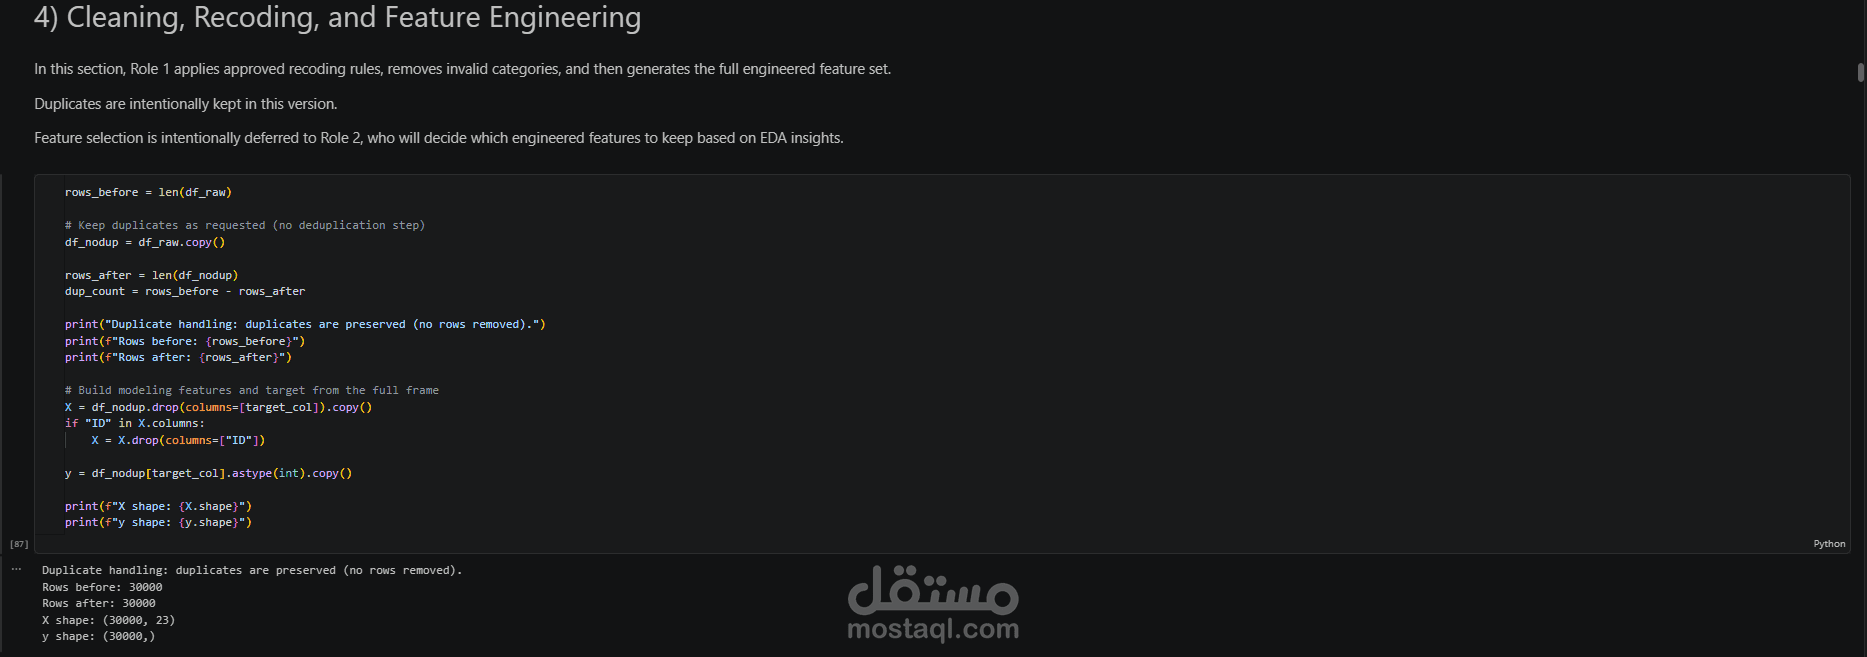
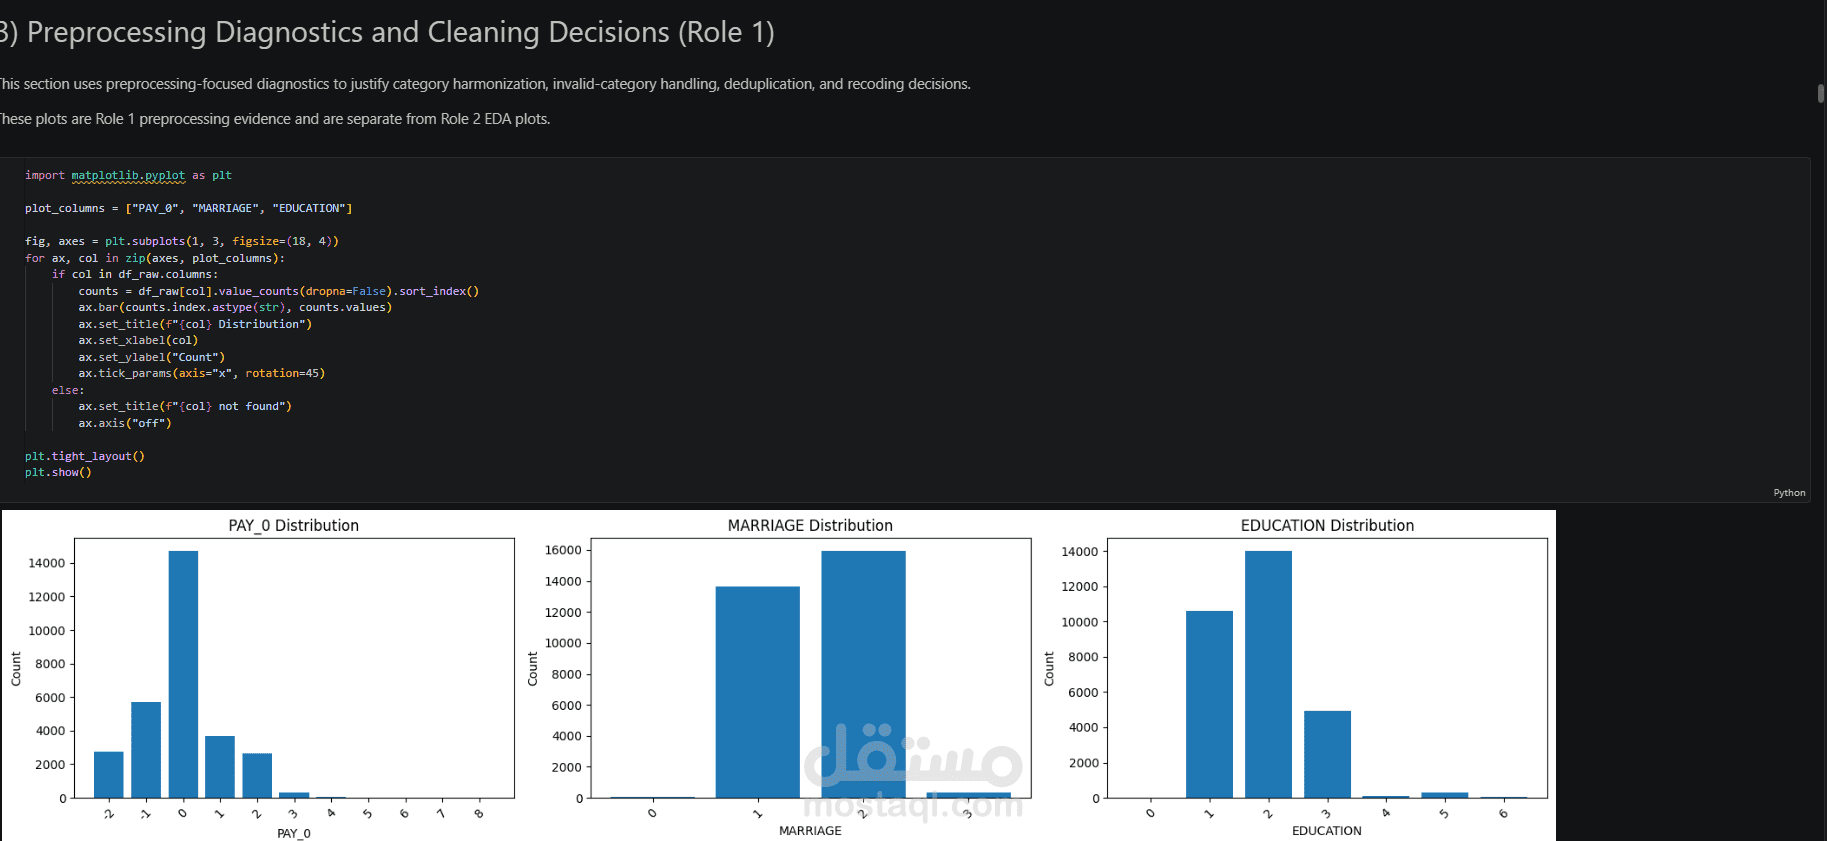
تحميل بيانات Credit Card Default, فحص البيانات وأنواع المتغيرات,التحقق من القيم المفقودة والقيم غير الصحيحة.فحص البيانات المكررة,
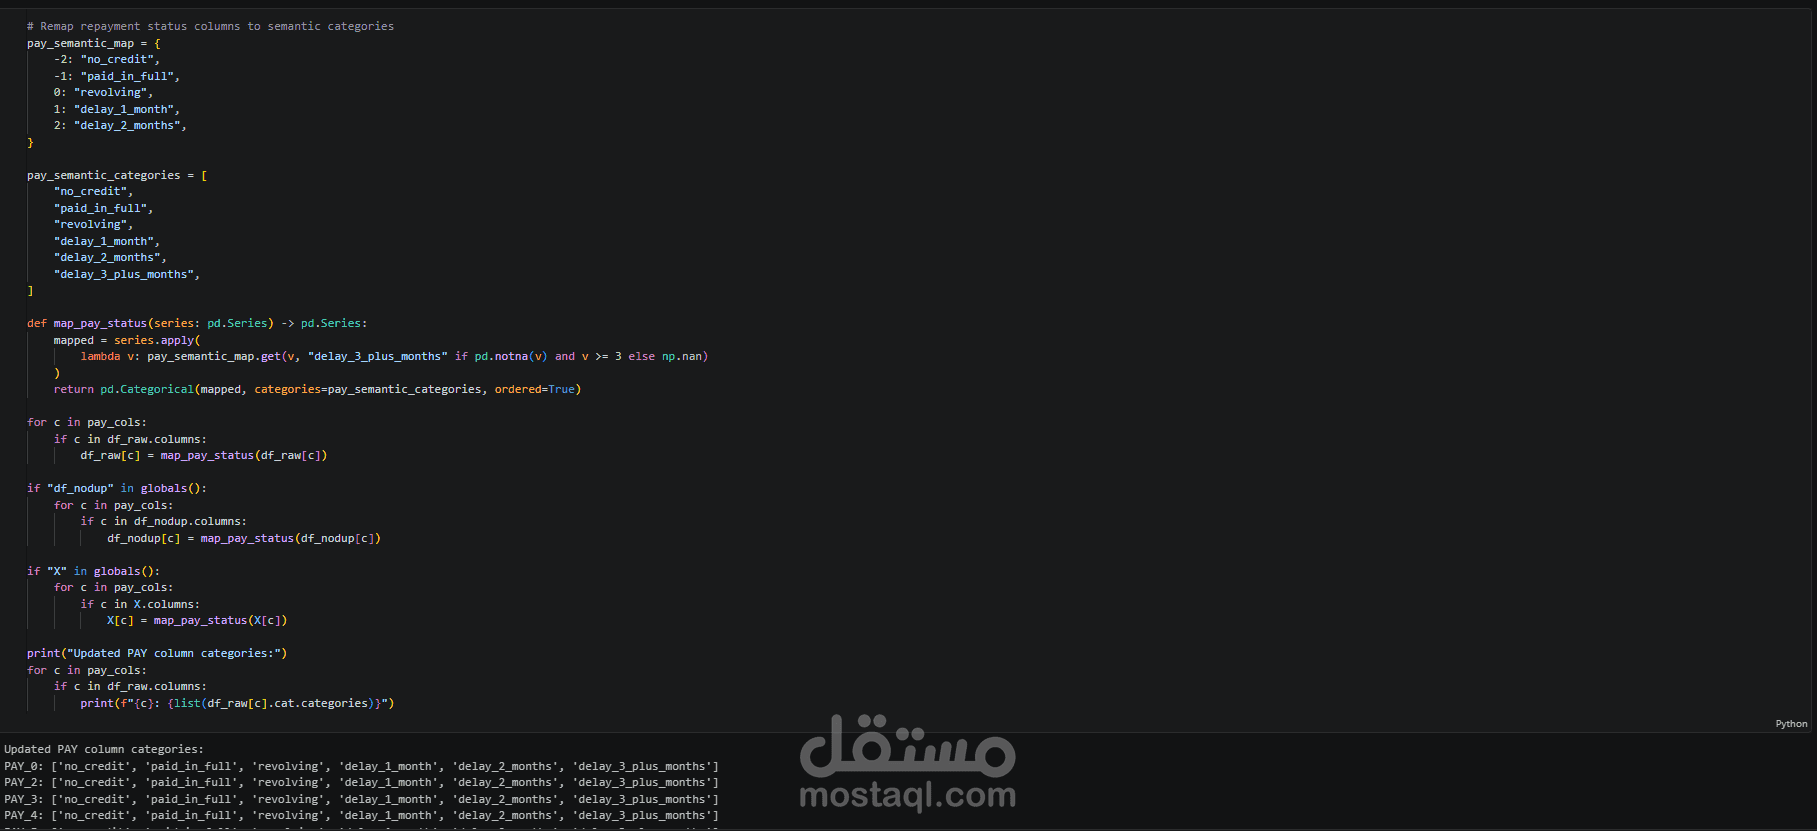
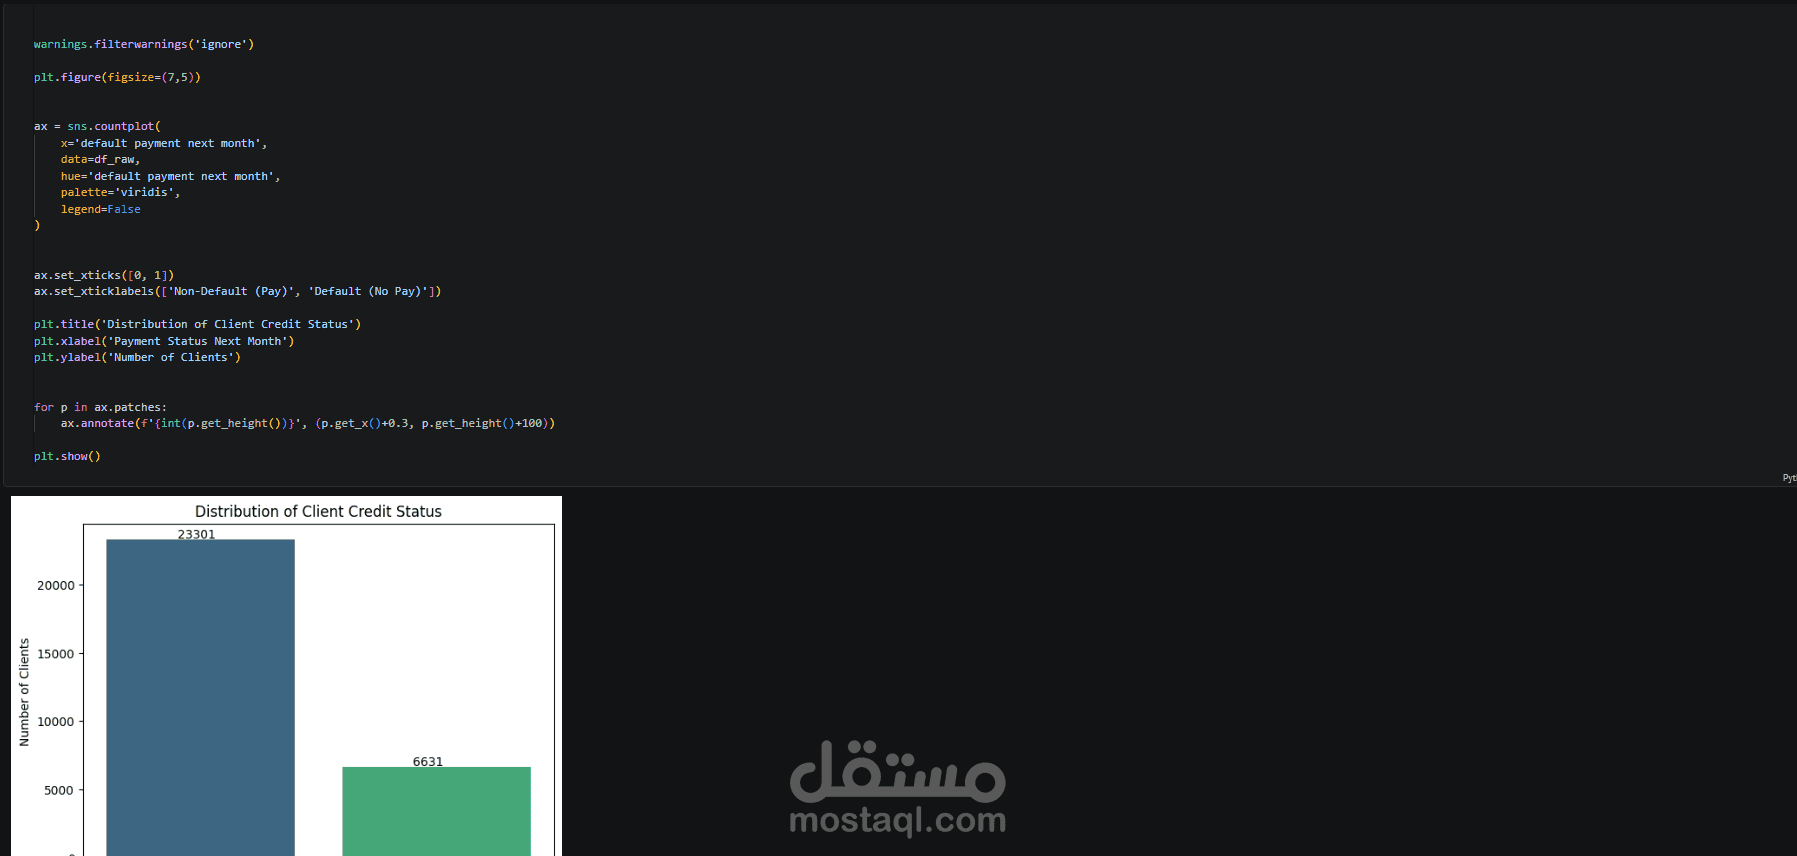
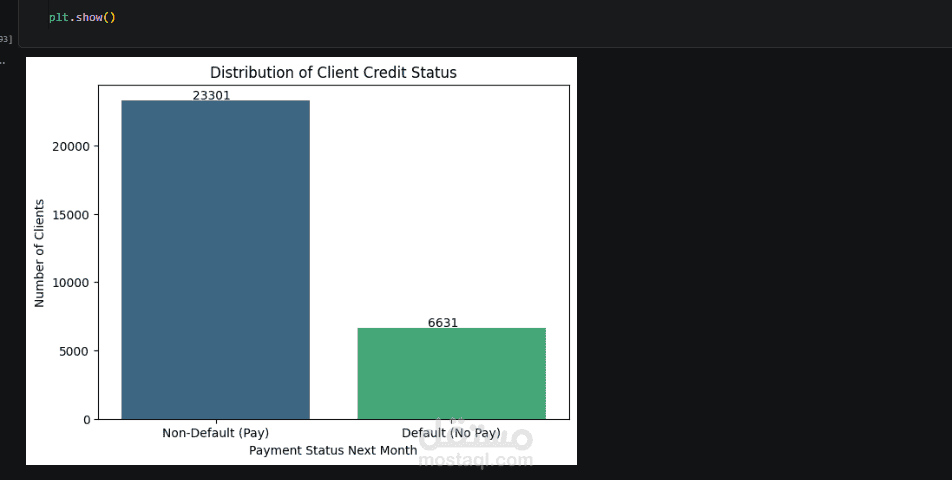
تحليل توزيع المتغير المستهدف,تنظيف وتوحيد بعض قيم متغيرات السداد.
2. تحليل البيانات الاستكشافي EDA:
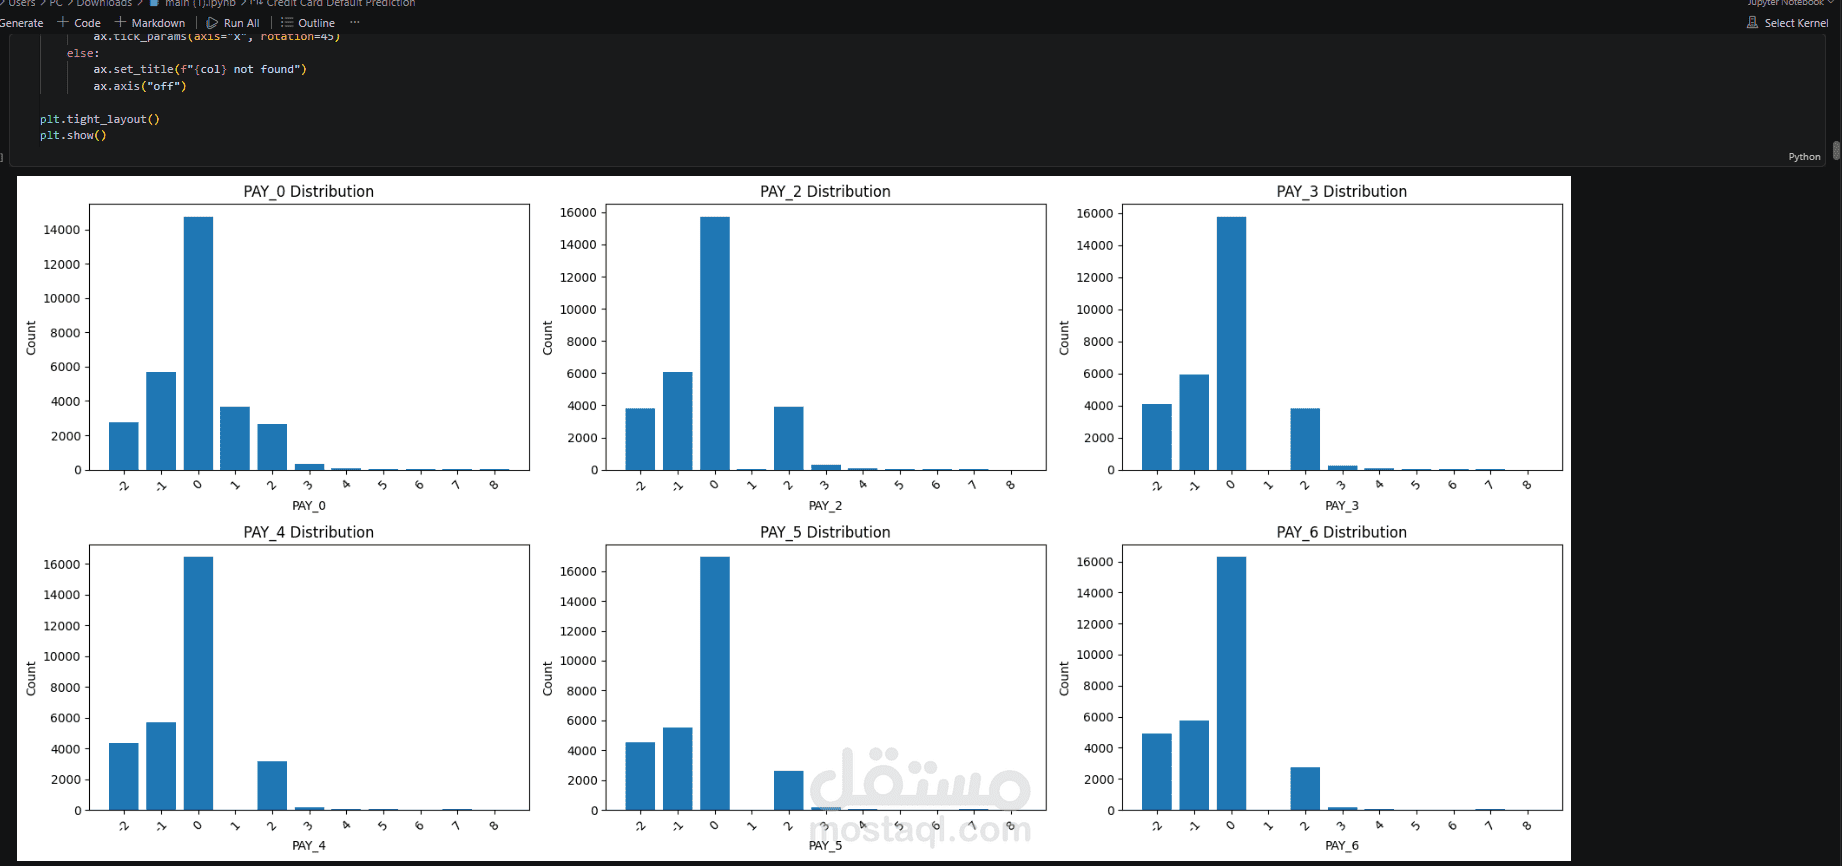
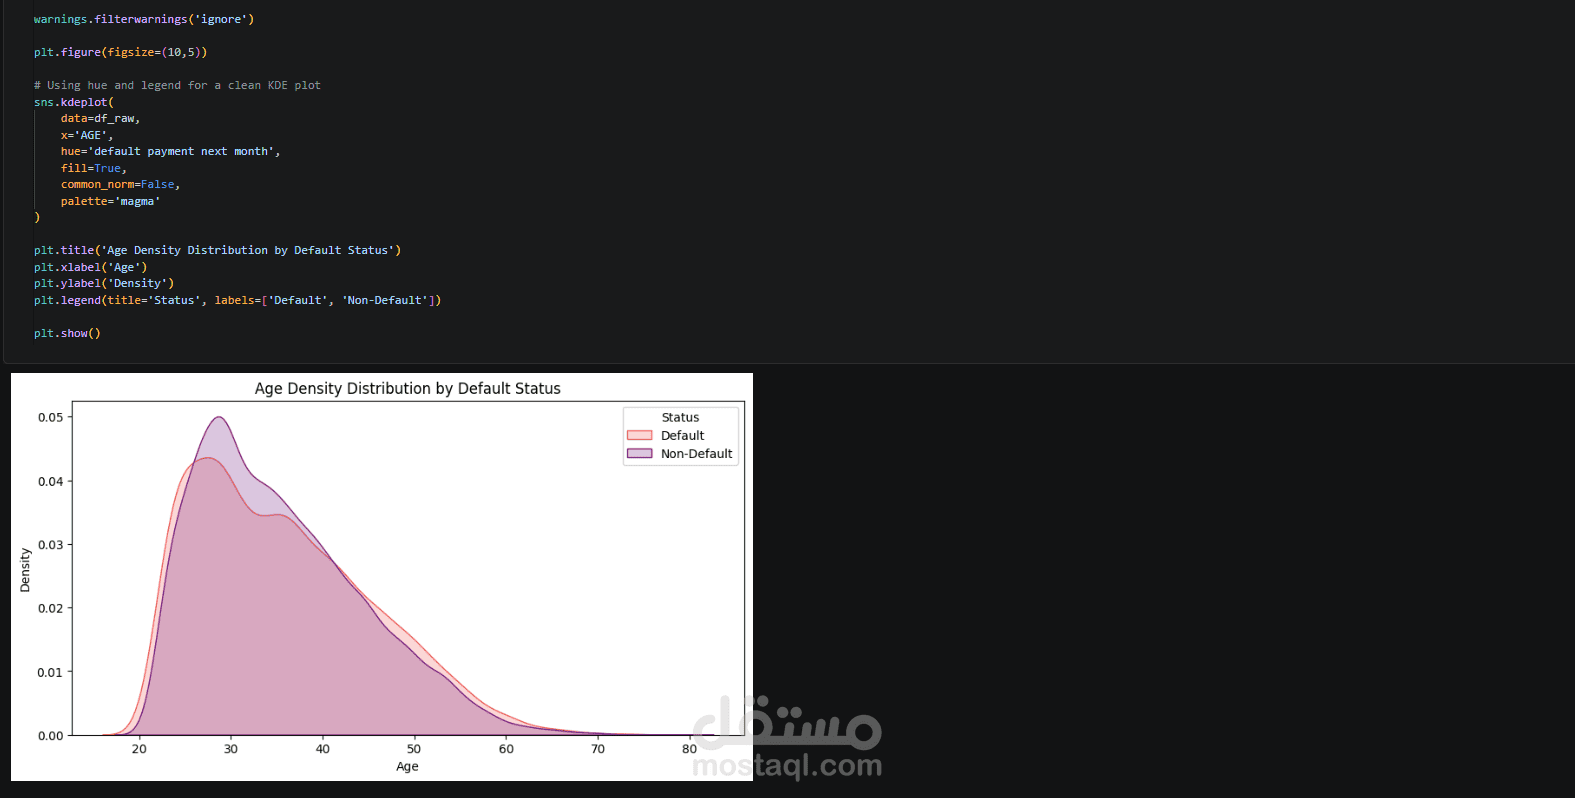
تحليل توزيع العملاء حسب حالة السداد,دراسة العلاقة بين عمر العميل واحتمالية التعثر,تحليل الارتباطات بين المتغيرات,اكتشاف المتغيرات التي تحتوي على ارتباط مرتفع فيما بينها,تحليل سلوك السداد خلال الأشهر السابقة.استخدام الرسوم البيانية وHeatmaps وKDE لفهم البيانات واستخراج أهم الـInsights.
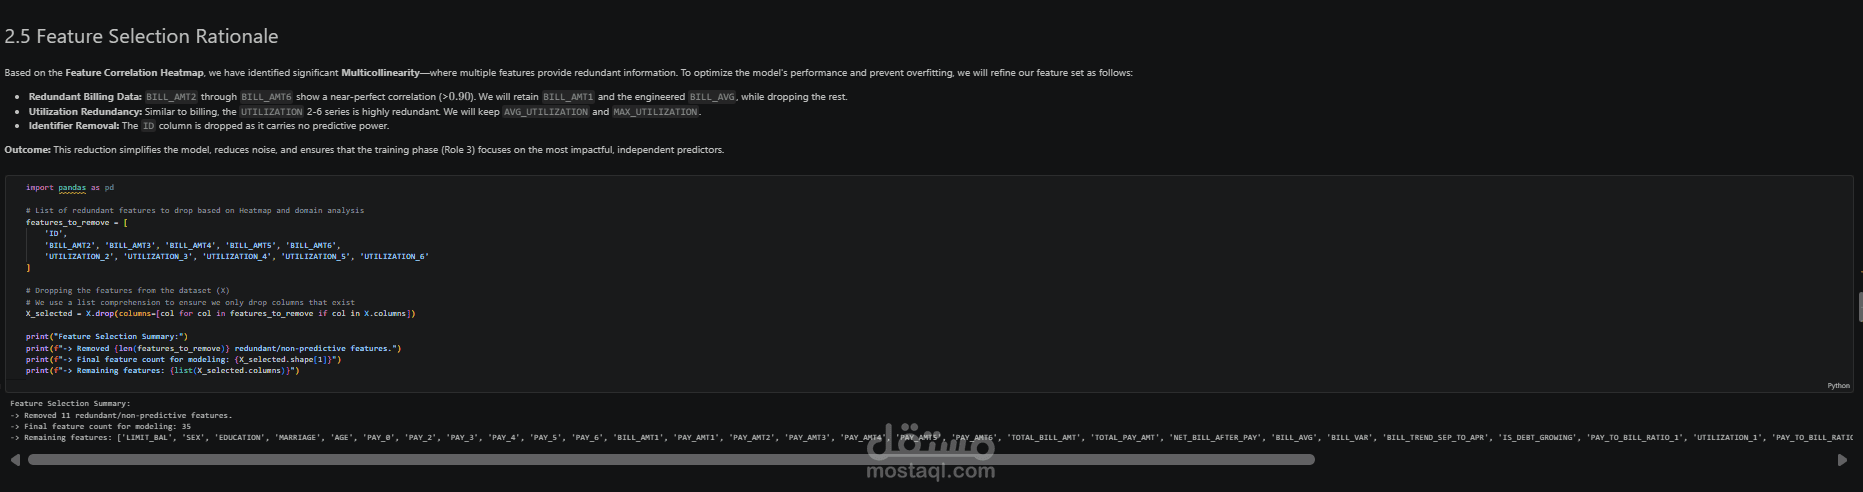
3. Feature Engineering وFeature Selection:
إنشاء Features تساعد في تمثيل السلوك المالي للعملاء.التعامل مع المتغيرات شديدة الارتباط,تقليل التكرار بين بعض متغيرات الفواتير,التعامل مع متغيرات Utilization,حذف ID لأنه لا يحمل قيمة تنبؤية.اختيار مجموعة Features مناسبة لاستخدامها في بناء النماذج.
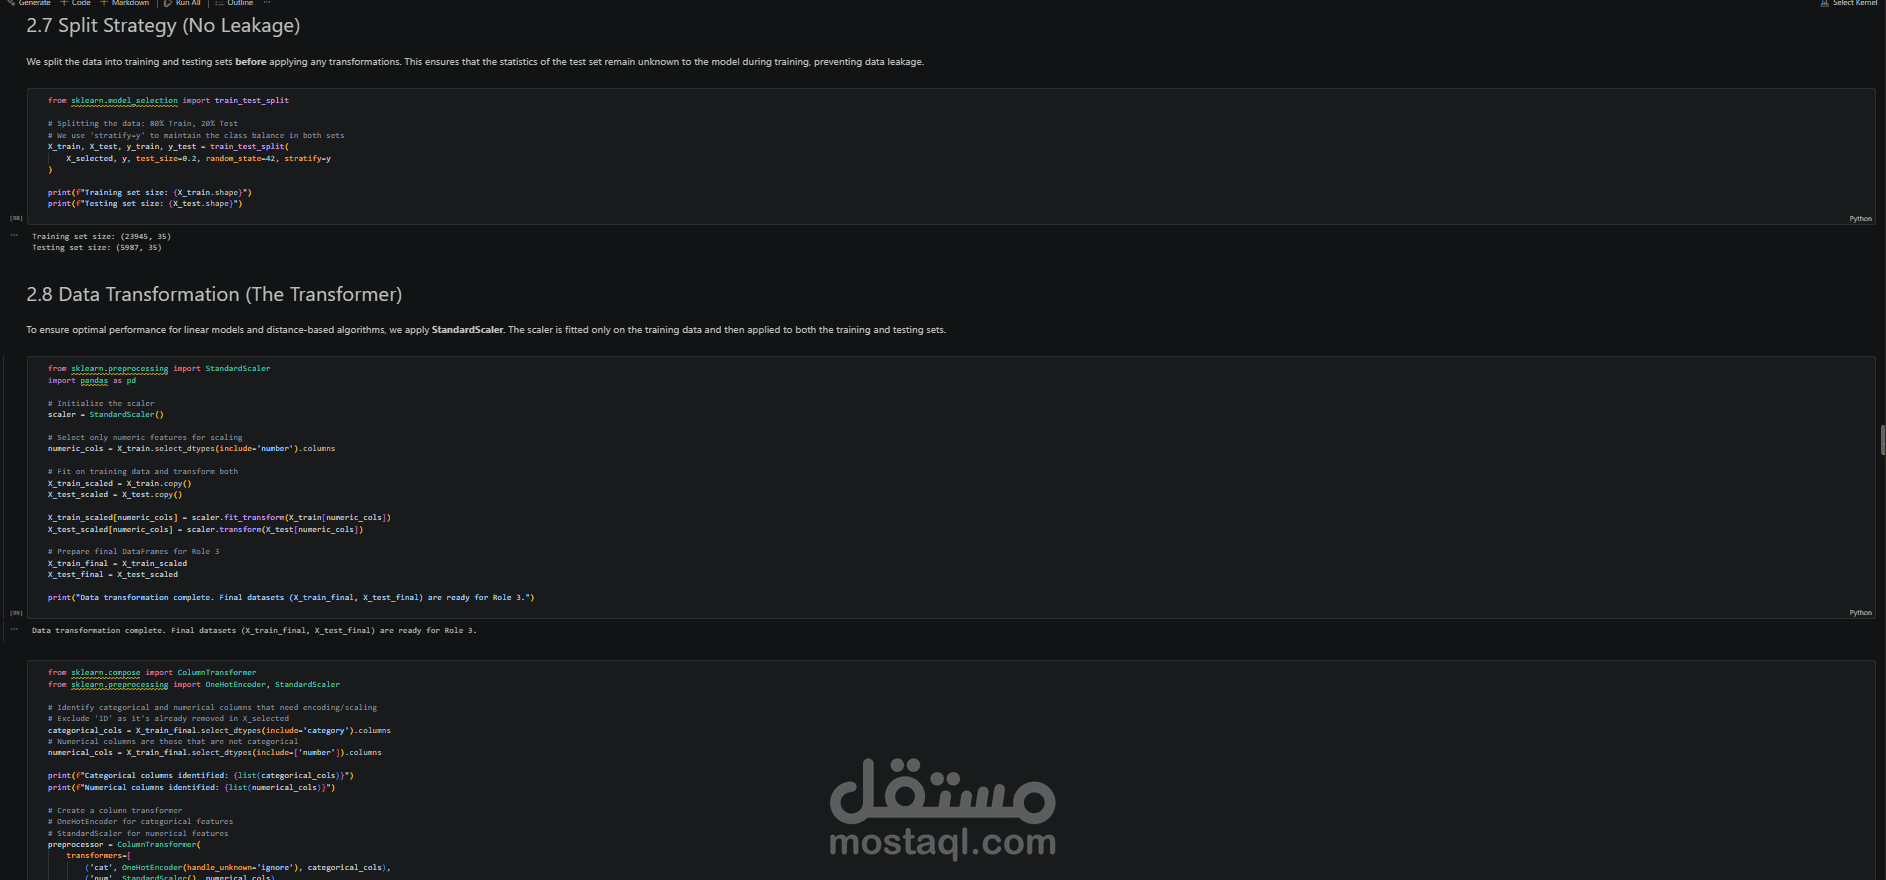
4. تجهيز البيانات للنمذجة:
تقسيم البيانات إلى Training Set بنسبة 80% وTesting Set بنسبة 20%.استخدام Stratified Split للحفاظ على توزيع الفئات.استخدام Random State لضمان إمكانية إعادة إنتاج النتائج.تطبيق StandardScaler على المتغيرات الرقمية.تدريب الـScaler باستخدام بيانات التدريب فقط لتجنب Data Leakage.
5.بناء نماذج Machine Learning:
تم استخدام ومقارنة عدة خوارزميات للتصنيف، منها:
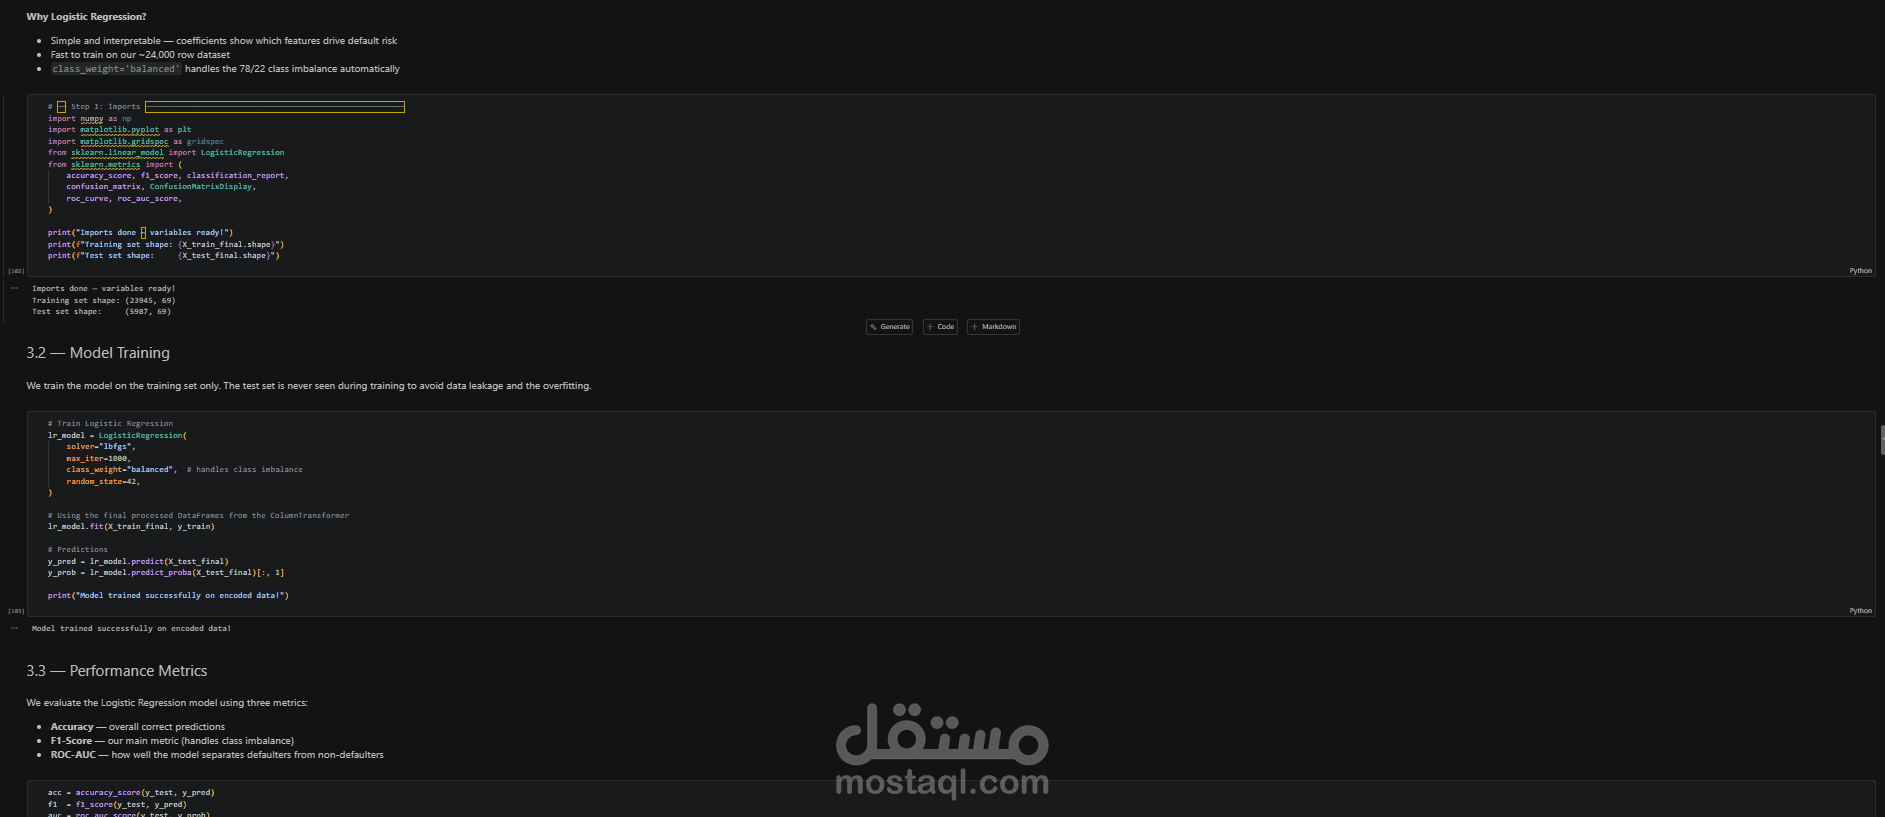
Logistic Regression كنموذج Baseline.
K-Nearest Neighbors KNN.
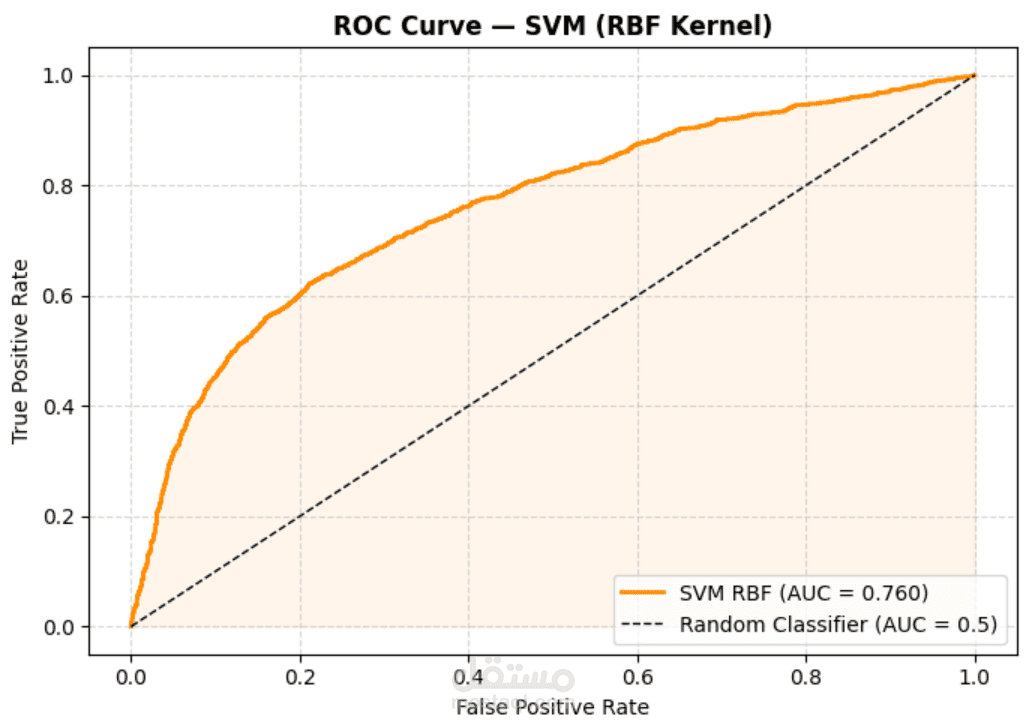
Support Vector Machine SVM باستخدام RBF Kernel.
Decision Tree Classifier.
استخدام Class Weighting للتعامل مع عدم توازن الفئات.
استخدام Cross Validation لاختيار بعض إعدادات النماذج وتقليل احتمالية Overfitting.
6.تقييم النماذج:
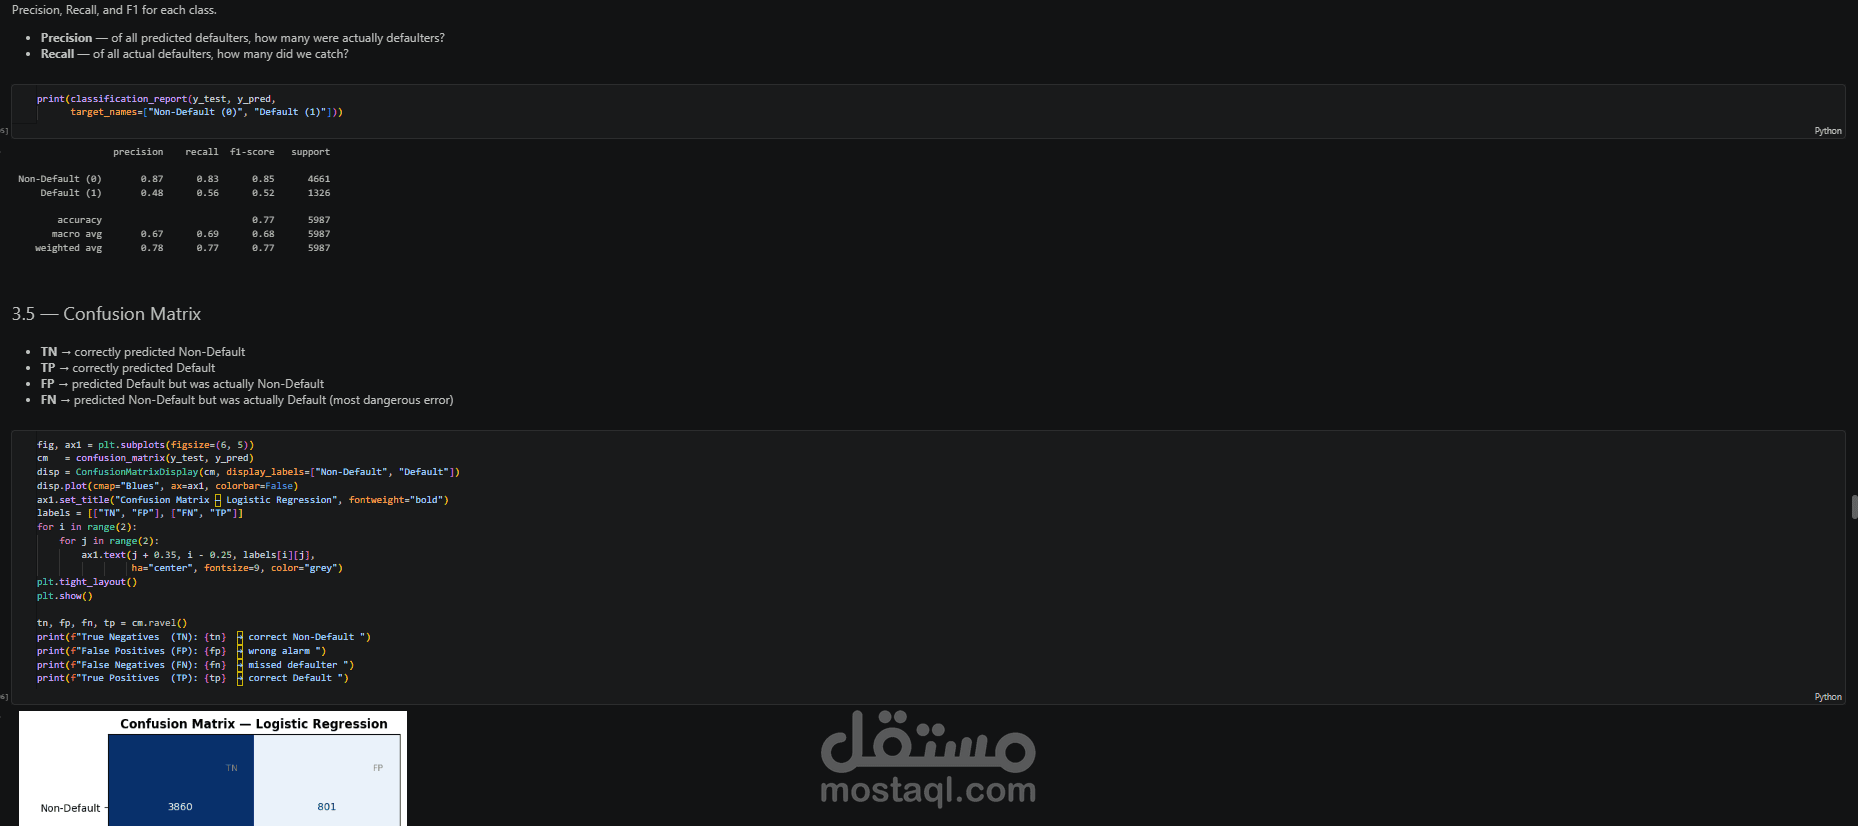
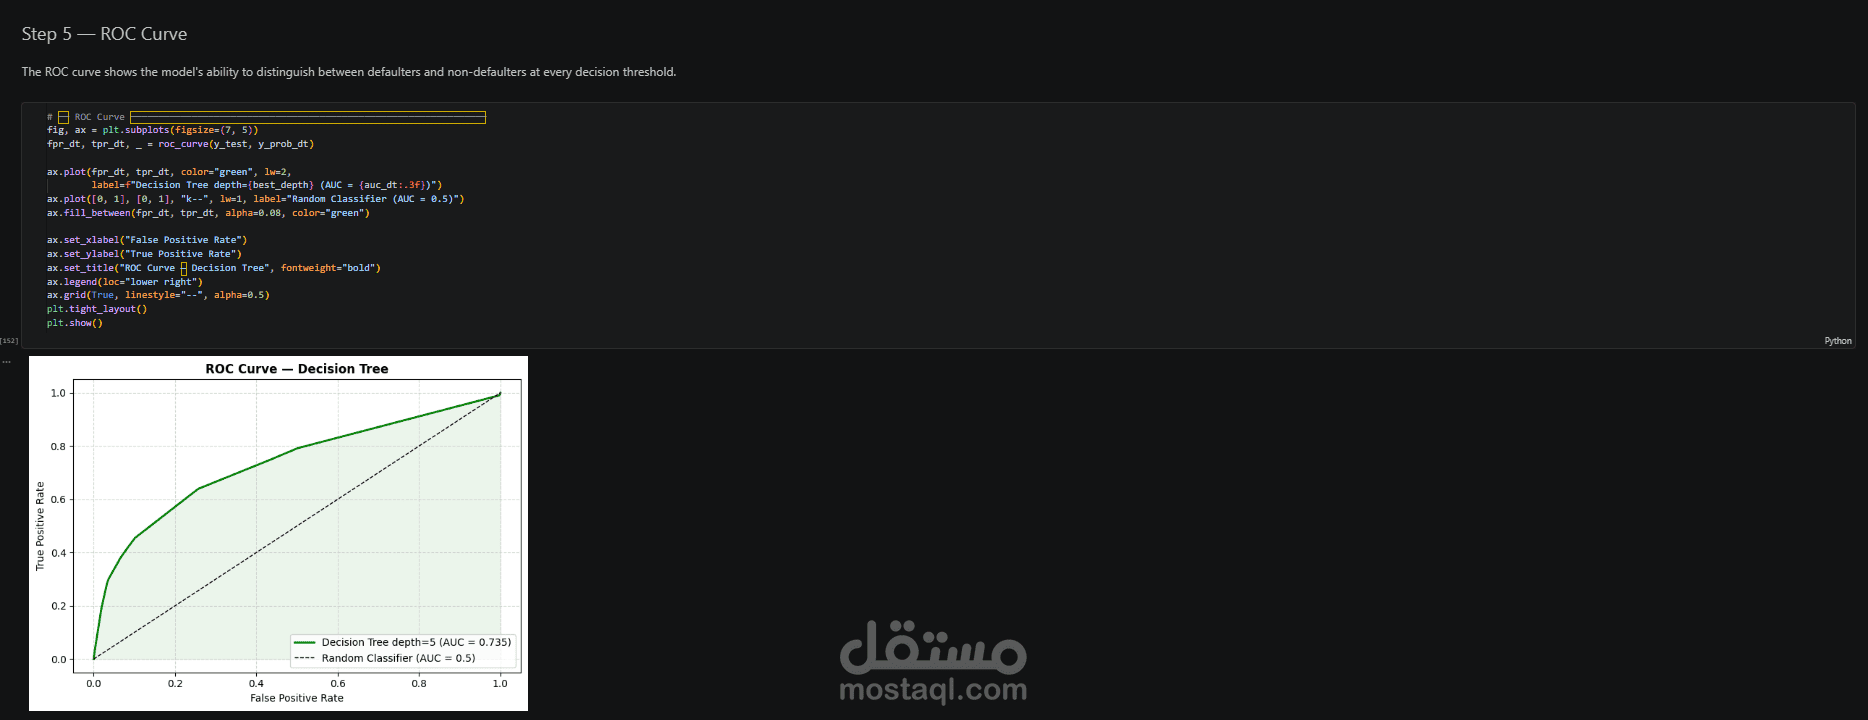
تم تقييم أداء النماذج باستخدام عدة Metrics، منها:
Accuracy
Precision
Recall
F1-Score
ROC-AUC
Confusion Matrix
ROC Curve
وتم الاهتمام بشكل خاص بمقاييس Recall وF1-Score لأن المشكلة تتضمن عدم توازن بين الفئات، ولأن اكتشاف العملاء المعرضين للتعثر يمثل جانبًا مهمًا من عملية التنبؤ.
النتيجة النهائية:
تم بناء Workflow متكامل لمشروع Machine Learning يبدأ من البيانات الخام، ثم Data Cleaning وEDA وFeature Engineering وFeature Selection، وبعد ذلك Data Preprocessing وتدريب عدة Classification Models ومقارنة أدائها باستخدام مجموعة من المقاييس المناسبة.
المشروع يوضح تطبيق عملي لمفاهيم مهمة في Machine Learning مثل:
Data Cleaning
Exploratory Data Analysis
Feature Engineering
Feature Selection
Data Preprocessing
Class Imbalance
Stratified Sampling
Cross Validation
Data Leakage Prevention
Model Training
Model Evaluation
Classification
ROC-AUC Analysis