Ai Job market 2026
تفاصيل العمل
# من بيانات خام إلى قرار: قصة تحليل سوق وظائف الذكاء الاصطناعي عالميًا
## البداية: سؤال بسيط بدا سهلاً
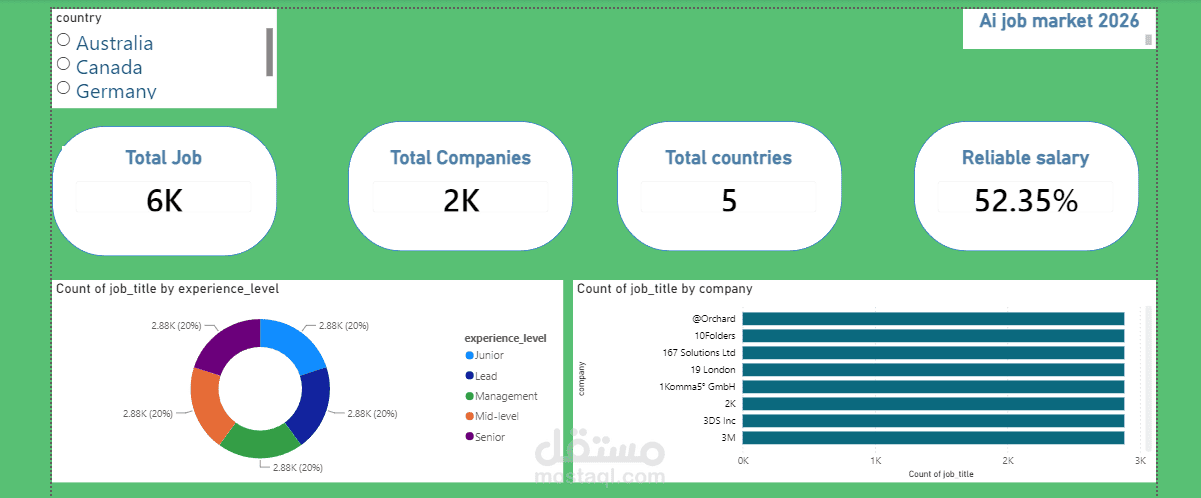
كل حد بيدخل مجال تحليل البيانات بيبدأ بنفس الافتراض: "عندي داتا، هعمل Dashboard، خلاص." لكن مشروع تحليل 5,773 وظيفة AI حول العالم علّمني إن الجزء الأصعب والأهم مش في الرسم البياني النهائي — هو في الأسئلة اللي بتسألها للبيانات قبل ما تثق فيها.
بدأت بسؤال واضح: **إيه اللي بيحصل فعليًا في سوق وظائف الذكاء الاصطناعي؟** إيه المهارات المطلوبة، وإزاي الرواتب بتختلف حسب الخبرة والدولة؟ بسيط في الظاهر. لكن كل خطوة كشفت مشكلة جديدة في البيانات، وكل مشكلة كانت فرصة أتعلم منها أكتر من أي Tutorial.
## أول مفاجأة: الغياب مش عشوائي أبدًا
أول حاجة واجهتها كانت 42% من بيانات الرواتب ناقصة. الرد السهل كان: "أملاها بالمتوسط وأمشي." لكن لما قسّمت الغياب حسب الدولة، لقيت الصورة الحقيقية: أمريكا وبريطانيا كانت شبه كاملة (أقل من 1% غياب)، بينما أستراليا وكندا وألمانيا كانت ناقصة بنسبة 80-93%.
الغياب مش صدفة — هو انعكاس لمصدر البيانات نفسه (Adzuna بيغطي بره أمريكا بشكل أضعف). القرار هنا كان أهم من أي كود: بدل ما "أخترع" بيانات لثلاث دول بأرقام وهمية، قصرت تحليل الرواتب على أمريكا وبريطانيا بس، ووثّقت السبب بوضوح. التحليل الأمين أحيانًا معناه إنك تقول "مش أعرف" بدل ما تلمّع رقم غير موثوق.
## الاكتشاف اللي غيّر فهمي للبيانات النصية
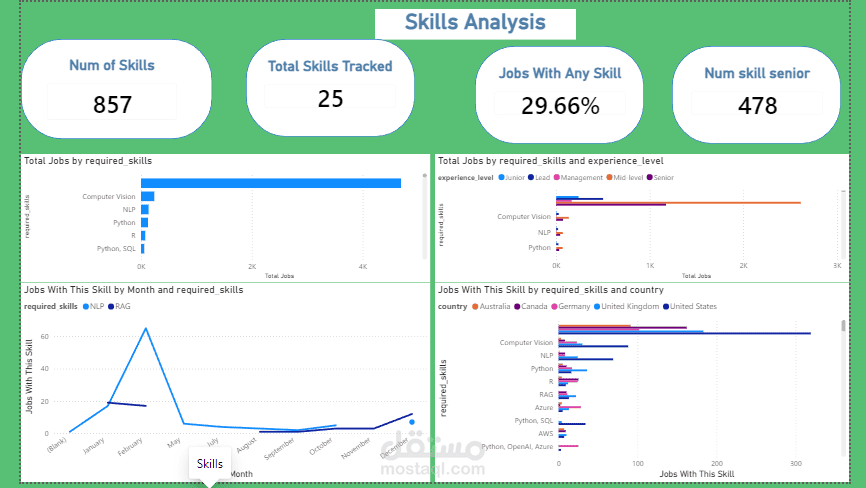
حاولت أستخرج المهارات المطلوبة من نص الوصف الوظيفي، لأن عمود المهارات الرسمي كان ناقص 81%. أول محاولة بحث بسيط (`str.contains`) رجعت نتيجة غريبة: **كل وظيفة بلا استثناء فيها مهارة "R".**
اتضح إن الكود كان بيمسك حرف الـ R جوه أي كلمة — "Career"، "Requirements"، "Software" — مش لغة R كمهارة برمجية فعلية. الحل كان `word boundaries` في الـ regex، لكن الدرس الحقيقي كان أعمق: أي نتيجة "مثالية أوي" أو "غريبة أوي" هي إنذار، مش سبب للفرح. لازم تتأكد قبل ما تصدّق.
وحتى بعد التصحيح، 71% من الوظائف طلعت من غير أي مهارة مستخرجة. بدل ما أتجاهل الرقم ده، رجعت للنصوص نفسها وقريتها بعيني — ولقيت السبب: كتير من الشركات بتستخدم قوالب وصف عامة (زي "About us..." الموحدة) مش بتذكر تقنيات محددة، حتى لو الوظيفة فعلاً تقنية. ده مش عيب في الكود، ده واقع في طبيعة بيانات التوظيف نفسها — وتوثيقه بصراحة كان أهم من محاولة "تصليحه" بالقوة.
## لما الرقم يبقى غريب، السبب دايمًا موجود
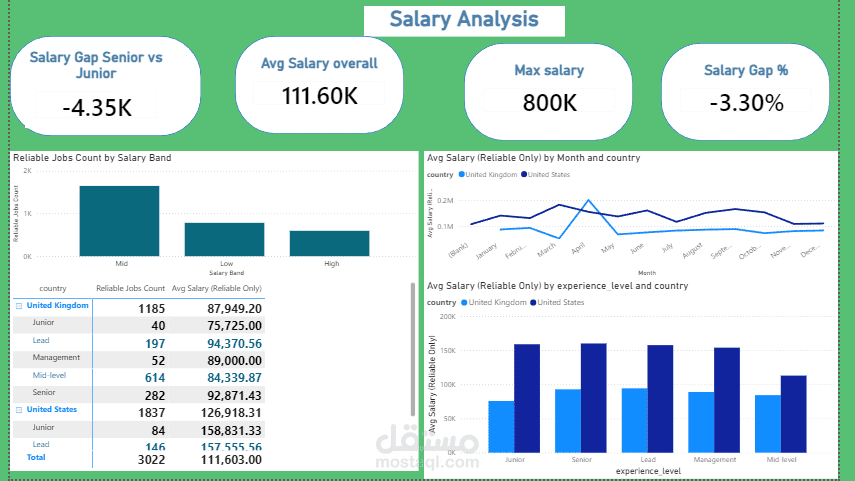
في تحليل الرواتب حسب الخبرة، طلع رقم غير منطقي: متوسط راتب **Junior** في أمريكا أعلى من **Mid-level**. بدل ما أمشي بالرقم ده على طول، رجعت للوظائف نفسها — ولقيت إن 17.7% من الوظائف المصنفة "Junior" كان عنوانها الفعلي بيقول "Senior" أو "Director"، براتب يوصل لـ 361,000 دولار.
الخطأ مش في التحليل، الخطأ في تصنيف مصدر البيانات نفسه. توثيق النقطة دي في التقرير مش كان "اعتراف بعيب" — كان دليل على إني بفهم البيانات اللي بتعامل معاها، مش بس بشغّل كود عليها.
## من جدول واحد إلى Star Schema
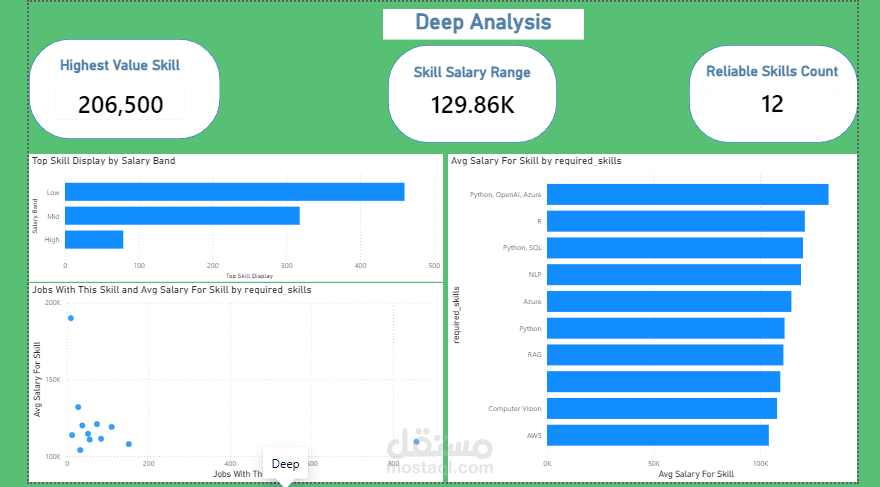
بعد التنظيف، بنيت الموديل في Power BI على هيئة **Star Schema** كامل: جدول Fact مركزي وتسع جداول Dimension (الدولة، الشركة، الخبرة، المهارات، التاريخ...). ده خلاني أكتب DAX حقيقي مش سطحي — أهمها الفرق بين **Calculated Column** (قيمة ثابتة لكل صف، زي تصنيف الراتب لـ Low/Mid/High) و**Measure** (قيمة ديناميكية بتتغير حسب الفلتر، زي متوسط راتب مهارة معينة عند اختيار دولة محددة).
الرسالة الأخيرة اللي علمتني إياها الصفحة دي كانت في التحليل المتقاطع: لما ربطت عدد الوظائف اللي بتطلب مهارة معينة بمتوسط راتبها، طلعت مهارات زي PyTorch وKubernetes — نادرة الطلب نسبيًا، لكن أعلى أجرًا بشكل واضح. ده مش مجرد رقم، ده رؤية تجارية حقيقية: المهارة النادرة مش دايمًا أقل قيمة، أحيانًا العكس هو الصح.
## الدرس الأكبر
المشروع ده مانتهاش بـ Dashboard حلو الشكل. انتهى بصفحة اسمها "Data Notes" — توثيق صريح لكل قيد وكل افتراض اتخذته. أي حد بيراجع البورتفوليو ده هيلاقي مش بس أرقام، هيلاقي طريقة تفكير: تشكك في النتيجة الغريبة، وثّق القيد بدل ما تخفيه، وميّز بين "مش عارف" و"مش موثوق" و"واضح ومؤكد".
ده الفرق اللي بيفصل بين حد بيشغّل Power BI وحد بيفهم البيانات.