NYC 311 Service Requests — Data Cleaning & Exploratory Data Analysis (EDA) for Predictive Modeling
تفاصيل العمل
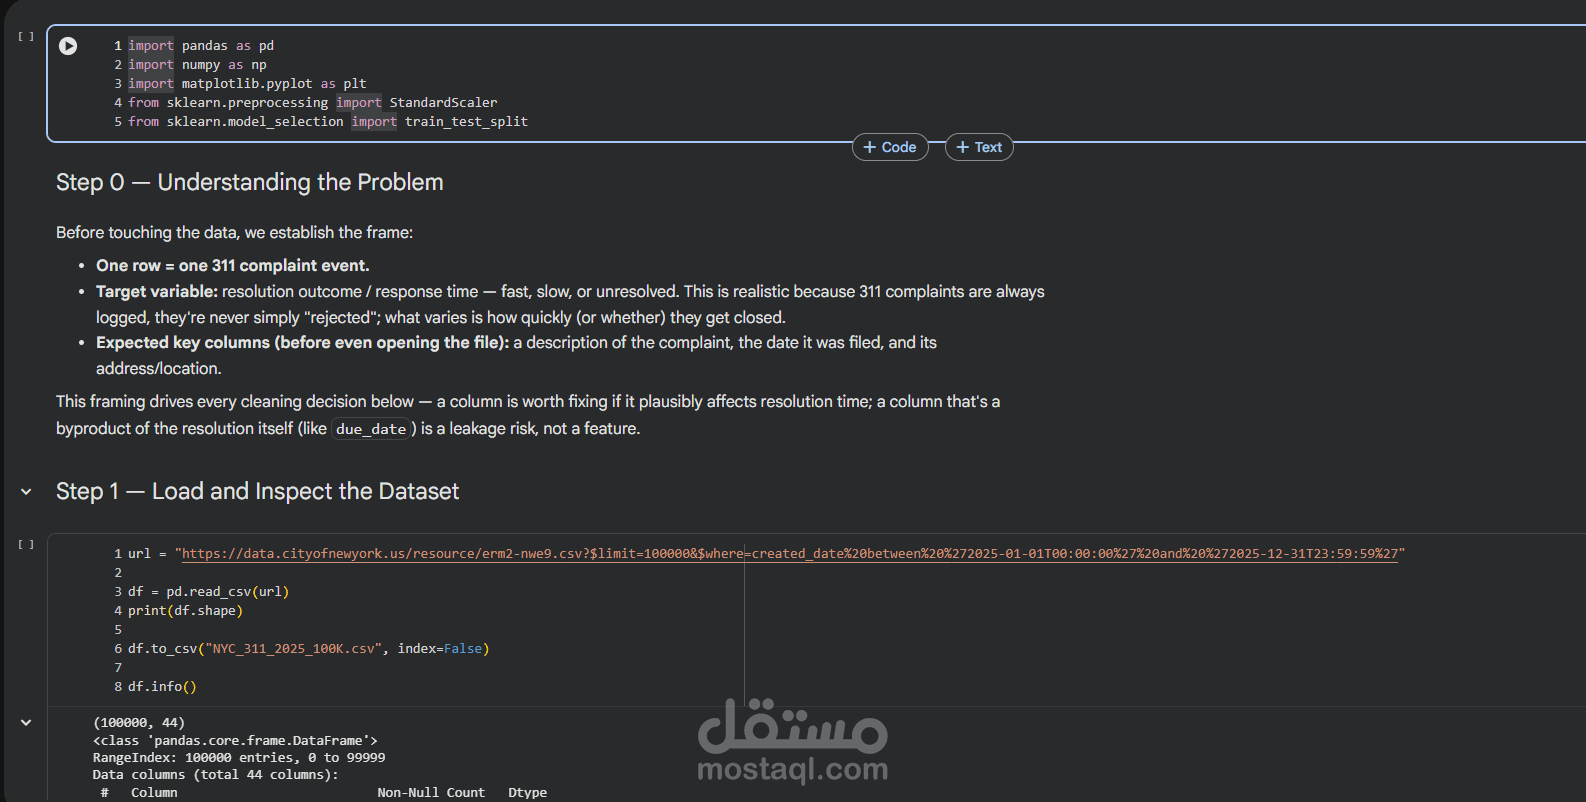
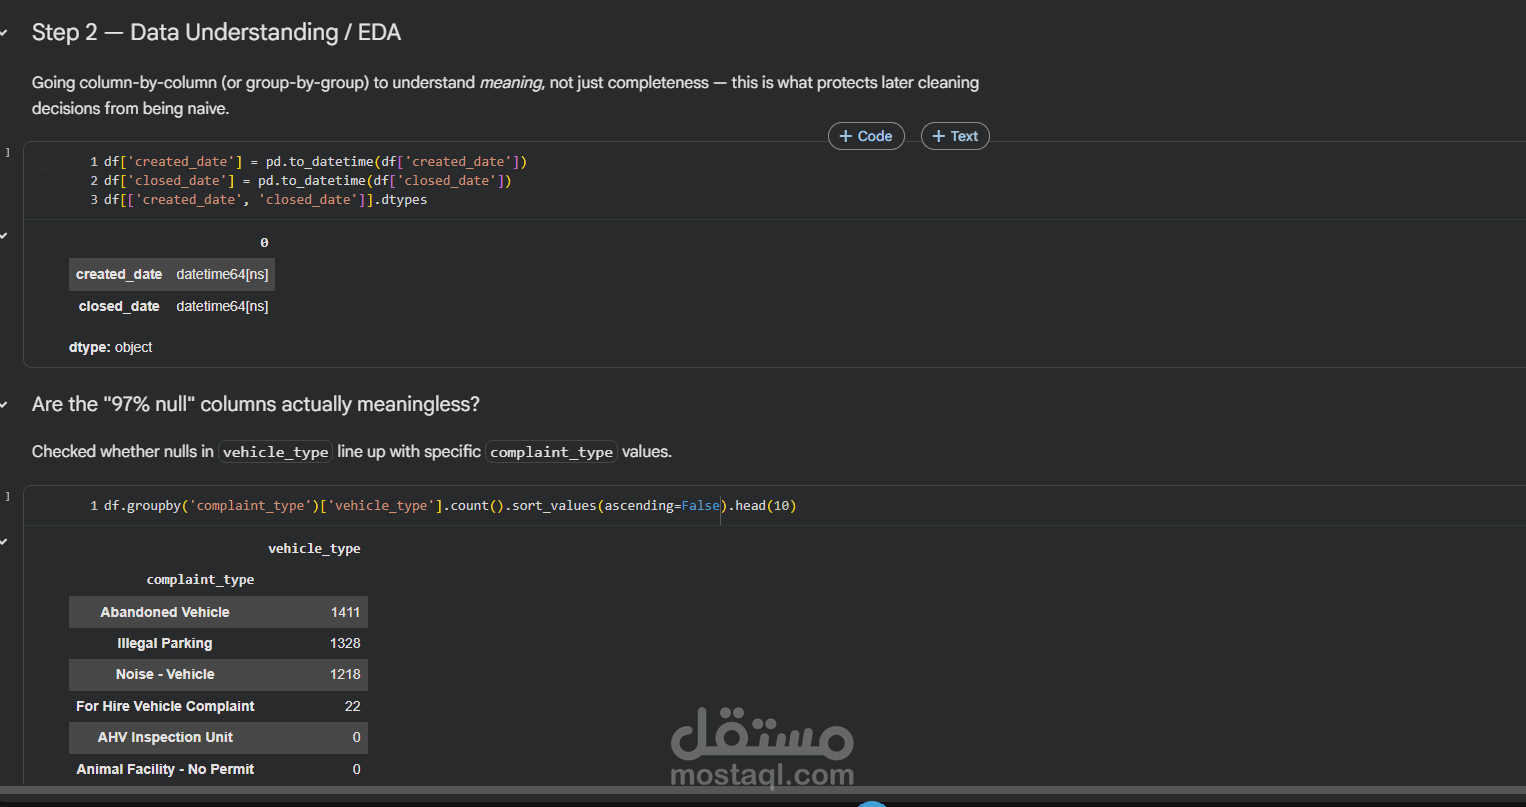
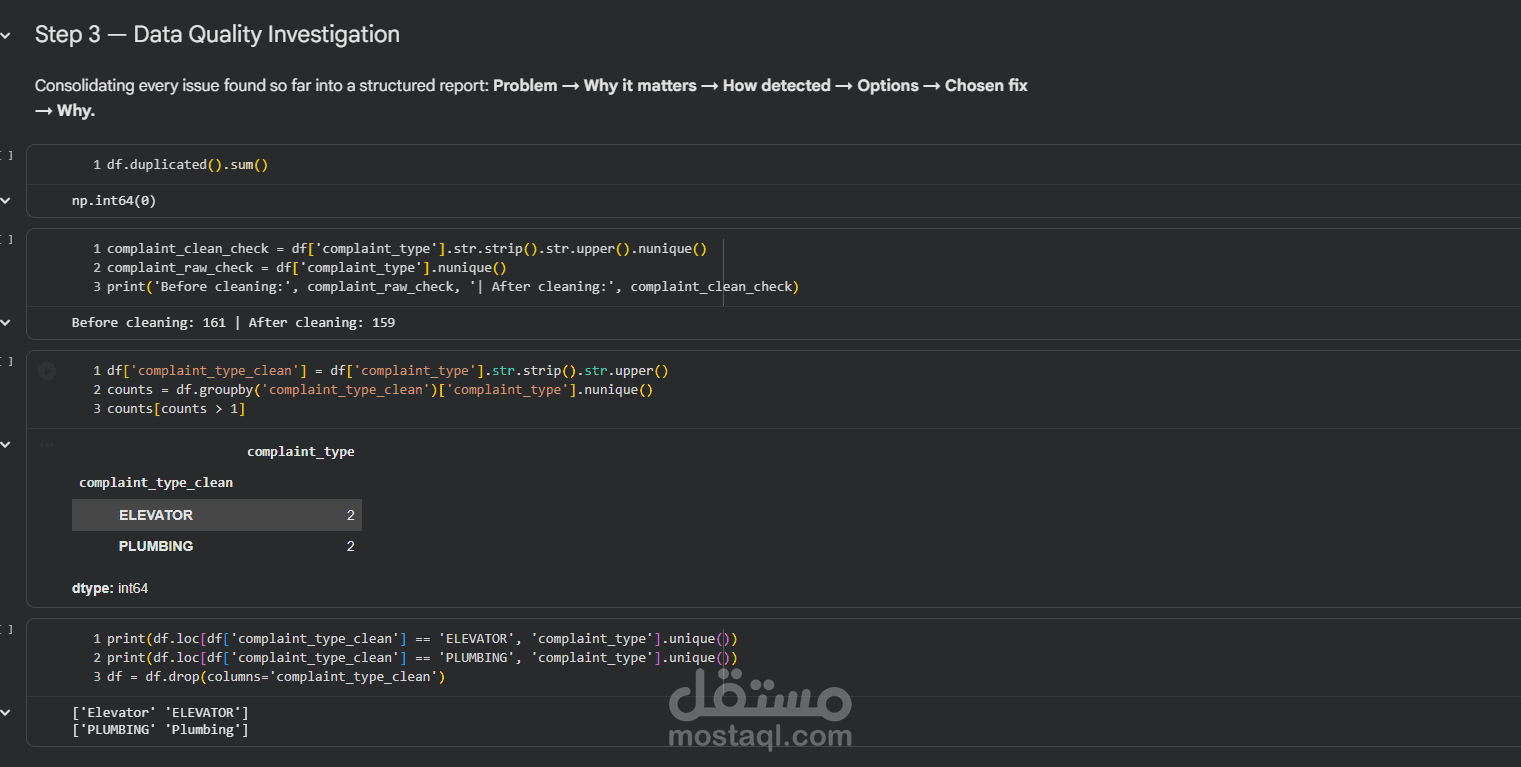
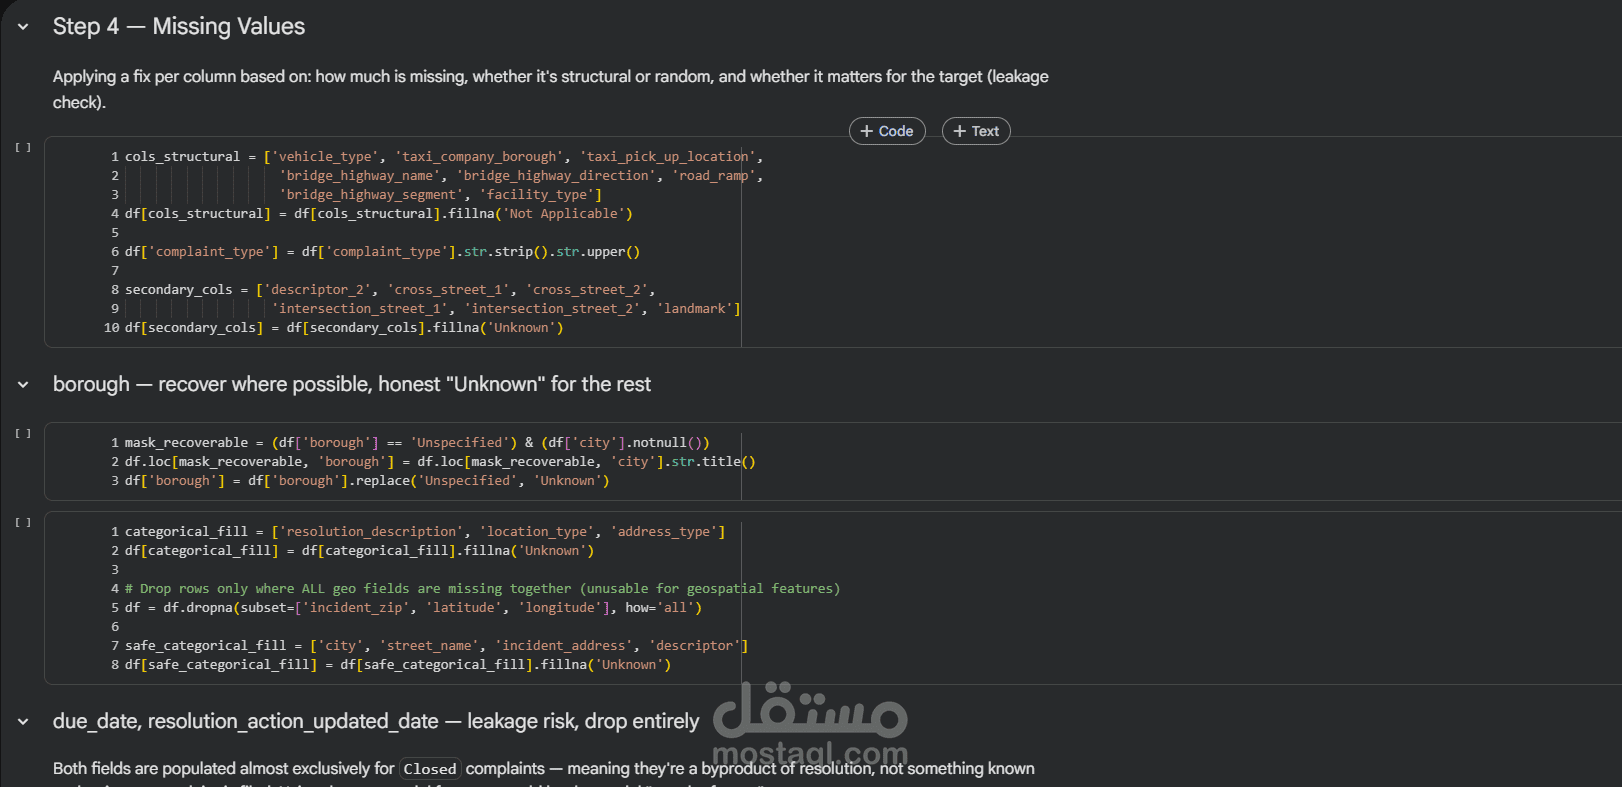
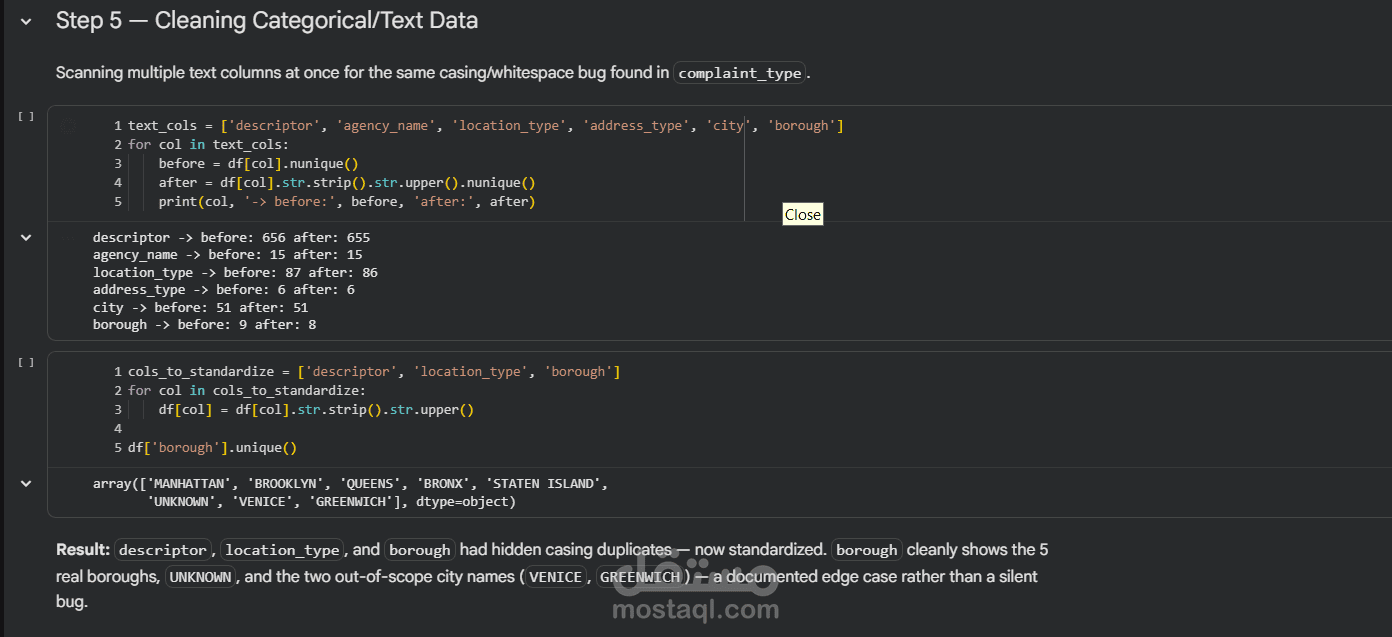
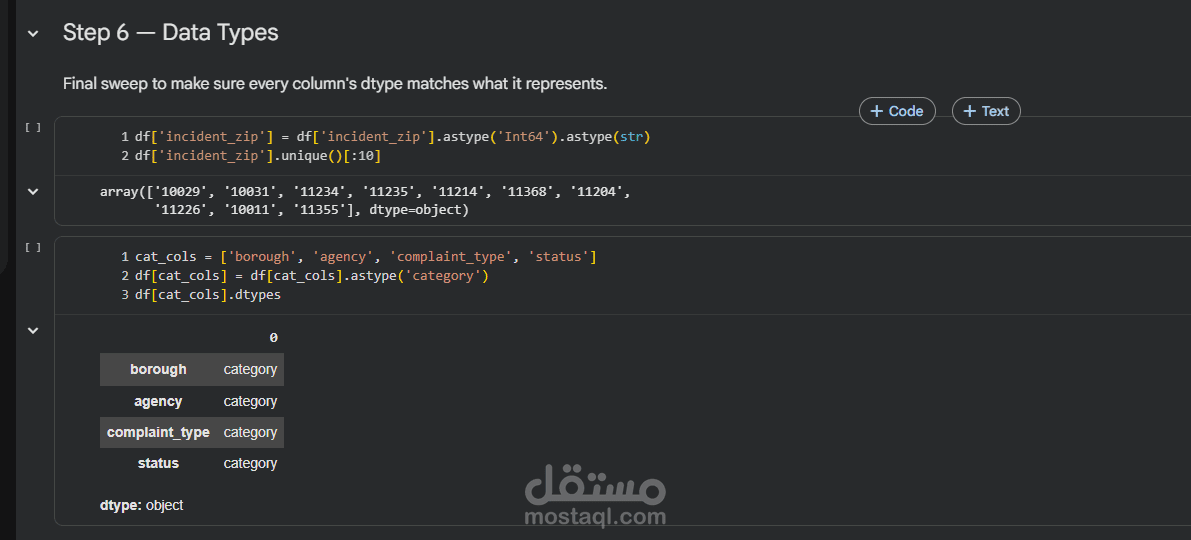
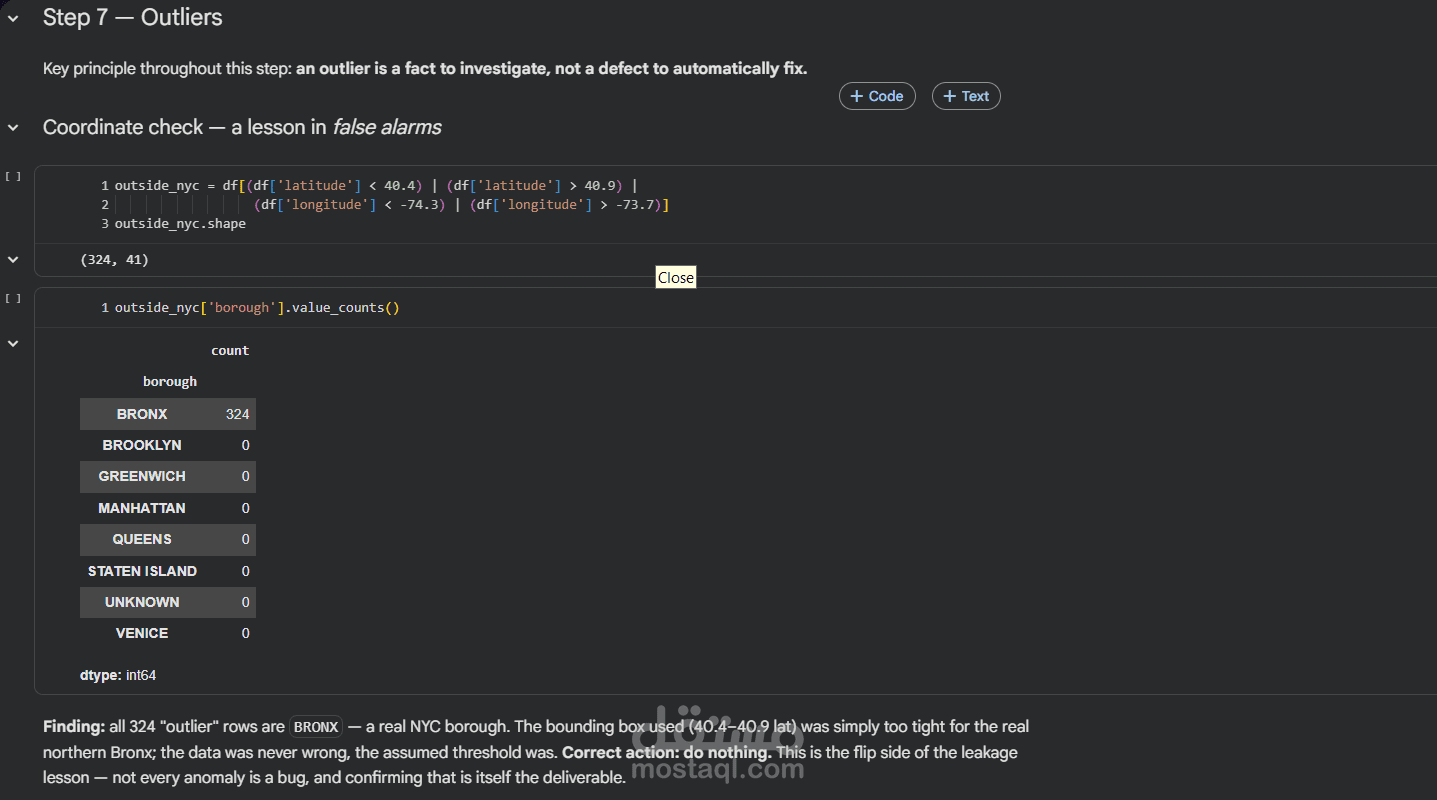
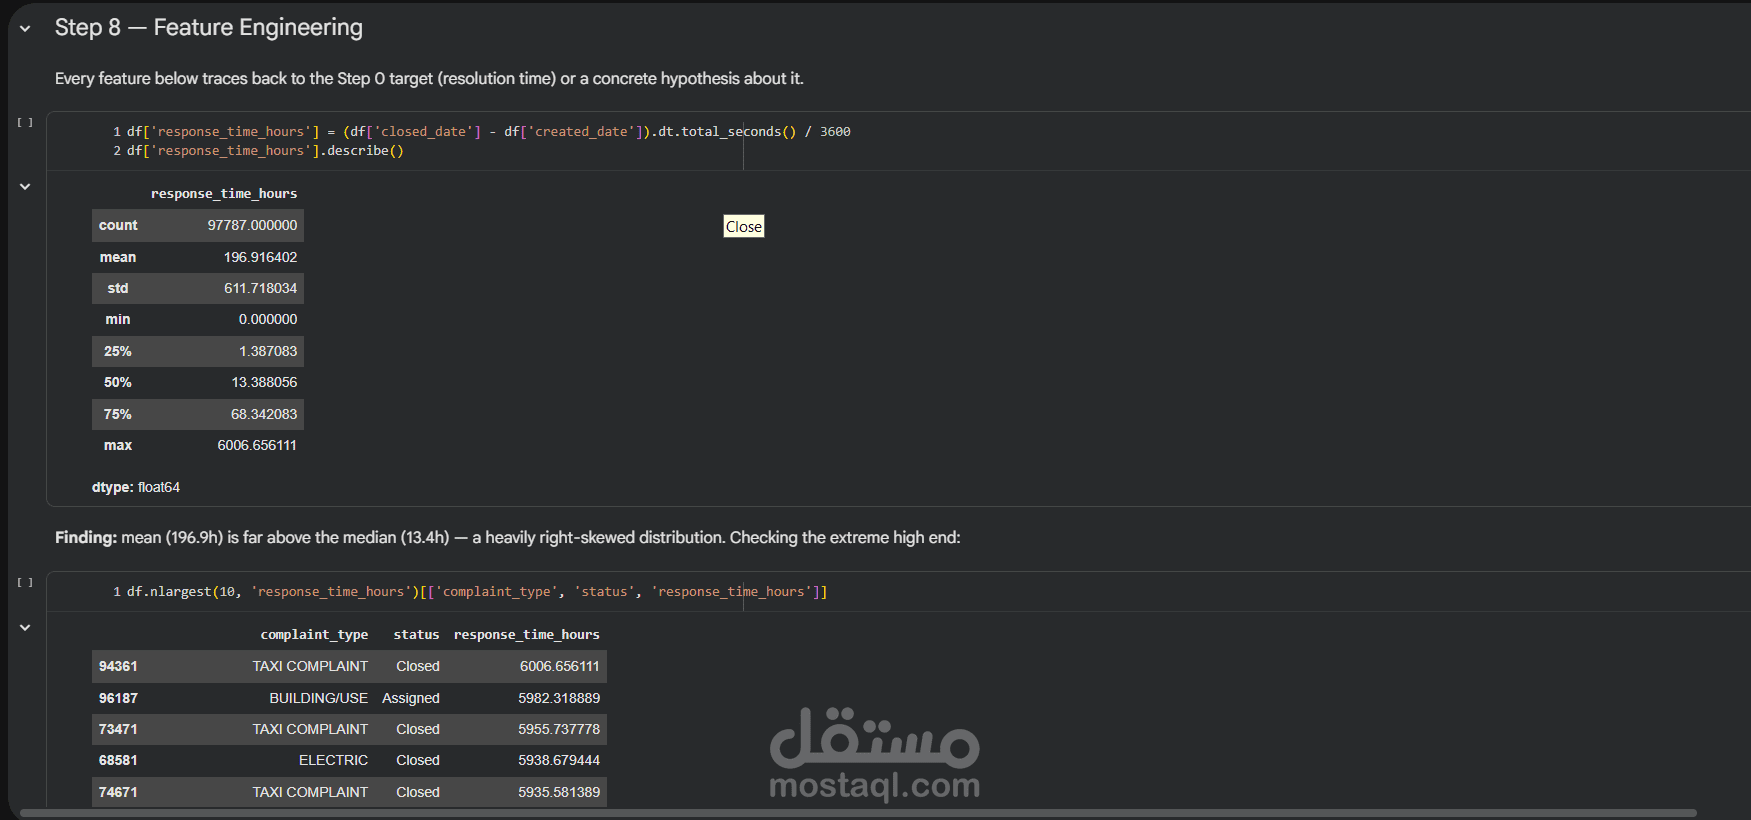
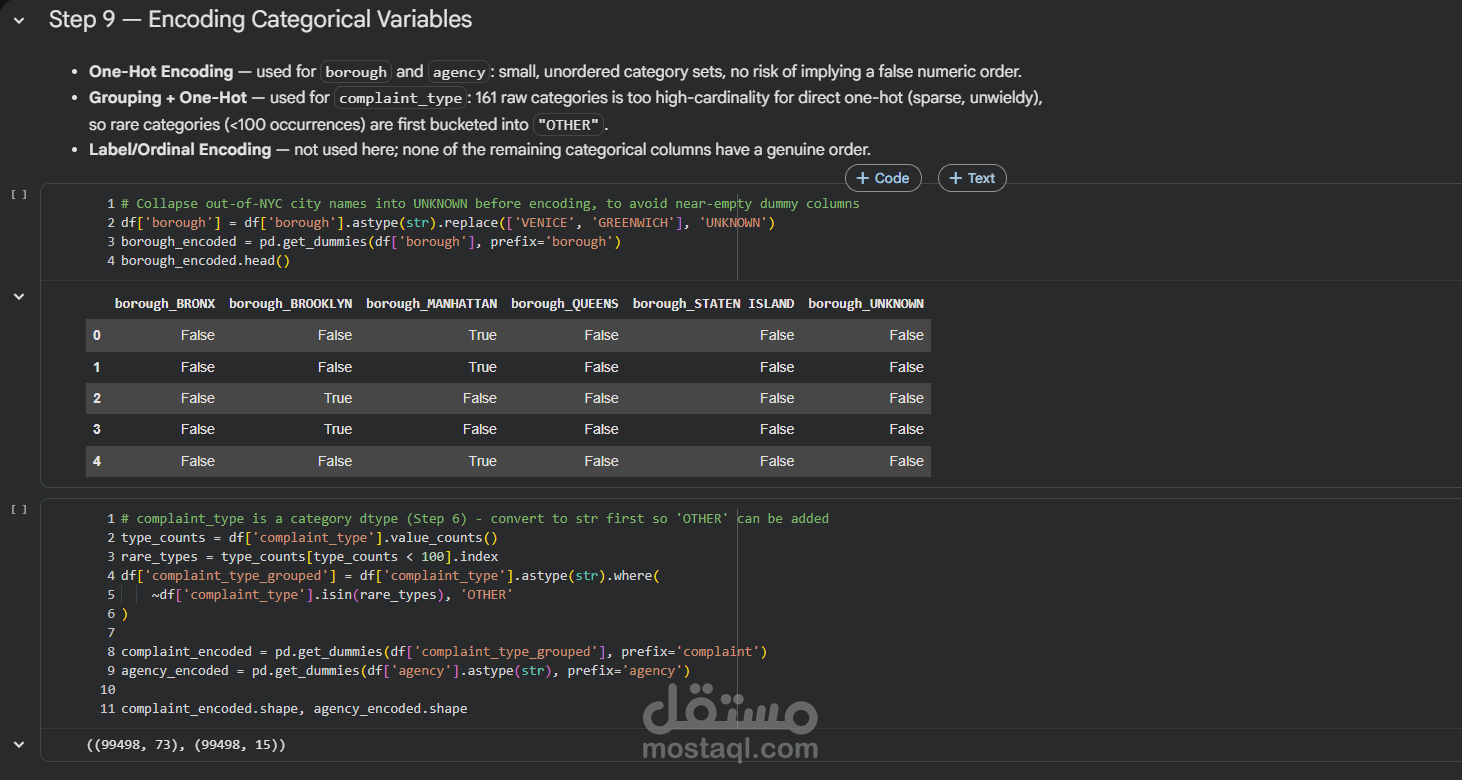
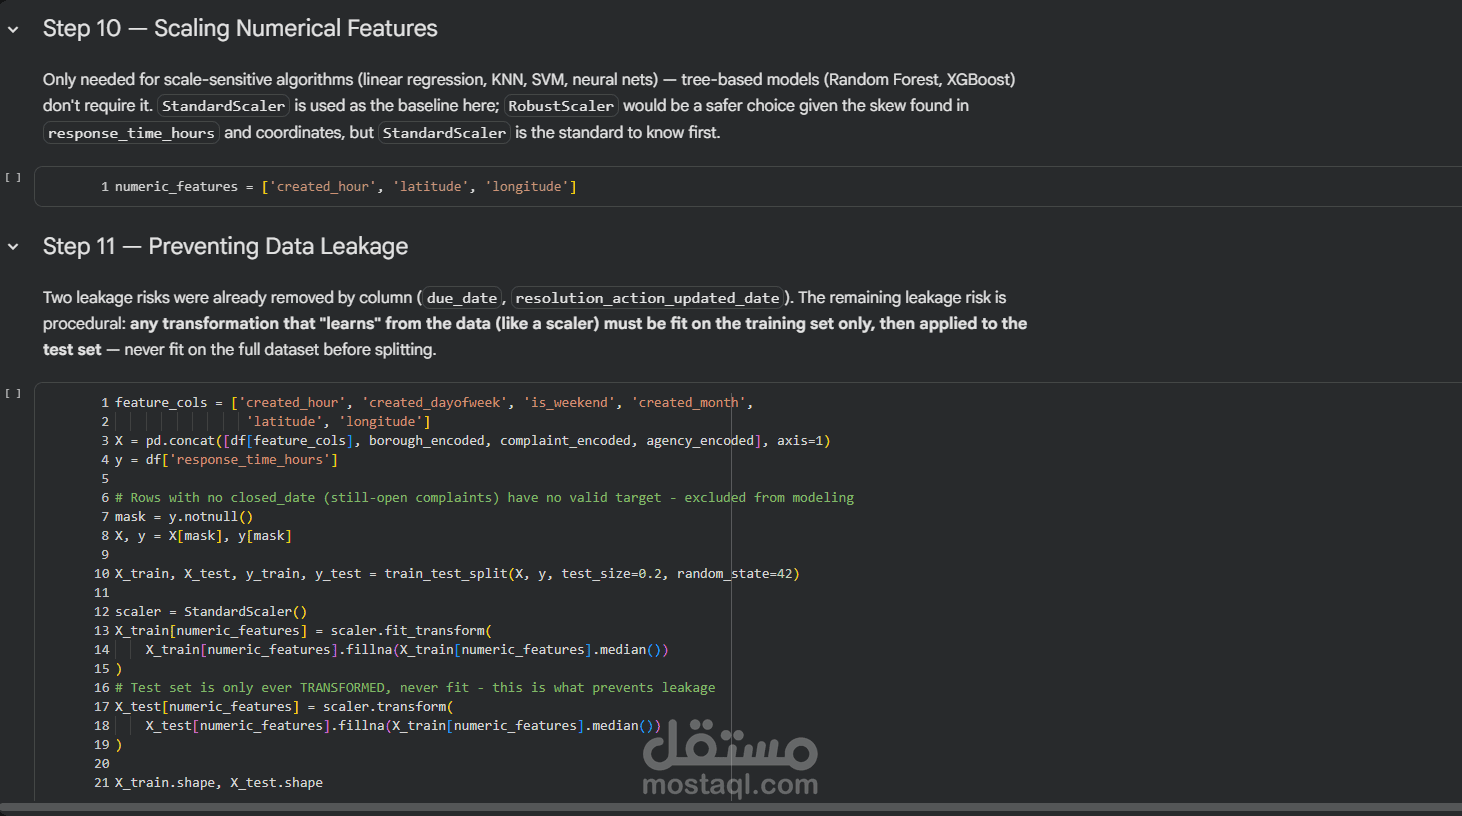
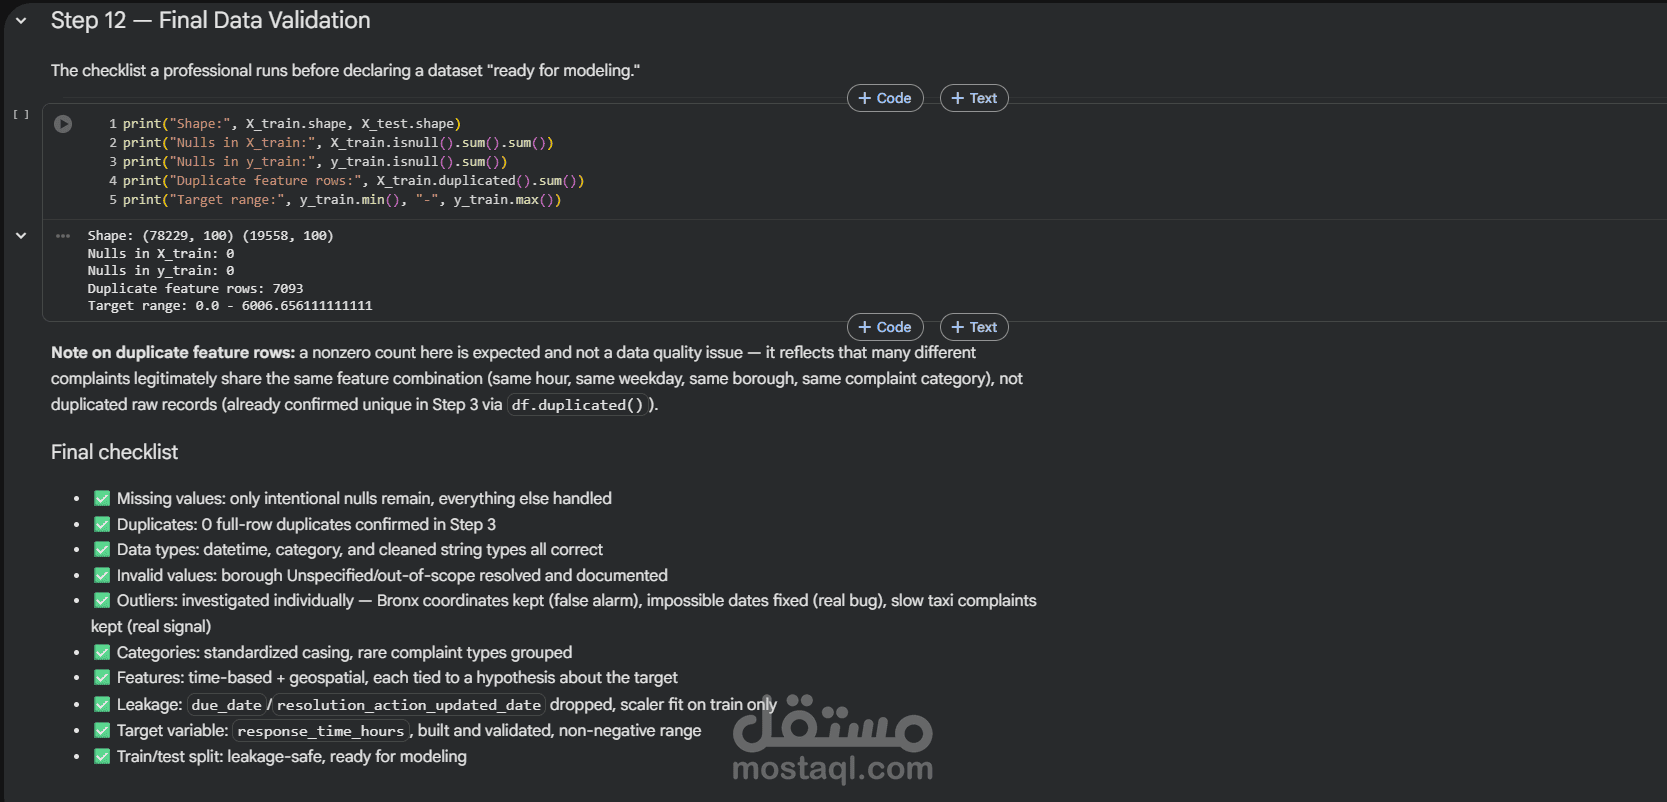
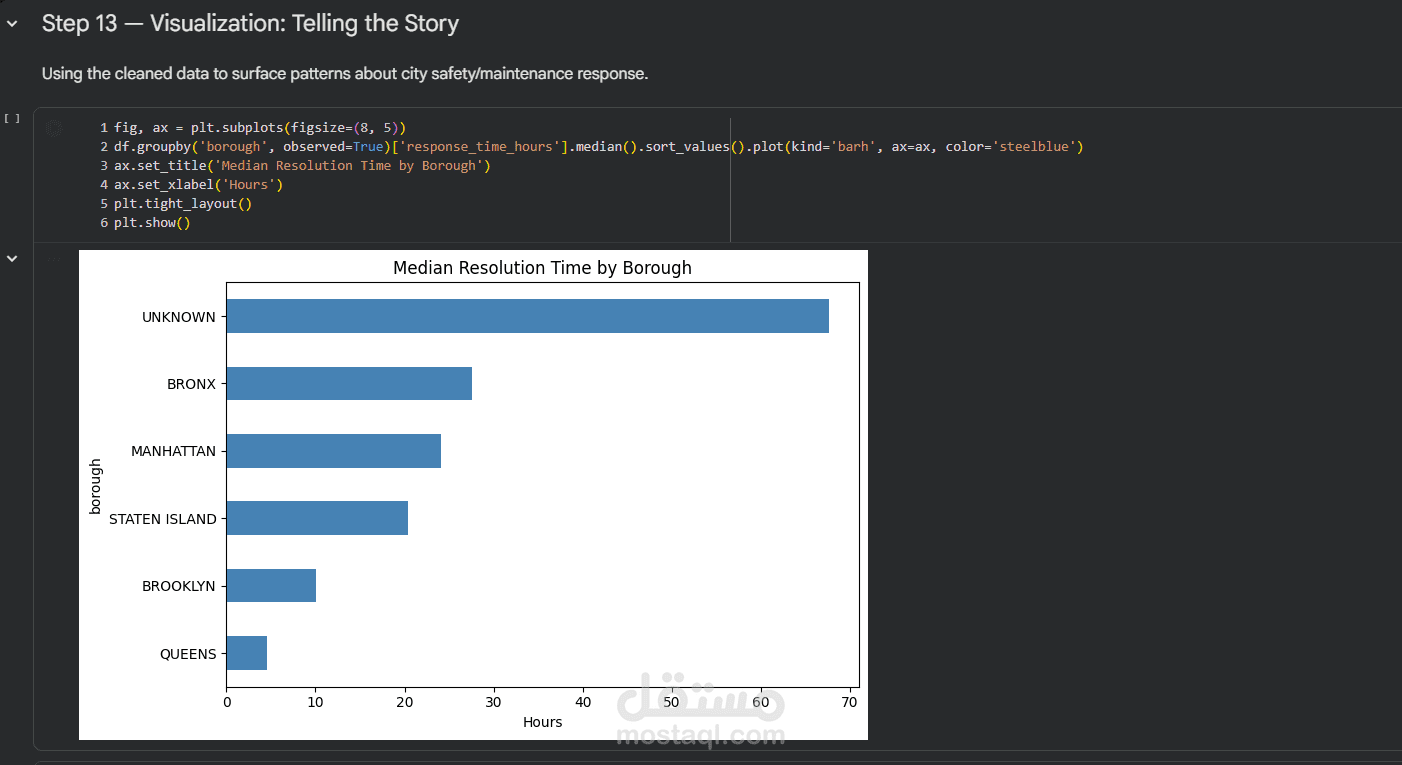
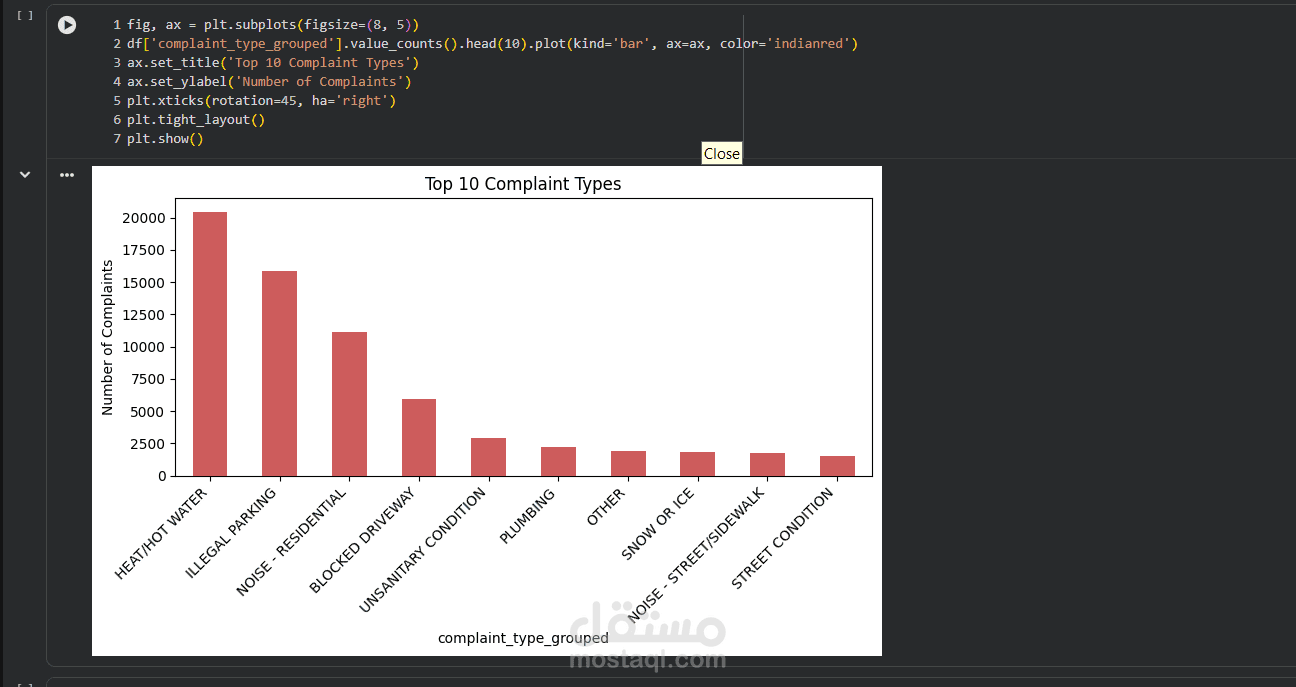
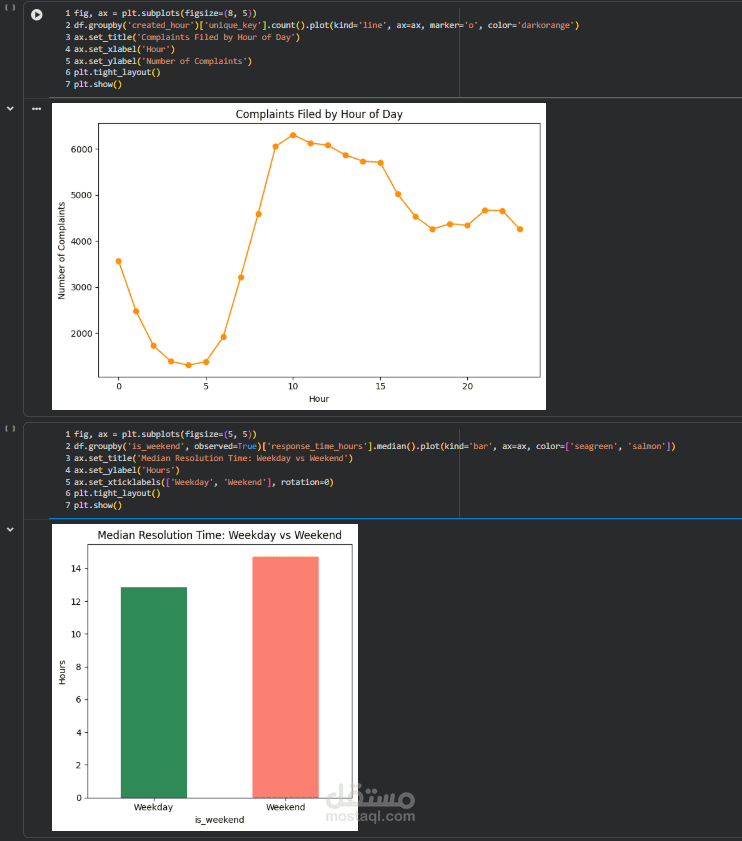
مشروع علوم بيانات متكامل على مجموعة بيانات NYC 311 Service Requests (بلاغات الخدمات العامة في مدينة نيويورك)، تضمّن اكتشاف مشاكل جودة البيانات ومعالجتها، التعامل مع القيم المفقودة (Missing Values)، توحيد صيغة البيانات النصية (Text Standardization)، واستخلاص خصائص جديدة (Feature Engineering) من الأبعاد الزمنية والجغرافية للبيانات، بالإضافة إلى تحليل استكشافي بصري (EDA) لاكتشاف الأنماط والعلاقات داخل البيانات. الهدف النهائي كان تجهيز البيانات بشكل كامل لتكون جاهزة لمرحلة النمذجة التنبؤية (Predictive Modeling)، باستخدام Python وPandas وMatplotlib/Seaborn. المشروع يوضّح خبرتي العملية في أهم وأصعب مرحلة في أي مشروع Data Science، وهي تجهيز وتنظيف البيانات الخام لتصبح قابلة للاستخدام في التحليل والنمذجة.