Spam Detection System
تفاصيل العمل
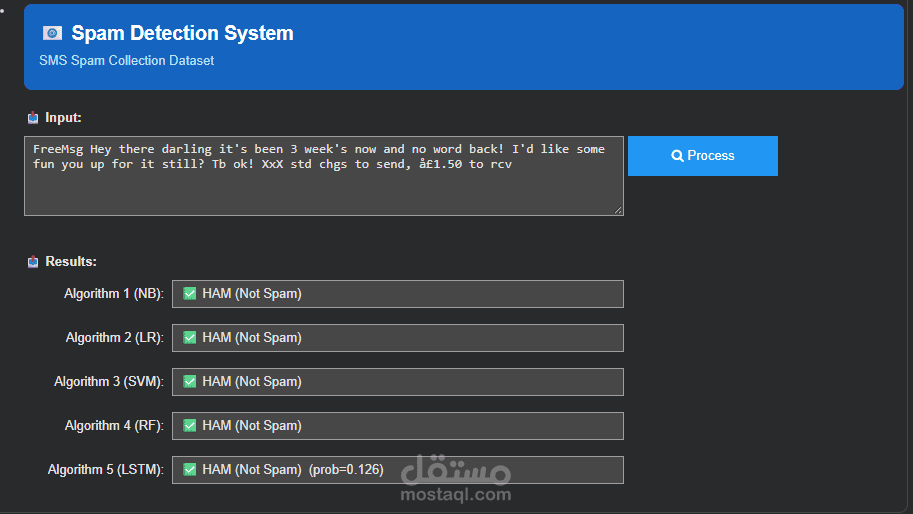
نبذة عن المشروع: اسم المشروع هو Spam Detection System، ويعتمد على مجموعة بيانات SMS Spam Collection Dataset التي تتضمن 5,572 رسالة نصية مصنفة إلى رسائل عادية (ham) أو رسائل مزعجة (spam).
خطوات العمل ومعالجة البيانات: تم استخدام مكتبات التعلم الآلي والعميق مثل scikit-learn و nltk و TensorFlow/Keras. تمت معالجة النصوص عبر تحويلها إلى أحرف صغيرة، إزالة الروابط وعناوين البريد الإلكتروني والرموز الخاصة، تطبيق تقنية إيقاف الكلمات (Stopwords)، واستخدام WordNetLemmatizer لرد الكلمات لجذورها. بعد ذلك، تم استخدام تقنية TF-IDF Vectorizer لتمثيل النصوص برمجياً، وتم تقسيم البيانات بنسبة 80% للتدريب و 20% للاختبار عبر (train_test_split).
الخوارزميات المستخدمة ومقارنة النتائج: تم تدريب واختبار 5 خوارزميات مختلفة، وكانت النتائج كالتالي:
* حقق نموذج SVM (Support Vector Machine) دقة بلغت 98.48% كأفضل أداء في المشروع.
* حقق نموذج Naive Bayes دقة بلغت 97.94%.
* حقق نموذج Random Forest دقة بلغت 97.49%.
* حقق نموذج Logistic Regression دقة بلغت 97.04%.
* حقق نموذج LSTM (التعلم العميق) دقة بلغت 86.64%.