Accent Identifcation: American, Brit, or Aussi?
تفاصيل العمل
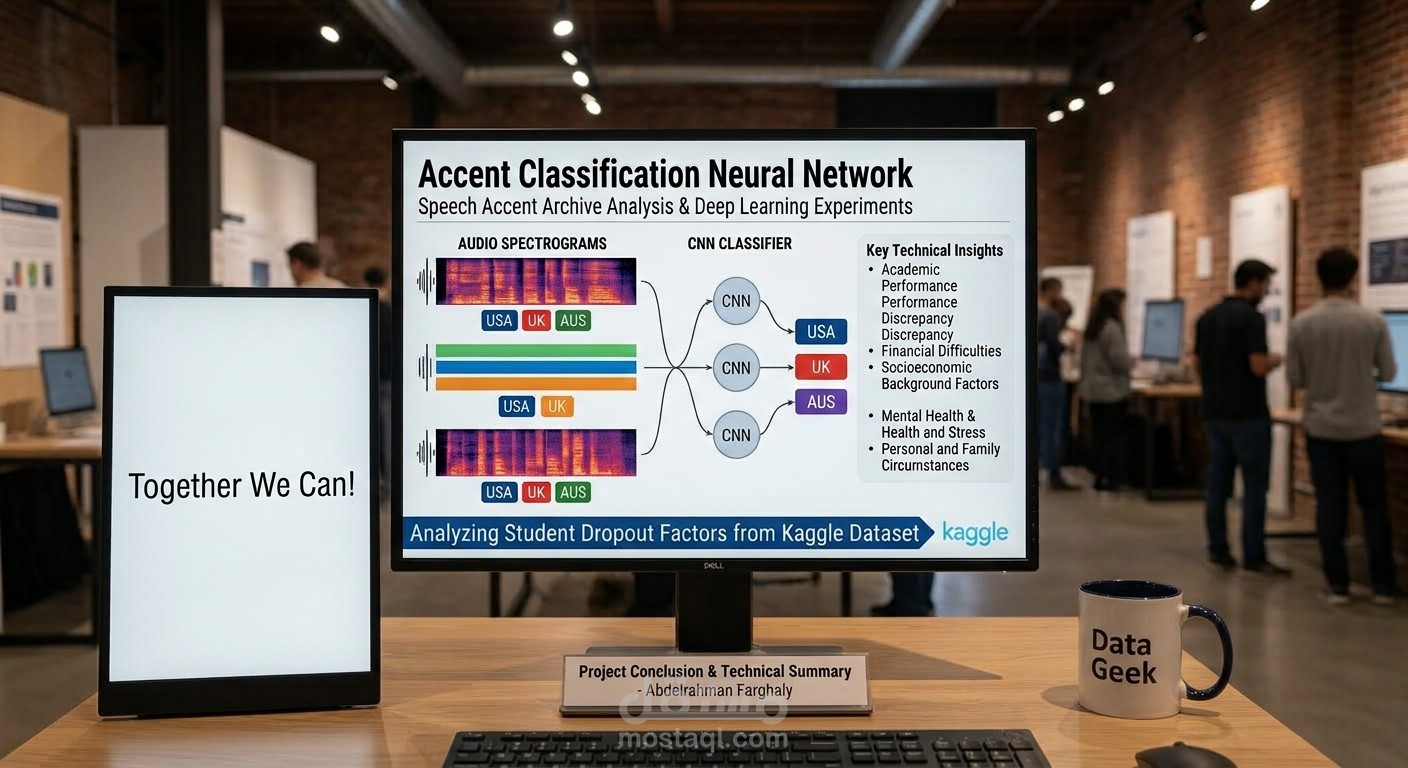
الهدف الأساسي من هذا المشروع لم يكن تقديم منتج نهائي أو حل تجاري لعميل، بل كان في المقام الأول رحلة تعليمية وتطبيقية لتعميق فهم مفاهيم التعلم العميق لمعالجة الصوت. تم التركيز على تدريب شبكة عصبية التفافية (CNN) لتصنيف المقطع الصوتي بناءً على اللهجة المستهدفة من ثلاث دول مختلفة (الولايات المتحدة، المملكة المتحدة، وأستراليا) اعتمادًا على تحويل التسجيلات الصوتية إلى صور طيفية (Mel-Spectrograms) باستخدام مكتبة Librosa. خلال تنفيذ هذا مشروع، تم استخلاص درسين رئيسيين في مجال معالجة البيانات والتعلم الآلي؛ الأول هو أهمية التعامل مع عدم توازن الفئات (Class Imbalance) في البيانات، حيث كان عدد العينات الخاص باللهجة الأمريكية أعلى بكثير من بقية اللهجات، مما تطلب استخدام أوزان الفئات (Class Weights) لموازنة عملية التدريب. أما الدرس الثاني، فكان إدراك تأثير حجم البيانات الكلي عند التعامل مع شبكات CNN؛ حيث أن التدريب على عدد محدود نسبياً من المقاطع (470 مقطعاً) ينطوي على مخاطر الإفراط في المطابقة (Overfitting)، مما يبرز أهمية تقنيات التجميع والاستقطاع الهيكلي لتحسين أداء النموذج.