Healthcare Insurance Cost Prediction using Machine Learning
تفاصيل العمل
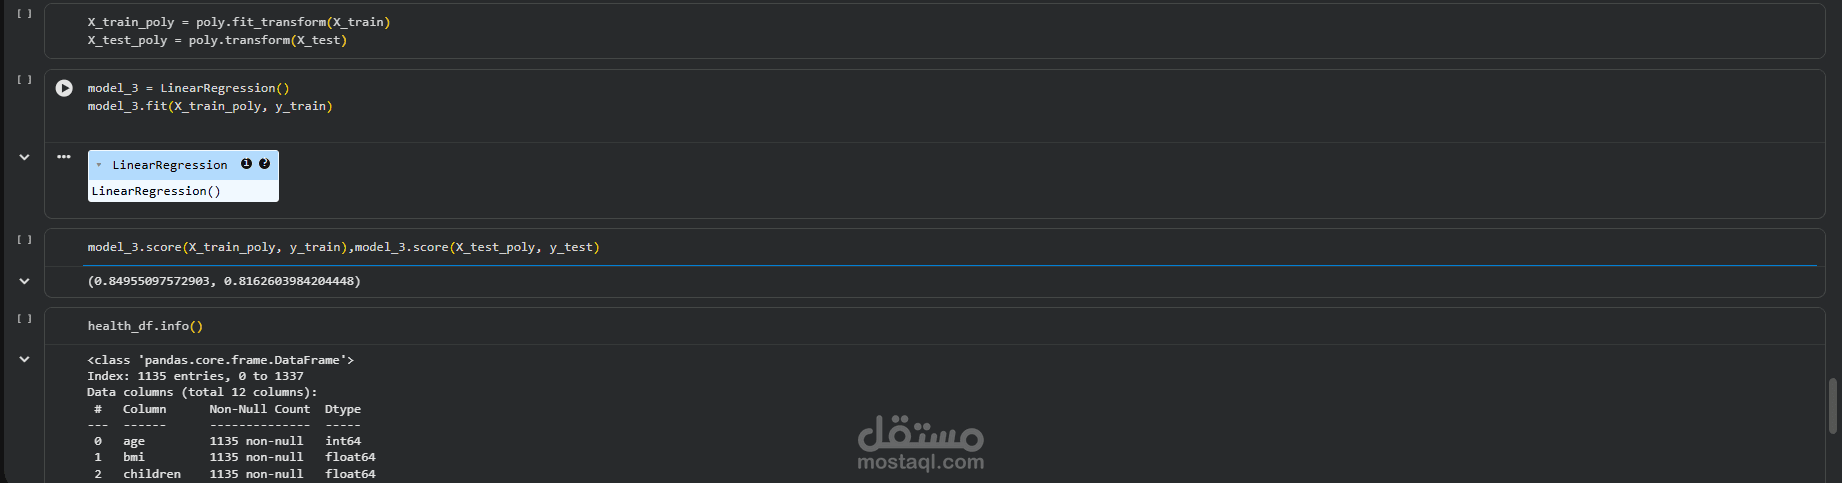
قمت بتطوير نموذج تعلم آلة (Machine Learning) متكامل لتحليل وتوقع تكاليف التأمين الصحي للمرضى بناءً على مجموعة من العوامل الصحية والديموغرافية (مثل العمر، مؤشر كتلة الجسم BMI، حالة التدخين، المنطقة الجغرافية، وعدد الأطفال). تم تنفيذ المشروع عبر بيئة Google Colab باستخدام لغة بايثون (Python).
الخطوات والمميزات الرئيسية في المشروع:
معالجة وتنظيف البيانات (Data Preprocessing): التعامل مع البيانات المفقودة (Missing Values)، وتصفية القيم الشاذة (Outliers) سواء في مؤشر كتلة الجسم أو التكاليف باستخدام طريقة الانحراف المعياري (Z-Score) لضمان أعلى مستويات الدقة لبيانات التدريب.
التحليل الاستكشافي للبيانات (EDA): تصميم رسوم بيانية متقدمة (Boxplots, Histograms, Pie Charts) واستخراج مصفوفة الارتباط (Correlation Heatmap) لدراسة مدى تأثير كل عامل على تكلفة التأمين، وذلك بالاعتماد على مكتبتي Matplotlib و Seaborn.
هندسة الميزات (Feature Engineering): تحويل البيانات الفئوية (Categorical Data) كالجنس ومناطق السكن والتدخين إلى قيم رقمية، بالإضافة إلى توحيد المقاييس (Standardization) للبيانات باستخدام مكتبة Scikit-learn.
بناء النماذج وتقييمها (Model Building):
تم تدريب واختبار خوارزمية الانحدار الخطي البسيط (Linear Regression).
تم رفع كفاءة النموذج بشكل ملحوظ وتطويره باستخدام الانحدار المتعدد الحدود (Polynomial Regression من الدرجة الثانية).
النتائج: حقق النموذج المطور (Polynomial Regression) أداءً ممتازاً، حيث وصلت دقة التوقع إلى قرابة 85% على بيانات التدريب وأكثر من 81% على بيانات الاختبار، مما يؤكد قدرته العالية على تقديم تنبؤات دقيقة للتكاليف الطبية.