محلل الأحافير (Fossil Analyzer)
تفاصيل العمل
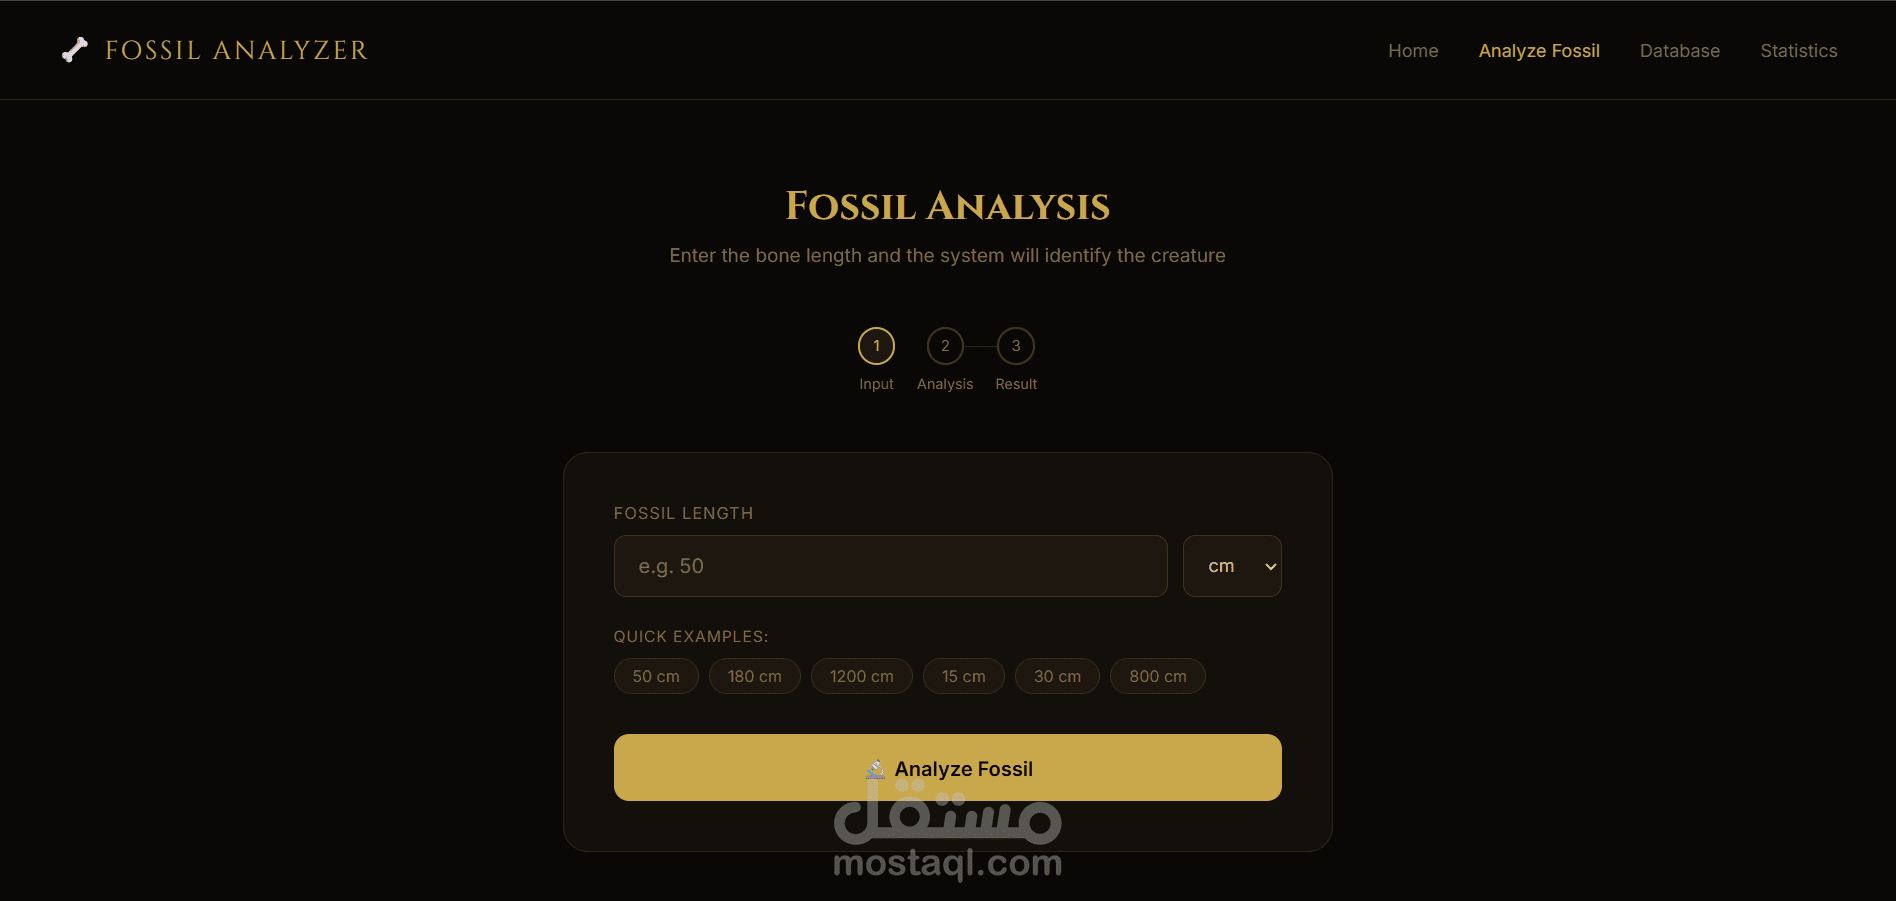
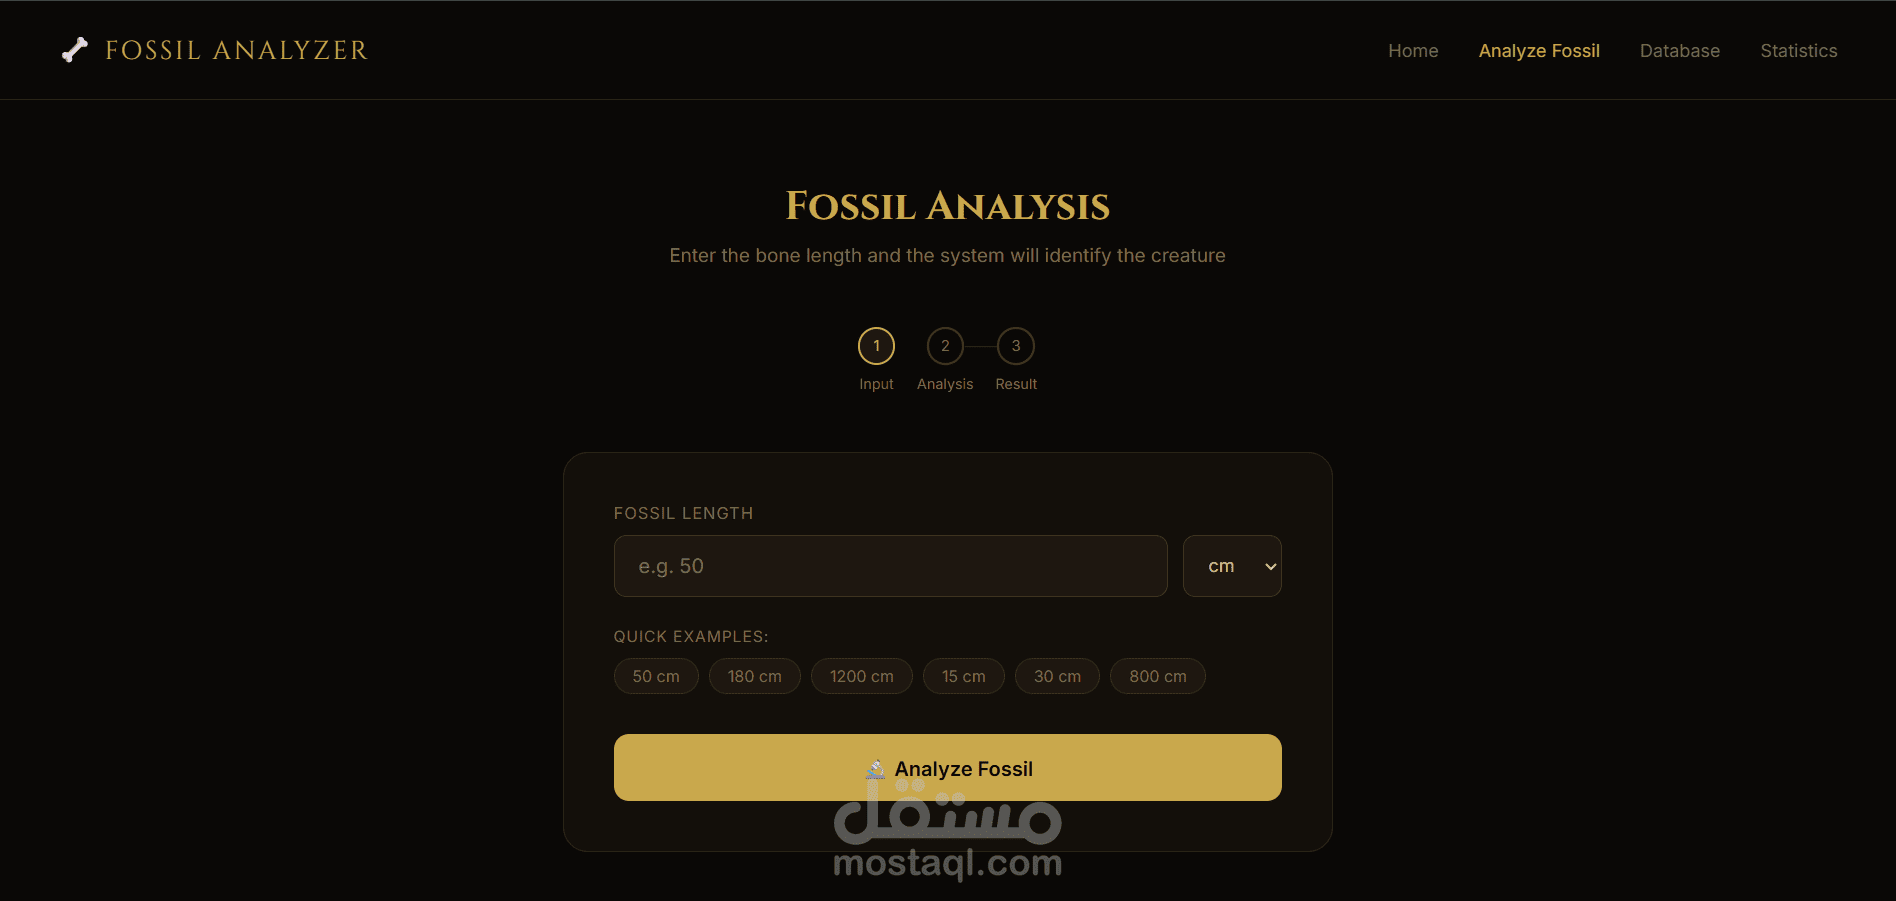
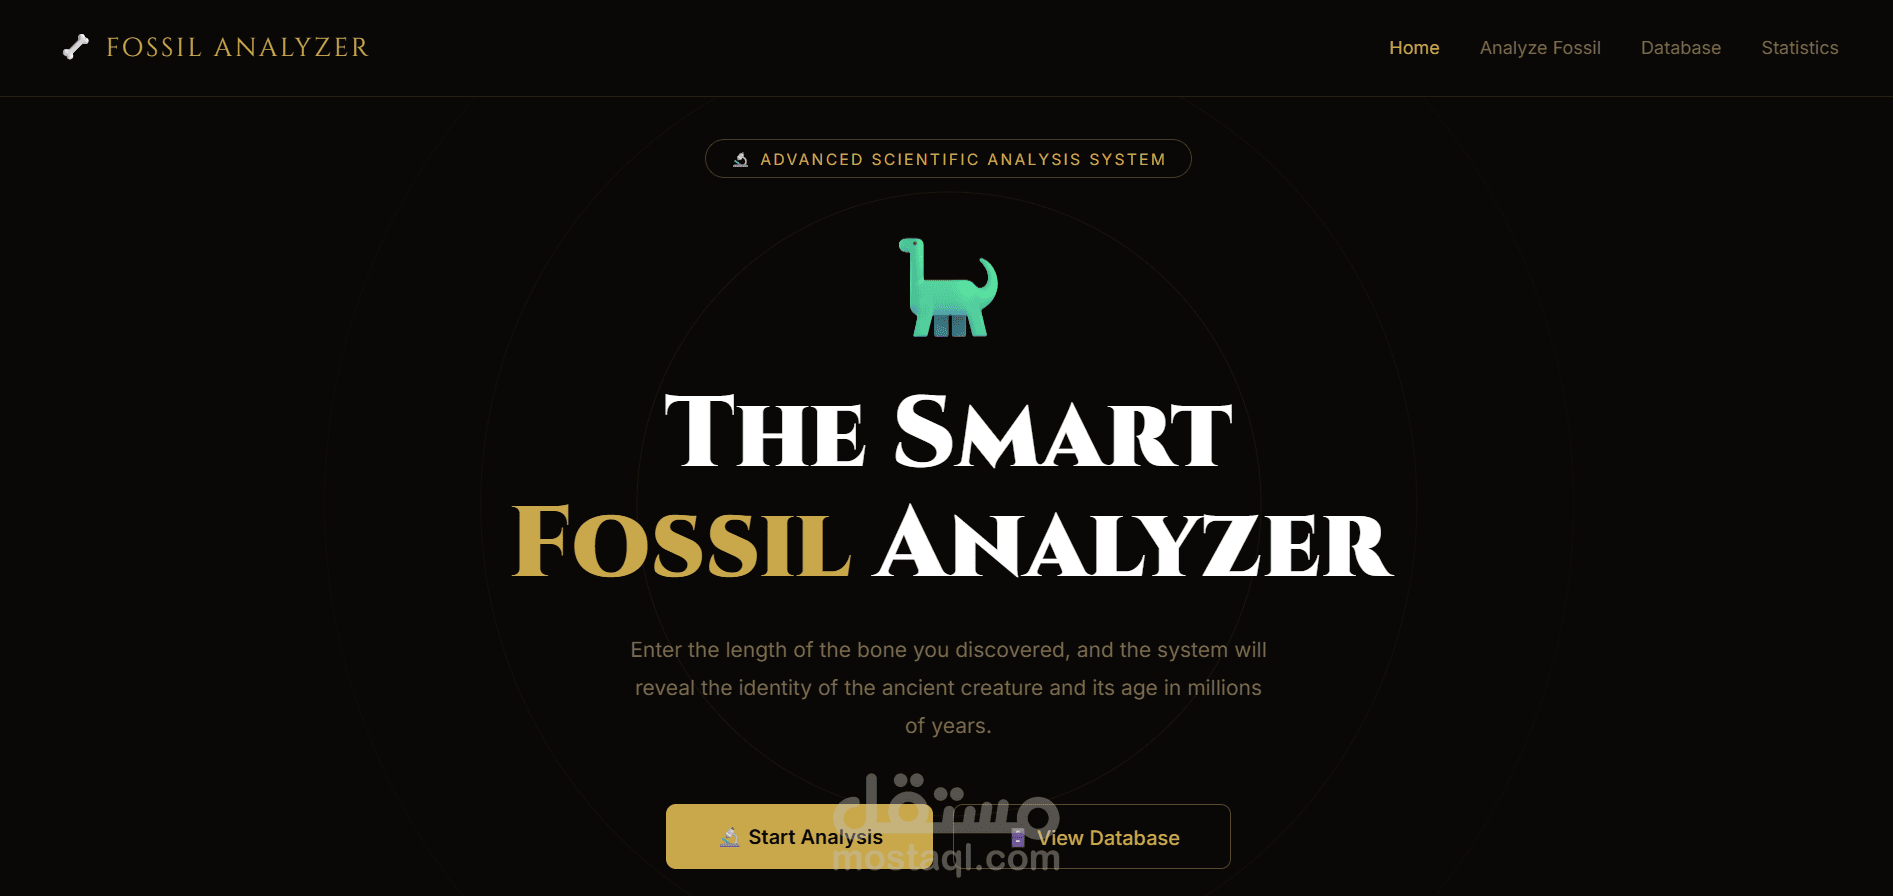
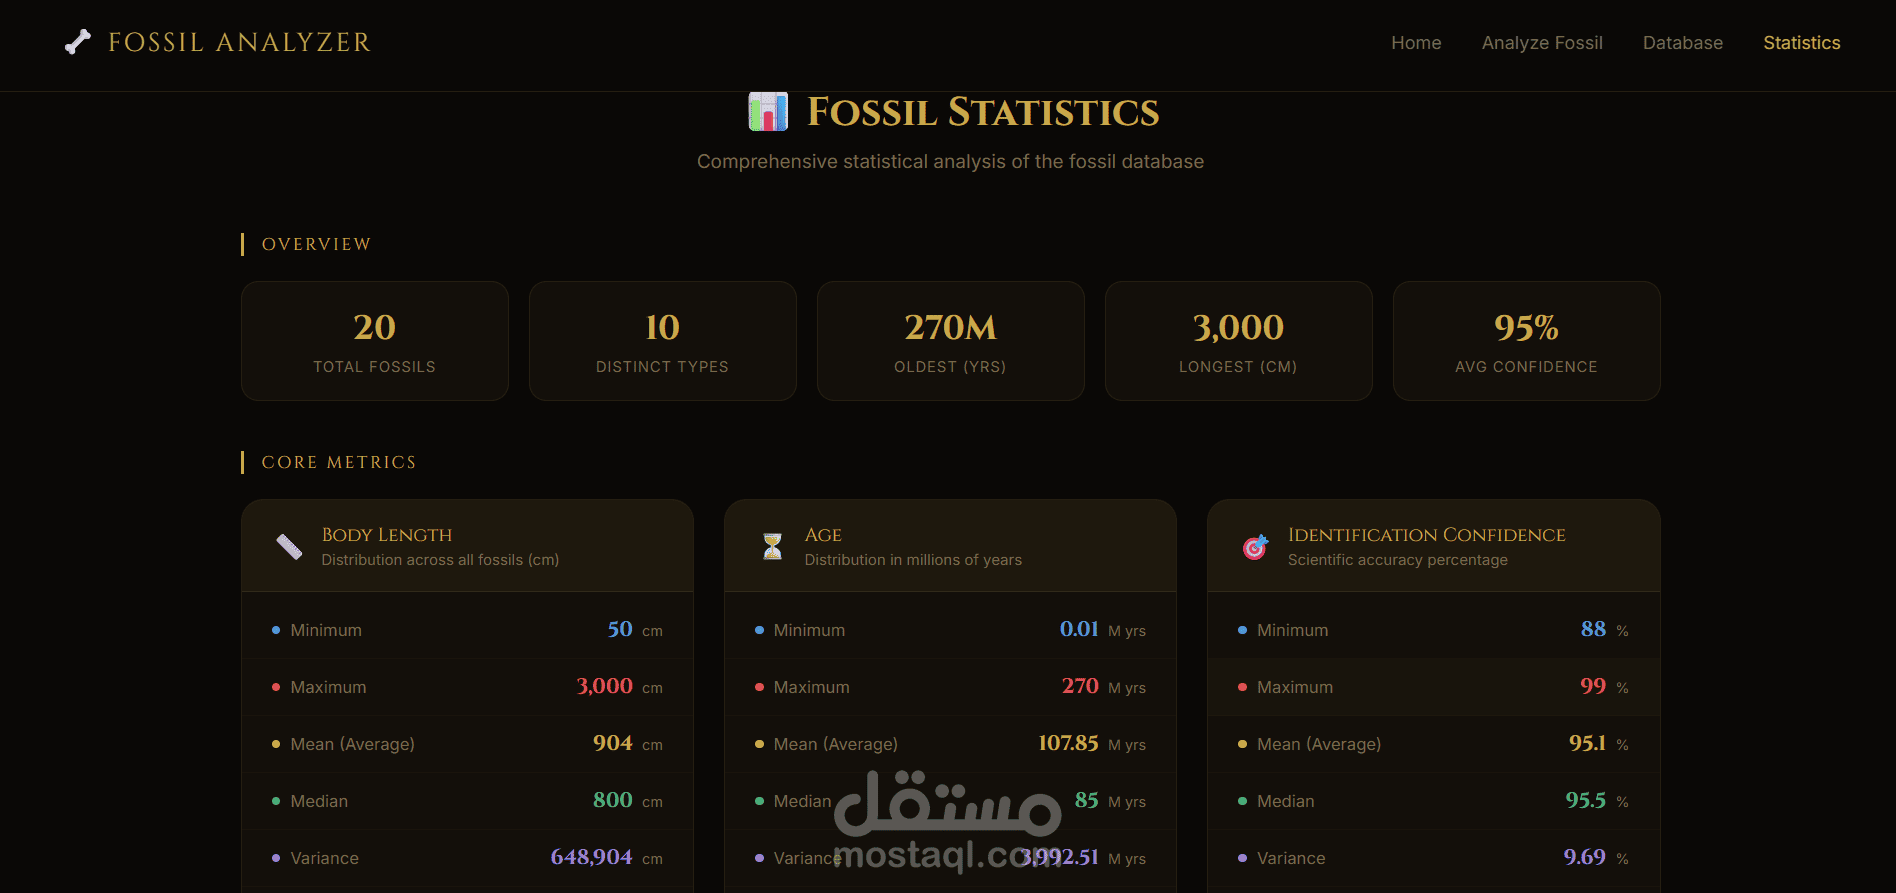
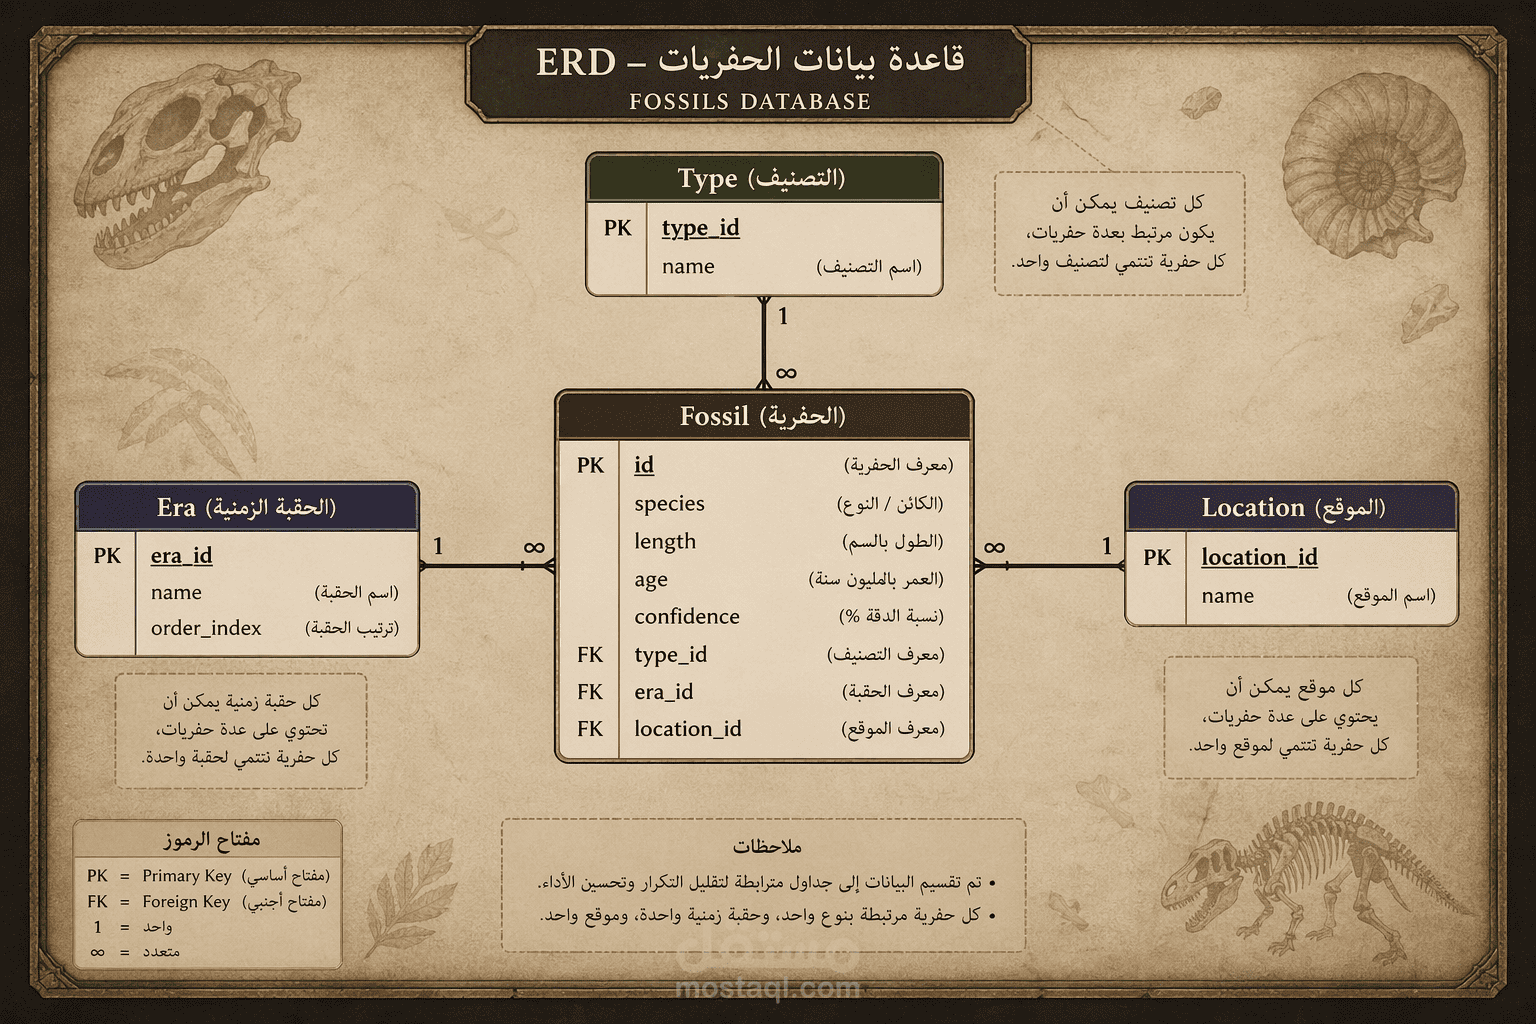
مشروع ويب متكامل (Front-end + Back-end) لتحليل وتحديد نوع الأحفورة بناءً على طول العظمة المُكتشفة، مع قاعدة بيانات علمية تحتوي على 20 سجل أحفورة حقيقية (ديناصورات، زواحف بحرية، طيور بدائية، ثدييات ما قبل التاريخ).
اللغات والتقنيات المستخدمة:
Back-end: Node.js مع إطار عمل Express.js لبناء REST API، ومكتبة CORS للتعامل مع الطلبات بين النطاقات (Cross-Origin).
Front-end: HTML5 و CSS3 و JavaScript (Vanilla JS) بدون أي إطار عمل خارجي، مع استخدام Fetch API للتواصل مع السيرفر.
قاعدة البيانات: ملف JSON (كقاعدة بيانات خفيفة) يحتوي على بيانات الأحافير المهيكلة.
إدارة الحزم عبر npm (package.json).
أهم المميزات:
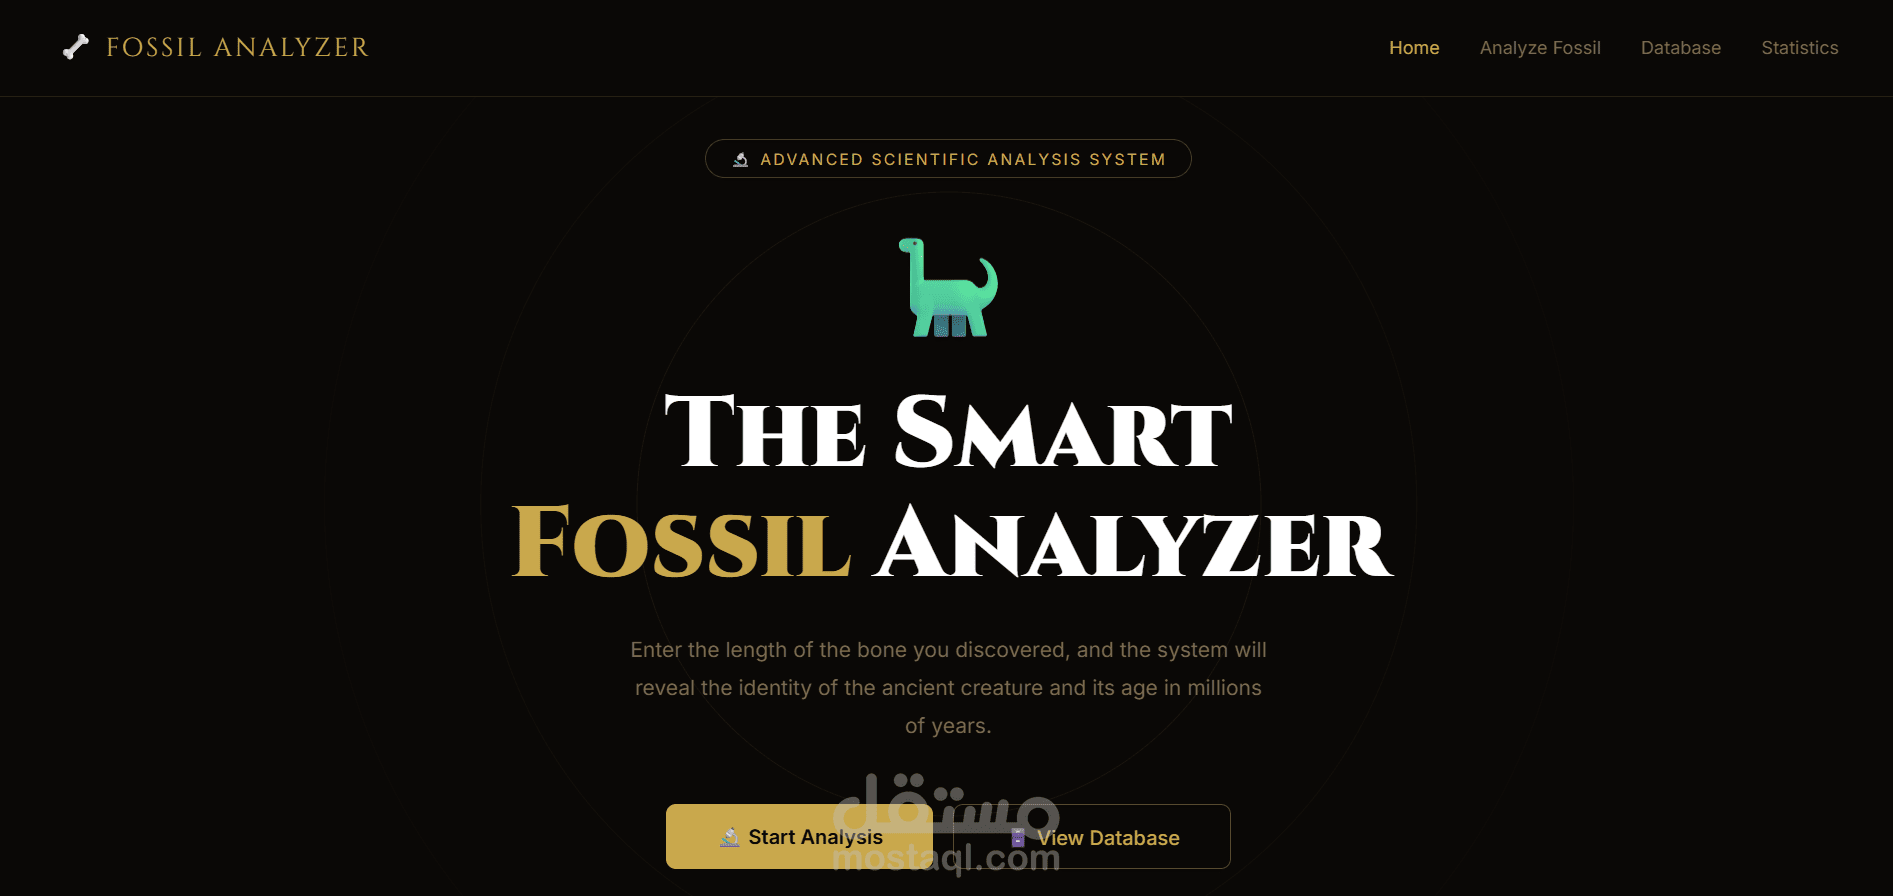
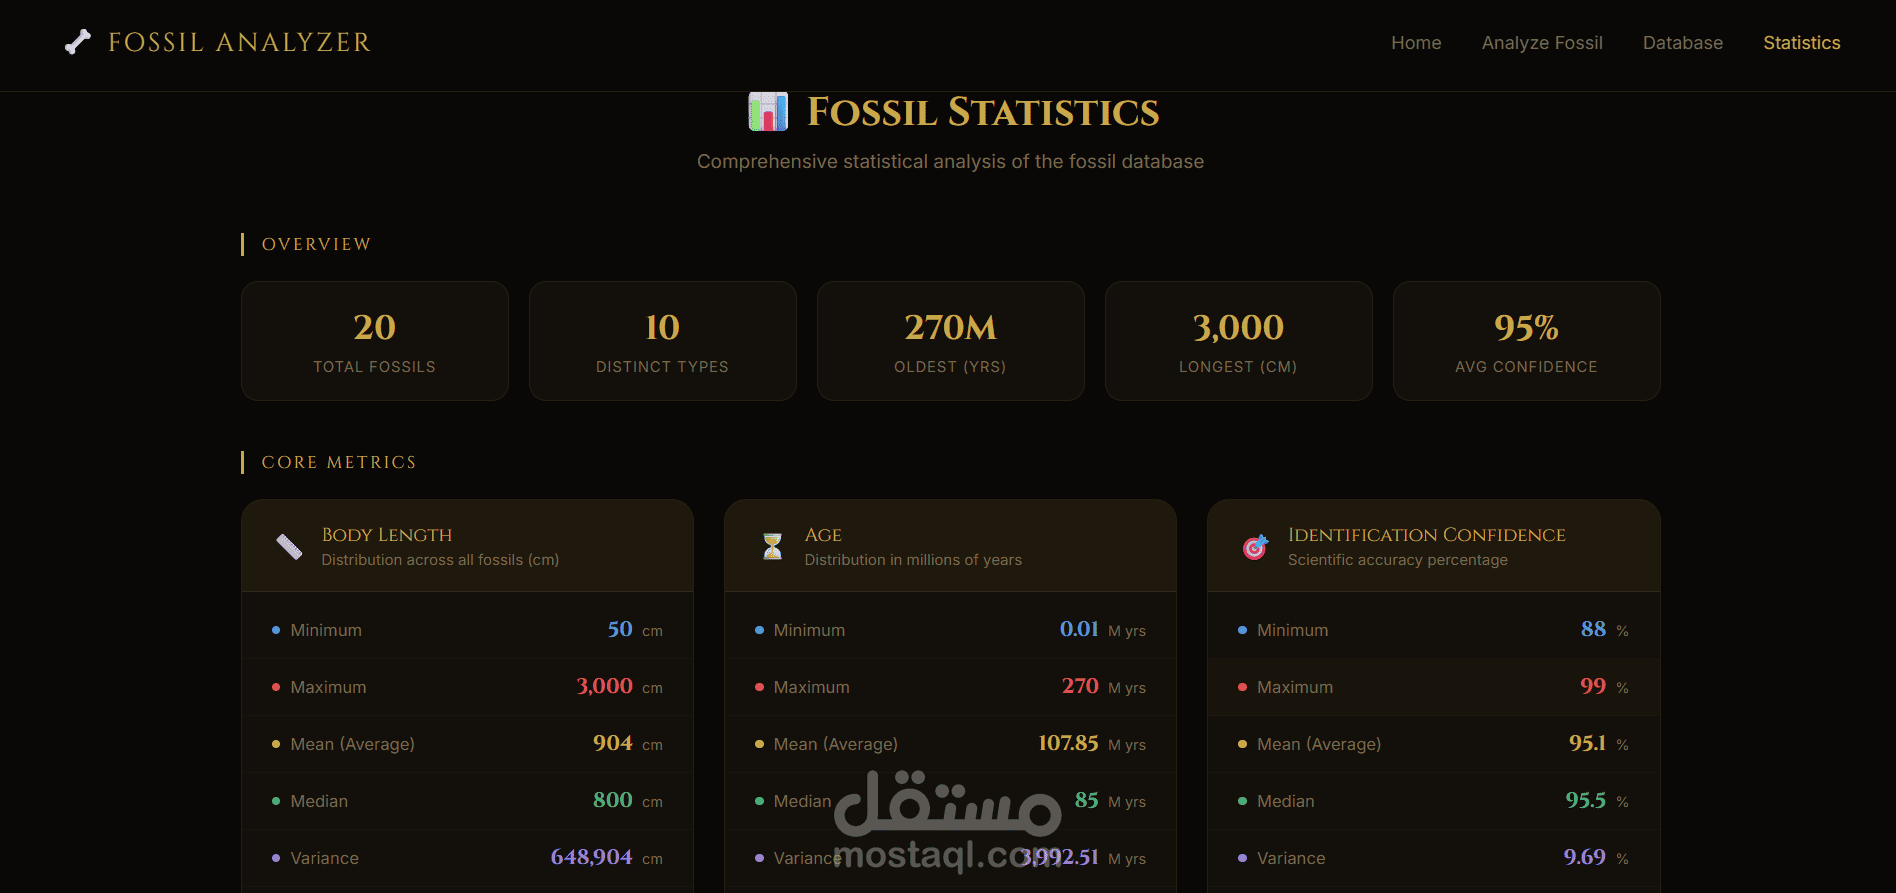
صفحة رئيسية (Landing Page): تعرض إحصائيات حية (عدد الأحافير، متوسط دقة البيانات، عدد الأنواع) يتم جلبها مباشرة من الـ API.
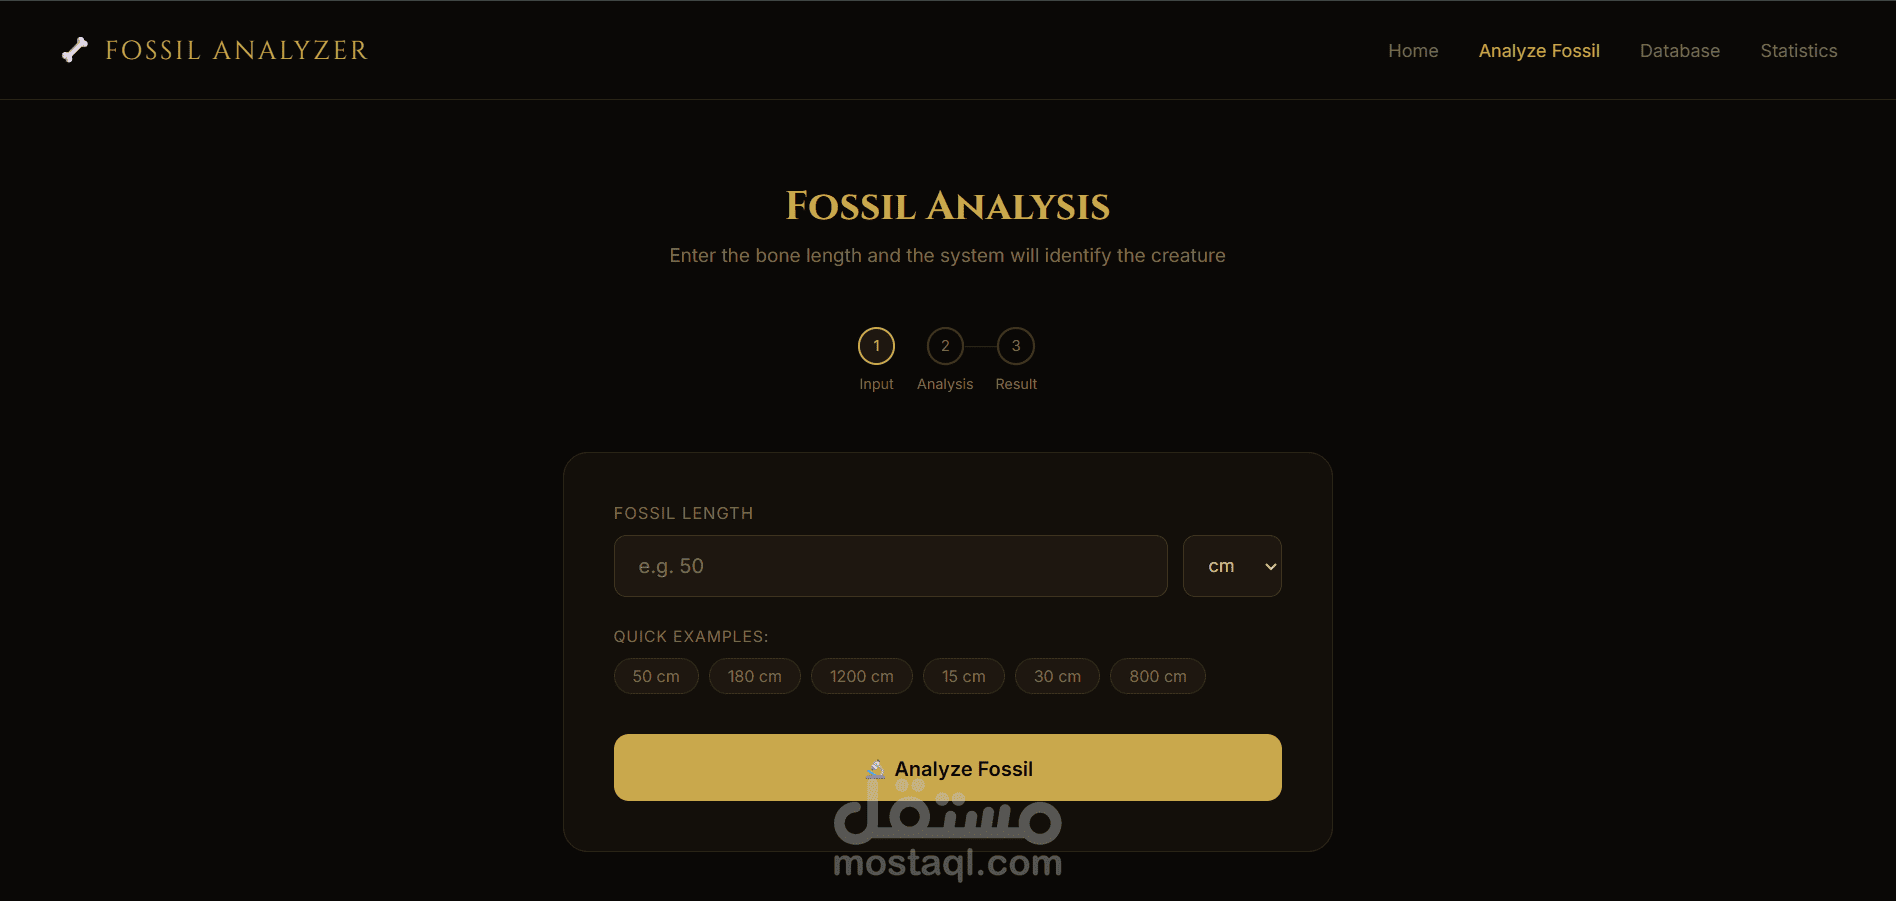
صفحة التحليل (Analyzer): يدخل المستخدم طول العظمة (بالسم أو المتر أو المليمتر)، والنظام يحسب ويعرض أقرب تطابق مع نسبة تطابق (Match Score)، بالإضافة إلى 3 أحافير مشابهة.
صفحة قاعدة البيانات (Database): عرض كامل لكل الأحافير مع إمكانية البحث والفلترة حسب النوع والترتيب حسب الطول/العمر/نسبة الدقة.
REST API متكامل يوفر 5 نقاط وصول (endpoints):
GET /api/fossils (بحث، فلترة، ترتيب)
GET /api/fossils/:id
GET /api/fossils/types
GET /api/fossils/stats
POST /api/analyze
وضع عدم الاتصال (Offline Fallback): الصفحات تعمل حتى بدون تشغيل السيرفر، بفضل بيانات احتياطية مدمجة في الواجهة الأمامية.
تصميم متجاوب (Responsive) يعمل على جميع أحجام الشاشات، مع واجهة مستخدم مستوحاة من طابع علمي/أثري.