Spam SMS Detection using Machine Learning & NLP
تفاصيل العمل
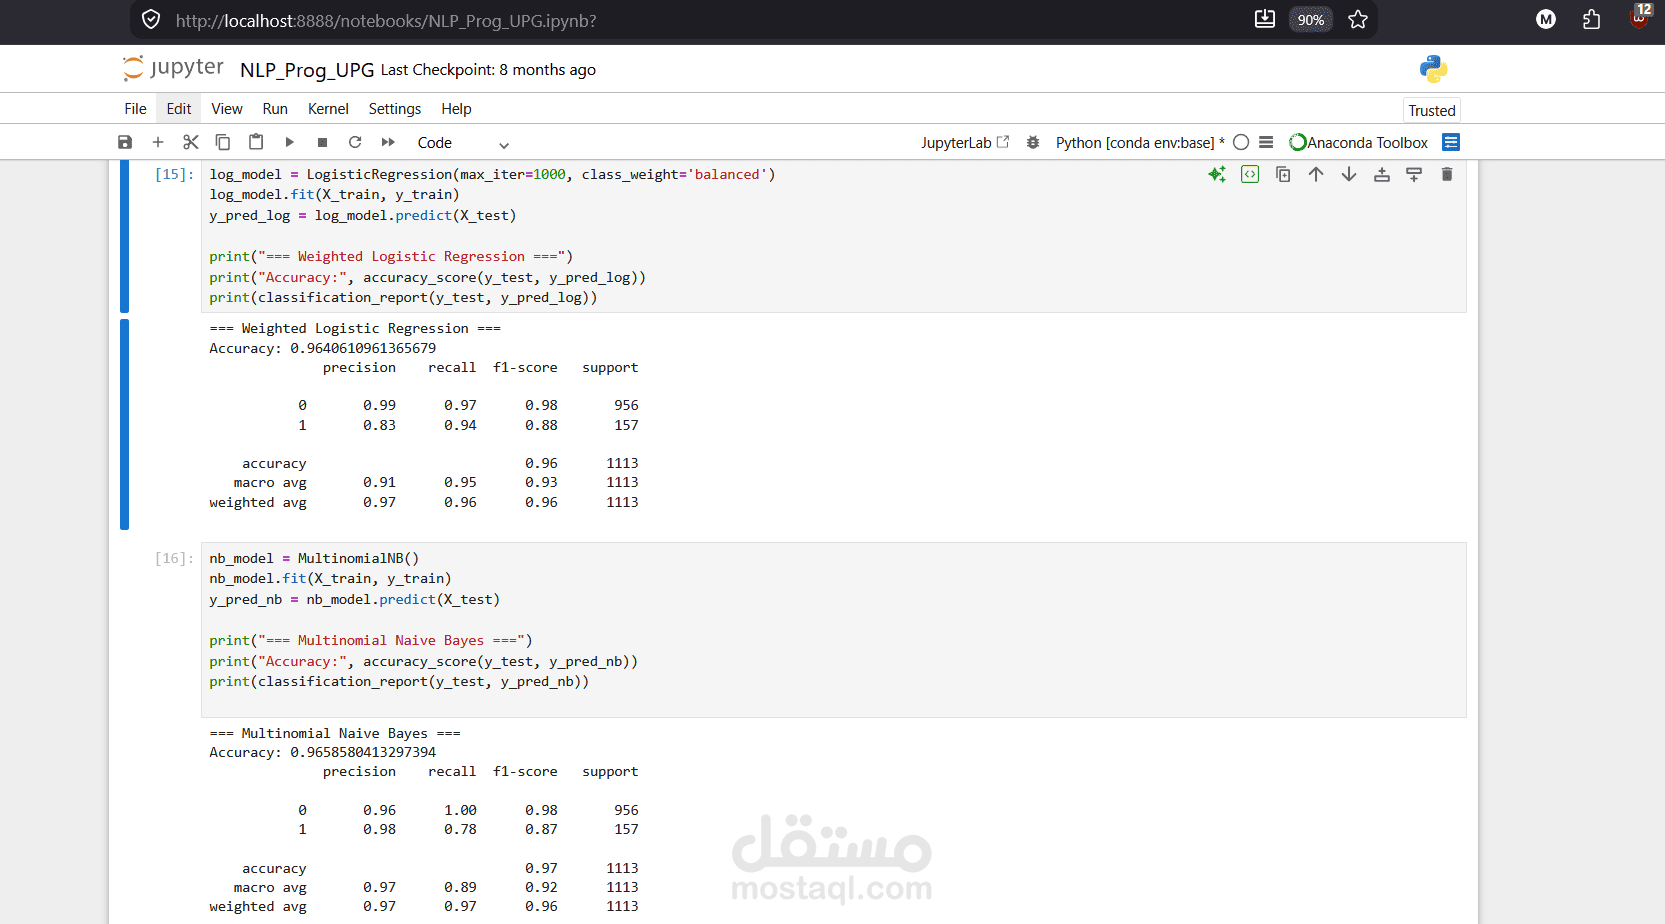
مشروع لتصنيف الرسائل النصية واكتشاف الرسائل المزعجة (Spam) باستخدام تقنيات معالجة اللغة الطبيعية (NLP) وMachine Learning.
قمت بمعالجة وتنظيف بيانات الرسائل النصية، ثم تطبيق مجموعة من تقنيات الـText Preprocessing مثل إزالة الكلمات الشائعة (Stopwords)، وتنظيف النصوص، وTokenization وLemmatization لتحسين جودة البيانات قبل تدريب النموذج.
استخدمت TF-IDF لتحويل النصوص إلى Features رقمية يمكن لخوارزميات Machine Learning التعامل معها، ثم قمت بتدريب واختبار نماذج للتصنيف مثل Logistic Regression وMultinomial Naive Bayes.
تم تقييم أداء النماذج باستخدام Accuracy وClassification Report، وحقق المشروع دقة تصنيف وصلت إلى حوالي 96% في التمييز بين الرسائل العادية (Ham) والرسائل المزعجة (Spam).
التقنيات المستخدمة:
Python، Pandas، NumPy، NLTK، Scikit-learn، TF-IDF، Logistic Regression، Multinomial Naive Bayes، NLP وMachine Learning.